

Разработка и внедрение производственных ML-пайплайнов на Apache Airflow
В современном мире создание точной модели — это лишь 20% успеха. Остальные 80% — это ее надежное внедрение, масштабирование и поддержка в production-среде. Ключевым инструментом для решения этих задач является оркестрация ML-пайплайнов.
В этом материале мы подробно разберем, как с помощью Apache Airflow — индустриального стандарта для оркестрации workflows — создать, запустить и поддерживать ваш первый ML-пайплайн. Мы не только пройдемся по теории, но и на практическом примере покажем весь процесс: от написания кода до мониторинга в веб-интерфейсе. Особое внимание мы уделим рискам, архитектурным решениям и best practices, которые мы выработали за годы успешной реализации проектов.
Почему Apache Airflow — идеальный выбор для MLOps?
Apache Airflow — это открытая платформа для программируемого создания, планирования и мониторинга workflows. В контексте машинного обучения он решает критически важные задачи: регулярное переобучение моделей (Re-training) - автоматизация процесса обучения на свежих данных по расписанию (ежедневно, еженедельно); пакетный инференс (Batch Prediction - массовое получение предсказаний для большого объема данных, например, для формирования персональных рекомендаций для всех пользователей раз в ночь; сложные ETL/ELT процессы – загрузка, очистка, преобразование и обогащение данных из множественных источников; автоматизированная генерация отчетов и мониторинг - создание дашбордов и отчетов о качестве модели и дрейфе данных.
Ключевое преимущество Airflow — его гибкость. Он не навязывает конкретный способ выполнения задачи, а позволяет интегрировать практически любой инструмент или скрипт через концепцию операторов (Operators).
Типичная архитектура ML-системы с Airflow:
Рассмотрим на примере рекомендательной системы:
- Feature Engineering Pipeline: Раз в сутки агрегируются и вычисляются актуальные признаки пользователей и товаров.
- Training Pipeline: На основе новых признаков и меток регулярно переобучается модель.
- Batch Prediction Pipeline: Обновленная модель применяется ко всем пользователям для генерации новых рекомендаций, которые сохраняются в базу данных для быстрого доступа.
Airflow идеально подходит для таких сценариев, где важна не минимальная задержка (latency), а точность, надежность и воспроизводимость вычислений.
Рис 01
Основные концепции Apache Airflow: краткий ликбез
Прежде чем погружаться в практику, разберем ключевые термины.
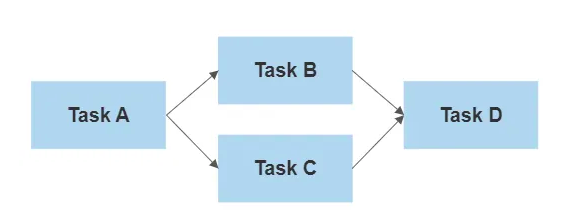
DAG (Directed Acyclic Graph) - осязаемое ядро Airflow. Это ориентированный ациклический граф, который определяет workflow вашего пайплайна. Каждый DAG состоит из набора задач и зависимостей между ними. «Ациклический» означает, что задачи не могут образовывать циклы — граф должен иметь четкое начало и конец.
- Task - конкретный шаг или операция в рамках DAG (например, «загрузить данные», «предобработать признаки», «обучить модель»).
-
Operator - шаблон, который определяет, как будет выполнена задача. Стандартные операторы:
PythonOperator(выполнить Python-функцию),BashOperator(выполнить bash-команду),DockerOperator(запустить команду в Docker-контейнере) и многие другие. - Scheduler - мозг Airflow. Отвечает за запуск задач по расписанию и с учетом их зависимостей.
- Web Server - веб-интерфейс для мониторинга выполнения DAG’ов, просмотра логов и ручного управления.
- Metadata Database - база данных (обычно PostgreSQL), где Airflow хранит всю информацию о DAG’ах, задачах, их статусах и связях.
Практический кейс: Пайплайн классификации финансовых новостей
Чтобы продемонстрировать всю мощь Airflow, мы реализуем end-to-end пайплайн, который ежедневно загружает свежие финансовые новости из RSS-фида CNBC, классифицирует каждую новость по заранее заданным темам (например, «Криптовалюты», «IPO», «Нефть и газ») с помощью ML-модели Zero-Shot Classification, а также агрегирует результаты и готовит отчет.
Почему мы выбрали именно этот пример?
Во-первых, за его наглядность - результаты работы пайплайна легко интерпретировать.
Во-вторых, это практическая ценность. Анализ новостного потока — реальная бизнес-задача для хедж-фондов и инвестиционных компаний.
В – третьих, это демонстрация ключевых техник. Мы затронем работу с Docker, внешними API, тяжелыми ML-моделями и организацию данных между задачами.
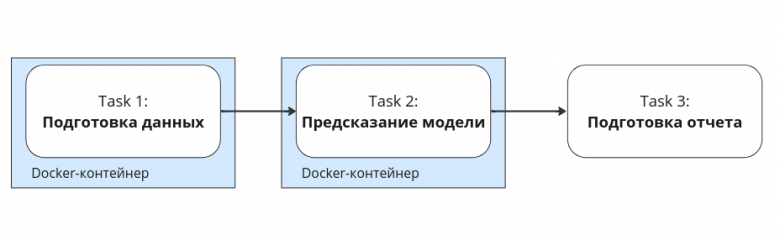
Наш пайплайн будет состоять из трех последовательных задач:
Task 1: news_load → Загрузка и предобработка данных (выполняется в Docker-контейнере).
Task 2: news_label → Инференс ML-модели (выполняется в отдельном Docker-контейнере).
Task 3: news_by_topic → Агрегация результатов и формирование отчета (выполняется как обычная Python-функция).
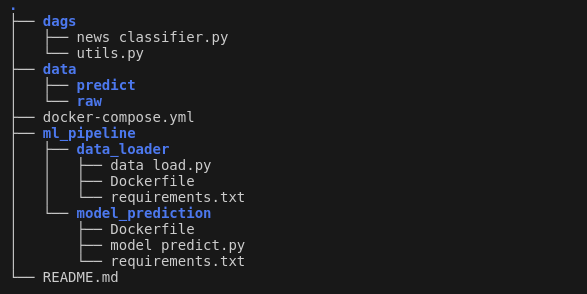
Код проекта будет выглядеть следующим образом:
Шаг 1: Подготовка среды и изоляция с помощью Docker
Одна из лучших практик в MLOps — изоляция зависимостей. Задачи загрузки данных и инференса модели могут иметь конфликтующие требования к версиям библиотек. Решение — запускать их в отдельных Docker-контейнерах.
Код для загрузки данных в csv:
import feedparser import pandas as pd NEWS_FEED_URL = "https://www.cnbc.com/id/19746125/device/rss/rss.xml" def data_load(data_path: str)-> None:news_feed = feedparser.parse(NEWS_FEED_URL)df = pd.DataFrame(news_feed.entries)df.to_csv(data_path,sep="\t",index=False)
В финальную версию data_load.py добавим использование Click и опции командной строки, логирование и дополнительную обработку данных:
import html import logging import click import feedparser import pandas as pd NEWS_FEED_URL = "https://www.cnbc.com/id/19746125/device/rss/rss.xml" COLUMNS_TO_SAVE =["id","published","title","summary"]logging.basicConfig(level=logging.INFO)@click.command()@click.option("--data_path",help="Path to the input data CSV file")def data_load(data_path: str)-> None:logging.info("Fetching financial news from the RSS feed...")news_feed = feedparser.parse(NEWS_FEED_URL)logging.info("News fetched successfully.")df = pd.DataFrame(news_feed.entries)[COLUMNS_TO_SAVE]df["published"]= pd.to_datetime(df["published"])df["title"]= df["title"].map(html.unescape)df["summary"]= df["summary"].map(html.unescape)logging.info(f"Saving the processed data to '{data_path}'...")df.to_csv(data_path,sep="\t",index=False)logging.info("Data saved successfully.")if __name__ == "__main__":data_load()
Для подготовки Docker-образа осталось создать список зависимостей - requirements.txt:
feedparser==6.0.10click==8.1.3pandas==2.0.1
Dockerfile:
FROM python:3.11COPY requirements.txt data_load.py /workdir/WORKDIR /workdirRUN pip install -r requirements.txt
У нас готовы все файлы для создания Docker-образа.
Шаг 2: Инференс модели с использованием Zero-Shot Classification
Для классификации новостей мы используем мощный подход Zero-Shot Classification с помощью модели от Hugging Face (valhalla/distilbart-mnli-12-1). Его преимущество в том, что не требуется предварительное обучение на размеченных данных — мы просто задаем список интересующих нас тем.
Определим список классов - тем, на которые мы будем разделять финансовые новости:
LABELS =["Crypto","SEC","Dividend","Economics","Oil or Gas","IPO","Politics","Buffet","Stock","Other",]
Для получения предсказаний загружаем модель valhalla/distilbart-mnli-12-1 из Hugging Face Hub. device=-1 означает, что модель запускается на CPU.
from transformers import pipeline model_hf = pipeline(model="valhalla/distilbart-mnli-12-1",device=-1)
Загрузим csv файл с новостями, который мы подготовили в предыдущем пункте:
import pandas as pd df = pd.read_csv(data_path,sep="\t")texts_for_pred =(df.title + ". " + df.summary).tolist()
Для получения предсказаний передадим модели список текстов texts_for_pred и классы LABELS:
pred = model_hf(texts_for_pred,LABELS,multi_label=False)
Выберем предсказание лучшего класса и сохраним результат в json-файл:
df["label"]=[x["labels"][0]for x in pred]df.T.to_json(pred_path)
Код готов.
import logging import click import pandas as pd from transformers import pipeline LABELS =["Crypto","SEC","Dividend","Economics","Oil or Gas","IPO","Politics","Buffet","Stock","Other",]logging.basicConfig(level=logging.INFO)@click.command()@click.option("--data_path",help="Path to the input data CSV file")@click.option("--pred_path",help="Path to save the output JSON file")def model_predict(data_path: str,pred_path: str)-> None:logging.info("Loading the model...")model_hf = pipeline(model="valhalla/distilbart-mnli-12-1",device=-1)logging.info("Model loaded successfully.")logging.info(f"Reading data from '{data_path}'...")df = pd.read_csv(data_path,sep="\t")logging.info("Data read successfully.")texts_for_pred =(df.title + ". " + df.summary).tolist()logging.info("Performing model prediction...")pred = model_hf(texts_for_pred,LABELS,multi_label=False)logging.info("Prediction completed successfully.")df["label"]=[x["labels"][0]for x in pred]logging.info(f"Saving the predictions to '{pred_path}'...")df.T.to_json(pred_path)logging.info("Predictions saved successfully.")if __name__ == "__main__":model_predict()
Примечание:
Обратите внимание на параметр device=-1. Он заставляет модель работать на CPU. В продакшене для тяжелых моделей необходимо использовать GPU. Для этого в Dockerfile нужно установить соответствующие драйверы и библиотеки (например, nvidia/cuda базовый образ), а в вызове оператора указать device=0 или использовать KubernetesPodOperator с указанием GPU-ресурсов.
Важно! Использование больших моделей на CPU может привести к долгому времени выполнения и таймаутам задач. Всегда тестируйте время инференса на реалистичном объеме данных и выделяйте соответствующие ресурсы.
Шаг 3: Проектирование DAG в Airflow
Теперь соберем все компоненты в единый граф. Ключевые аспекты нашего DAG:
-
Обмен данными: Для простоты мы используем смонтированную локальную директорию
/opt/airflow/data/. В реальных проектах мы настоятельно рекомендуем использовать надежные распределенные хранилища, такие как Amazon S3, Google Cloud Storage или Azure Blob Storage, которые интегрируются с Airflow через соответствующие операторы.
<>2.from docker.types import Mount dockerops_kwargs ={"mount_tmp_dir": False,"mounts": [Mount(source="<path_to_your_airflow-ml_repo>/data",target="/opt/airflow/data/",type="bind",)],...}
- Определим путь для 3 типов файлов: исходные данные, предсказания и файл с результатом. Они используют синтаксис Airflow {{ ds }}, который будет заменен на дату выполнения при запуске DAG.
raw_data_path = "/opt/airflow/data/raw/data__{{ ds }}.csv"
 pred_data_path = "/opt/airflow/data/predict/labels__{{ ds }}.json"
 result_data_path = "/opt/airflow/data/predict/result__{{ ds }}.json"
-
Создадим DAG. dag создает DAG с названием
financial_newsс начальной датой (days_ago(0)) и ежедневным запуском.taskflowпредставляет собой сам DAG и содержит задачи, формирующие наш пайплайн.
from airflow.decorators import dag from airflow.utils.dates import days_ago # Create DAG @dag("financial_news",start_date=days_ago(0),schedule="@daily",catchup=False)def taskflow():...
- Создадим 2 задачи для запуска в Docker-контейнерах. Для этого нам понадобится DockerOperator.
# Task 1 news_load = DockerOperator(task_id="news_load",container_name="task__news_load",image="data-loader:latest",command=f"python data_load.py --data_path{raw_data_path}",**dockerops_kwargs,)# Task 2 news_label = DockerOperator(task_id="news_label",container_name="task__news_label",image="model-prediction:latest",command=f"python model_predict.py --data_path{raw_data_path}--pred_path{pred_data_path}",**dockerops_kwargs,)
- Создадим последнюю задачу, которая преобразует полученные предсказания питоновским кодом.
# Task 3 news_by_topic = PythonOperator(task_id="news_by_topic",python_callable=aggregate_predictions,op_kwargs={"pred_data_path": pred_data_path,"result_data_path": result_data_path,},)
Установим зависимости между задачами:
news_load >> news_label >> news_by_topic
Создадим и настроим объект DAG в соответствии с заданными параметрами:
taskflow()
Наш пайплайн готов.
Шаг 4: Запуск и оркестрация с помощью Docker Compose
Для локального запуска всего стека Airflow мы используем официальный docker-compose.yml, который мы модифицировали:
- Установили пакет для поддержки работы с Docker:
_PIP_ADDITIONAL_REQUIREMENTS: apache-airflow-providers-docker==3.6.0
-
Добавили свои сервисы: Определили сервисы для сборки наших кастомных образов
data-loaderиmodel-prediction.
data-loader: build: context:ml_pipeline/data_loaderimage:data-loaderrestart: "no" model-prediction: build: context:ml_pipeline/model_predictionimage:model-predictionrestart: "no"
-
Настроили volumes: Смонтировали директорию с данными и, что критически важно, Docker socket (
/var/run/docker.sock) в контейнеры Airflow. Это позволяет операторуDockerOperatorизнутри контейнера Airflow управлять другими контейнерами на хостовой машине.
volumes: -${AIRFLOW_PROJ_DIR:-.}/data/:/opt/airflow/data/-/var/run/docker.sock:/var/run/docker.sock
-
Добавили
docker-socket-proxy: Для повышения безопасности мы используем прокси для Docker socket, чтобы ограничить команды, которые может выполнять Airflow.
# Required because of DockerOperator. For secure access and handling permissions. docker-socket-proxy: image:tecnativa/docker-socket-proxy:0.1.1 environment: CONTAINERS: 1 IMAGES: 1 AUTH: 1 POST: 1 privileged: true volumes: -/var/run/docker.sock:/var/run/docker.sock:rorestart:always
После настройки окружения (AIRFLOW_UID) и инициализации базы данных (docker compose up airflow-init), весь стек поднимается командой docker compose up --build.
Перед запуском Airflow нужно подготовить окружение. Если вы работаете на Linux перед запуском укажите AIRFLOW_UID:
echo -e "AIRFLOW_UID=$(id -u)" > .env
Независимо от ОС выполните миграцию БД и создайте первую учетную запись пользователя:
docker compose up airflow-init
Наша учетная запись имеет логин airflow и пароль airflow.
Для создания и запуска контейнеров, определенных в файле docker-compose.yml, используется команда:
docker compose up
В нашем случае также необходимо предварительно собрать образы data-loader и model-prediction
docker compose up --build
Когда вы закончите работу и захотите очистить свое окружение, выполните следующую команду:
docker compose down--volumes --rmiall
Шаг 5: Мониторинг и отладка в Web UI
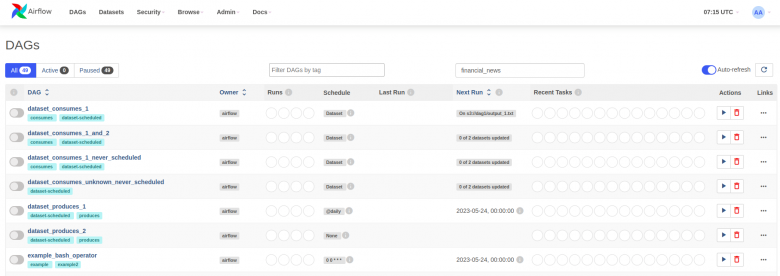
После запуска по адресу http://localhost:8080 (логин/пароль: airflow) открывается веб-интерфейс. Здесь мы можем вручную запустить DAG (кнопка "Trigger DAG"), в реальном времени наблюдать за выполнением задач на графическом представлении графа, а также просматривать логи каждой задачи для отладки. Именно здесь мы видим наши сообщения, записанные через logging.info.
На домашней странице находится список всех дагов, включая те, что устанавливаются по умолчанию от Airflow. Здесь можно найти и выбрать DAG financial_news.
На странице DAG доступна информация о пайплайне: графическое представление, время ближайшего запуска, логи запуска, код и многое другое.
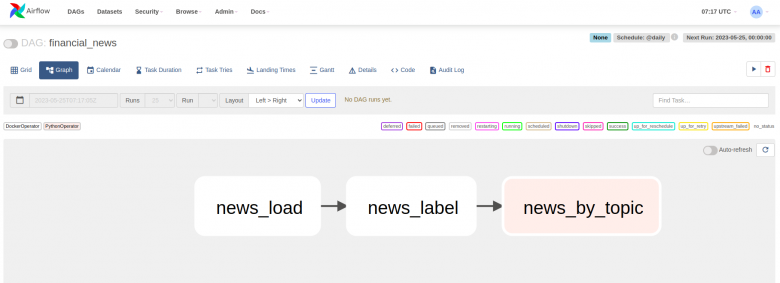
Запустим DAG, нажав на кнопку старта:
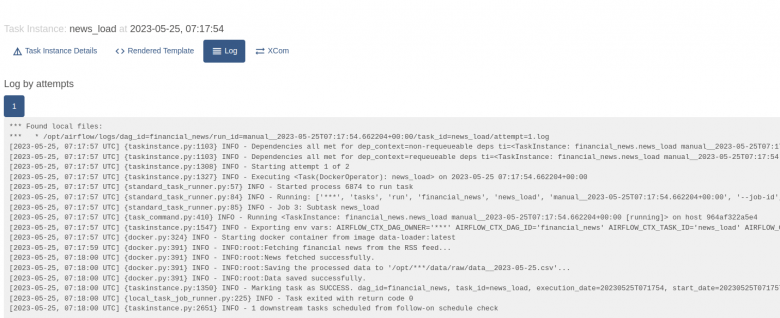
Интерфейс Airflow — мощный инструмент для оператора пайплайнов, позволяющий быстро выявлять и устранять проблемы.
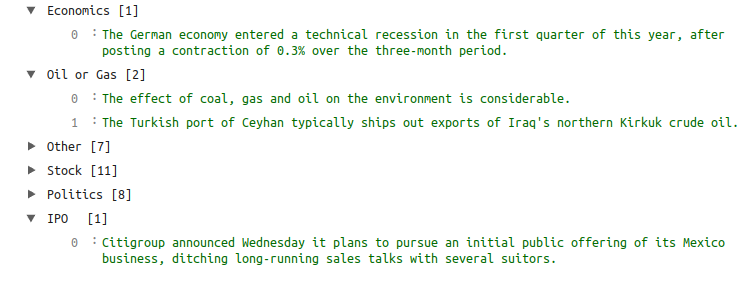
Смотрим результат нашего пайплайна. Как классифицировались новости?
Анализ рисков, ошибок и рекомендации для продакшена
Наш учебный пример сильно упрощен. При выводе подобных пайплайнов в продакшен реклмендуем уделять особое внимание следующим аспектам:
- Безопасность и управление доступом. В данном случае главный риск – это передача секретов (паролей, API-ключей) в коде или через переменные окружения в незашифрованном виде. Решение: использование встроенных Airflow Connections и Variables, которые шифруются в базе данных, или интеграция с внешними секрет-менеджерами (HashiCorp Vault, AWS Secrets Manager).
-
Надежность и отказоустойчивость. В данном случае риск сводится к падению одной задачи, которая в итоге приводит к провалу всего DAG. Решение: настройка политик повторного запуска (
retries) и обработчиков неудач (on_failure_callback) для отправки уведомлений в Slack/Telegram. -
Масштабируемость. Риск: локальный Docker Compose не подходит для рабочих нагрузок.
DockerOperatorможет стать узким местом. Решение - развертывание Airflow в Kubernetes и использованиеKubernetesPodOperator. Это позволяет динамически создавать pod'ы для каждой задачи, обеспечивая идеальную изоляцию и эффективное использование ресурсов кластера. - Мониторинг и логирование. Риск: просмотр логов через веб-интерфейс Airflow неудобен для анализа больших объемов данных. Решение: настройка интеграции с централизованными системами мониторинга (Prometheus/Grafana) и логирования (ELK Stack, Loki).
-
Управление данными. Риск: использование локальной файловой системы ненадежно и немасштабируемо. Решение: интеграция с облачными объектными хранилищами (S3, GCS) через операторы (
S3Hook,GCSHook).
В заключении хотелось бы отметить тот факт, что разработка ML-пайплайнов — это сложный процесс, требующий экспертизы в машинном обучении, инженерии данных и DevOps, а Apache Airflow является мощным инструментом, который позволяет структурировать этот процесс, делая его управляемым, воспроизводимым и надежным.


