

Архитектурные принципы DG в DWH, Lakehouse и Data Platform
Данная глава предназначена для новичков в области управления данными и для тех, кто отвечает за архитектуру хранения и обработки в организациях. Мы разберём, какие архитектурные принципы лежат в основе Data Governance (DG) и как эти принципы реализуются в современных DWH, Lakehouse и Data Platform. Вы найдёте теорию, термины, методологии, практические примеры (open-source и отечественные решения), технические детали, риски внедрения и конкретные рекомендации к действию. В конце главы — раздел FAQ с 7–10 вопросами и подробными ответами.
Data Governance — это совокупность управленческих, организационных и технических мероприятий, которые обеспечивают надёжность, доступность, качество и безопасность данных на протяжении всего их жизненного цикла. Архитектурные принципы DG должны быть встроены в архитектуру хранения и обработки данных (DWH, Lakehouse и Data Platform), чтобы политики доступа, качества и соответствия регуляторным требованиям жили в среде безопасно и прозрачно.
Ключевые идеи:
- политика единая и приводимая кода образовательно: политика доступа, качество данных и соответствие требованиям должны быть «кодируемы» и воспроизводимы.
- метаданные как первый класс: каталогизация, lineage, бизнес-слой, технический слой.
- разделение обязанностей: назначение ролей и ответственных за данные, а не только за инфраструктуру.
- интеграция на протяжении всего цикла данных: от ingestion до consumption и архивирования.
- мониторинг и аудит: непрерывная проверка соблюдения политики через метрики, логи и алерты.
Ниже мы рассмотрим теорию, затем предложим практические архитектурные решения на основе открытых инструментов и отечественного рынка, приведём технические примеры и завершим обсуждение рисков.
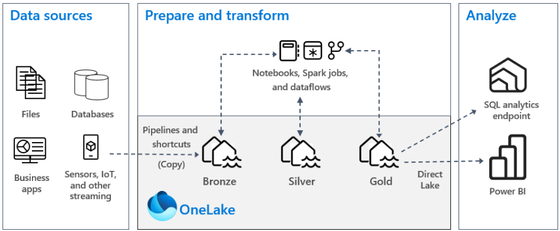
Архитектурные принципы DG для DWH, Lakehouse и Data Platform
Основные принципы можно объединить в следующие блоки:
Политики как код (Policy as Code)
- Управление доступом, классификацией, качеством и соответствием реализуется через конфигурационные файлы и политики, которые можно развернуть в CI/CD. Это обеспечивает повторяемость, аудит и откат.
Мета-слой как базис эксплуатации
- Единый словарь (data dictionary), линейность (data lineage), бизнес-термины, технические атрибуты и качества — всё это создаёт единый контекст для потребителей данных.
Гранулированный доступ и контроль над данными
- RBAC и ABAC, маскирование, псевдонимизация и защита персональных данных, поддержка нормативных требований. Важно не только определить доступ, но и обеспечить его в реальном времени.
Полная видимость жизненного цикла данных
- От источника ingestion до потребителя: трассируемость изменений, версия данных, история изменений схем и метаданных.
Защита приватности и безопасности
- Порядок хранения и обработки данных, а также механизмы шифрования и аудит.
Управление качеством данных
- Нормы качества, валидаторы, проверки на чистоту, полноту и консистентность. Результаты — видимые дашборды и продукты для аналитиков и продакшн-команды.
Стандартизованные метаданные и единообразная терминология
- Каталоги данных, бизнес-словарь, линейность данных ( lineage ), версии схем, описание политик.
Масштабируемость и устойчивость к изменениям
- Архитектура должна адаптироваться к новым источникам, форматам и требованиям регуляторов без радикального переработки инфраструктуры.

Архитектура DG в разных слоях хранения и обработки
DWH (традиционный) слой
- Централизованный catalog и политики доступа на уровне базы данных и слоев ETL/ELT.
- Gobernance-слой концентрируется на столпах: бизнес-метаданные, lineage, контроль качества и аудиты исполнения.
Lakehouse
- Объединение хранения структурированных и полуструктурированных данных с открытым форматом и схематизацией. DG должна управлять схемами, версиями файлов, политиками доступа к данным в файлах (например, в парадигме Delta Lake, Iceberg).
Data Platform
- Обеспечивает единое управление данными в рамках всего пайплайна: ingestion, обработка, хранение и потребление, включая ML/AI. DG охватывает все сервисы (Data Lake, Data Warehouse, streaming, аналитика и т.д.) через единый слой политики.
Роли и ответственность (RACI) в DG
- Владелец данных (Data Owner): ответственность за данные в business-понимании; определение политики качества и доступности.
- Консерватор данных/Куратор данных (Data Steward): операционная реализация политик, поддержание справочников и метаданных.
- Архитектор DG: проектирование и поддержка архитектуры DG, интеграция инструментов, контроль исполнения политик.
- Администратор доступа (Access Admin): настройка RBAC/ABAC, управление ролями и правами.
- Архиватор/гарант качества (Data Quality Engineer): настройка тестов качества и их мониторинг.
- Регуляторный/compliance officer: обеспечение соответствия требованиям закона и регуляциям.
Метаданные и линейность ( lineage )
- Технические метаданные: схема, типы, форматы, драйверы загрузки, источники, технологические параметры.
- Бизнес-метаданные: бизнес-термины, правила согласования, описание данных, цели использования.
- Операционные метаданные: графики загрузок, тайминги, ошибки, SLA.
- lineage позволяет ответить на вопросы: откуда пришли данные, какие преобразования они претерпели, кто потребляет, какие продукты зависят.
- В реальной среде lineage нужна не только через ETL/ELT, но и через потоковую обработку (streaming), граф событий и схему событий (CDC).
Политики доступа и privacy-by-design
- RBAC (Role-Based Access Control): доступ по ролям, простота аудита.
- ABAC (Attribute-Based Access Control): доступ по атрибутам пользователя и данных (например, сегменты, подразделения, уровень секретности).
- Маскирование и псевдонимизация: защита PII в отчетности и аналитике.
- Политики конфиденциальности в реальном времени: автоматическое применение маскирования при доступе к данным, а также журналирование попыток доступа.
Инструменты DG: обзор классов решений
Каталоги и линейность
- Open-источники и коммерческие: Apache Atlas, Apache Ranger, OpenMetadata, Amundsen, DataHub.
Контроль доступа и безопасность
- Apache Ranger, OPA (Open Policy Agent), встроенные механизмы в облачных платформах (Snowflake, BigQuery, AWS Lake Formation и т.д.).
Контроль качества данных
- Great Expectations, Deequ (Scala/Java), DePC (Data Profiling Checker) — позволяют описать наборы тестов качества и автоматически их выполнять.
Управление метаданными и визуализация
- OpenMetadata, DataHub, Amundsen — каталоги данных, отображение lineage, унификация терминов.
Оркестрация и интеграция политик
- Apache Airflow, Dagster, Prefect — универсальные конвейеры с поддержкой политики как код.
Методы реализации политики как кода
- Конфигурации политик пишутся в декларативных форматах: YAML, JSON, Rego (OPы).
- Инструменты политики как код обычно связаны с CI/CD: при пуше в репозиторий политики разворачиваются и тестируются в среде staging.
- Пример подхода: политика доступа к таблицам определяется в Rego и применяется через OPA к запросам к данным (или через интеграцию в слой анализа).
Практические примеры
Ниже приведены практические сценарии внедрения DG с конкретными технологиями и конфигурациями. Мы используем как открытые решения, так и отечественные подходы, которые чаще всего строятся на базе открытых проектов с локализацией и поддержкой локальных партнёров.
Пример 1 — DG в DWH на основе открытого стека (OpenMetadata + Atlas/Ranger)
Схема:
- DWH: любой облачный или on-premises база данных (PostgreSQL, Snowflake, BigQuery и т. д.)
- Каталог: OpenMetadata как единый каталог метаданных и линейности.
- Безопасность: Apache Ranger для контроля доступа на уровне источников данных; OPA — слой policy-as-code для ABAC.
- Quality: Great Expectations для тестов качества.
- Контекст: локализация терминов в бизнес-слое, единый словарь и линейность.
Конфигурация (упрощённая):
OpenMetadata (пример YAML-конфигурации)
# om_config.yaml
service:
  type: metadata
  name: example-metadata
entities:
  - table
  - column
  - database
  - dataset
  - lineage
OPA (poly-policy) — пример простого правила ABAC
package authz

default allow = false

# роль пользователя
allow {
  input.method = "GET"
  input.user.role = "analyst"
  input.resource.type = "dataset"
  input.resource.privacy != "PII"  # ограничение для аналитиков на PII
}
Great Expectations — тест kwaliteit
# great_expectations.yml
data_docs_sites:
  "local_site":
    site_tailwind:
      show_examples: true
Преимущества:
- Единый каталог упрощает поиск и использование метаданных.
- Расширяемость: легко добавить новые источники и новые политики.
- Политики могут быть протестированы до деплоя в prod.
Недостатки/потребности:
- Необходимость грамотной интеграции между OpenMetadata, Ranger и OPA.
- Возможна задержка при реализации сложных RBAC-ABAC-сценариев и больших объёмах данных.
Пример 2 — Lakehouse на Delta Lake / Apache Iceberg с OpenMetadata
Схема:
- Хранение: Delta Lake или Iceberg в дата-лагере (Databricks, Apache Spark, локальные кластеры).
- Каталог: OpenMetadata для метаданных, линейности и политик.
- Политика доступа: OPA + встроенные механизмы Spark/HDFS для контроля фильтров и маскирований.
- Data Quality: Great Expectations + Deequ на этапах ETL/ELT.
Короткий сценарий настройки:
- Настроить OpenMetadata для регистрации источников и таблиц.
- Определить бизнес-слова в Data Dictionary и связать их с техническими атрибутами.
- Определить политики ABAC через OPA и применить на уровне запросов Spark (через плагин OPA).
- Добавить набор тестов качества данных в Great Expectations, чтобы KPI качества отображались в дашбордах.
Преимущества:
- Универсальная платформа для хранения разнообразных типов данных.
- Гибкость в выборе источников и форматов.
- Хорошая масштабируемость и поддержка облачных решений.
Недостатки:
- Требуется синхронизация между каталогами и хранилищами слоев.
- В больших организациях сложнее поддерживать единый словарь и бизнес-термины.
Пример 3 — Data Platform с policy-as-code и Kubernetes
Схема:
- Обзорная платформа: Kubernetes + микросервисы, инфраструктура как код.
- DG-компоненты: OPA для политик, OpenMetadata для метаданных, Ranger для доступа на уровне источников, Grafana для мониторинга.
- Помимо этого: Deequ и Great Expectations для качества, Airflow/Prefect для конвейеров.
Ключевые шаги:
- Развернуть OpenMetadata и OPA в Kubernetes.
- Связать политики OPA с конвейерами в Airflow через REST API.
- Настроить тестовые наборы Great Expectations и соединить их с CI/CD.
- Включить мониторинг и алерты по качеству и доступам.
Плюсы:
- Гибкость и масштабируемость в больших средах.
- Возможность полного контроля через код.
- Лёгкость интеграции с ML-пайплайнами.
Минусы:
- Сложная оперативная сеть и необходимый DevOps-уровень компетенций.
- Риски несовместимости версий между компонентами.
Архитектура и слои DG
- Инфраструктурный слой: физическое хранение данных, платформа облака/локальная среда, безопасность на уровне сетей и шифрования.
- Слой хранения и обработки: DWH, Lakehouse, streaming/ETL-обработчики.
- Слой метаданных и каталогов: OpenMetadata, Atlas, Amundsen, DataHub, с линейностью и бизнес-терминами.
- Слой политики: OPA, Atlas/Ranger, политики в коде (policy as code).
- Слой качества и комплаенса: Great Expectations, Deequ, мониторинг качества данных, аудит и регуляторные политики.
- Слой потребителей данных: BI/аналитика, отчёты, данные для ML.
Компоненты DG и их роли
Каталог метаданных
- Хранит технические и бизнес-метаданные, линейность данных.
- Пример: OpenMetadata, DataHub.
Политики доступа
- ABAC/RBAC, маскирование, аудит.
- Пример: OPA, Apache Ranger.
Контроль качества
- Набор тестов, мониторинг и алерты.
- Пример: Great Expectations, Deequ.
Безопасность и приватность
- Маскирование, приватность (анонимизация, дифференциальная приватность), хранение ключей и сертификатов.
Видимость и аудит
- Логирование доступа, аудит изменений, KPI по качеству.
Примеры конфигураций и кода
Пример Rego-правила ABAC (OPA)
package governance

default allow = false

# Разрешить доступ аналитикам к данным, если данные не PII
allow {
  input.user.role == "analyst"
  input.resource.type == "dataset"
  not input.resource.tags[_] == "PII"
}
Пример YAML-конфигурации OpenMetadata (упрощённый)
# om_config.yaml
service:
  type: metadata
  name: prod-metadata
  description: "Центральный каталог для DG"
entities:
  - database
  - table
  - column
  - dataset
polling:
  interval: 3600
Пример Great Expectations (микросхема)
# great_expectations.yml
expectation_suite_name: dataset_quality_suite
datasets:
  - path: data/datasets/sales.csv
    expectations:
      - expect_column_values_to_not_be_null: {column: "order_id"}
      - expect_column_values_to_be_between: {column: "amount", min_value: 0, max_value: 100000}
Пример политики для маскирования PII в SQL-потреблениях (псевдокод)
IF user.role IN ('analyst') AND data.privacy == 'PII'
  THEN apply_mask(column='ssn', mask='XXX-XX-XXXX')
Технологический стек: варианты реализации
Каталоги и линейность:
- OpenMetadata, Apache Atlas, Apache DataHub, Amundsen.
Контроль доступа:
- Apache Ranger, OPA, встроенная безопасность на платформах Snowflake, BigQuery, AWS Lake Formation.
Контроль качества:
- Great Expectations, Deequ.
Оркестрация и инфраструктура:
- Kubernetes, Airflow, Dagster, Prefect.
Мониторинг и аудит:
- Grafana, Prometheus, Elasticsearch/Kibana.
Модели защиты:
- Маскирование, псевдонимизация, шифрование на уровне хранения и передачи, DLP-системы.
Риски и ограничения внедрения DG
Сложность интеграции
- Не все компоненты легко интегрируются друг с другом. Требуется продуманная архитектура и план миграции.
Производительность
- Неправильно настроенные политики и большие каталоги могут замедлить запросы и конвейеры.
Расхождение между бизнес-слоем и техническим слоем
- Неконсистентные термины в бизнес-слове и техметаданных создают путаницу для потребителей.
Управление изменениями в больших организациях
- Частые изменения в источниках, политике и требованиях могут привести к «болезненному» обновлению всей экосистемы DG.
Безопасность и приватность
- Маскирование и приватность требуют правильной реализации; неправильная настройка может привести к утечкам или излишним ограничениями.
Соответствие требованиям
- В РФ и других юрисдикциях существуют законы о персональных данных (ФЗ-152) и требования к аудиту; DG должен обеспечивать соблюдение.
Стоимость и ресурсы
- Внедрение DG требует вложений в инфраструктуру, людей и процессы. Это часто требует долгосрочной стратегии и управляемого бюджета.
Практические замечания по рискам
- Не превращайте DG в «бутылочное горлышко» для бизнеса. Делайте политики явными, тестируемыми и прозрачными.
- Начинайте с минимально жизнеспособного набора политик (MVP): доступ к конфиденциальным данным для ограниченного круга пользователей, базовый каталог, базовый контроль качества.
- Проводите регулярную оценку соответствия и аудита. Автоматизируйте отчёты по изменению политик, доступов и качества.
- Обеспечьте синхронизацию между бизнес-терминами и техметаданными. Введите единый словарь и нормализуйте названия.
- Учитывайте требования локальных регуляторов, особенно в России: хранение данных в стране, аудит доступов, обработка ПД и т. д.
Выводы
- Архитектурные принципы DG должны быть встроены в каждую ступень инфраструктуры данных: от источников до потребителей.
- Единство словаря терминов, линейности и политики как код позволяют обеспечить прозрачность и предсказуемость поведения систем.
- Комбинация открытых инструментов (Atlas, Ranger, OpenMetadata, Great Expectations, OPA) и местных реализаций может дать мощную и гибкую DG-архитектуру.
- Важно сбалансировать требования к безопасности и приватности с необходимостью быстрой аналитики и инноваций.
- Риски в DG связаны с интеграцией, производительностью и соответствием, поэтому необходимо поэтапное внедрение, мониторинг и адаптация.
FAQ (Вопрос–Ответ)
1) Что такое DG и зачем он нужен в DWH и Lakehouse?
- DG — это управление данными на уровне политики, качества, безопасности и соответствия. В DWH и Lakehouse DG обеспечивает прозрачность, контроль доступа, качество и регуляторную ответственность, что позволяет бизнесу безопасно и эффективно работать с данными.
2) Какие ключевые компоненты DG в архитектуре?
- Каталог метаданных ( OpenMetadata, Atlas, DataHub), политики доступа (RBAC/ABAC, OPA, Ranger), контроль качества данных (Great Expectations, Deequ), мониторинг и аудит (Grafana, Prometheus), единый словарь терминов, линейность ( lineage ).
3) Как реализовать политику доступа как код?
- Используйте политики в формате Rego (OPA) или YAML/JSON, интегрируйте в CI/CD, применяйте через систему авторизации (OPA, Ranger) и слои данных. Пример: Rego-правило для ABAC и YAML-конфигурация каталога.
4) Какие примеры открытых инструментов вы рекомендуете для начала?
- OpenMetadata для каталога и линейности, Apache Atlas/Ranger как опции безопасности, Great Expectations для качества данных, OPA для политики как код, DataHub или Amundsen для визуализации и поиска.
5) Какие есть подходы к приватности и защите персональных данных?
- Маскирование и псевдонимизация, классификация данных как PII/PHI, приватность по дизайну, аудит доступа к данным, шифрование данных в покое и в транзите.
6) Какие бывают риски внедрения DG и как их минимизировать?
- Риск: сложность интеграции и производительности. Решение: MVP, поэтапное внедрение, четко прописанные интерфейсы, мониторинг.
- Риск: несоответствие требованиям регуляторов. Решение: внедрение политики в коде и аудиты.
- Риск: расхождение бизнес-терминов и техметаданных. Решение: единый словарь, регламенты обновления словаря.
7) Какие практические шаги начать уже сейчас?
- Определите владелца данных и стейкхолдеров; создайте единый словарь бизнес-терминов; зарегистрируйте критические источники и таблицы в каталоге; внедрите базовые политики ABAC/RBAC; настройте базовые тесты качества.
8) Как DG влияет на управляемость данными в облаке?
- DG обеспечивает единое место управления, что уменьшает риск утечек и ошибок, упрощает соответствие требованиям и улучшает прозрачность: lineage, access, and quality в рамках единой экосистемы.
9) Каковы принципы перехода от монолитных процессов к DG-инфраструктуре?
- Постройте пилот в виде MVP, добавляйте каталоги и политики, внедряйте policy-as-code, усиливайте мониторинг и аудит, обучайте пользователей и стейкхолдеров.
10) Что уместно учесть в России при внедрении DG?
- Локализация хранения данных и соблюдение отечественного законодательства по защите данных (ФЗ-152), аудит доступа, контроль кросс-граничной передачи данных, обратная совместимость с локальными сервисами и партнёрами.


