
Чек-листы готовности: данные, инфраструктура, процессы, люди
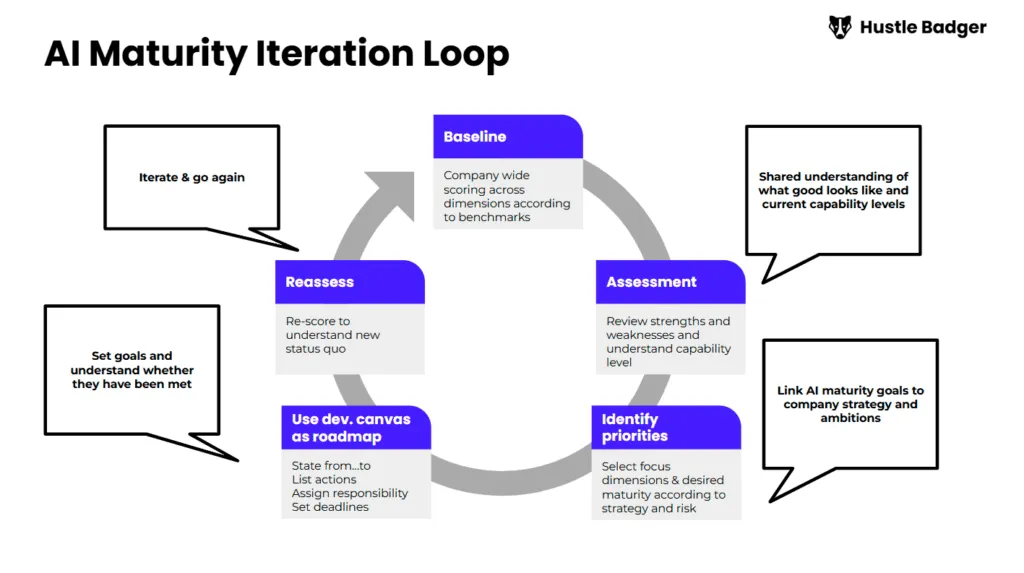
Чек-листы готовности — это структурированные инструменты для оценки того, насколько организация готова к внедрению и эксплуатации искусственного интеллекта на разных этапах жизненного цикла проекта. В контексте модели зрелости AI (AI Maturity) они служат для определения текущего состояния и целевых уровней по четырём ключевым направлениям: данные, инфраструктура, процессы и люди. Такой подход позволяет не только выявлять «узкие места», но и строить план последовательных улучшений, привязанный к KPI и бенчмаркингу.
Развернутая аналогия: можно представить AI-инициативу как сложную систему, где данные — это сырьё, инфраструктура — производственные мощности, процессы — технологии и методики, люди — операторы и управляющие. Без согласованности по всем четырём направлениям любая модель на тестовом стенде, вероятно, «не дойдёт» до продакшна или будет работать нестабильно и неэфективно.
В этой главе мы:
- разберём теоретическую базу чек-листов готовности и их связь с моделями зрелости;
- дадим практические примеры чек-листов и KPI;
- представим технические детали по инструментам (open-source и российские решения);
- разберём риски и ограничения внедрения;
- предложим готовые образцы материалов для внедрения в вашем подразделении.
Что такое чек-листы готовности и зачем они нужны
Чек-лист готовности — это набор критериев, которые позволяют проверить, что конкретный аспект проекта соответствует требованиям к качеству, управлению рисками и операционной устойчивости. В контексте AI Maturity чек-листы позволяют:
- систематизировать требования к данным, инфраструктуре, процессам и людям;
- обеспечить повторяемость оценки на разных уровнях зрелости;
- связывать результаты оценки с планами улучшений и KPI;
- снизить риск провалов на продакшн за счёт ранней идентификации проблем.
Модель зрелости и её связь с чек-листами
Чаще всего используют 4–5 уровней зрелости:
- Начальный/Ad hoc: процессы хаотичны, данные фрагментированы, инфраструктура слабая, люди дезориентированы.
- Определённый/Defined: задокументированы базовые процессы, есть политики управления данными, стартовая инфраструктура.
- Управляемый/Managed: у проекта устойчивый цикл разработки, есть мониторинг, есть контроль качества данных и моделей.
- Оптимизированный/Optimized: процессы автоматизированы, данные управляются как корпоративный актив, присутствуют продвинутые метрики эффективности, культура инноваций.
- Превосходный/Exemplary (иногда добавляется как пятый уровень): организация системно улучшает всё через внедрение новых методов, быстрый отклик на изменения, интеграцию с бизнес-результатами.
Связка уровней зрелости с чек-листами заключается в том, что на каждом уровне требуется проверить конкретные элементы по четырём направлениям: данные, инфраструктура, процессы, люди. Грубое соответствие можно представить так:
- Данные: качество, полнота, актуальность, управляемость и прослеживаемость данных.
- Инфраструктура: вычислительные мощности, хранилища, безопасность, доступ и управление версиями моделей.
- Процессы: жизненный цикл моделей, CI/CD для МЛ, управление экспериментами, контроль качества.
- Люди: компетенции, роли, обучение, вовлечённость бизнеса и угрозы организационных изменений.
Терминология и ключевые концепты
- Data quality (качество данных): точность, полнота (missingness), своевременность, согласованность, валидность, достоверность данных.
- Data lineage (генеалогия данных): прослеживаемость происхождения и трансформаций данных.
- Data governance (управление данными): набор политик, ролей и процедур управления данными.
- MLOps: набор практик и инструментов для разработки, развёртывания и эксплуатации ML-моделей.
- KPI и бенчмаркинг: показатели эффективности и сравнение с эталонами/конкурентами.
- Data contracts (контракты данных): формальные соглашения о формате, частоте и качестве данных.
- Observability (наблюдаемость): мониторинг производительности моделей, качества данных, инфраструктуры.
Как строить чек-листы
- Определите целевые уровни зрелости для каждого из четырёх направлений.
- Определите набор проверок (критериев) для каждого уровня.
- Свяжите проверки с KPI и бизнес-целями.
- Придумайте процедурные шаги для устранения отклонений и план внедрения.
- Регулярно обновляйте чек-листы по мере эволюции инфраструктуры и практик.
Практические примеры
Ниже представлены примеры подходов и инструментов, которые можно использовать для реализации чек-листов в реальном мире.
Open-source решения и подходы
- Great Expectations (GE): библиотека для валидации данных и постановки контрактов. Позволяет описать ожидания к данным и автоматически валидировать новые наборы данных.
- MLflow: платформа для отслеживания экспериментов, параметров и моделей. Помогает сохранить воспроизводимость и управлять версиями артефактов.
- Kubeflow: набор инструментов для оркестрации ML-рабочих процессов в Kubernetes, включая пайплайны, обучение и развёртывание.
- Apache Airflow: управление задачами и оркестрация ETL/ML-пайплайнов; хорошо подходит для CI/CD в ML.
- DVC (Data Version Control): управление версиями данных и артефактов моделей наряду с Git.
- Prometheus + Grafana: мониторинг сервисов и инфраструктуры, включая модели и данные.
- Amundsen или Apache Atlas: каталоги метаданных и линейности, управление данными и их контекстами.
- DeepPavlov: открытые инструменты и модели для NLP от российского исследовательского сообщества; полезно для внедрения в локальные решения и демонстрации возможностей.
Пример концептуального чек-листа на базе этих инструментов может выглядеть так:
Данные:
- Контракты данных определены и документированы (data contracts) — GE-expectations.
- Наличие набора тестов на полноту и качество данных.
- Линейность данных и трекинг версий (DVC, Git).
- Регулярный мониторинг датчика качества данных (profile.py, GE).
Инфраструктура:
- Установлен кластер для обучения/развёртывания (Kubernetes) и масштабируемые хранилища.
- Безопасность: IAM, аудит доступа, шифрование данных в покое и в транзите.
- CI/CD для моделей (MLflow + GitHub Actions / GitLab CI).
-
Процессы:
- Жизненный цикл модели: регистр моделей, версии, тесты на качество, ретренинг по расписанию.
- Мониторинг производительности и данных в продакшне.
- План "вывода" и безопасного обновления моделей.
Люди:
- Назначены ответственные за данные, инфраструктуру, пайплайны и бизнес-наклонности.
- Программы обучения и поддержка внутри команды.
- Регулярные обзоры изменений и коммуникации между командами.
Российские решения и примеры внедрения
- Yandex DataSphere (DS) и Yandex ML Platforms: российские решения для разработки и развёртывания моделей, предоставляющие управляемые пайплайны, мониторинг, управление версиями и соответствие требованиям по безопасности и локализации данных.
- СберCloud AI/ML-платформы: инфраструктурные и сервисные компоненты для работы с ML, включая управление данными, экспериментами и деплоем моделей в условиях российского правообладания.
- DeepPavlov: набор инструментов и готовых моделей для NLP на базе российского сообщества исследователей; полезен для демонстраций и прототипирования локально в рамках компаний.
- Внутренние корпоративные решения и эксперименты: многие крупные российские организации внедряют ML-платформы, управляемые через собственные средние и крупные окружения, с акцентом на безопасность данных и соответствие требованиям законодательства.
Пример чек-листа в виде таблицы (уровни, направления)
| Уровень зрелости | Данные | Инфраструктура | Процессы | Люди |
|---|---|---|---|---|
| Начальный | Нет формальных контрактов, данные разбросаны | Ручной доступ к средам, без версионности | Нет стандартизированного цикла разработки | Нет выделенных ролей, ограниченная обучаемость |
| Определённый | Контракты данных частично прописаны, наборы согласованы | Регистрация сред и версий, базовые IAM | Есть дефиниции процессов, но миграции редки | Назначены роли: data owner, ML eng; базовое обучение |
| Управляемый | Контракты говорят о датах обновления, качество данных стабилизировано | CI/CD для пайплайнов, мониторинг инфраструктуры | Пайплайны обучены, валидация данных автоматизирована | Команда обучена, процессы документированы, бизнес-активности вовлечены |
| Оптимизированный | Контракты данных автоматизированы, данных хватает для ретренинга | Автоматизированное масштабирование, audited deployment | Полная observability, A/B тестирование, продвинутые метрики | Высокий уровень компетенций, культура инноваций и обучения |
Данные: качество, контракты, прослеживаемость
- Контракты данных (data contracts): формализация требований к формату, диапазонам значений, частоте обновления и источникам.
- Прослеживаемость данных (data lineage): знание того, как данные попадают в моделируемый набор, какие трансформации происходят, какие источники задействованы.
- Контроль качества данных: регулярные проверки на полноту, точность, валидность и согласованность данных.
Пример кода: простейшая валидация данных с использованием Great Expectations (GE).
# expectations.yaml
datasource:
  name: my_datasource
  class_name: Datasource
expectations_suite_name: data_quality_suite
data_docs_sites:
  - type: "html"
    site_name: "data_docs"
    base_url: "http://localhost:8000"
# validate.py
from great_expectations.data_context import DataContext

ctx = DataContext("path/to/GE/data_context.json")
suite = ctx.get_expectation_suite("data_quality_suite")
results = ctx.run_validation_operator("validate_everything", assets_to_validate=None)
print(results.success)
Ожидаемые проверки в GE могут включать:
- наличие необходимых столбцов и их типы;
- диапазоны значений;
- отсутствие null-значений в критичных полях;
- уникальность ключевых полей;
- проверка распределений.
Инфраструктура: мощности, безопасность, управляемость
- Модель инфраструктуры: кластеризация для обучения и инференса (Kubernetes, контейнеры), GPU-узлы для ускорения обучения.
- Безопасность: IAM, RBAC, шифрование данных в покое и в транзите, аудит действий.
- Управление версиями: Git для кода, DVC или MLflow для данных и артефактов, MLflow для метрик.
Пример YAML конфигурации для Kubernetes-пайплайна (упрощённый):
apiVersion: batch/v1
kind: Job
metadata:
  name: train-model
spec:
  template:
    spec:
      containers:
      - name: trainer
        image: myregistry/ml-trainer:v1.0
        command: ["bash", "-lc", "python train.py --config=config.yaml"]
        resources:
          limits:
            nvidia.com/gpu: 1
            cpu: "4"
            memory: "16Gi"
        env:
        - name: DATA_PATH
          value: "/data/training"
        - name: MODEL_OUTPUT
          value: "/models/latest"
      restartPolicy: OnFailure
Процессы: жизненный цикл и CI/CD для моделей
- Жизненный цикл модели (ML lifecycle): сборка данных -> подготовка данных -> обучение -> валидация -> развёртывание -> мониторинг -> ретренинг.
- CI/CD для моделей: автоматическая проверка данных и моделей на качество, тестирование гипотез, развёртывание через canary/A/B тестирование.
Пример GitHub Actions workflow (упрощённый):
name: ML CI/CD

on:
  push:
    branches: [ main ]

jobs:
  train-and-test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - name: Setup Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.9'
      - name: Install deps
        run: |
          python -m pip install -r requirements.txt
      - name: Run tests
        run: |
          pytest tests/
      - name: Train model
        run: |
          python train.py --config=config.yaml
      - name: Publish metrics
        run: |
          python track.py --output metrics.json
Люди: роли, обучение, адаптация
- Роли: data owner (владелец данных), data steward, ML engineer, MLOps инженер, security/QA специалист, бизнес-бренч.
- Обучение: программы повышения квалификации по ML-методологиям, безопасной работе с данными, этике и регуляторике.
- Коммуникации: регулярные обзоры рисков, демонстрации бизнес-ценности и прогресса проекта.
Риски и ограничения внедрения
Проблемы с данными:
- Неполнота и несогласованность данных между системами;
- Неправильная или задержанная маркировка/обновление;
- Утечки и нарушение приватности, особенно с персональными данными.
Риски инфраструктуры:
- Недостаточная безопасность или управление доступом;
- Вопросы к масштабированию и резервированию;
- Зависимость от поставщиков и возможные санкционные ограничения в части российского рынка.
Риски процессов:
- Неполная интеграция с бизнес-процессами;
- Непредсказуемость поведения моделей в продакшне;
- Отсутствие полноценного мониторинга и управляемого ретренинга.
Риски людей:
- Недостаток квалификации и сопротивление изменениям;
- Неправильная мотивация и неверная интерпретация результатов;
- Разрыв между бизнес-целями и техническими задачами.
Ограничения и методологические риски:
- Избыточная бюрократия и медленная адаптация;
- Неправильное использование метрик; перекос в KPI;
- Проблемы внедрения в условиях локальных нормативов и кибербезопасности.
Ограничения по данным и регуляторике:
- Нормы локализации данных и доступ к данным;
- Требования к хранению и обработке данных (GDPR, локальные законы в России и другие регионы).
Как минимизировать риски:
- внедрять data contracts и lineage с использованием GE и каталогов;
- строить observability и мониторинг на ранних стадиях;
- проводить пилоты и A/B тесты перед полномасштабным развёртыванием;
- разворачивать ретренинг и обновления через управляемые пайплайны и каналы уведомлений;
- обучать сотрудников и внедрять культуру ответствующего использования моделей.
Выводы
- Чек-листы готовности — критически важный инструмент для системной оценки и планирования внедрения AI в организации. Они помогают структурировать требования к данным, инфраструктуре, процессам и людям, связывая их с KPI и стратегией бизнеса.
- В интеграции с open-source и российскими решениями можно получить мощные инструменты для контроля качества данных, управления пайплайнами и мониторинга моделей.
- Важен баланс между техническими решениями и организационными процессами: без ясных ролей, обученных сотрудников и культурной поддержки любые технологии неизбежно столкнутся с препятствиями.
- Управление рисками и ограничениями должно быть встроено в процесс освоения зрелости: регулярно оценивайте риск-идентификацию и корректируйте план внедрения.
FAQ (Вопросы и ответы)
1) Что именно включают четыре направления чек-листа: данные, инфраструктура, процессы и люди?
- Данные: качество, контракты данных, прослеживаемость, доступ к данным и правовые вопросы.
- Инфраструктура: вычислительные мощности, хранение, безопасность, управляемость версий и доступ.
- Процессы: жизненный цикл ML, CI/CD, тестирование и мониторинг, регламент изменений.
- Люди: роли и ответственности, обучение, вовлечённость бизнеса, культура и коммуникации.
2) Какие KPI подходят для оценки готовности по данным?
- Процент заполненных обязательных полей, уровень полноты датасета, частота обновления данных, доля данных с контрактами, прослеживаемость источников, количество ошибок данных, среднее время обнаружения дефектов.
3) Какие open-source инструменты наиболее полезны для реализации чек-листов?
- Great Expectations (контракты данных и качество), MLflow (отслеживание экспериментов и моделей), DVC (версионирование данных), Kubeflow и Airflow (пайплайны), Prometheus/Grafana (наблюдаемость), Amundsen/Atlas (каталоги метаданных).
4) Что такое data contract и зачем он нужен?
- Data contract — это соглашение между источником данных и потребителем, фиксирующее формат, типы, диапазоны значений и частоту обновления. Он снижает риски несогласованности и упрощает интеграцию.
5) Где взять готовые российские решения и как они дополняют open-source?
- Российские платформы, такие как Yandex DataSphere и решения от СберCloud, дополняют open-source готовыми интеграциями, безопасностью, локализацией и соблюдением регуляторики. Они также поддерживают локальный запас знаний и инфраструктуры, что важно в части соответствия требованиям.
6) Какие риски наиболее критичны на старте внедрения?
- Неполнота и качество данных, несоответствие требования безопасности и приватности, отсутствие компетенций в команде, слабый мониторинг, управляемость и ретренинг.
7) Как понять, что пришло время переходить на следующий уровень зрелости?
- Когда текущие чек-листы по всем направлениям показывают устойчивые результаты и metrices достигают целевых значений, есть задокументированные процессы, внедрённый ретренинг, есть бизнес-метрики, которые демонстрируют ценность проекта.
8) Какие примеры кода полезны для старта?
- Примеры GE suite для контракта данных, примеры CI/CD пайплайнов для ML, YAML-файлы Kubernetes и Terraform для инфраструктуры, а также базовые скрипты мониторинга и ретренинга.
9) Можно ли начать внедрение чек-листов без крупных инвестиций в инфраструктуру?
- Да. Начните с документирования текущего состояния и внедрите базовые проверки качества данных и простые пайплайны на существующей инфраструктуре. Со временем можно расширять пул инструментов и автоматизировать больше процессов.
10) Как связать чек-листы с бизнес-целями и KPI?
- Установите бизнес-цели (например, улучшение точности прогноза на X%, снижение задержек на Y%), затем сопоставьте каждую проверку чек-листа с конкретным KPI. Регулярно оценивайте прогресс, проводите анализ влияния изменений на бизнес-результаты.
Если вы рассматриваете AI как часть цифровой трансформации компании, мы поможем сформировать дорожную карту, оценить риски и запустить пилот с понятными метриками эффективности.


