

Что лучше для бизнеса - Trino или StarRocks?
В этой статье мы хотим поделиться с Вами глубоким анализом двух ведущих open-source движков для выполнения запросов к большим данным - Trino и StarRocks. Этот материал основан на реальном опыте внедрения, тестирования и эксплуатации обеих систем, а также на последних технических данных по состоянию на конец 2023 года.
Не секрет, что современный бизнес зависит от данных. Но данные лежат в разных местах: в классических реляционных базах данных, в огромных data lakes на основе Apache Hive, Iceberg, Hudi или Delta Lake, в системах реального времени типа Kafka и т.д. И задача аналитика в данном случае заключается в том, чтобы быстро получить ответ на сложный вопрос, соединив информацию из всех этих разрозненных источников. Именно для этого и созданы такие распределенные SQL-движки, как Trino и StarRocks.
Однако их философия и сильные стороны существенно различаются. Неверный выбор может привести к миллионным затратам на инфраструктуру, к недовольству пользователей медленными отчетами и к бесконечной дополнительной настройке системы. Давайте поговорим об этом более подробно.

От Presto к Trino и рождение StarRocks
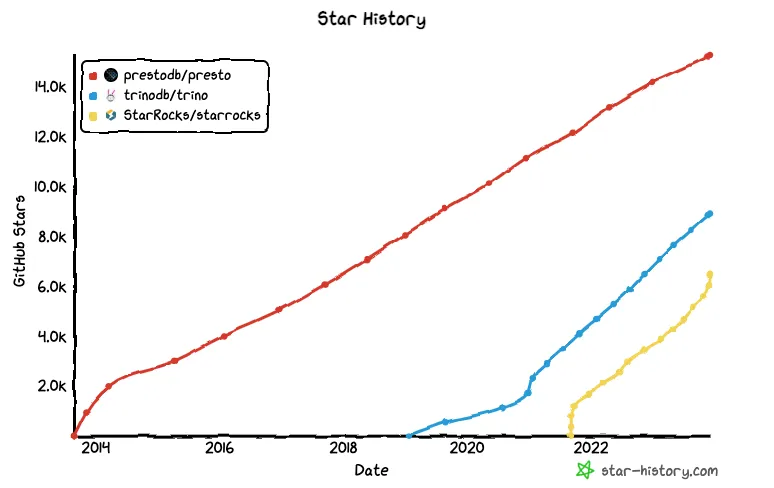
Чтобы лучше понять современное состояние дел, нужно немного оглянуться назад. Trino — это прямое продолжение проекта Presto, который был создан внутри Facebook еще в 2012 году для решения проблем медлительности Apache Hive. Его появление стало настоящей революцией: впервые можно было выполнять интерактивные запросы к петабайтам данных в Hadoop, соединяя информацию из разных источников.
В 2018 году сообщество Presto раскололось, и одна из ветвей, PrestoSQL, позже была переименована в Trino. Сегодня это уже зрелый, проверенный временем проект с огромной экосистемой.
StarRocks — это более молодой и амбициозный проект, изначально разработанный в Китае и переданный в Linux Foundation в 2023 году. Его создатели, имея богатый опыт работы с базами данных, с самого начала заточили его под совершенно другие требования: не просто запросы к любым данным, а молниеносные запросы к огромным объемам структурированных данных с максимальной конкурентной нагрузкой (сотни и тысячи одновременных пользователей).
Совет:
Если Ваш проект существует достаточно давно и построен вокруг Hadoop-экосистемы, то Trino может показаться Вам более привычным и предсказуемым вариантом. Если же Вы строите новую, высокопроизводительную аналитическую платформу с нуля и Ваши ключевые метрики — это скорость отклика и количество поддерживаемых пользователей, то Вам стоит внимательнее присмотреться к StarRocks.
В чем движки похожи?
Massively Parallel Processing (MPP)
И Trino, и StarRocks используют MPP-архитектуру. Ваш SQL-запрос разбивается на множество мелких задач, которые выполняются параллельно на десятках или сотнях серверов. Это и есть основа высокой производительности.
Cost-based Optimizer
Оба движка используют Cost-Based Optimizer. Когда Вы делаете JOIN пяти таблиц, движок не будет выполнять их в том порядке, как вы написали в SQL. CBO анализирует статистику (размеры таблиц, фильтры) и вычисляет самый дешевый по ресурсам план выполнения. Это критически важно для выполнения сложных запросов.
Конвейерное выполнение
Эта технология позволяет максимально эффективно использовать ресурсы CPU на каждом сервере внутри кластера, уменьшая накладные расходы на планирование задач и повышая утилизацию процессоров.
Поддержка ANSI SQL
Ваши аналитики смогут работать с обоими движками через привычный SQL и подключать стандартные BI-инструменты типа Tableau, Power BI или Superset.
Примечание:
Даже при наличии CBO его качество сильно зависит от актуальной статистики. Частая ошибка — забывать настраивать сбор статистики по данным. Это приводит к тому, что CBO выбирает неоптимальный план, и запрос, который должен выполняться секунду, вдруг работает минуту. Это общая проблема для обоих движков, и ее нужно иметь в виду при администрировании.
Чем движки отличаются друг от друга?
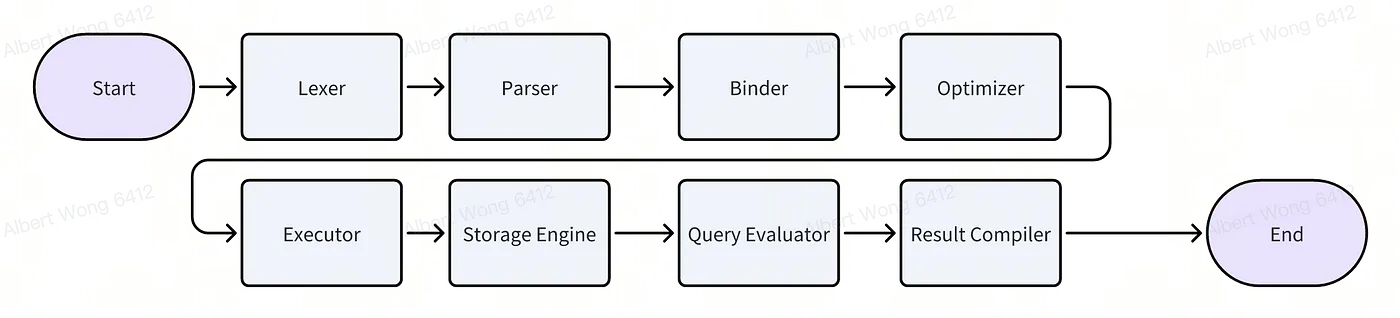
Векторизованное выполнение запросов
StarRocks написан на C++ и изначально спроектирован как полностью векторизованный. Это означает, что он обрабатывает данные не построчно, а блоками (векторами), что позволяет максимально эффективно использовать кеш CPU, задействовать SIMD-инструкции современных процессоров (одна инструкция применяется к множеству данных сразу), а также сильнее сжимать данные в оперативной памяти.
Представьте запрос, который суммирует продажи по месяцам. Векторизованный движок загрузит блок значений колонки sales, затем блок значений колонки month, применит к ним SIMD-инструкции сложения и группировки и почти мгновенно вернет результат. Обычный движок будет обрабатывать каждую строку по отдельности, что требует гораздо больше тактов CPU.
По заявлениям StarRocks и независимым тестам, это дает выигрыш в 3-10 раз на агрегациях и фильтрациях (!)
Движок Trino написан на Java, и его векторизация находится на более ранней стадии развития. Хотя некоторые элементы уже векторизованы (например, обработка отдельных операторов), сквозного векторизованного выполнения пока нет. Сообщество активно над этим работает (проект Velox от Meta), но пока это не является сильной стороной Trino.
Примечание:
Velox — это открытая библиотека на C++, которая реализует нативный векторизованный движок выполнения запросов. Важно понимать, что это не законченный продукт (как Trino), а именно библиотека (компонент), которую можно встроить в другие data-системы, чтобы кардинально повысить их эффективность и производительность.
Проще говоря, Velox — это попытка создать единый, высокооптимизированный «мозг» для выполнения вычислений, который можно использовать в самых разных фреймворках, избавившись от необходимости каждому из них изобретать свой велосипед.
Если эта концепция получит более широкое распространение, это может привести к новой волне инноваций в области обработки данных, где разработчики будут собирать сложные системы из лучших готовых компонентов, как из конструктора Lego.
Вернемся к основной теме нашей статьи и подчеркнем тот факт, что если Ваша нагрузка — это множество быстрых агрегирующих запросов (дашборды, оперативная отчетность), векторизация StarRocks даст Вам немедленное и заметное преимущество.
Материализованные представления
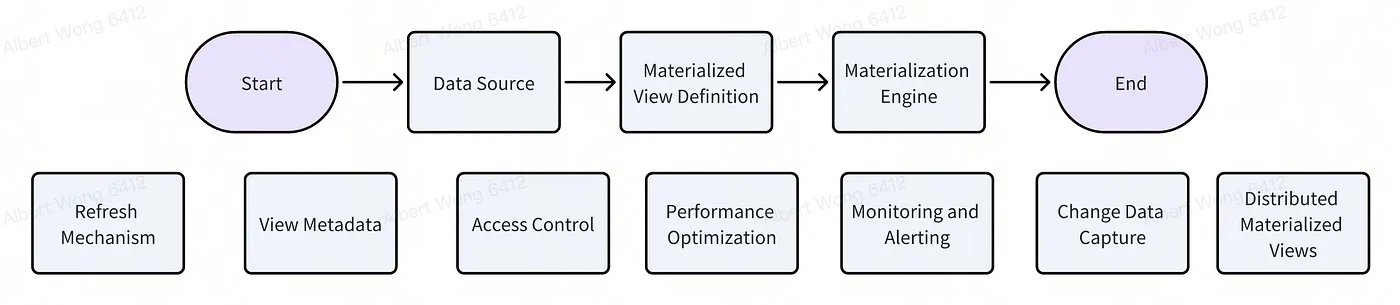
Это одна из самых мощных функций для ускорения запросов.
В StarRocks реализован полнофункциональный подход.
Вы создаете материализованное представление, которое предварительно агрегирует данные, например, по часам. Когда пользователь делает запрос с детализацией по дням, движок автоматически понимает, что можно использовать готовые часовые агрегаты, а не пересчитывать все из сырых данных. Пользователь даже не знает, что его запрос был перенаправлен на MV.
MV обновляются в фоне, не мешая основным запросам.
Если у Вас данные партиционированы по дням, то при поступлении новых данных обновится только последняя партиция MV, а не вся таблица целиком.
Пример:
Один из наших клиентов имел дашборд с 20 ключевыми метриками, каждый запрос к которому сканировал миллиарды строк. Создание MV с предварительной агрегацией сократило время ответа с 45 секунд до 0.5 секунд. Ошибка, которую они допустили сначала — попытка создать одно гигантское MV на все случаи жизни. Правильный подход — создать несколько более мелких MV, под каждую частую бизнес-логику.
Что же касается Trino, то поддержка MV на данный момент существенно ограничена.
Чтобы использовать MV, аналитик должен вручную изменить свой SQL-запрос, чтобы он явно обратился к материализованному представлению. Это сводит на нет всю пользу для конечных пользователей. Кроме того, есть определенные сложности с обновлением - актуальность данных в MV приходится контролировать своими силами. Вообще, MV в Trino — это скорее "костыль", требующий ручного труда и высокой квалификации инженеров данных. В большой команде аналитиков заставить всех использовать правильные MV практически невозможно…
Система кэширования
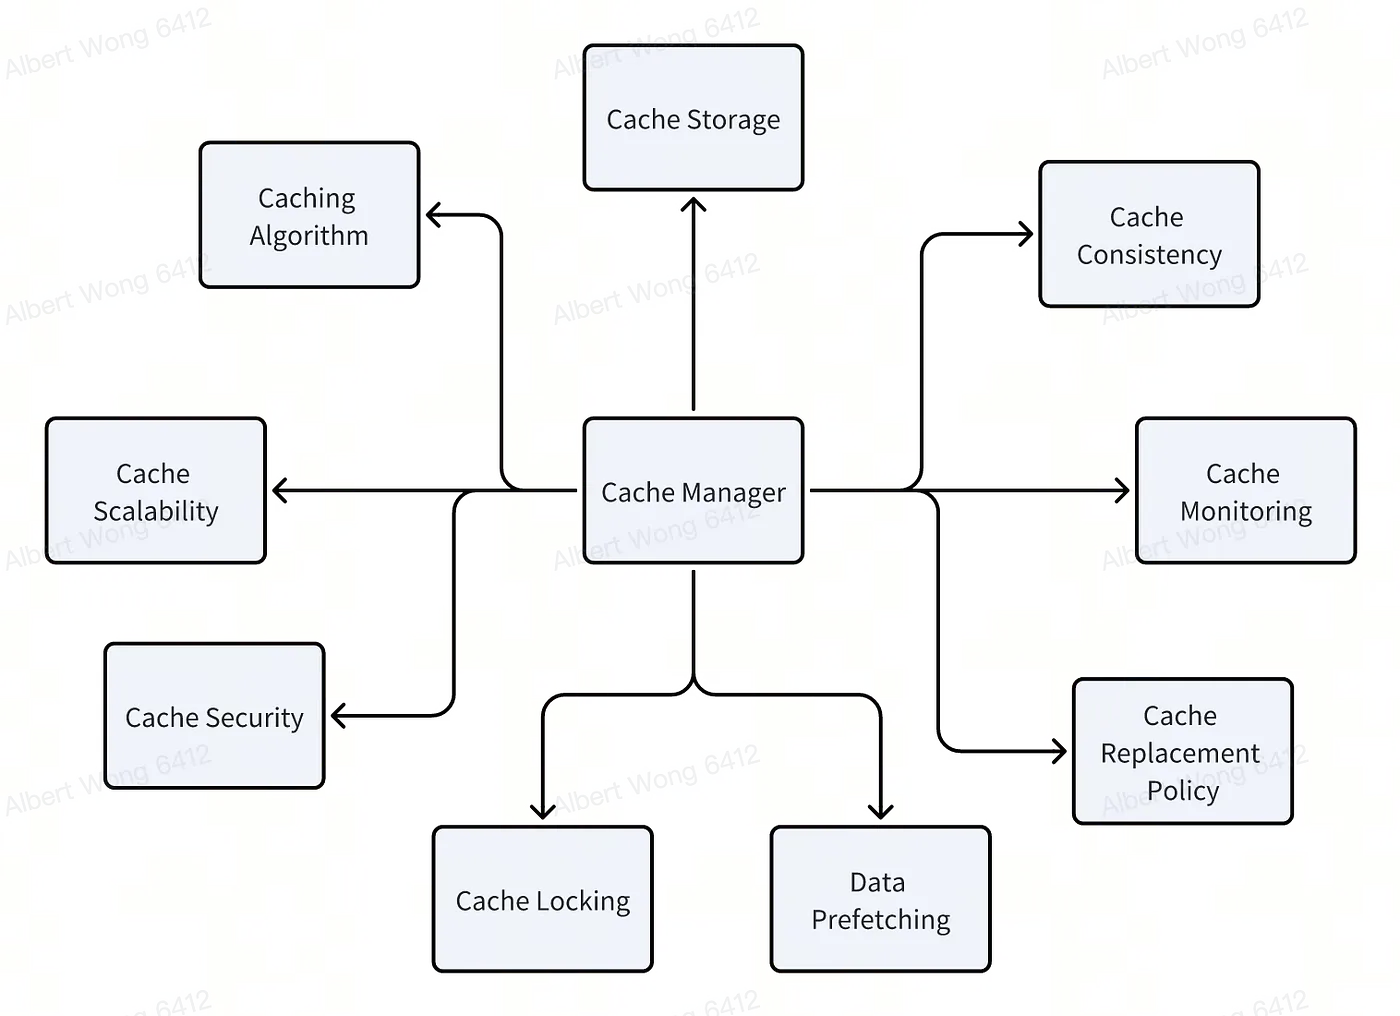
Кэш — это то, что позволяет выдерживать пиковые нагрузки и обеспечивать стабильность скорости ответа.
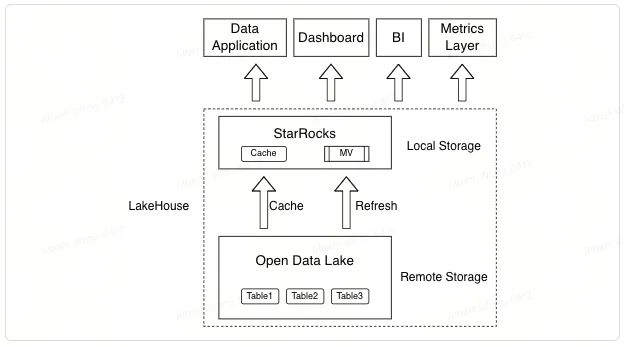
StarRocks имеет многоуровневую систему кэширования (память + диск) на каждом узле. Кэшируются не только конечные результаты, но и промежуточные данные запросов. Это означает, что даже если два запроса не идентичны, но используют общие подмножества данных (например, один запрос за январь-март, а второй за январь-апрель), второй запрос может частично использовать закэшированные результаты за январь-март.
В течение дня пользователи часто запрашивают данные за текущий и прошедший месяц. Благодаря кэшу промежуточных результатов, после первого же запуска такого запроса, последующие будут выполняться в разы быстрее, так как основные блоки данных уже находятся в кэше узлов.
В случае с Trino кэширование в основном работает на уровне оперативной памяти. Это очень быстро, но требует огромного объема RAM и не так эффективно справляется с разнородной нагрузкой. Работа над дисковым кэшем ведется, но это пока это только разработка.
В StarRocks важно правильно настроить размер кэша под Ваши данные и паттерны запросов. Слишком маленький кэш будет неэффективен, слишком большой — может привести к нехватке памяти для выполнения самих запросов.
Производительность JOIN
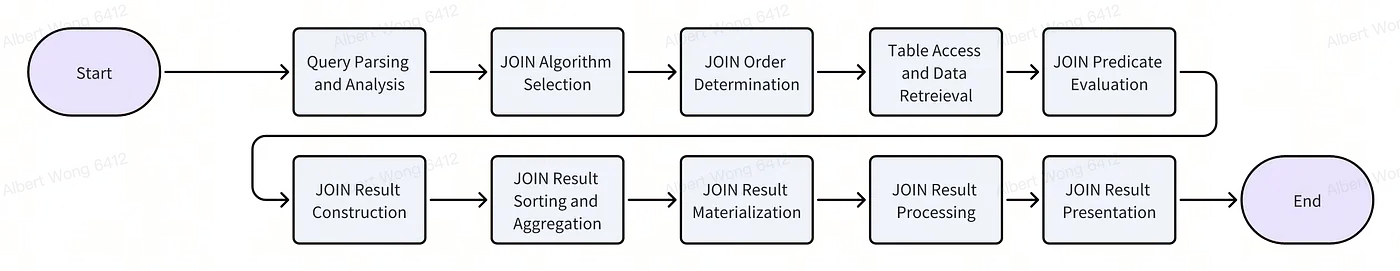
Операции соединения таблиц — это чаще всего самое ресурсоемкое место в запросе.
Оба движка умеют делать сложные JOIN, но StarRocks применяет более агрессивные и разнообразные оптимизации.
StarRocks использует сложные алгоритмы, динамическое программирование и другие методы, чтобы найти самый дешевый план соединения множества таблиц. Кроме того, он применяет runtime-фильтрацию – это крайне важная оптимизация. Представьте, что Вы соединяете огромную таблицу продаж с небольшой таблицей регионов. StarRocks сначала прочитает маленькую таблицу регионов, создаст на ее основе фильтр (например, Bloom Filter) и "протолкнет" этот фильтр на уровень сканирования большой таблицы продаж. Таким образом, из продаж будут считаны только те строки, которые относятся к нужным регионам. Это может сократить объем читаемых данных в десятки раз.
Если Вы заранее знаете, что две таблицы часто соединяются по определенному ключу, вы можете физически разместить их данные на одних и тех же узлах кластера. Это полностью исключает необходимость перемешивания данных (data shuffling) между серверами во время JOIN, что значительно ускоряет процесс обработки запроса.
Пример:
Один из наших клиентов делал JOIN фактовой таблицы на 10 млрд строк с 10 справочниками. В Trino запрос выполнялся 15 минут и часто падал из-за нехватки памяти. В StarRocks, после настройки Runtime Filter и перепартиционирования данных, тот же запрос стал выполняться за 20-30 секунд. Риск здесь в том, что для таких оптимизаций требуется глубокое понимание данных и их распределения в кластере. Без грамотного инженера данных можно не получить никакого выигрыша.
Высокая доступность
В случае StarRocks архитектура изначально спроектирована для высокой доступности. Компоненты Frontend (FE) и Backend (BE) являются многовекторными и реплицируются. Координатор (аналог мастера) автоматически выбирается по протоколу Raft. Это позволяет делать "горячее" обновление кластера без простоя.
Координатор в Trino — это единая точка отказа (Single Point of Failure, SPOF). Если упадет процесс координатора, весь кластер перестанет отвечать на запросы. Обновление кластера требует остановки обслуживания.
Развертывание Trino в продакшене без отказоустойчивости координатора — грубая архитектурная ошибка. Чтобы mitigate этот риск, компании часто разворачивают два независимых кластера Trino и настраивают балансировку нагрузки между ними, что удваивает стоимость инфраструктуры. Сообщество Trino годами обсуждает эту проблему, но решения пока нет.
Поддержка источников данных и открытых форматов
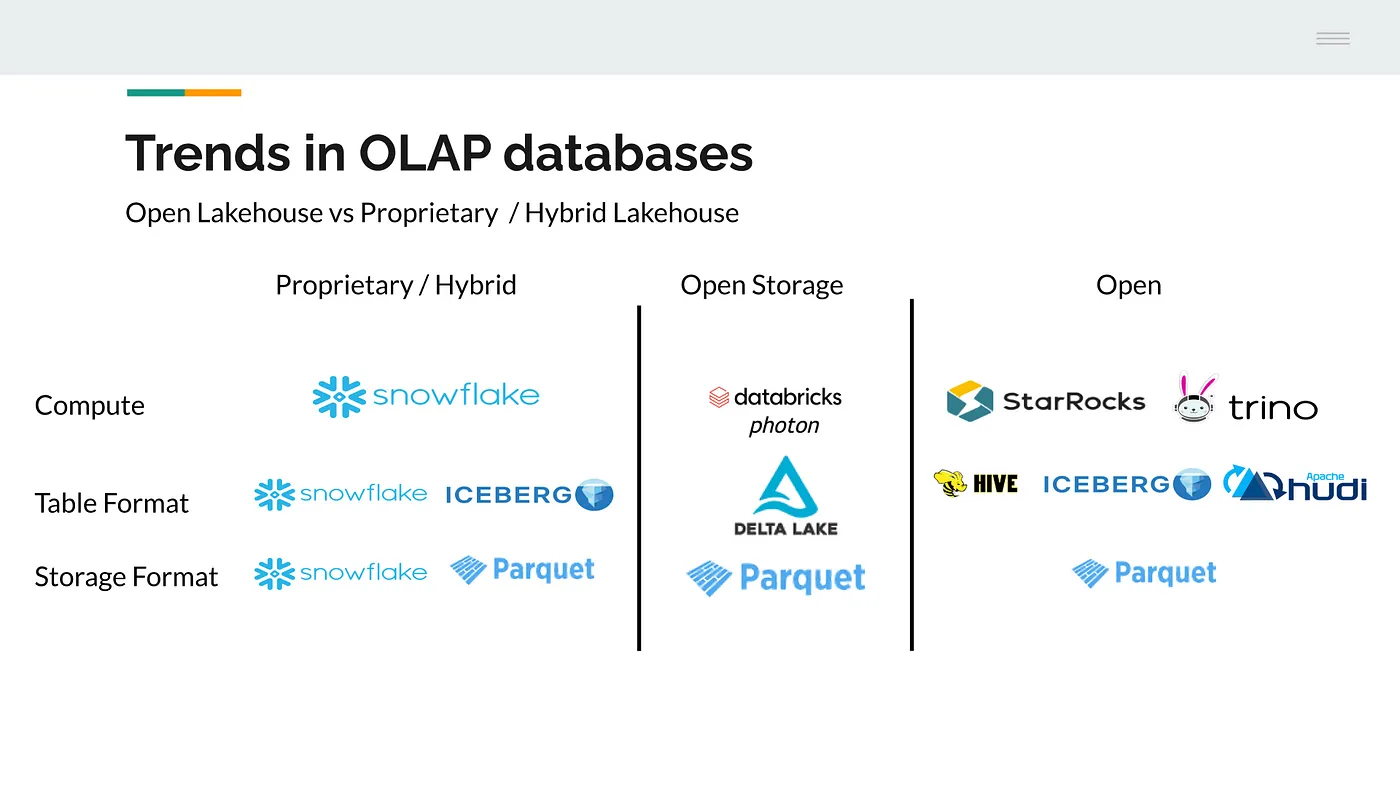
Trino - безусловный лидер по количеству коннекторов (более 60). Это его основная сила. Trino — это идеальный "универсальный солдат" для запросов к чему угодно: от PostgreSQL и Oracle до Kafka и Elasticsearch. Это лучший выбор для концепции Data Mesh.
StarRocks сфокусирован на работе с data lakes (Iceberg, Hudi, Hive, Delta Lake) и своими внутренними таблицами. Его сила — не в универсальности, а в запредельной производительности на своей "территории". Коннекторы к другим источникам данных находятся в разработке.
Пример:
Если Ваша компания имеет 20 разноплановых источников данных (MySQL, MongoDB, SQL Server, S3-бакеты с JSON-логами) и вам нужно делать единые отчеты по всей системе — Trino будет единственным правильным выбором. Если же вы уже консолидировали все данные в центральном data lake в формате Iceberg/Parquet и вам нужна максимальная скорость — выбор смещается в сторону StarRocks.
Бенчмарки и реальная производительность
Команда StarRocks провела тесты по стандарту TPC-DS на 1 ТБ данных в формате Apache Iceberg. Результат: общее время выполнения набора запросов в StarRocks оказалось в 5.54 раза ниже, чем в Trino.
Важно понимать, что это - синтетический тест, который показывает потенциал движков на чистом сценарии "запрос к data lake". В реальности разница может быть как больше (благодаря правильным оптимизациям и кэшу), так и меньше (если запросы очень простые или упираются в скорость чтения из удаленного хранилища, например, S3).
Что же выбрать?
Выбор между Trino и StarRocks — это не выбор между "плохим" и "хорошим". Это выбор между универсальностью и специализацией.
Мы считаем, что Trino – наиболее подходящий вариант в том случае, если:
- Ваша главная задача — выполнять SQL-запросы к десяткам разнородных источников данных (Data Virtualization, Data Mesh);
- Ваша экосистема построена вокруг Hive, и Вы ищете более производительную замену;
- У Вас нет требований к субсекундной задержке для тысяч concurrent-пользователей;
- Вы готовы мириться с риском единой точки отказа и более сложной ручной оптимизацией запросов.
StarRock наиболее оптимален в случае, если:
- Ваши данные уже находятся или будут находиться в data lake (Iceberg, Hudi, Delta);
- Скорость выполнения запросов и низкая задержка — Ваш главный KPI;
- Вам необходимо обслуживать сотни и тысячи одновременных пользователей (например, система отчетности для всех менеджеров компании);
- Вы хотите использовать современные оптимизации "из коробки" (векторизация, автоматические MV, runtime-фильтры) без глубокого погружения в ручную настройку;
- Для вас критически важна отказоустойчивость и возможность обновлять кластер без простоя.
Как видите, нет правильного или неправильного выбора. Есть выбор, который лучше подходит под Ваши конкретные задачи.


