

Что такое глубокая наблюдаемость данных?
Глубокая наблюдаемость данных является действительно всеобъемлющей с точки зрения источников, форматов и гранулярности данных, а также конфигураций валидаторов и пользователей. В этой статье объясняется, чем глубокая наблюдаемость данных отличается от поверхностной: глубокая наблюдаемость данных является действительно всеобъемлющей с точки зрения источников, форматов и гранулярности данных, а также конфигураций валидаторов и пользователей.
Потребность в “глубокой” наблюдаемости данных
2022 год стал годом, когда наблюдаемость данных стала отдельной категорией (в отличие от старых "инструментов качества данных"), а также официальным термином, используемым Gartner. Аналогичным образом Мэтт Тёрк объединил категории качества данных и наблюдаемости данных в анализе MAD Landscape за 2023 год. Тем не менее, отрасль еще не до конца сформирована. В своем отчете под названием "Наблюдаемость данных - восход хранителей данных" Ойвинд Бьерке из MMC Ventures говорит о том, что у этой области есть огромный потенциал для дальнейших инноваций.
Исходя из вышесказанного определим наблюдаемость данных как:
Степень, в которой организация способна наблюдать за конвейерами данных. Высокая степень наблюдаемости данных позволяет командам, работающим с данными, значительно повысить их качество.
Однако не все платформы наблюдаемости данных, т.е. инструменты, специально разработанные для того, чтобы помочь организациям достичь наблюдаемости данных, созданы одинаково. Эти инструменты различаются по степени наблюдаемости данных. Так, мы выделяем глубокую и неглубокую наблюдаемость данных. Они различаются по следующим параметрам: источники данных, форматы данных, гранулярность данных, конфигурация валидатора, частота работы валидатора и ориентация на пользователя.
В оставшейся части статьи мы подробнее поговорим о глубокой наблюдаемости данных и расскажем о шести измерениях, которые отличают "глубокую" наблюдаемость данных от "неглубокой".
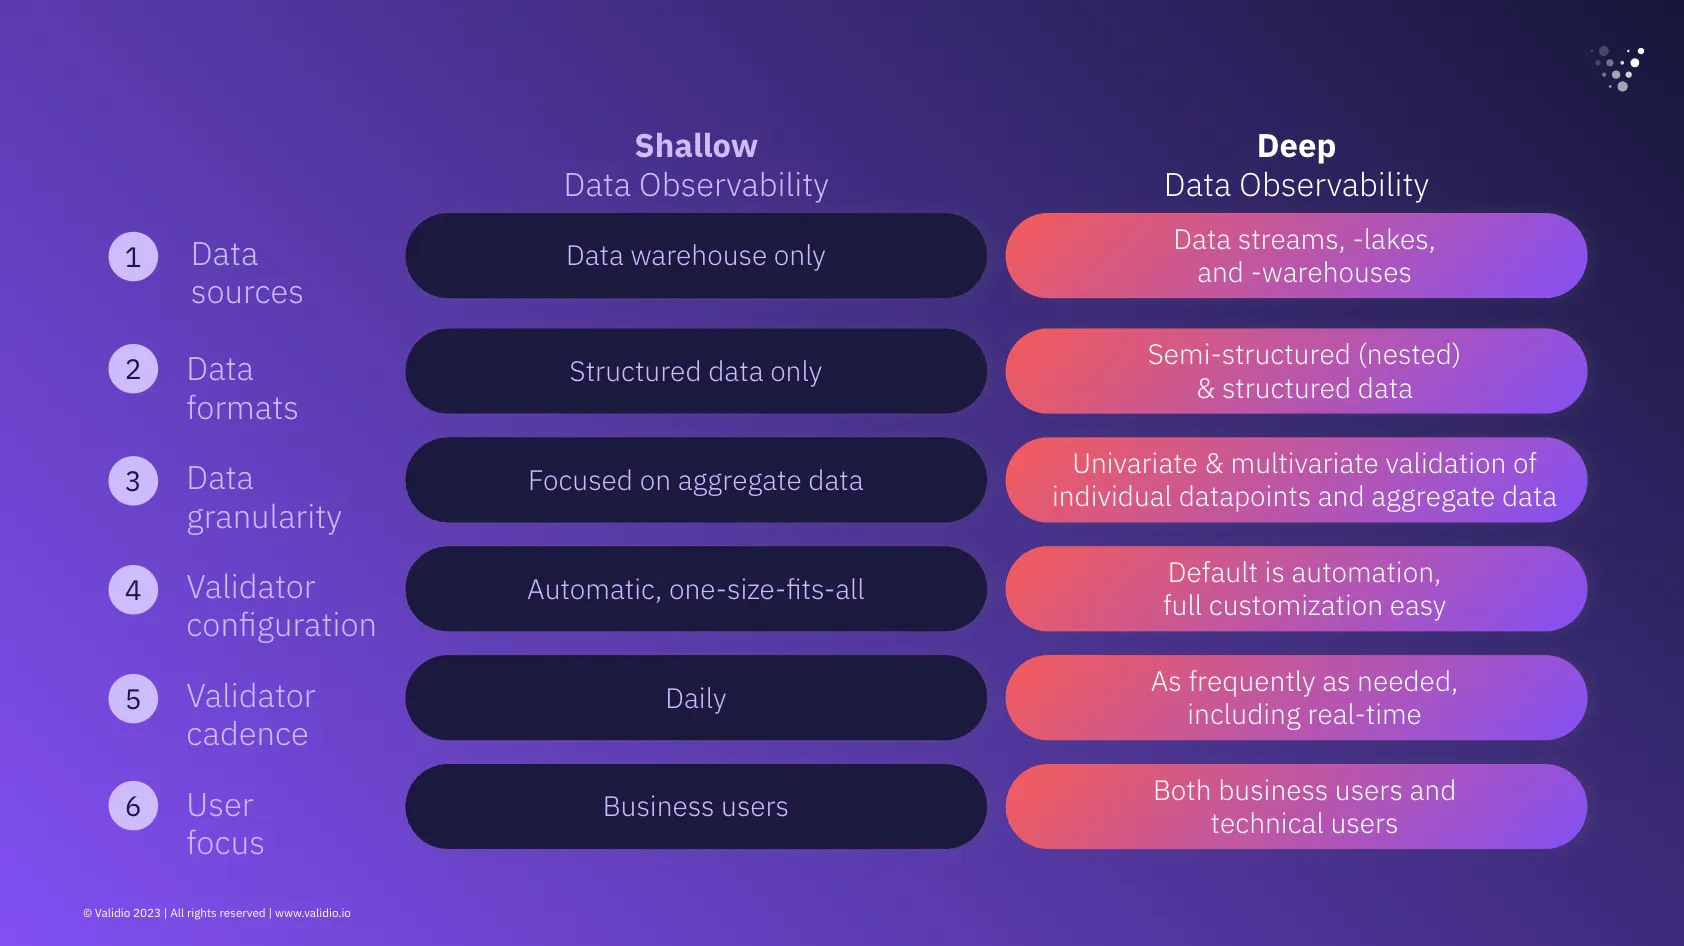
Шесть столпов глубокой наблюдаемости данных
1. Источники данных: необходимо видеть их насквозь
Решения для неглубокой наблюдаемости данных, как правило, ориентированы только на хранилища данных с применением SQL-запросов. Решения для глубокой наблюдаемости данных, напротив, обеспечивают командам, работающим с данными, равную степень наблюдаемости потоков данных, озер данных и хранилищ данных. Это важно по двум причинам:
Во-первых, данные не появляются в хранилище данных как по волшебству. Зачастую они поступают из определенного источника, попадают в озеро данных, и только потом уже - в хранилище данных. Некачественные данные могут появиться везде, поэтому необходимо как можно быстрее выявить проблемы и определить их происхождение.
Во-вторых, как правило, данные никогда не выходят за пределы хранилища данных. Для того чтобы инструмент наблюдения за ними был действенным и приносил пользу, он должен быть сквозным.

2. Форматы данных: структурированные и полуструктурированные
Неглубокая наблюдаемость данных ориентирована на хранилище данных, то есть она обеспечивает наблюдаемость структурированных данных. Однако, чтобы достичь высокой степени наблюдаемости в стеке данных, решение должно поддерживать форматы данных, распространенные и в озерах данных. Благодаря глубокой наблюдаемости данных команды разработчиков могут получать высококачественные данные, отслеживая качество данных не только в структурированных наборах данных, но и во вложенных форматах, например, JSON-блобах.
3. Гранулярность данных: одномерная и многомерная валидация datapoints и агрегированных данных
Изначально "неглубокая наблюдаемость" данных получила известность благодаря анализу одномерной статистики совокупных данных (например, метаданных). Например, просмотр среднего количества нулевых значений в одном столбце.
Однако бесчисленные случаи использования некачественных данных говорят нам о том, что группы обработки данных должны проверять не только сводную статистику и распределения, но и отдельные datapoints. Кроме того, необходимо рассматривать зависимости (многомерные) между полями (или столбцами), а не только отдельные поля, так как реальные данные содержат зависимости, поэтому большинство проблем с качеством данных имеют многомерный характер. Глубокая наблюдаемость данных помогает командам, работающим с данными, выполнять именно эту задачу: одномерную и многомерную проверку отдельных datapoints и агрегированных данных. Рассмотрим пример, когда требуется многомерная проверка.
Приведенный ниже набор данных сегментирован по странам и по типу_продукта (несколько переменных, а не только одна), что необходимо для проверки каждого отдельного подсегмента (набора записей). Каждый подсегмент, вероятно, будет иметь уникальный объем, отклонения и распределение, что означает, что он должен быть проверен в индивидуальном порядке. Допустим, в этом наборе данных отслеживаются все транзакционные данные электронного бизнеса. Тогда каждая страна, скорее всего, будет демонстрировать индивидуальное покупательское поведение, а значит, и валидировать их нужно индивидуально. Щелкнув еще раз, мы можем обнаружить, что в каждой стране каждый тип_продукта также характеризуется различным покупательским поведением. Таким образом, нам необходимо сегментировать оба столбца, чтобы подтвердить достоверность данных. 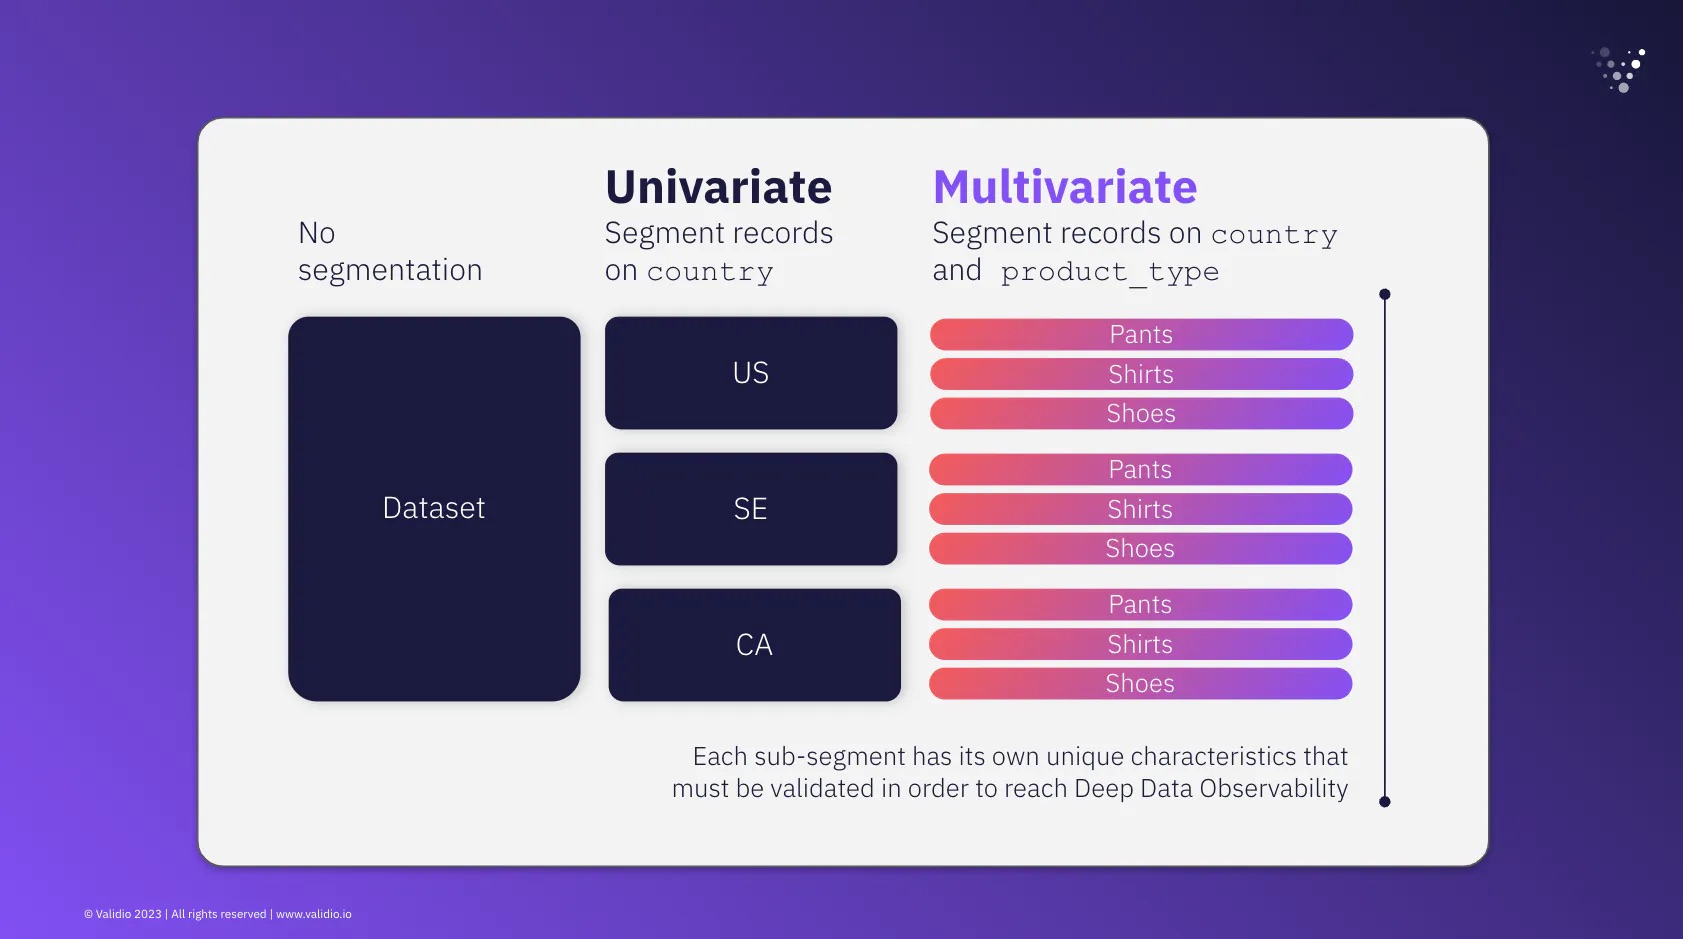
4. Конфигурация валидатора: Автоматическая и ручная настройка
В зависимости от специфики организации Вам может потребоваться различная степень масштабируемости систем данных. Например, если Вы ищете решение по типу "поставил и забыл", то Вам нужна неглубокая наблюдаемость данных. В этом случае Вы получите обзор с высоты птичьего полета, например, всех таблиц в Вашем хранилище данных и их ожидаемого «поведения».
И наоборот, в Вашем бизнесе может быть уникальная бизнес-логика или пользовательские правила проверки, которые необходимо настроить. Степень масштабируемости такой пользовательской настройки определит степень наблюдаемости данных. Если каждое пользовательское правило требует от cпециалиста по данным написания SQL, то это не очень масштабируемая система, и достичь состояния глубокой наблюдаемости данных в таком случае будет очень сложно. Напротив, если у Вас есть быстро реализуемое меню валидаторов, которые можно комбинировать в соответствии с требованиями Вашего бизнеса, то глубокая наблюдаемость данных вполне себе достижима. Настройка пользовательских валидаторов не должна быть уделом только тех, кто хорошо разбирается в коде.
5. Многокадэнсная валидация: так часто, как это необходимо, в том числе и в режиме реального времени
Опять же, в зависимости от потребностей бизнеса, у Вас могут быть различные требования к наблюдаемости данных во времени. Например, предположим, что Вы используете стандартную схему, при которой данные загружаются в хранилище ежедневно. В этом случае неглубокая наблюдаемость данных, поддерживающая только стандартный ежедневный цикл, будет полностью удовлетворять Вашим потребностям.
Если же Ваша инфраструктура данных более сложная, и некоторые источники обновляются в режиме реального времени, некоторые - ежедневно, а другие - реже, то тогда Вам потребуется поддержка проверки данных при всех этих каденциях. Такая потребность в многовариантности особенно актуальна для компаний, полагающихся на данные любого типа для быстрого принятия решений или создания функций продукта в режиме реального времени, например, при динамическом ценообразовании, в приложениях IoT, в розничных компаниях, которые в значительной степени полагаются на цифровой маркетинг и т.д. Платформа глубокой наблюдаемости данных обладает полной поддержкой проверки данных для всех этих сценариев использования. Это дает гарантию того, что Вы получите информацию о данных в нужное время в соответствии с контекстом Вашего бизнеса. Это также означает то, что Вы можете принять меры в отношении плохих данных непосредственно в момент их появления и до того, как они затронут последующие сценарии использования.
6. Ориентация на пользователя: как технического, так и нетехнического
Качество данных по своей сути является проблемой межфункциональной, что отчасти и является причиной того, что ее решение может быть достаточно сложным. Например, человек, который знает, как выглядят "хорошие" данные в наборе данных CRM, может быть продавцом, который работает на местах, совершая звонки по продажам. Таким образом, человек, который перемещает (или вводит) данные из CRM-системы в хранилище данных, может вообще не иметь об этом никакого представления и, естественно, будет больше заинтересован в том, чтобы конвейеры данных работали по расписанию.
Решения с малой степенью наблюдаемости данных ориентированы в основном на одну группу пользователей. Они ориентированы либо на инженеров по обработке данных, которых в основном волнует, как работают конвейеры и масштабируется ли система. Или же они ориентированы на бизнес-пользователей, для которых важны в основном дашборды и сводная статистика.
Глубокая наблюдаемость данных достигается тогда, когда учитываются интересы обеих сторон. На практике это означает предоставление нескольких способов управления платформой наблюдаемости данных: через интерфейс командной строки и через графический интерфейс пользователя. Это также может подразумевать наличие нескольких уровней доступа и привилегий. Таким образом, все пользователи могут совместно работать над настройкой проверки данных и получать высокую степень видимости конвейеров данных. Это, в свою очередь, эффективно демократизирует качество данных в рамках всего бизнеса.
Что дальше?
Мы рассмотрели 6 аспектов, отличающих неглубокую и глубокую наблюдаемость данных. Мы надеемся, что этот обзор дает Вам основу, на которые Вы можете опираться при оценке потребностей Вашего бизнеса в инструментах по обеспечению качества данных и наблюдаемости данных.


