

Что такое Trino и почему он незаменим при обработке Big Data
Сегодня Большие данные воспринимаются как решение многих проблем. Однако они же могут быть и причиной серьезных трудностей.
Да, большие данные могут дать всестороннее и глубокое понимание ситуации, которого у нас никогда раньше не было. Но при этом запросы к ним выполняются крайне медленно, управлять ими дорого, для их обработки требуется много дорогих специалистов, а их объем увеличивается в геометрической прогрессии.
В целом, данные, особенно большие, заставили технологических гигантов заняться разработкой более совершенных инструментов управления данными.
Одной из таких компаний стала Facebook, которая решила, что ей необходимо разработать совершенно новый механизм для эффективной обработки всех своих петабайтов данных. Этот инструмент получил название Presto, который недавно отделился от другого проекта под названием Trino.
В этой статье мы расскажем Вам о том, что такое Trino, почему люди используют его и с какими проблемами сталкиваются при его развертывании.

Что такое Trino
Давайте проясним ситуацию. Trino не БД. Это ошибочное мнение. Если Вы используете Trino для работы с SQL-запросами, это не значит, что Вы работаете с базой данных.
Trino - это движок SQL. Точнее, Trino - это распределенный SQL-движок с открытым исходным кодом для обработки специальных и пакетных ETL –запросов, отправляемых к самым разным источникам данным. Не говоря уже о том, что он может управлять целым рядом стандартных и полуструктурированных типов данных, таких как JSON.
Еще один важный момент, который стоит обсудить - это история Presto. В 2012 году Мартин Траверсо, Дэвид Филлипс, Дайн Сундстром и Эрик Хванг работали в Facebook и в определенный момент создали Presto в качестве альтернативы Apache Hive. Новый инструмент должен был обрабатывать сотни петабайт данных Facebook.
В ноябре 2013 года создатели проекта сделали его открытым. Но из-за того, что Facebook захотела установить более жесткий контроль над проектом, в итоге произошел раскол.
Создатели Presto занялись созданием сообщества open-source проекта, назвав его PrestoSQL.
Facebook решила создать конкурирующее сообщество с помощью Linux Foundation и в качестве первого шага подала заявку на регистрацию товарного знака Presto, что привело к судебным разбирательствам и другим проблемам, которые заставили группу, разработавшую Presto, провести ребрендинг.
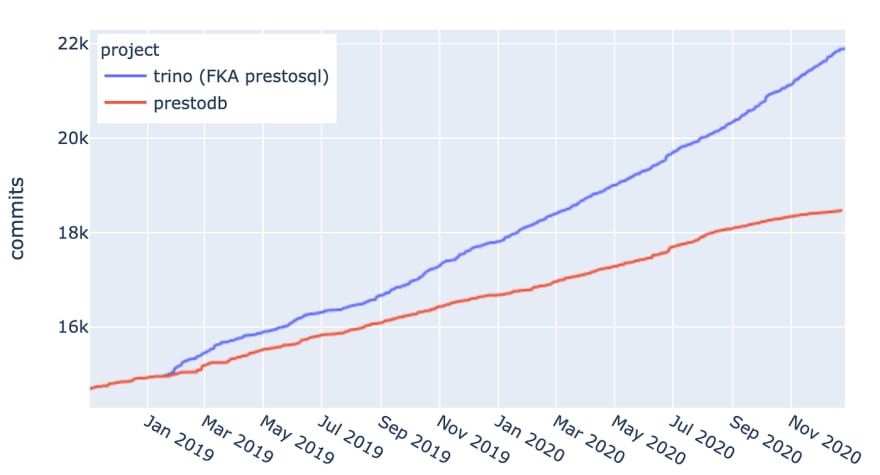
В декабре 2020 года PrestoSQL был переименован в Trino. Сегодня данный проект популярен среди большого количества пользователей, над его развитием трудятся высококвалифицированные разработчики по всему миру.
Принцип работы Trino
Trino - это распределенная система, использующая архитектуру, аналогичную базам данных с массивно-параллельной обработкой (MPP). Как и во многих других системах обработки больших данных, здесь есть узел-координатор, который управляет несколькими рабочими узлами для обработки всей задачи, которую необходимо выполнить.
Аналитик или обычный пользователь отправляет свой SQL-запрос, который передается координатору. Координатор, в свою очередь, анализирует, планирует и распределяет работу. Trino поддерживает стандартный ANSI SQL, а также позволяет пользователям выполнять более сложные преобразования, такие как разбор JSON и MAP.
Почему специалисты выбирают Trino
Trino, являясь побочным продуктом Presto, имеет множество преимуществ, обусловленных тем, что его разработкой занималась крупная компанией, которой нужно было выполнять запросы к различным источникам данных, не тратя много времени на обработку полученных данных. Кроме того, он был разработан для масштабирования на облачной инфраструктуре. Но давайте разберемся, почему же люди используют Trino.
Агностические подключения к источникам данных
Существует множество вариантов того, как можно запрашивать данные. Соответственно, существуют разные инструменты, как Athena, Hive и Apache Drill.
Так зачем же нам Trino?
Trino предоставляет множество преимуществ для разработчиков. Например, главное преимущество Trino состоит в том, что это просто SQL-движок, то есть он располагается поверх различных источников данных, таких как MySQL, HDFS и SQL Server.
Поэтому если Вы хотите выполнить запрос к источникам данных, Вы с легкостью можете это сделать.
Это мощная функция, которая избавляет пользователей от необходимости разбираться в соединениях и диалектах SQL базовых систем.
Фокус на облачных технологиях
Архитектура Presto, предполагающая раздельное хранение и вычисление данных, делает его чрезвычайно удобным для работы в облачных средах. Поскольку кластер Presto не хранит никаких данных, его можно автоматически масштабировать в зависимости от нагрузки.
В каких случаях Trino незаменим
- Специальные запросы и отчетность - Trino позволяет конечным пользователям использовать SQL для выполнения специальных запросов к данным. Более того, Вы можете создавать запросы для формирования самых разных отчетов.
- Аналитика Data Lake - одним из многих распространенных вариантов использования Trino является возможность напрямую запрашивать данные в озере данных без необходимости их преобразования. Вы можете запрашивать структурированные или полуструктурированные данные из различных источников и на их основе оперативно создавать красивые информативные дашборды.
- Пакетная ETL обработка данных - Trino является отличным инструментом для выполнения пакетных ETL-запросов. Это связано с тем, что он может быстро обрабатывать большие объемы данных, а также получать данные из различных источников.
Сложности использования Trino
Для эффективного использования Trino требуется довольно много настроек, сопряженных с рядом трудностей.
Медленная обработка федеративных запросов
Единственным недостатком федеративных запросов является то, что для их обработки требуется достаточно большое количество времени, что может быть вызвано отсутствием метаданных. Кроме того, Presto изначально разрабатывался в Facebook, у которой есть собственное облако, для нее не представляет большой проблемы расширить его при необходимости. Другим же организациям для того, чтобы получить такой же уровень производительности, возможно, придется потратить огромное количество денег на добавление машин в свои кластеры.
Одним из таких примеров является Varada. Varada индексирует данные в Trino таким образом, что сокращает время использования процессора для сканирования данных (с помощью индексов) и освобождает процессор для других задач, таких как очень быстрое получение данных или работа с параллелизмом. Таким образом, пользователи SQL могут выполнять различные запросы, как по измерениям, так и по фактам, а также другие типы объединений и аналитики на основе данных, на индексированных данных в качестве объединенных источников данных. Агрегация и группировка данных SQL также ускоряется с помощью наноблочных индексов, что приводит к высокоэффективной аналитике SQL.
Установка и настройка
Настройка Trino - дело непростое. Особенно когда речь идет об оптимизации производительности и управления. При настройке экземпляров Trino многим системным администраторам и ИТ-командам требуются помощь специалистов.
Недостаток корпоративных опций
Одна из самых больших проблем, с которой сталкиваются компании, использующие Trino, заключается в том, что у него не так много функций, ориентированных на корпоративные решения. То есть функции, связанные с безопасностью, контролем доступа и даже расширенным подключением к источникам данных, ограничены. Поэтому приходится пользоваться сторонними решениями, одним из которых является Starburst Data. Помимо всего прочего Starburst облегчает настройку контроля доступа. Все системы управления доступом работают на основе ролевых механизмов управления доступом с пользователями, группами, ролями, привилегиями и объектами.
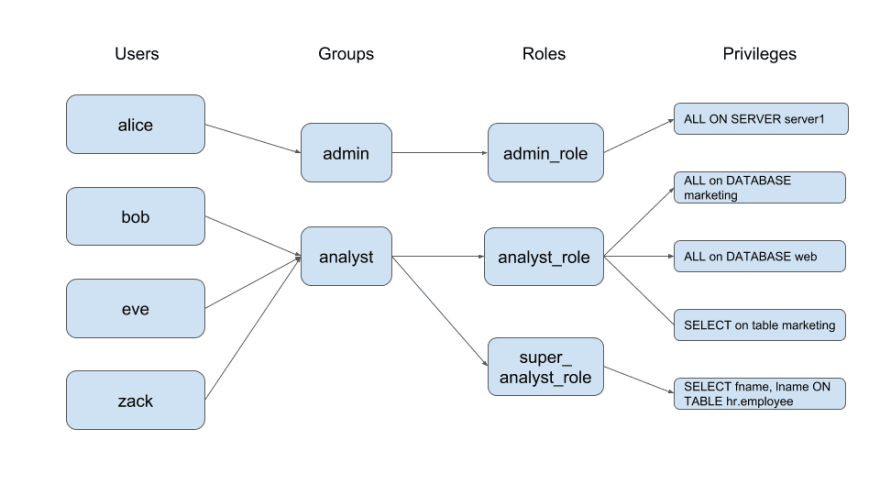
Это облегчает командам безопасности и администраторам DWH задачу управления доступом к данным. Starburst также предлагает другие полезные функции безопасности, такие как аудит и шифрование данных. Все эти решения позволяют компаниям внедрять централизованную систему безопасности, не прибегая к разработке собственных модулей Trino.
Заключение
Большие данные будут оставаться большой проблемой для компаний, которые не заинтересованы в поиске инструментов управления данными, подобных Trino. Способность Trino быть агностическим SQL-движком, который может запрашивать большие массивы данных из разных источников, - отличный вариант для многих современных организаций. Но, как уже говорилось ранее, Trino далек от совершенства, за скорость его работы иногда приходится очень дорого расплачиваться.
Именно поэтому появляется множество новых решений, позволяющих сделать Trino более доступным. В конце концов, управлять большими данными можно, Вам просто нужны правильные инструменты.


