

ClickHouse: вставка нескольких миллионов записей всего за несколько секунд
ClickHouse - это колоночно-ориентированная система управления базами данных с открытым исходным кодом, специализирующаяся на быстром анализе больших объемов данных. Основная цель ClickHouse – молниеносное выполнение запросов на анализ данных и масштабирование для обработки больших объемов информации.
Ключевые преимущества ClickHouse:
- Высокая скорость обработки данных: ClickHouse предназначен для быстрого анализа больших объемов данных. В данной СУБД используются различные оптимизации, такие как колоночное хранение данных, что значительно уменьшает размер данных, хранящихся в памяти, и повышает скорость обработки запросов.
- Масштабируемость: ClickHouse легко масштабируется как по горизонтали (путем добавления новых серверов), так и по вертикали (путем увеличения ресурсов на существующих серверах). Это позволяет работать с большими объемами данных и увеличивать производительность системы по мере необходимости.
- Эффективность за счет колоночно-ориентированного хранения данных: ClickHouse использует столбцовое хранение данных, что позволяет оптимизировать выполнение агрегированных запросов, агрегацию данных, а также аналитические операции с большими объемами данных.
- Поддержка SQL: ClickHouse поддерживает стандартный SQL, что делает его относительно простым в использовании. Это позволяет выполнять сложные аналитические запросы и агрегации без особых усилий.
- Оптимизация памяти и дисков: ClickHouse эффективно использует память и дисковое пространство для оптимизации обработки данных, позволяя работать с большими объемами информации на ограниченных ресурсах.

Конечно, ClickHouse можно интегрировать со множеством сторонних систем, в том числе с библиотеками. Я решил воспользоваться библиотекой Pandahouse.
Рассмотрим вставку файла и чтение запроса для дальнейшей аналитической обработки.
Я взял файл с 5 миллионами записей (примерно ~500 мегабайт):
Тест #1 (проверяем скорость вставки данных)
Я использовал метод to_clickhouse, у которого есть несколько важных параметров, таких как df и chunksize. Второй особенно важен, так как именно он позволяет добиться высокой скорости обработки запросов.
Сначала создадим саму таблицу.
CREATE TABLE ibm_small_transactions ( date_t Date, from_bank Int64, account String, to_bank Int64, account_1 String, amount_received Float64, receiving_currency String, amount_paid Float64, payment_currency String, payment_format String, is_laundering Int64 ) engine = MergeTree() PARTITION BY toYYYYMMDD(date_t) ORDER BY date_t SETTINGS index_granularity = 8192;
Далее создадим цикл, который будет перебирать общий фрейм данных по фрагментам (df_day) и их размеру (chunksize), а затем передавать каждый результат в to_clickhouse.
import pandas as pd
import pandahouse as ph
connection = {'host': 'http://localhost:8123', 'database': 'default'}
for date in pd.date_range(start='2022-09-01', end='2022-09-18', freq='D'):
    date_str = date.strftime('%Y-%m-%d')
        df_day = df[df['date_t'] == date_str]
        chunksize = len(df_day)
        print(f"Date: {date_str}, Length: {chunksize}")
    ph.to_clickhouse(df_day, table='ibm_small_transactions', chunksize=chunksize,
                     connection=connection, index=False)
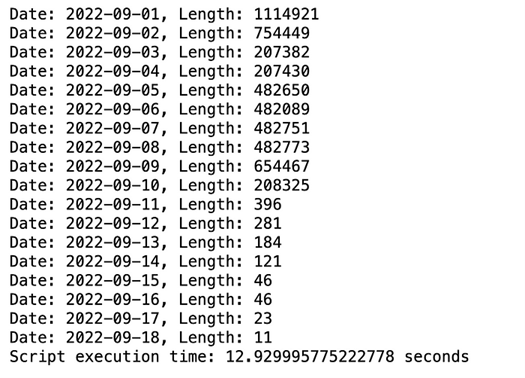
Как видите, мы загрузили целый датафрейм всего за ~13 секунд.
Тест #2 (проверяем скорость чтения запроса)
В этом случае я использую метод read_clickhouse.
# 2022-09-01 includes ~1,1M rows
ph.read_clickhouse('''SELECT * FROM default.ibm_small_transactions
                   PREWHERE date_t = '2022-09-01' ''',
                   connection=connection)
На обработку запроса ушло всего 1.35 секунды.
Таким образом, Pandahouse является достойным вариантом для работы с ClickHouse.


