

ClickStack: Высокопроизводительный OSS-стек наблюдаемости на базе ClickHouse
ClickStack — это новый продукт, созданный командой ClickHouse на базе открытой платформы HyperDX, приобретённой в марте 2024 года. По сути, это интегрированный стек для observability (наблюдаемости) с возможностями работы с логами, метриками, трассировками и воспроизведением пользовательских сессий. Он позиционируется как опенсорс-альтернатива Elastic Stack (ELK), но с фокусом на производительность ClickHouse.
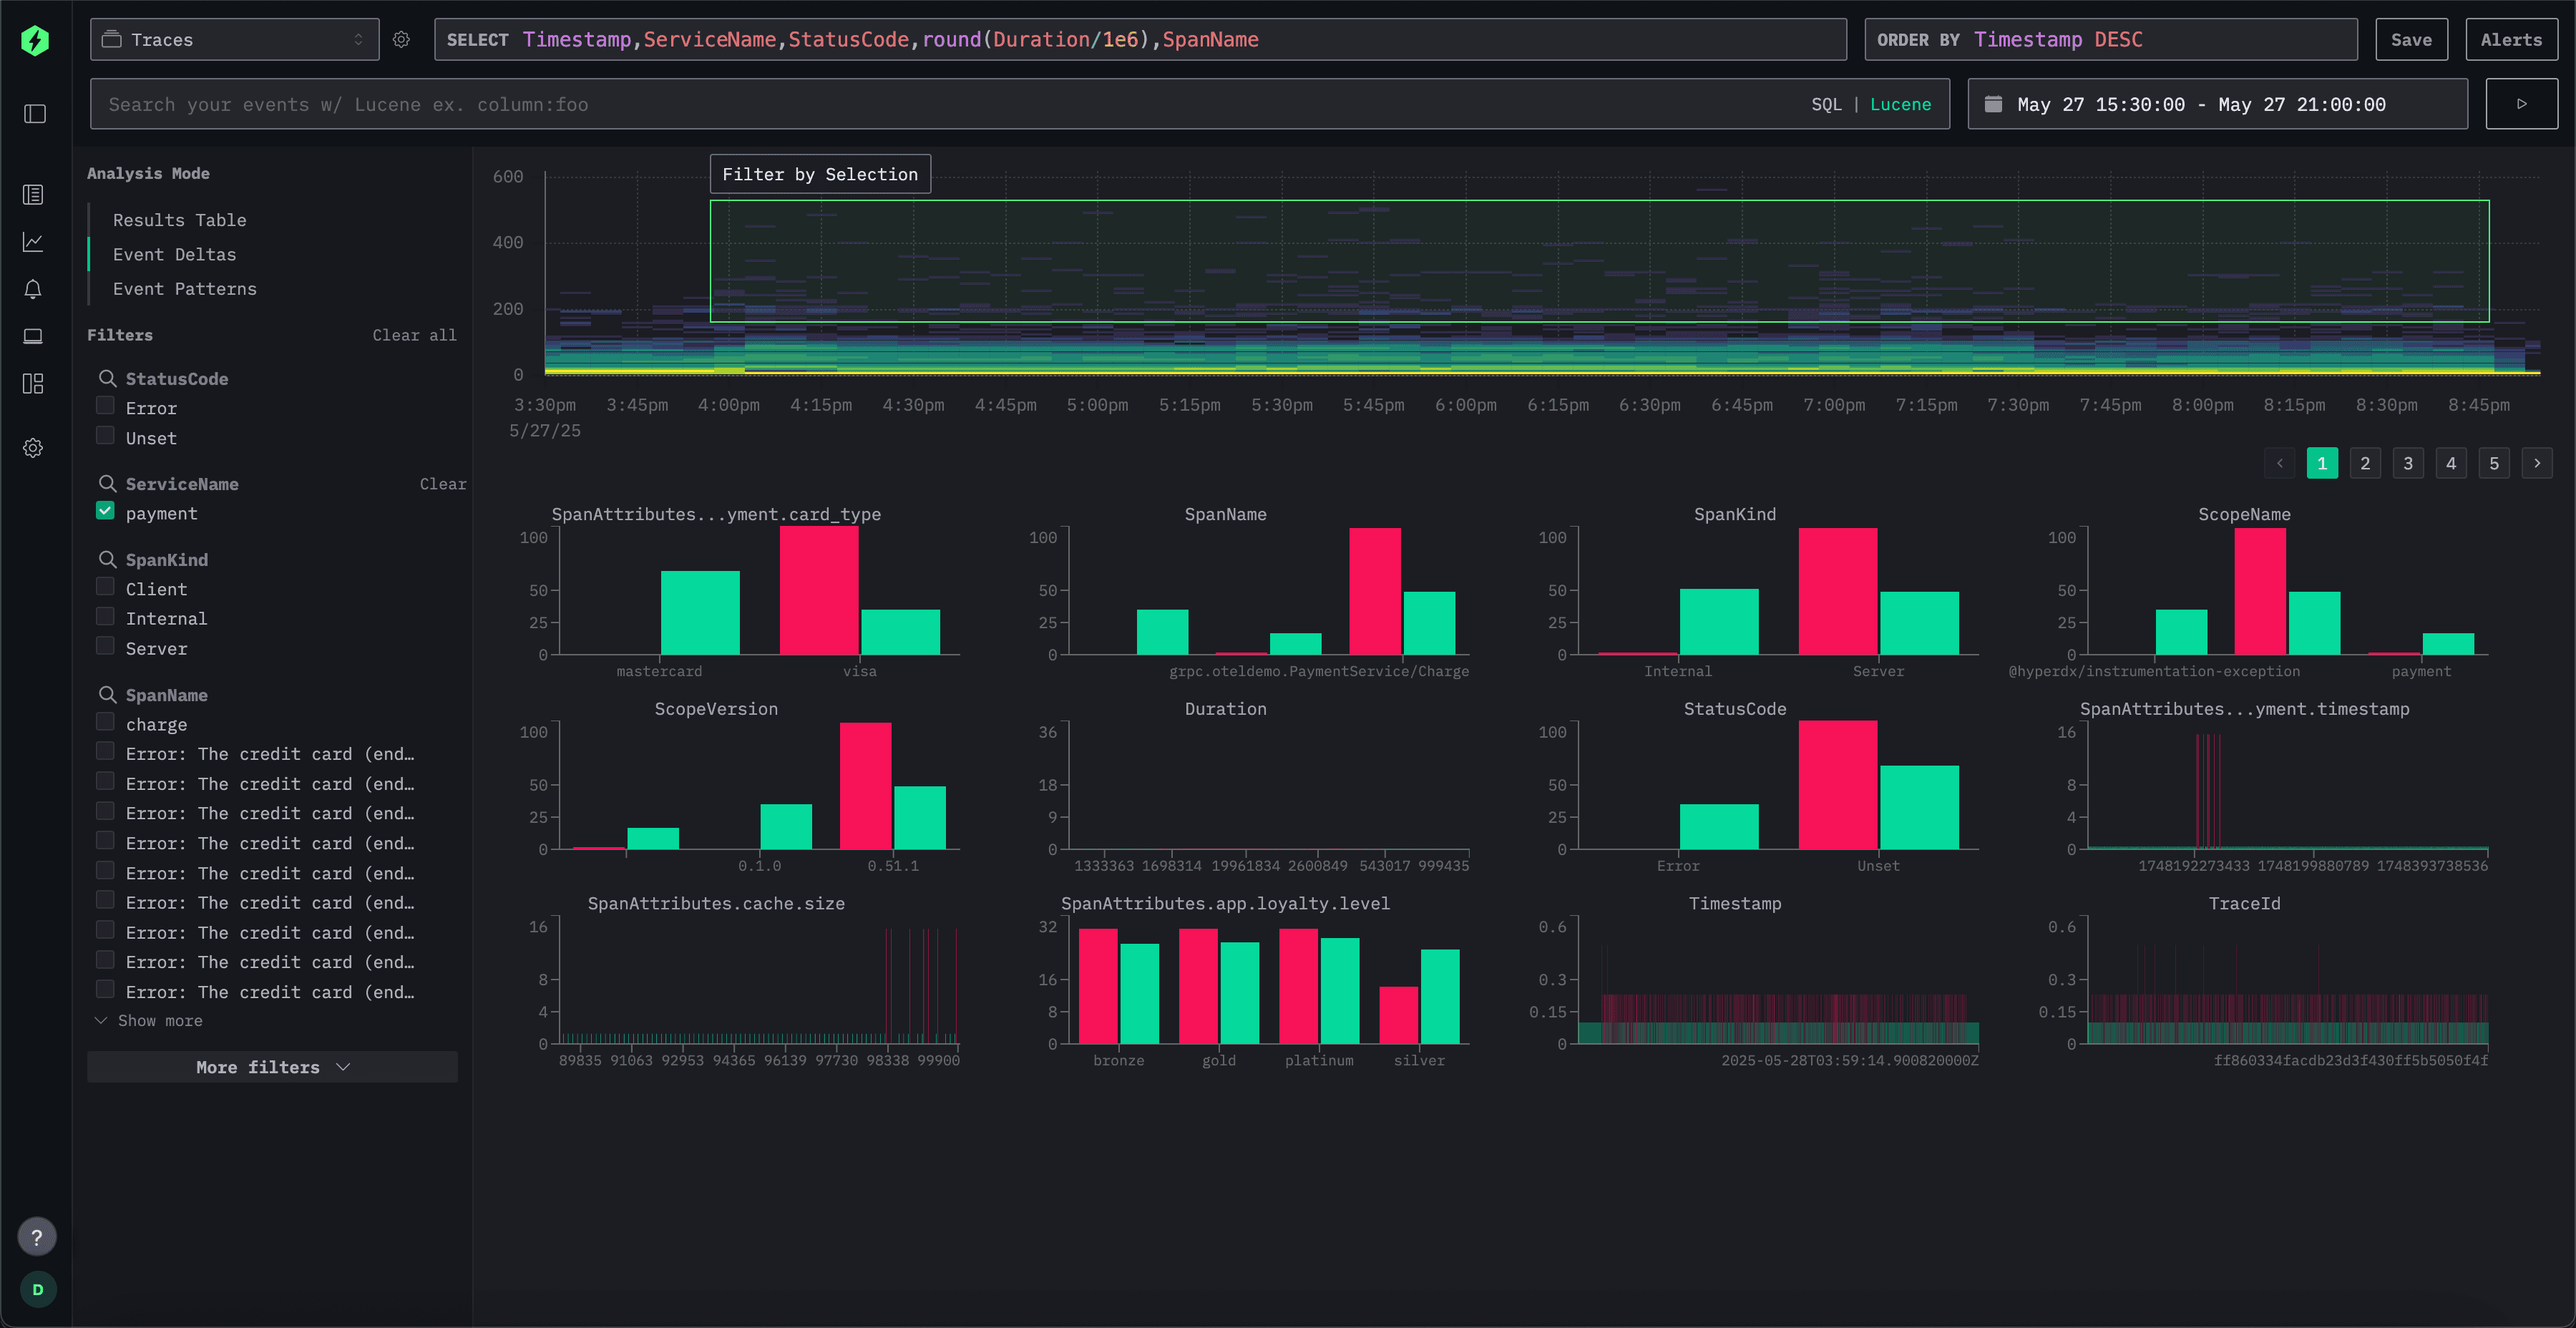
Основная идея — предоставить полноценный GUI и функционал, чтобы работать с логами и событиями без необходимости писать длинные SQL-запросы вручную.
Теоретическая база: что такое Observability и чем тут важен ClickStack
Observability (наблюдаемость) — это способность системы предоставить полное представление о своём состоянии на основе трёх основных источников данных:
- Логи — текстовые записи событий в системе.
- Метрики — агрегированные числовые показатели работы (например, количество запросов в секунду, среднее время отклика).
- Трассировки (traces) — цепочки событий, показывающие прохождение запроса через микросервисы и компоненты системы.
Проблема традиционных решений вроде ELK:
- ElasticSearch — мощен, но ресурсоёмок и дорого масштабируется.
- Kibana — функциональна, но требует тюнинга и не всегда оптимальна при обработке больших объёмов логов.
- Разные системы для логов, метрик и трассировок требуют интеграции.
ClickStack решает это так:
- Единый движок хранения — ClickHouse (колоночная СУБД, заточенная под аналитические запросы).
- Единый интерфейс (от HyperDX) для поиска, фильтрации, визуализации.
- Масштабируемость и скорость — архитектура ClickHouse позволяет держать петабайты данных и обрабатывать их за миллисекунды.
Архитектура ClickStack
ClickStack — это не просто ClickHouse с веб-UI. Это целая интегрированная платформа, в которую входят:
- ClickHouse — основное хранилище логов, метрик и трассировок.
- Ingestion Layer — сбор и парсинг данных из приложений, серверов, брокеров сообщений (Kafka, Redpanda, FluentBit, Vector).
-
Data Model — оптимизированные схемы хранения событий:
- Логи: хранение в колоночном формате с парсингом JSON и быстрыми фильтрами.
- Метрики: агрегированные таймсерии с сжатием.
- Трассировки: отдельные таблицы с parent/child span-ами для распределённого трейсинга.
- HyperDX UI — поисковый и аналитический интерфейс:
- Поиск логов по ключевым словам, полям, временным диапазонам.
- Дашборды для метрик.
- Визуализация цепочек трассировок.
- Воспроизведение пользовательских сессий.
- Alerting — система оповещений по заданным правилам (аналог Alertmanager, но интегрирована в стек).
Технические особенности
- Парсинг и хранение JSON в ClickHouse с автоматическим определением типов.
- TTL-политики для автоматического удаления старых данных.
- MergeTree-таблицы с оптимизацией под время и партиционирование по дате.
- Материализованные представления для предагрегации метрик.
- Интеграция с OpenTelemetry для сбора трассировок.
- Поддержка real-time ingestion с задержкой менее 2 секунд.
Кейсы использования
Кейс 1: Разбор падения сервиса ночью
- Раньше: дежурный разработчик открывает Kibana, ищет нужный индекс, пишет сложный запрос или использует фильтры, но Elastic под нагрузкой тормозит.
- Сейчас: дежурный открывает ClickStack, вводит ключевые слова, сразу видит цепочку событий и трассировку запроса, может воспроизвести действия пользователя.
Кейс 2: Отладка деградации производительности
- Метрики CPU и latency подтягиваются в одном UI вместе с логами ошибок и трассировками — можно сразу понять, что рост времени ответа вызван зависанием в конкретном сервисе.
Кейс 3: Комплаенс и аудит
- Поиск всех действий определённого пользователя за период с фильтрацией по типам операций и местам возникновения ошибок.
Преимущества перед ELK
- Скорость поиска — благодаря ClickHouse поиск по миллиардам строк занимает миллисекунды.
- Меньшее потребление ресурсов — колоночное хранение и сжатие.
- Единая платформа для логов, метрик, трассировок.
- Open source — без зависимости от коммерческих подписок Elastic.
Риски и ограничения
- Молодость продукта — хотя HyperDX зрелый, интеграция с ClickHouse ещё обкатывается.
- Отсутствие некоторых фич Elastic — например, сложные ML-анализаторы аномалий.
- Требования к схеме данных — плохой парсинг на ingestion-этапе приведёт к тормозам на аналитике.
- Кривая обучения — DevOps и аналитики, привыкшие к Kibana, должны переучиться.
- Хранение “всего” в ClickHouse — при огромных объёмах логов нужно внимательно рассчитывать стоимость хранения и нагрузки.
ClickStack — это сильная альтернатива ELK для компаний, уже использующих ClickHouse. Он закрывает главный недостаток “ClickHouse+логи” — отсутствие удобного GUI для быстрого поиска и анализа. Благодаря интеграции HyperDX продукт сразу стартует с богатым функционалом и может быть внедрён в production без многомесячной доработки.
ClickStack — архитектура (текстовая схема)
Картина целиком (слои и потоки)
[Клиентские и серверные приложения]├─(OTLP/HTTP/UDP, файлы)────────────────────────────────┐│ │v v[Collectors/Agents/SDKs] [Synthetics/SessionSDK]├─ OpenTelemetry SDK & Collector └─ Web/AppSessionReplay SDK├─ FluentBit/ Vector / Filebeat└─ Syslog, journald, Nginx/Envoyaccesslogs│v[Ingestion & Transport]├─ OTLP/HTTP endpoint (ClickStack Ingest API)├─ Kafka/Redpanda (опционально)└─ OTEL Collector pipelines (processors/exporters)│v[Parsing & Normalization]├─ Enrichers (service, env,version, host, k8s labels)├─ Parsers (JSON, logfmt, regex, nginx/apache)└─Drop/Keep/Mask (PII scrub)│v[Storage onClickHouse]├─ Logs: ReplicatedMergeTree,PARTITION BY date,ORDER BY(ts, service,level)├─ Traces: spans/events/links, parent/child indices├─ Metrics:time-series (measurement, labels,value)├─SessionReplay: events timeline + blobs (obj.storage)└─MaterializedViews/Projections/TTL/Indexes│v[Query & UI (HyperDX-powered)]├─ Поиск и фильтрация логов (GUI, безSQL)├─ Эксплорер трассировок (distributed tracing)├─ Дашборды по метрикам├─SessionReplay (воспроизведениедействий)└─ Saved Searches, RBAC, sharing│v[Alerting & Automations]├─ Правила(KQL-like/фильтры/SQL)├─ SLO/SLI, пороги, аномалии (правила)└─ Интеграции(Email, Slack/Teams, Webhook, PagerDuty)[Ops/Platform]├─ AuthN/AuthZ (SSO/OIDC, RBAC)├─ Auditlog, Config-as-Code├─ Backups, Tiering (S3), Retention└─ Observability самогостека(Prometheus, CHsystem.*)
Сбор и транспорт данных
Источники
- Backend: приложения на JVM/.NET/Go/Node, системные логи, Nginx/Envoy, k8s stdout/stderr.
- Frontend/mobile: Web SDK (события UI, ошибки, network), mobile SDK (опционально).
- Инфраструктура: k8s события, ingress logs, cloud audit.
Агенты/коллекторы
- OpenTelemetry SDK в коде сервисов (traces/metrics/logs) → OTel Collector.
- Fluent Bit/Vector/Filebeat для файловых логов и stdout/stderr подов.
- Syslog/UDP/TCP — для сетевого ввода.
Протоколы
- OTLP (gRPC/HTTP) — единый для логов/метрик/трейсов.
- HTTP ingest — JSON/NDJSON для простых источников.
- Kafka/Redpanda — буфер/шина для пиков и изоляции нагрузки.
Рекомендации
- На k8s: DaemonSet агента (Fluent Bit/Vector) + Deployment OTel Collector (fan-in).
- Backpressure: включать буферизацию у агентов и в Kafka, настроить retry/дедубликацию.
Нормализация и обогащение
Парсинг
- JSON auto-parse, logfmt, regex-пайплайны для нестандартных строк.
- Готовые парсеры для nginx/apache/access-log.
Обогащение (enrichment)
- service, env, version, k8s: namespace, pod, node, labels.
- geoip/ASN (опционально), user/session id для фронтенда.
- trace_id/span_id для склейки логов и трассировок.
Безопасность
- Скраббинг PII (e-mail, телефон, токены) до записи.
- Drop/Keep фильтры для шумных источников.
Хранилище ClickHouse (таблицы и приёмы)
Логи
-
Engine:
ReplicatedMergeTreeна проде,MergeTreeна стенде. -
Партиции: по дню/неделе (
toYYYYMMDD(ts)), зависит от объёма. -
Сортировка:
(ts, service, level, trace_id)— ускоряет фильтры по времени/сервису. -
Индексы:
tokenbf_v1/ngrambf_v1поmessageдля быстрых substring-поисков. - TTL: горячие 7–30 дней на локальном/SSD, далее move to S3-disks или drop.
Пример (упрощённый):
CREATE TABLElogs(ts DateTime64(3,'UTC'),date DateMATERIALIZED toDate(ts),service LowCardinality(String),env LowCardinality(String),level LowCardinality(String),trace_id UUID,span_id UUID,host String,message String,attrs JSON,-- или Map(String, String) / Object('json')k8s_pod LowCardinality(String),user_id Nullable(String))ENGINE=ReplicatedMergeTree('/clickhouse/tables/{shard}/logs','{replica}')PARTITION BY date ORDER BY(ts, service, level, trace_id)TTL ts+ INTERVAL 30 DAYSETTINGS index_granularity= 8192;-- Текстовый индекс ALTER TABLElogsADDINDEX idx_msg ngrambf_v1(message,3,2048,2,0) GRANULARITY4;
Трассировки
-
Таблицы
spans,span_events,span_links. -
Ключи:
trace_id,span_id,parent_span_id,service,kind,status. - Идея: быстрый реконструкт «дерева запроса» и фильтры по длительности/ошибкам.
Метрики
- Модель: «measurement + labels + value + ts».
-
Хранение:
AggregatingMergeTreeдля downsampling, или сырые ряды с MV. - Материализованные представления создают 1m/5m/1h агрегаты.
Session Replay
- В CH: метаданные сессии и таймлайн событий (клики, роуты, ошибки).
- Бинарные артефакты (скриншоты/снимки DOM/сетевые payload) — в объектном сторидже (S3), ссылки — в CH.
Запросы, UI и API (HyperDX-пласт)
Интерфейс
- GUI для логов: быстрый полнотекстовый поиск, фильтры по полям, сохранённые запросы.
- Traces: диаграмма спанов, flamegraph, фильтры по латентности/статусу.
- Metrics: дашборды, алерты на базовые SLI (RPS, p95 latency, error rate).
- Session Replay: по trace/user/session → воспроизведение проблемных сессий.
Связность
-
Клик по логу с
trace_id→ переход в соответствующий trace. - Из trace к конкретным логам спана и к фронтовой сессии (если есть связь).
AuthZ/мультиарендность
- OIDC/SSO, группы, роли (RBAC), фильтры «по организациям/командам/проектам».
- Маски/политики на поля (например, скрыть PII для группы «поддержка»).
Алерты и автоматизация
Правила
- Пороговые (threshold), rate-of-change, «отсутствие событий».
- Запросные: условие формулируется как фильтр/сохранённый поиск/SQL.
- SLO/SLI: budget burn alerts (ошибки/латентность за интервал).
Интеграции
- Email, Slack/Teams, PagerDuty, Webhook (в тикетницу/оркестратор).
- Дедупликация/мьютинг (тихие часы, шумные источники).
Эксплуатация и масштабирование
Топология ClickHouse
-
N шардов × M реплик. Шардинг по
date + hash(service)или чисто по range времени. - Хранение: SSD (горячие), HDD/S3 (холодные). ClickHouse S3-backed disks для tiering.
Проекции и MV
-
Проекции для частых разрезов (например,
ORDER BY (service, ts)). - Materialized Views для предагрегаций метрик и «расплющивания» JSON-полей в отдельные столбцы.
Кеши и планирование
-
mark_cache,uncompressed_cache, настройкаmax_threads/max_concurrent_queries. - Фоновая оптимизация с учётом ночных пиков ingest.
Резервирование
- Бэкапы CH (native) + версионирование в S3.
- Disaster Recovery: ≥2 AZ/ЦОД, async реплика в DR-кластер.
Безопасность и комплаенс
- TLS «на входе» и между компонентами, mTLS по возможности.
- SSO (OIDC), MFA, строгие роли (read-only/analyst/admin).
- PII: скраббинг «на входе», маски на чтение, запрет экспорта сырых данных без прав.
- Audit trail действий в UI и системные логи админских операций.
- Сетевые политики: private endpoints, VPC peering, ограничение egress.
Жизненный цикл данных (retention & стоимость)
- Горячие логи: 7–30 дней (SSD, быстрый поиск).
- Тёплые: 30–90 дней (HDD/S3-диски, чуть медленнее, но дёшево).
- Холодные: >90 дней (S3 только для комплаенса, выборочно).
-
TTL/
MOVE TO VOLUMEправила, разные классы хранения. - Для метрик — downsampling (1s → 1m → 5m → 1h).
Типовые флоу расследования инцидента (как работает команда)
-
Алерт: p95 latency ↑ у сервиса
checkout(Slack уведомление). - Дэшборд: скачок latency совпал с ростом 5xx.
-
Traces: фильтр по
service=checkout AND duration>2s→ видим «узкое место» вpayments. -
Логи: по
trace_idоткрываем логи конкретного спана — видимDB timeout. - Session Replay: привязываем к пользовательским сессиям — подтверждаем массовое влияние.
-
Root Cause: у
paymentsистёк пул соединений к БД после релиза N. - Fix: откат/настройка пула, проверка метрик, закрытие инцидента с постмортем.
Риски и как их закрывать
-
Неправильная схема логов → медленные запросы
Рецепт: ранняя нормализация (flatten), явные типы столбцов, индексы по ключевым полям. -
Шум/высокая кардинальность (
user_id,request_idв labels метрик)
Рецепт: лейблы с высокой кардинальностью — в логи/trace attrs, а не в «метки» метрик; агрегация на входе. -
Пики ingest → pressure на ClickHouse
Рецепт: Kafka буфер, батчинг у агентов, квоты/лимиты, горизонтальный масштаб CH. -
PII/секреты в логах
Рецепт: скраббинг на collector/ingest, маскирование в UI, DLP-политики. -
Кривая обучения после Kibana
Рецепт: пресеты поисков, сохранённые фильтры, «How-to» плейбуки, маппинг hotkeys. -
Стоимость хранения
Рецепт: TTL, tiering в S3, короткий retention для сырых логов + агрегаты/сэмплинг.
Мини-«чеклист внедрения»
- Сбор: OTel Collector + Fluent Bit/Vector, тестовый OTLP/HTTP ingest.
-
Моделирование: целевые разрезы поиска →
ORDER BY, индексы, проекции. - Retention: политики TTL и tiered storage с первого дня.
- Безопасность: SSO, роли, маски PII.
- Набор дашбордов: «Здоровье платформы», «Ошибки по сервисам», «Latency p95/p99».
- Алерты: error rate, latency, отсутствие логов источника, budget burn.
- SLO: определить SLI/цели для ключевых путей (checkout, login, search).
- Операции: бэкапы, обновления, capacity planning (RPS, Б/сутки, кардинальность).
Что важно помнить (позиционирование)
- ClickStack = ClickHouse-хранилище + HyperDX-интерфейс + полный ingest-путь.
- Альтернатива ELK, особенно там, где уже есть ClickHouse и требуется предсказуемая производительность на больших объёмах.
- Ключ к успеху — дисциплина на входе (нормализация и скраббинг), грамотная сортировка/индексы и строгая политика жизненного цикла данных.


