

Эксплуатация и операционная поддержка: мониторинг, инциденты, обслуживание
Эффективная эксплуатационная поддержка в рамках дисциплины Data Quality и Data Observability требует системного подхода к тому, как данные ведут себя в продакшене, как сигнализируются отклонения от ожидаемого уровня качества, и как организованы процессы реагирования на инциденты и дальнейшее обслуживание инфраструктуры наблюдаемости. В условиях больших дата‑пайплайнов, распределённых по нескольким хранилищам и потокам данных, операционная дисциплина становится неотъемлемой частью архитектуры качества данных: без неё невозможно обеспечить предсказуемость и надёжность аналитических выводов.
Данная глава рассматривает архитектурные принципы мониторинга, методологию постановки и эскалации инцидентов, а также практики обслуживания и эволюции систем наблюдаемости. Особое внимание уделяется тому, как проектировать контракты данных, как выбирать и настраивать метрики, какие сигналы считать критичными для своевременного реагирования и какие процедуры должны быть встроены в процессы CI/CD для данных. В конце представлено практическое руководство по реализации типовых сценариев в условиях реального производства, включая примеры кода и конфигураций, необходимых для внедрения архитектурных паттернов.
- Мониторинг качества данных и наблюдаемости как системный сервис
- Жизненный цикл инцидентов в дата‑пайплайнах и принципы постмортемов
- Операционные практики: миграции схем, регламенты обслуживания и управляемость изменений
- Интеграции инструментов наблюдаемости и автоматизация реагирования
- Практические примеры реализации и проверки работоспособности
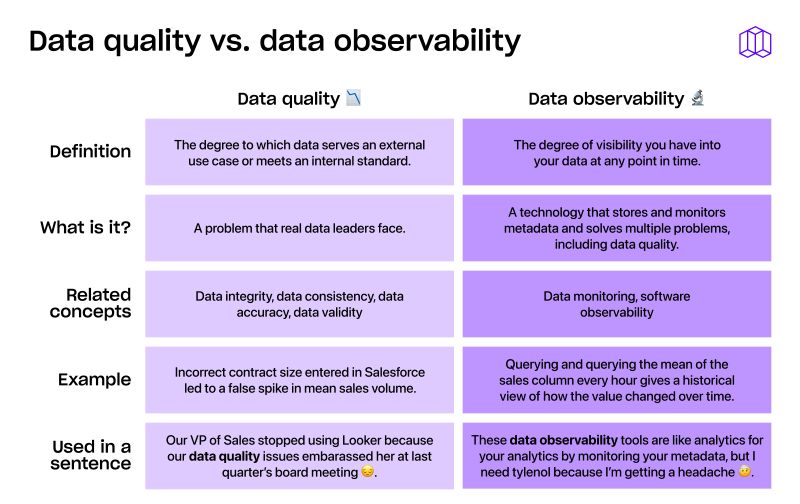
Архитектура мониторинга и наблюдаемости данных
Мониторинг данных выходит за рамки традиционных метрик производительности ETL‑задач. Он требует интеграции телеметрии на каждом этапе пайплайна: источники данных, трансформации, загрузки в целевые хранилища и взаимодействие с внешними системами. В архитектурном плане это формируется вокруг нескольких слоёв: контракты данных, сигналы качества, механизмы телеметрии, хранилища и унифицированный слой визуализации.
Основной подход — моделирование данных как продукта: контракт между владеющим поставщиком данных и потребителем, где ожидаемые свойства фиксируются заранее и валидируются на каждом шаге движения данных. Контракты позволяют отделить ответственность за качество данных от исполнения конкретной техники обработки и дают возможность раннего предупреждения о возможном ухудшении согласованности между источниками.
- Контракты данных и схемы версионирования: контракт задаёт ожидаемую схему, требования к уникальности записей, допустимым диапазонам значений и временным характеристикам. Для реализации применяются паттерны схем‑регистров, например система регистрирования схем или база контрактов, поддерживающая эволюцию без ломки потребителей.
- Метрики и сигналы: на уровне пайплайна применяются SLI/SLO для ключевых данных: полнота (completeness), точность (accuracy), своевременность (timeliness), согласованность (consistency) и уникальность (uniqueness). В сочетании с задержками обработки и временем поставки, они дают реальную картину надёжности пайплайна.
- Телеметрия и трассировка: на уровне потоков важны агрегированные метрики задержки, объёма данных, топологии зависимостей, а также трассировка запросов через системы оркестрации и обработки. OpenTelemetry служит связующим мостиком между источниками данных, трансформациями и целевыми хранилищами.
- Инструменты и интеграции: выбор инструментов должен опираться на возможность экспорта метрик в единый центр мониторинга (например, Prometheus/Alertmanager) и визуализации в дашбордах Grafana. В контексте эволюции технологий важна поддержка стандартов и возможность адаптации без значительной переработки кода.
Глубокое понимание архитектуры мониторинга позволяет определить пороги риска и типы инцидентов до того, как данные достигнут потребителей. Важнейшее реализуемое качество — предсказуемость поведения пайплайна в продакшене: достаточно точно знать, какие сигналы соответствуют норме, и какие — аномалии.
# пример: instrumented latency metric (псевдокод) from opentelemetry import metrics from opentelemetry.exporter.prometheus import PrometheusMetricsExporter from prometheus_client import start_http_server import timemeter = metrics.get_meter(name) latency_hist = meter.create_histogram("data_pipeline_latency_ms", unit="ms")
def process_record(record): start = time.time()
обработка записи
... end = time.time() latency = (end - start) * 1000 latency_hist.record(latency)if name == "main":
exporter = PrometheusMetricsExporter()настройка экспорта в Prometheus через HTTP-эндпойнт
start_http_server(8000) # цикл обработки while True: rec = fetch_next_record() process_record(rec)
Почему так: архитектура, основанная на контрактах и централизованных метриках, позволяет разделить ответственность за качество данных и повысить повторяемость реагирования на тревоги. При этом важно обеспечить согласованность между контракторами и потребителями: не допускается ситуация, когда одна часть пайплайна валидирует контракт, а другая игнорирует его сигналы из-за отсутствующей интеграции в мониторинг.
Метрики, контракты и пороги
Центральные метрики качества данных включают в себя углублённые характеристики качества и устойчивости пайплайна. Эффективная эксплуатация требует ясной стратегии по выбору метрик, их агрегации и автоматической индикации отклонений.
- Completeness и timeliness: какая доля записей присутствует в целевом репозитории и насколько своевременно они попадают туда относительно заданного окна.
- Accuracy и validity: насколько значения соответствуют бизнес‑правилам и ограничениям. Это может включать валидацию диапазонов, соответствие внешним справочникам, проверку референциальной целостности.
- Consistency и drift: согласованность между несколькими источниками одного и того же предмета (мульти‑поставщики) и обнаружение дрейфа в распределениях со временем.
- Uniqueness и deduplication: исключение дубликатов и корректная обработка уникальных ключей.
- Data contracts: формализация интерфейсов данных через схемы и спецификации контрактов (например, в формате JSON Schema или Protocol Buffers), поддержка версии и миграций без нарушения потребителей.
SLI/SLO для данных должны быть привязаны к бизнес‑потребностям: чем выше риск принятия неверных решений, тем более строгие цели по качеству и более частые проверки. Важная часть — автоматизация устранения слабых мест: например, автоматическое повторное исполнение моковых задач, переразделение нагрузки, корректировка QoS на уровне очередей.
- Пороговые режимы: устанавливайте разные уровни тревоги для разных сценариев (критичный, высокий риск, информационный). Эскалация должна третье по уровню минимального времени реакции, а не только как простая конвертация сигнала в алерт.
- Baselining и drift detection: начальное моделирование нормального поведения, затем непрерывная проверка отклонений. drift‑детекторы должны быть адаптивны и учитывать сезонность.
В контексте инструментов и практик полезно опираться на два базовых подхода: контракт‑первый дизайн (двусторонняя валидация между источником и потребителем) и мониторинг по принципу наблюдения по слоям пайплайна (источник → трансформация → загрузка). Реализация контрактов часто требует обмена схемами и ограничениями в рамках оркестратора и хранилища, что упрощает совместную работу команд и ускоряет внедрение изменений.
# пример: простая проверка контракта данных на Python (для локального тестирования) import json from jsonschema import validate, ValidationErrorcontract = { "type": "object", "properties": { "order_id": {"type": "string"}, "customer_id": {"type": "string"}, "amount": {"type": "number"}, "order_ts": {"type": "string", "format": "date-time"} }, "required": ["order_id", "customer_id", "amount", "order_ts"] }
def validate_record(record): try: validate(instance=record, schema=contract) return True except ValidationError as e: return False, str(e)
record = {"order_id": "ORD123", "customer_id": "CUST45", "amount": 250.0, "order_ts": "2026-01-26T12:34:56Z"} ok = validate_record(record) print(ok)
Почему так: контракты данных позволяют определить четкие границы допустимого поведения данных, что особенно важно в условиях эволюции схем и распределённых команд. Они минимизируют риск принятия некорректных данных на продакшн и упрощают аудит изменений.
Инциденты: управление сигналами, эскалация и постмортем
Инцидент в контексте дата‑пайплайнов — это событие, которое нарушает ожидаемое качество или доступность данных в потребителях. Эффективная операционная практика предполагает формальный процесс реагирования: обнаружение, классификация нарушения, эскалация, локализация причины, устранение проблемы и возврат пайплайна к нормальной работе, за которым следует постмортем‑анализ и корректирующие меры.
- Сигналы и детекция: опирайтесь на сигнальные показатели как внутри заметных дашбордов, так и на лог‑потоки систем. Важно объединить сигналы с контракторами и планами регламентной проверки.
- Классификация инцидентов: критичность по бизнес‑контексту; определение времени отклика и целевых уровней восстановления.
- Жизненный цикл инцидента: обнаружение → классификация → эскалация → локализация → исправление → проверка решения → документирование в постмортем.
- Роль постмортемов: анализ причин без обвинений, определение долгосрочных мер профилактики, обновление runbooks и контрактов.
- Коммуникация и координация: регламент уведомлений, каналы связи, роли и ответственности. В условиях распределённых команд критично обеспечить единый канал информирования (например, чат‑пилик или сервис-нуги), чтобы снизить задержки в реакции.
Практически это выражается в наборе готовых runbooks: шаги для тривиальных инцидентов (например, падение задержек в очереди, пропуски в партициях, несовместимость схем) и для сложных сценариев (проблемы в upstream‑сигналах, проблемы в регуляторных правилах). Встроенная автоматизация, например, эвристические правила эскалации, может существенно сократить время реакции и устранения.
# пример упрощённого runbook: инцидент с задержкой в загрузке в хранилище
1. Обнаружить аномалию времени задержки через дашборд.
2. Проверить сигналы источников на наличие пропусков или ошибок парсинга.
3. Проверить состояние очередей и обработчиков в оркестраторе (Airflow/Ddagster).
4. Если проблема не решена автоматически, эскалировать в команду механику данных.
5. Зафиксировать факт в постмортем и обновить контракт и монитоинг.
Почему так: инциденты в дата‑пайплайнах часто зависят от множества точек отказа: источники, трансформации, слои загрузки. Наличие подготовленного плана, чётких ролей и регламентов помогает снизить латентность реакции и повысить надёжность пайплайна в целом. Постмортем — не винительная процедура, а средство обучения и системного улучшения.
Обслуживание и эксплуатационные практики: устойчивость и эволюция
Эксплуатационная поддержка подразумевает не μόνο реактивные действия при инцидентах, но и активное управление эволюцией архитектуры наблюдаемости и самой инфраструктуры. Основные направления:
- Управление изменениями: версионирование контрактов, схем, правил проверки и регламентов выпуска. Вносить изменения нужно через регламентированные этапы тестирования, интеграцию в CI/CD и проверку обратной совместимости.
- Миграции схем и эволюция моделей данных: планирование эволюции схем, поддержка версионирования и миграционных стратегий, чтобы минимизировать простои и риски потребителей.
- Управление зависимостями и устойчивость к сбоям: дублирование источников, резервирование каналов, повторная попытка обработки и идемпотентность операций; мониторинг устойчивости к сбоям в каждом из звеньев цепочки.
- Регламент обслуживания: периодические аудиты качества данных, обновления тестовых наборов и контрактов, подготовка резервных сценариев.
- Каталог метаданных и управление доступами: централизованный реестр схем, lineage и владение данными. Подчёркнуть необходимость прозрачности и соблюдения политики доступа и безопасности.
- Архитектурная устойчивость: проектирование с учётом эволюционных изменений, минимизация «стыков» между компонентами, использование устойчивых паттернов, таких как event‑driven архитектура и сервис‑моры.
Обеспечение устойчивости и эволюции требует методологического подхода и тесной координации между командами данных, инфраструктуры и безопасности. Важной составляющей является интеграция с регламентами DevOps/DataOps: автоматизация тестирования, развёртывания и отката, а также обеспечение обратной связи между тестированием на «производственной» ветке и стадии продакшена.
Интеграции и автоматизация: паттерны и инструменты
Эффективная эксплуатация наблюдаемости требует единого стека для сбора телеметрии, агрегации данных и алертинга. Варианты архитектуры в современных условиях часто включают:
- Оркестрацию и обработку данных: Apache Airflow, Dagster или аналогичные инструменты, обеспечивающие надёжную и воспроизводимую последовательность задач, обработку ошибок и повторные запуски.
- Мониторинг и алертинг: Prometheus + Alertmanager для метрик и уведомлений; Grafana для дашбордов. В некоторых случаях внедряется OpenTelemetry в качестве единого слоя трассировки и сбора метрик.
- Валидацию данных: Great Expectations или аналогичные решения для автоматизации проверок на соответствие контракта на каждом этапе пайплайна.
- Каталоги и lineage: инструменты для управления метаданными и прослеживаемости данных (например, локальные решения или открытые плагины к существующим системам).
- Интеграция и безопасность: обеспечение согласованной политики доступа, шифрования и аудитирования для данных, проходящих через пайплайны.
Плюсы такого подхода очевидны: единая система мониторинга упрощает обнаружение проблем, ускоряет реакции и позволяет централизованно управлять изменениями. В качестве примера инструментов можно отметить: Prometheus для метрик и Alertmanager для алертинга, Grafana для дашбордов, и OpenTelemetry для трассировки. Для проверки контрактов часто применяется Great Expectations.
# упрощённый пример экспорта метрик в Prometheus из Python (OpenTelemetry) from opentelemetry import metrics from opentelemetry.exporter.prometheus import PrometheusMetricsExporter from prometheus_client import start_http_server import timemeter = metrics.get_meter(name) dq_latency = meter.create_histogram("dq_latency_ms", unit="ms")
def quality_check(record):
проверка качества
...def emit_metric(latency_ms):
dq_latency.record(latency_ms)if name == "main":
exporter = PrometheusMetricsExporter()
start_http_server(9100)
while True:
start = time.time()
rec = fetch_next_record()
quality_check(rec)
emit_metric((time.time() - start) * 1000)
time.sleep(0.01)
Почему так: автоматизация мониторинга и алертинга через единый стек улучшает управляемость, снижает задержки реакции и обеспечивает прозрачность процессов для всех заинтересованных сторон. Важно сохранять баланс между полнотой наблюдаемости и оперативностью: избыточность телеметрии увеличивает стоимость поддержки, тогда как её нехватка порождает «слепые зоны».
Примеры реализации и практические сценарии
Говоря о практической реализации, стоит привести кейс, где архитектура мониторинга и процедур инцидент‑менеджмента позволили заметно снизить риск ошибок из-за изменений схем и задержек в пайплайне.
Кейс: входные данные в дата lake имеют три независимых источника, параллельные трансформации и загрузку в аналитическую базу. Контракты данных поддерживаются через JSON‑схемы и контрактные тесты. Метрики мониторинга отражают задержку и полноту каждой стади, а алерты формируются в зависимости от типа инцидента. В случае дрейфа распределения ценности в одном из источников автоматически запускается процедура повторной загрузки и уведомления команды данных.
Внедрённые практики позволили:
- быстро обнаружить дрейф распределения в одном источнике;
- автоматически откатить на предыдущую версию трансформации;
- применить миграцию схемы без влияния на downstream потребителей;
- зафиксировать инцидент и результаты постмортема, обновив контракты и тесты.
Такой подход обеспечивает устойчивость к изменчивости данных и уменьшает риск ошибок на продакшн.
Если рассматривать теоретическую сторону и практическую реализацию, важно не забывать о балансе между сложностью архитектуры и реальными бизнес‑потребностями. В реальных проектах редко требуется реализовать полный набор инструментов сразу. Бюджет, компетенции команд и регуляторные требования определяют выбор конкретных инструментов и стратегий. Важно стремиться к модульности и расширяемости, чтобы можно было постепенно вводить новые сигналы наблюдаемости и тесты качества данных без массовых изменений в существующей инфраструктуре.
Key takeaways
- Эксплуатационная поддержка качества данных требует системного подхода к мониторингу, контрактам и инцидентам.
- Контракты данных и схемы служат основой для предсказуемости и устойчивости пайплайна; контракты должны поддерживать эволюцию без нарушения потребителей.
- Метрики качества данных и SLA должны отражать бизнес‑риски и быть связаны с порогами тревоги и правилами эскалации.
- Инцидент‑менеджмент в дата‑пайплайнах включает детекцию, эскалацию, локализацию, исправление и постмортем‑анализ с обновлением контрактов и регламентов.
- Архитектура Observability должна быть модульной, с интеграцией оркестрации, мониторинга, валидации данных и управлением метаданными.
- Инструменты, такие как Prometheus, Grafana, OpenTelemetry и Great Expectations, позволяют построить устойчивый цикл мониторинга и автоматизации.
- Реализация требует баланса между полнотой наблюдаемости и стоимостью поддержки; начинать стоит с критичных сигналов и постепенно наращивать покрытие.
FAQ
- Какие основные компетенции необходимы для команды на этапе эксплуатации?
- Важны навыки разработки контрактов данных, настройки мониторинга и алертинга, знания по оркестрации и обработке ошибок, умение проводить постмортемы и внедрять изменения в регламенты.
- Как выбрать пороги тревоги для данных?
- Пороги должны соответствовать бизнес‑рискам и историческим данным. Начните с Baselining на существующем пайплайне и постепенно адаптируйте пороги по мере накопления опыта. Важно обеспечить иерархию сигналов (критичный/высокий риск/информация).
- Что такое data contract и почему он так важен?
- Data contract — это формальная спецификация входных и выходных данных, включая схему, типы полей, требования к валидности и временным характеристикам. Он обеспечивает двустороннюю уверенность между поставщиком и потребителем данных и облегчает эволюцию без разрыва потребительских сервисов.
- Какие инструменты лучше использовать в малых командах?
- В малых командах разумно начать с OpenTelemetry для трассировки и Prometheus/Alertmanager для мониторинга, а также с простым инструментом для проверки контрактов (например, Great Expectations). По мере роста можно добавлять более сложные решения по каталогу метаданных и управлению данными.
- Как организовать постмортем по инциденту в дата‑пайплайне?
- Постмортем должен быть без обвинений, ориентирован на причины и профилактику. В документе фиксируются факты, последствия, корневые причины и конкретные действия по устранению и предотвращению повторений, а затем обновляются контракты, тесты и регламенты.
- Когда стоит рассматривать миграцию схем?
- Когда изменяются бизнес‑правила, появляются новые требования к данным или когда текущие схемы стали узким местом. Проводите миграции через версионирование и тестирование совместимости, минимизируя простои и риски downstream‑потребителей.
- Как обеспечить устойчивость к сбоям в дата‑пайплайне?
- Путём дублирования источников, идемпотентных трансформаций, ретраи с экспоненциальной задержкой и автоматизированного отката. Включение резервного канала и ретеншен‑политик для дефектных записей обеспечивает более высокую устойчивость.
- Какие практики по документированию стоит внедрить?
- Ведение регистров контрактов и схем, документация runbooks для инцидентов, хранение постмортем‑отчётов и журналов изменений в системах Observability. Центральный каталог метаданных помогает снизить потери информации и ускорить внедрение изменений.
- Какие вызовы чаще всего возникают при внедрении мониторинга?
- Сложности с согласованием контрактов между командами, сопротивление изменениям в культуре разработки, перегруженность телеметрией и сложностями интеграций между различными инструментами.
- Какая роль обучающих программ в успешной эксплуатации?
- Обучение команд работы с контрактами, настройке метрик и алертинга, практикам быстрого реагирования на инциденты и проведению постмортемов. Повышение уровня цифровой грамотности в области наблюдаемости снижает риск ошибок при изменениях и ускоряет внедрение улучшений.


