

Риски, приватность, этика и ответственность
Современная архитектура данных, подготовленная под использование больших языковых моделей и агентных систем, неизбежно сталкивается с вопросами риска, приватности, этики и ответственности. В этой главе рассматриваются ключевые концепции и практики, которые позволяют снизить вероятность инцидентов, сохранить доверие пользователей и обеспечить соответствие нормативным требованиям. Центральные идеи - это проактивная защита данных на всех этапах жизненного цикла, прозрачность принятия решений и четкая фиксация ответственности за последствия внедряемых решений.
Далее будут выделены концептуальные рамки и конкретные технические решения, которые помогают сочетать производительность платформы с требованиями к конфиденциальности и этике. Особое внимание уделено тому, как архитектура, политики и операционные практики работают в связке, чтобы поддерживать безопасность, контроль доступа и аудит на уровне инфраструктуры и моделей.
- Риск-менеджмент в контексте AI-ready Data Platform: как идентифицировать и классифицировать угрозы на разных уровнях.
- Приватность как принцип проектирования и практические методы защиты данных в движении, на хранении и в производстве моделей.
- Этические рамки и ответственность: как выстроить прозрачность, защиту пользователей и управление предвзятостью.
- Аудит, соответствие и процесс инцидентов: от политики до конкретных механизмов мониторинга и реагирования.
- Интеграция этики и приватности в жизненный цикл проекта: от требований к эксплуатации и улучшению.
Контекст риска в AI-ready Data Platform
Категории рисков
В рамках AI-ready инфраструктуры риски можно условно разделить на несколько витков: операционные, технологические, юридические и социально-этические. Операционные риски включают утечки данных, неправильную настройку прав доступа, несоответствие политик хранения и устаревших сертификатов. Технологические риски связаны с некорректной обработкой персональных данных в обход применяемых фильтров и защитных механизмов, а также с уязвимостями компонентной инфраструктуры, например, модулями обработки данных или сервисами в экосистеме LLM. Юридические риски касаются несоблюдения регламентов по защите данных, требованиям регуляторов и договорных обязательств. Социально-этические риски включают предвзятость моделей, манипуляцию выводами, непреднамеренное использование данных пользователей в целях, противоречащих ожиданиям клиентов.
Управление рисками должно быть встроено в архитектуру: от проектирования до эксплуатации. Важно понимать, какие данные являются чувствительными, какие сценарии использования требуют дополнительной фильтрации и какие данные подлежат сохранению в виде журналов и аудита. Для техник это означает моделирование угроз на уровне архитектурных компонентов, потоков данных и прав доступа, а также внедрение контрмер в каждом слое: от слоя хранения до слоя моделей и инструментов анализа.
Архитектурные сигналы риска
- Био- и персональные данные: идентификаторы PII, данные о здоровье, финансовые данные - требуют особого обращения, разграничения доступа и строгой политики ретенции.
- Данные контекста: слияние данных из разных источников может рождение кросс-доменных угроз идентификации, поэтому необходима обособленная обработка и минимизация объема данных.
- Выходные данные: результаты обработки и генерации контента LLM могут непреднамеренно утечить чувствительную информацию через обучающие сигналы, логи или ответы агента.
- Доступ и контроль: неадекватные политики доступа, устаревшие ключи, слабые секреты и отсутствие журналирования приводят к компрометации платформы.
- Комплаенс и аудит: отсутствие полной трассируемости данных и последовательности действий по политике снижает способность доказать соответствие регуляторным требованиям.
Риск-ориентированное проектирование
Риск-ориентированное проектирование предполагает три слоя: стратегию, архитектуру и операцию. На стратегическом уровне устанавливаются принципы минимизации данных, приватности по дизайну и ответственности за решения. В архитектуре реализуются технические средства защиты: шифрование, контроль доступа, маскирование, дифференцированная приватность и политика данных как код. На операционном уровне - мониторинг, аудит и регулярная переоценка рисков, включая тесты на устойчивость к инцидентам и проверки соответствия. Такой подход требует тесного взаимодействия между командами безопасности, юридическим отделом, командами разработки и бизнес-единицами.
В данном контексте архитектура данных должна поддерживать прозрачность потоков данных и обеспечивать детальную трассируемость до уровня источников. Это значит, что каждое использование данных должно быть связано с политикой доступа, правами пользователей и контекстом цели обработки. В итоге риск-менеджмент становится не отдельной функцией, а встроенной характеристикой жизненного цикла данных и моделей.
yaml
policy:
  version: 1.0
  data-assets:
    - **id**: customer_pii
      retention: 90d
      encryption:
        at_rest: AES-256
        in_transit: TLS1.3
      access:
        roles: ["data-scientist", "data-analyst"]
        conditions:
          - ip_range: "203.0.113.0/24"
  governance:
    masking: "tokenization"
    anonymization: "pseudonymization"
  auditing:
    enabled: true
    log_retention: 365
Приватность как базовый параметр архитектуры
Принципы приватности по дизайну
Приватность должна быть встроена в архитектуру еще на этапе проектирования. Это означает, что системы должны поддерживать минимизацию данных, ограничение доступа, защиту данных в покоя и в движении, а также возможность региональной локализации и управляемой ретенции. В контексте LLM и агентных систем особенно важно управление контекстной информацией и ограничение объема данных, которые попадают в контекст запросов, логи и кэш. Принципы включают в себя: минимизацию данных, конфиденциальность по умолчанию, защиту данных в ходе обработки и возможность удаления данных по запросу пользователя («right to be forgotten») в рамках регуляторных требований.
Защита данных в движении и на хранении
Основной набор механизмов включает шифрование данных на диске и в каналах связи, использование защищённых окружений выполнения и изоляцию между средами (разделение рабочих нагрузок). Важна детальная настройка менеджмента секретов и ключей доступа, а также поддержка аппаратной защиты ключей (HSM) там, где это возможно. Мониторинг аномалий доступа и автоматические уведомления являются частью операционной устойчивости и помогают быстро выявлять попытки несанкционированного доступа.
Управление доступом и анонимизация
Эффективная модель доступа строится на принципе наименьших прав и многоуровневой аутентификации. Роли и политики должны быть реализованы через централизованный механизм политики доступа, который способен обрабатывать контекстные условия (IP-адрес, время, источник данных). В качестве примера можно рассмотреть внедрение системы политики доступа на основе открытых стандартов: OPA (Open Policy Agent) для декларативного управления правилами и интеграция с существующей системой каталогов.
yaml
policy:
  version: 1.0
  decision:
    - **action**: "read"
      resource: "dataset:customer_pii"
      allowed_roles: ["data-scientist", "data-analyst"]
      constraints:
        - **region**: "EU"
        - **retention_not_after_days**: 90
Альтернативной опцией для некоторых проектов является интеграция решений типа Apache Ranger, которые обеспечивают централизованное управление доступом к данным и аудитом PostgreSQL, HDFS и других хранилищ, тем самым усиливая уровень наблюдаемости и контроля.
Маскирование, анонимизация и дифференцированная приватность
Для работы с чувствительными данными применяются методы маскирования и псевдонимизации, чтобы предотвращать идентификацию отдельных субъектов в обучении и генерируемых ответах. Дифференцированная приватность позволяет получить статистическую полезность данных без раскрытия отдельных записей. В сочетании с машинным обучением это обеспечивает возможность извлечения полезной информации из агрегатов без риска идентифицировать конкретных пользователей.
Упаковка и распространение данных
Необходимо явно отделять наборы данных с различными уровнями чувствительности и обеспечивать согласование между политиками на уровне систем хранения и аналитических инструментов. Публикация и обмен данными между подразделениями должны происходить через согласованные каналы и с надлежащей маскированием и ограничением доступа. Контроль версий и аудит изменений - важная часть, позволяющая восстанавливать контекст использования данных.
Этические принципы и ответственность
Этические рамки для сборки и использования данных
Этика в контексте AI-ready платформ требует ясной формулировки целей обработки данных, прозрачности по отношению к пользователям и ответственности за последствия моделей и агентов. В рамках проекта необходимо определить принципы: справедливость, недискриминация, прозрачность в отношении того, как принимаются решения, и ответственность за результаты. Этические принципы должны быть не буквой закона, а живым набором практик, которые применяются на каждом этапе реализации.
Этика тесно связана с методиками тестирования и оценки моделей, включая аудит предвзятости по демографическим признакам и оценку рисков для пользователей. В практической плоскости это означает внедрение механизмов предотвращения предвзятости и обеспечения надлежащей информированности пользователей о возможном воздействии решений.
Обнаружение и устранение предвзятости
Предвзятость может проявляться на уровне данных (заоблачения, неполные датасеты), в конфигурации модели и в сценариях использования. Подходы к снижению риска включают: сбор репрезентативных наборов данных, корректировку весов в обучении, тестирование на равные возможности и постоянный мониторинг выходов моделей. Важно учитывать культурный контекст и региональные различия, чтобы не допустить систематических ошибок и несправедливости в итоговых выводах.
Прозрачность и объяснимость
Прозрачность касается как внутренних процессов обработки, так и пользовательских интерфейсов. В архитектуре это выражается в возможности трассировать, как данные проходят через пайплайны, какие политики применяются и как сформировался вывод модели. Объяснимость помогает бизнесу и регуляторам понимать, почему система приняла определенное решение - особенно в критически важных сценариях, например, по кредитованию, найму или медицинским услугам.
Подотчетность и ответственность
Ответственность за последствия решений, принятых на базе AI-систем, должна быть четко закреплена в организационной структуре. Назначаются ответственные за данные офицеры, руководители проектов и члены надзорных комиссий. В случае инцидента необходима регламентированная процедура эскалации и информация, которая может быть предоставлена регулирующим органам и пользователям. Эволюционно такие процессы развиваются через «policy-as-code» и автоматизированные проверки соответствия в CI/CD конвейере.
yaml
ethics_framework:
  principles:
    - fairness
    - transparency
    - accountability
  governance:
    - **board_review**: true
    - **impact_assessment**: quarterly
  explanation:
    on_model_output: true
    on_decision_rationale: true
Механизмы соответствия и аудит
Регуляторика и стандарты
Соответствие требованиям регуляторов - один из краеугольных камней любой AI-ready платформы. В зависимости от юрисдикции применяются разные стандарты и правила: защита персональных данных (например, GDPR), требования к аудиту и криптографическим механизмам, правила хранения и ретенции. В рамках архитектуры целесообразно предусмотреть возможность адаптации политик под разные регуляторные режимы, а также внедрить процессы периодической переоценки соответствия, чтобы отражать изменения в законодательстве и бизнес-условиях.
Data lineage и мониторинг
Трассировка происхождения данных, их обработки и передачи в ходе жизненного цикла критически важна для аудита и восстановления контекста инцидентов. Логирование, мониторинг и визуализация цепочек обработки позволяют не только обнаруживать нарушения, но и понимать, как изменения в данных влияют на выводы моделей. Важна интеграция инструментов lineage с системами управления политиками доступа и обнаружения нарушений.
Инцидент-менеджмент
Процедуры реагирования на инциденты должны быть четко документированы и автоматизированы там, где это возможно. Это включает идентификацию, локализацию, устранение причин, уведомления заинтересованных сторон и последующую фиксацию уроков. В контексте агентных систем особенно важна способность быстро ограничивать контекстные окна и блокировать подозрительные сценарии взаимодействия агентов с внешними источниками данных.
Политика как код
Политики доступа, приватности и этических ограничений должны храниться в виде читаемых и исполняемых конфигураций, которые можно версионировать, тестировать и разворачивать через CI/CD. Это обеспечивает повторяемость и прозрачность изменений, а также облегчает аудит. В практической плоскости это означает тесную интеграцию между системами управления идентификацией, инструментами политики и пайплайнами данных.
Интеграции, управление данными и практические сценарии
Архитектурные паттерны интеграции
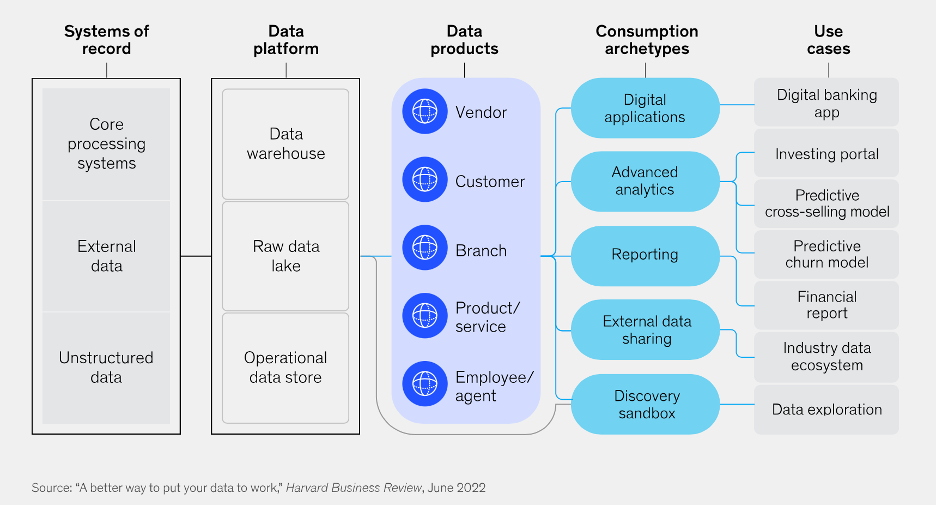
Этические и приватностные требования влияют на выбор паттернов интеграции данных: централизованные хранилища данных с ограничением доступа, федеративные источники, обработка через безопасные контейнеры и песочницы для моделей, а также слои маскирования и анонимизации на границе между источниками и аналитическими пайплайнами. Важно обеспечить совместимость между различными системами хранения и вычислениями, чтобы политика "принцип минимального доверия" сохранялась на всем пути данных.
Инструменты приватности и этики
Для реализации политики доступа и приватности можно использовать две группы инструментов: решения с открытым исходным кодом и коммерческие. В рамках этой главы упоминаются как примеры: OPA для декларативных политик и Apache Ranger как средство управления доступом и аудита. Эти инструменты могут сочетаться с решениями по дифференцированной приватности и маскированию данных, обеспечивая комплексный контроль над темами доступа, приватности и этических ограничений в пайплайнах.
yaml
data_pipeline:
  stages:
    - **extract**: "secure-extract"
    - transform:
        privacy: "masking"
        ethics: "bias-check"
    - **load**: "secure-load"
  governance:
    policy_engine: "OPA"
    auditing: "enabled"
Примеры реализации: конфигурации и сценарии
- Сценарий 1: обучение модели на синтетических данных с использованием дифференцированной приватности, где данные синтезируются из реальных источников и проходят маскирование на входе в модель.
- Сценарий 2: агент, который действует в ограниченной контейнерной среде и не имеет доступа к внешним сетям без прохождения процедуры проверки безопасности и разрешения администратором.
- Сценарий 3: аудит пользовательских запросов и выводов модели, с автоматической маркировкой тех случаев, где вывод может содержать потенциально чувствительную информацию.
В каждом сценарии критично присутствие механизмов мониторинга, журналирования и подготовки к аудиту, чтобы можно было объяснить принятые решения и выявлять отклонения от согласованных политик.
Ключевые выводы
- Риски в AI-ready Data Platform необходимо рассматривать как системную проблему, затрагивающую архитектуру, операционные процессы и организационную культуру.
- Приватность должна быть встроена в дизайн систем: минимизация данных, защита на всех этапах цикла жизни данных, контроль доступа и прозрачность обработки.
- Этические принципы должны быть интегрированы в процессы разработки и эксплуатации через рамки прозрачности, ответственных лиц и механизмов аудита.
- Политики доступа и приватности требуют программной реализации в виде политики как код и централизованных инструментов управления доступом.
- Механизмы аудита, трассировки данных и инцидент-менеджмента позволяют не только соответствовать требованиям, но и оперативно реагировать на угрозы.
- Интеграционные паттерны должны учитывать приватность и этику на границе источников данных и вычислительных сред, обеспечивая совместимость между платформами и соблюдение политик.
- Реализация требует баланса между безопасностью, производительностью и функциональностью, что достигается через сотрудничество между командами безопасности, юридическим отделом, инженерами и бизнес-единицами.
FAQ
- Какие основные риски следует учитывать при внедрении AI-ready Data Platform?
- Ответ: Прежде всего, это риск утечки или неправильной обработки персональных данных, риск предвзятости и непреднамеранных дискриминационных исходов, риск неправильной или недостаточной аудита и контроля, риск несоответствия регуляторным требованиям. Правильная стратегия включает приватность по дизайну, управление доступом, мониторинг и четко описанную ответственность за данные и выводы моделей.
- В чем состоит понятие приватности по дизайну в контексте LLM и агентных систем?
- Ответ: Приватность по дизайну предполагает встроенную защиту данных на этапах сбора, хранения, обработки и вывода. Это значит минимизацию данных, маскирование и псевдонимизацию, шифрование в движении и на хранении, ограничение доступа, а также использование дифференцированной приватности и архитектурных изоляций для предотвращения утечек через контекст или логи.
- Какие механизмы поддержки прозрачности и объяснимости можно внедрить?
- Ответ: Необходимо обеспечить трассируемость обходных цепочек обработки данных, журналирование изменений, объяснимость решений моделей и возможность предоставлять пользователям обоснование выводов. Технологически это достигается комбинацией объяснимости моделей, журналирования контекстов запросов, а также предоставлением интерфейсов, где пользователи могут просматривать логи обработки и принятые политики.
- Как организовать ответственность за результаты ИИ в рамках крупных проектов?
- Ответ: Важно закрепить роли и обязанности в рамках корпоративной структуры: ответственный за данные (data steward), ответственный за модели (model risk owner), и управляющий регуляторными рисками. Необходимо внедрить процессы оценки воздействия на этику и безопасность, регламентированное инцидент-менеджмент и механизм полевой проверки и аудита.
- Какие практические способы снижения риска в архитектуре данных?
Применение политики доступа на основе ролей и контекстных условий, маскирование и псевдонимизация чувствительных данных, шифрование в движении и на хранении, использование изолированных сред выполнения для моделей, аудит и мониторинг доступа, а также внедрение политики как код и автоматизированных тестов соответствия в CI/CD.
- Какие технологии и практики применяются для соответствия требованиям регуляторов?
- Ответ: Использование политик доступа и аудита (OPA, Ranger), регламентация политики ретенции и шифрования, трассировка данных (data lineage) и регулярный аудит соответствия. Важно документировать политику, сохранять журналы и обеспечивать возможность демонстрации соответствия регуляторным требованиям по требованию.
- Какие типичные ошибки встречаются при реализации этических принципов?
- Ответ: Недостаточная вовлеченность бизнес- stom и юридического отдела, отсутствие четкого определения ролей и ответственности, поверхностные оценки предвзятости без системной проверки, слабые механизмы мониторинга и ограниченная прозрачность для пользователей. Эти ошибки можно предотвратить через раннюю интеграцию этических принципов в требования проекта, регулярный аудит и непрерывное обучение сотрудников.
- Как внедрять защиту данных в пайплайне данных и выводах моделей?
- Ответ: Внедрять защиту на каждом этапе: сбор и предобработка данных с минимизацией, применение маскирования и псевдонимизации, дифференцированную приватность в статистических операциях, контроль доступа через политики, и аудит на выходах моделей. В идеале это сопровождается автоматизированными проверками соответствия и сценариями тестирования на предвзятость.
- Как обеспечить надёжное управление данными и их lineage в больших платформах?
- Ответ: Важна централизованная система документирования источников данных, трансформаций и доступов. Назначение владельцев данных, автоматическое журналирование действий и интеграция с системами мониторинга помогут отслеживать происхождение данных и быстро идентифицировать источник проблем или нарушения политики.
- Какие шаги рекомендуются для начала внедрения этих практик в проект?
- Ответ: Определить карту данных и чувствительных категорий, сформировать команду ответственных за данные и этические принципы, внедрить базовую политику доступа и аудит, настроить политики в виде кода, внедрить мониторинг и инцидент-менеджмент, начать с пилотного проекта и постепенно расширять охват, добавляя новые проверки и аудит в процессе роста платформы.


