

Безопасность данных и соответствие требованиям (Privacy, GDPR, HIPAA)
Краткое введение
В рамках курса «Feature Store и повторное использование признаков: проектирование, версии, доступы и интеграция с пайплайнами обучения» вопрос безопасности данных и соответствия требованиям выступает основой доверия к промышленной эксплуатации ML-архитектур. Feature Store оперирует чувствительными данными: персональными данными, медицинскими данными, финансовой информацией и коммерческой тайной. Любой сбой в защите превращает ценную интеллектуальную собственность и репутацию организации в риск: утечка PII, нарушение регламентов, штрафы, остановка обучения и недоверие заказчиков. Цель главы - систематизировать принципы защиты, показать архитектурные решения и практические механизмы, которые позволяют обеспечить принцип “least privilege”, полноту аудита и соответствие GDPR/HIPAA в рамках конвейера обучения и повторного использования признаков.
Введение
Защита данных в контексте feature store включает несколько пересекающихся слоёв: данные на входе (сырьё и метаданные признаков), хранение признаков, доступ к признакам и управление версиями. Эффективная реализация требует сочетания технических средств (шифрование, контроль доступа, аудит, маскирование) и организационных процессов (DPIA, ответственность, договора), а также методологии, позволяющей адаптироваться к изменяющемуся регуляторному окружению.
Основные понятия:
- PII (персональные данные), PHI (медицинские данные), GDPR и HIPAA как регуляторные рамки.
- Privacidad как концепт конфиденциальности и минимизации данных.
- Data governance и data lineage как базовые элементы контроля.
- Access control models: RBAC, ABAC, DAC, MAC.
- Privacy-enhancing technologies (PET): маскирование, псевдонимизация, дифференциальная приватность, федеративное обучение.
Теоретические основы и терминология
- Приватность и минимизация: хранение только тех данных, которые необходимы в рамках признаков, и только на период, необходимый для целей обучения.
- Регуляторное соответствие:
- GDPR: законность обработки, цель обработки, минимизация данных, ограничение сроков хранения, право субъектa на доступ к данным, удаление и переноса, аудит и доказывание соблюдения.
- HIPAA: защита PHI в контексте медицинских данных, требования к охране конфиденциальности и целостности, управление доступами и аудит.
- Технические концепты:
- TLS 1.2+ для передачи данных в режиме покоя и движения.
- шифрование на хранении (AES-256, GCM/CCM режимы), управление ключами (KMS).
- псевдонимизация и маскирование (masking) для снижения риска обработки PII.
- аудит и неотъемлемая трассируемость действий пользователя и системных сервисов.
- политика доступа как код (policy as code) и автоматизация контроля доступа.
Термины в рамках архитектуры:
- Feature Store: слой хранения и управления признаками с поддержкой версионирования и lineage.
- Metadata/Catalog: реестр признаков и сущностей данных, атрибуты безопасности.
- Control Plane и Data Plane: управление политиками и учет доступа vs обработка данных.
- DPIA (Data Protection Impact Assessment): оценка воздействия на защиту данных.
- Data Residency: локализация данных в рамках юрисдикций.
Методологии и подходы
- Privacy by Design и Privacy by Default: безопасность встроена на проектном этапе, а не добавляется позднее.
- Data Governance как процесс: роли, ответственности, регламенты по обработке данных.
- Политики доступа как код: управляем политики через OPA/Rego, Terraform, Kubernetes RBAC.
- DPIA и DSR (Data Subject Rights): документирование соответствия и поддержка запросов субъектов данных.
- Дорожная карта по соответствию: план миграций к безопасной архитектуре, внедрение упреждающих мер и ретроспективных аудитов.
Архитектура и технологическая реализация
Общая концепция архитектуры безопасности в связке с feature store:
- Уровень инфраструктуры
- Защита транспорта: TLS 1.2+/1.3, клиентские и сервисные сертификаты.
- Защита хранения: шифрование at rest, безопасные HSM/KMS (например, облачный KMS или локальный Hardware Security Module).
- Управление секретами: Vault, Kubernetes Secrets с шифрованием, Ali/Яндекс версии секретного хранения.
- Уровень данных и метаданных
- Catalog с пометками по чувствительности (PII/PHI, VIP, конфиденциально).
- Включение политики защиты в процесс регистрации признаков (privacy tags).
- Версионирование признаков и контроль доступа к версиям.
- Уровень доступа и контроля
- RBAC/ABAC для API, UI и пайплайнов.
- Политики доступа к признакам, основанные на роли, контексте клиента, проекта и области применения.
- Аудит и логирование: хранение целостных журналов действий пользователей и систем.
- Уровень интеграции с пайплайнами обучения
- Инструменты автоматизации тестирования безопасности перед развёртыванием в прод.
- Инструменты мониторинга и SIEM для событий доступа к признакам и данным.
- Поддержка федеративного доступа и локальных решений в рамках регуляций.
Пример архитектурной схемы (упрощённая текстовая диаграмма):
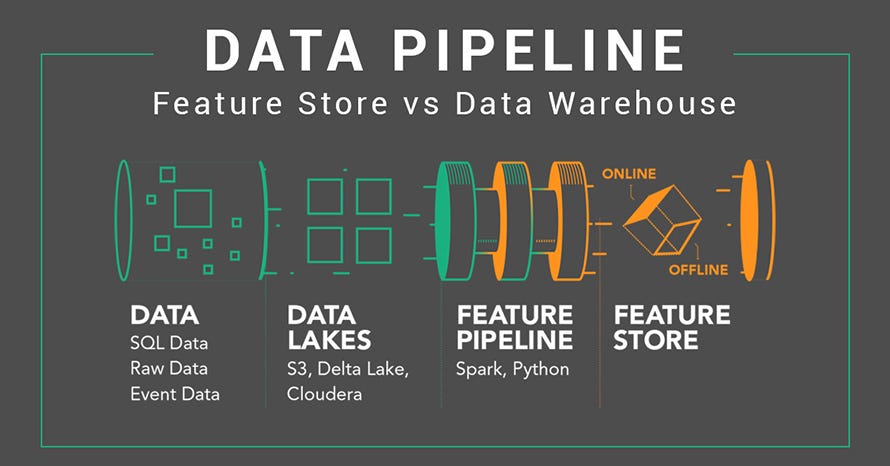
- Источники данных -> Ingestion Layer -> Feature Registry/Store -> Признаки (версии) -> Модели обучения
- Управление доступами и политикой: OPA/Policy Engine, секреты через Vault, мониторинг через SIEM
- Шифрование: TLS/HTTPS на каналах, AES-256 на хранении, ключи в KMS
- Логирование: полнотекстовый аудит и телеметрия доступа
Ключевые принципы реализации:
- least privilege: пользователи и сервисы получают минимально необходимый доступ.
- data lineage: отслеживание происхождения признаков, версий и изменений.
- privacy by design: встроенное маскирование и псевдонимизация на этапе регистрации признаков.
- регуляторное соответствие: поддержка DPIA, DSR и политики хранения по срокам.
Технические элементы реализации:
- API безопасности: OAuth 2.0 / OIDC, JWT с краткоживущими токенами, подпись токенов.
- Аудит: структурированные логи и унифицированная схема событий (JSON) с метаданными пользователя, действиями, временем.
- Маскирование и псевдонимизация: динамическое замещение PII в задачах обучения, временная маска для предварительного просмотра.
- Шифрование ключей: миграции ключей, ротация каждые N дней, журнал ротаций.
- Контроль версии: хранение версий признаков и метаданных, автоматическое откатывание и аудит изменений.
Пример кода: политика доступа к признакам (OPA/Rego)
Пример политики, ограничивающей доступ к признакам по роли и проекту
package auth.featurestore
default allow = false
Разрешение по ролям
allow {
input.method = "GET"
input.user.roles[_] = "data_scientist"
input.feature.project = input.user.project
input.user.access_level = "read"
}
Разрешение на запись версии признака ограничено
allow {
input.method = "POST"
input.user.roles[_] = "feature_owner"
input.feature.project = input.user.project
input.user.access_level = "write"
}
Контроль по чувствительности данных
allow {
input.feature.privacytag != "PII"
input.method = "GET"
input.user.roles[] = "data_consumer"
}
Этот пример демонстрирует, как код политики может определять, кто может читать или писать признаки в зависимости от роли, проекта и уровня доступа. Реальная конфигурация должна дополняться контекстом пользователя, времени, региона и конкретными ограничениями по данным.
Пример конфигурации секретов (Vault)
Пример фрагмента конфигурации для Vault (псевдокод)
vault secrets enable -path=feature-store/ kv
vault kv put feature-store/keys/db-password value=SECRET_DB_PASSWORD
vault secrets enable -path=kms transit
vault write kms/aliases/my-key purpose="aes256-gcm96" type="alias"
Кодовый пример безопасной передачи ключей и материалов в пайплайны обучения:
- Учётный процесс: модель обучается в среде с ограниченным доступом к секретам.
- Чтение ключей и секретов происходит через обращения к Vault через сервисный аккаунт с ограничением по сроку действия токенов.
Интеграция с фреймворками и протоколами:
- HTTPS/TLS для всех API
- OIDC для входа и управления пользователями
- OPA для декларативной политики доступа
- Vault для секретов и ключей
- DI/DevSecOps: включение тестов безопасности в CI/CD
Организационные и процессные аспекты
- Роли и ответственные
- Data Owner: владелец домена данных, отвечает за законность и цель обработки.
- Data Steward: обеспечивает качество, доступность и безопасность данных.
- Data Protection Officer (DPO): мониторинг соблюдения регламентов, ведение DPIA.
- Security Architect/Engineer: реализация технических средств защиты.
- Политики и регламенты
- Политика минимизации хранения признаков.
- Политика доступа на основе ролей и контекста (ABAC).
- Политика хранения и удаления: сроки хранения, удаление и псевдонимизация по истечении срока.
- Управление данными и DPIA
- Предварительная оценка воздействия (DPIA) при добавлении новых источников и признаков.
- Ведение журнала обработки данных, возможность аудита и проверки соответствия.
- Внешние контрагенты и интеграции
- Договоры об обработке данных (DPA), требования к безопасности поставщиков.
- Контроль над совместным использованием признаков и данными между командами.
- Обучение и культура
- Регулярные тренинги по безопасности, phishing-тесты, обработка инцидентов.
- Чек-листы перед публикацией моделей и признаков в продакшн.
Практические примеры и кейсы (open-source и российские решения)
- Open-source стек
- Feast + Apache Atlas: Feast обеспечивает хранение и версионирование признаков, Atlas - метаданные и lineage, включая привязку к регуляторным требованиям.
- OPA (Open Policy Agent) + Kubernetes RBAC: управление доступами к данным и признакам на уровне кластера.
- Vault (HashiCorp): секреты, ключи шифрования, ротация ключей, интеграция с KMS.
- Дифференциальная приватность и маскирование: интеграции с Spark/Beam через кастомные стадии обработки.
- Apache Ranger: централизованное управление доступом к данным в Hadoop-средах и деривативах.
- Российские решения и контекст
- Яндекс.Облако DataSphere (и сопутствующие сервисы безопасности): локализация в регионах РФ, управление секретами, аудит, интеграция с централизованными политиками.
- СберCloud ML/Data Platform: управление доступами и обеспечение соответствия для гос и промышленных проектов, инструментальные средства аудита и контроля доступа.
- КриптоПро и ГОСТ-совместимость: криптографические модули для защиты ключей и прозрачной государственной сертификации.
- Практические кейсы по локализации: хранение регуляторно чувствительных данных в российских регионах, обеспечение соответствия локальным требованиям по срокам хранения и доступу.
Примеры реализации
- Кейс 1: открытая инфраструктура на Feast + Vault + OPA + Atlas
- Архитектура: ingestion layer -> feature store -> API -> модель
- Безопасность: TLS, JWT, OPA-политики, Vault для секретов, Atlas для lineage
- Преимущества: гибкость, прозрачность lineage, прозрачная проверка соблюдения требований
- Кейс 2: российский контекст на базе Яндекс.Облако / СберCloud
- Архитектура аналогична, но с учётом локальных политик, региональных стейкхолдеров и интеграций с локальными решениями (DLP, аудит, региональные юридические лица)
- Преимущества: соответствие локальным регуляциям, поддержка региональных SLA и локализаций.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Безопасность на конвейере обучения
- Прямой доступ к признакам ограничен через API Gateway, где применяются OIDC/OAuth2 и RBAC/ABAC.
- Признаки хранятся в зашифрованном виде; ключи управляются через KMS с полным журналом операций.
- Каждая версия признака имеет тег безопасности (privacy_tag) и временные ограничения на доступ.
- Контроль доступа и политика
- Политики реализованы как код (OPA+Rego). Пример выше иллюстрирует базовые принципы: чтение для data_scientist и запись только для feature_owner.
- Логирование всех операций; сбор телеметрии для аудита и мониторинга.
- Маскирование и псевдонимизация
- В момент загрузки признаков выполняется маскирование PII, чтобы защитить данные на стадии анализа.
- Псевдонимизация позволяет проводить обучающие вычисления без прямого доступа к реальным идентификаторам.
- Дифференциальная приватность и федеративное обучение
- Для некоторых задач используются подходы с дифференциальной приватностью при агрегациях признаков.
- Федеративное обучение: обучающие данные остаются локальными у партнеров, признаки обобщаются и агрегируются в центр через безопасные протоколы.
- Управление данными и ротация
- Жизненный цикл признаков: регистрация -> использование -> архив -> удаление. Ротация токенов и ключей каждые N дней.
- DPIA при добавлении нового набора признаков или партнёров по обработке.
- Примеры протоколов и форматов
- TLS 1.3, AES-256-GCM на хранении и передачи
- JSON/AVRO/SR-карты для метаданных
- Rego-политики для доступа к API
Кодовый пример: хранение и доступ к признакам с использованием TLS и JWT
- Токены JWT с кратким сроком жизни для доступа к признакам
- Пример FastAPI-эндпоинта с валидацией JWT и проверкой политики OPA
from fastapi import FastAPI, Depends, HTTPException
from pydantic import BaseModel
import jwt
import requests
app = FastAPI()
OPA_URL = "https://opa.example.com/v1/data/decision"
OPA_POLICY = "package auth.featurestore\ndefault allow = false\n..."
class FeatureRequest(BaseModel): feature_id: str project: str
def verify_jwt(token: str = Depends(...)):
Проверка подписи и срока действия JWT
try:
    payload = jwt.decode(token, "public_key.pem", algorithms=["RS256"])
    return payload
except Exception as e:
    raise HTTPException(status_code=401, detail="Invalid token")
def opa_decide(input_ctx: dict):
resp = requests.post(OPA_URL, json={"input": input_ctx})
if resp.status_code == 200:
return resp.json().get("result", False)
return False
@app.post("/features/get")
def get_feature(req: FeatureRequest, user=Depends(verify_jwt)):
input_ctx = {
"user": user,
"feature": {
"id": req.feature_id,
"project": req.project
}
}
if not opa_decide(input_ctx):
raise HTTPException(status_code=403, detail="Access denied by policy")
В реальности - извлечение признака из хранилища
return {"feature_id": req.feature_id, "value": "encrypted_value"}Таблица: типовые политики доступа и соответствующие роли
- Data Owner: мощный доступ к управлению признаками своего домена
- Data Steward: доступ на чтение к данным, метаданным и lineage
- Data Scientist: доступ на чтение к признакам, без доступа к чувствительным полям
- DevOps/Platform: доступ к инфраструктуре без чтения данных
Управление данными и аудит
- Журналы аудита должны храниться в неизменяемом виде (WORM-хранилище или журнал через SIEM).
- Метаданные и lineage должны оставаться неизменными для документирования соответствия и расследований.
- Регламент хранение: определения по срокам хранения для разных категорий данных (PII, PHI, анонимизированные данные).
Риски, ограничения и типовые ошибки
- Избыточный доступ: чрезмерные роли и доверие без надлежащей автоматизации. Решение: внедрить ABAC, ограничить scope, регулярные проверки.
- Недостаточная маскировка: реальный риск через неправильную конфигурацию полей, что приводит к утечкам через лог-файлы.
- Неэффективная ротация ключей: нарушение политики хранения и утечи.
- Неполная локализация: данные регламентированной области неверно размещены в регионе.
- Отсутствие lineage: трудности в аудите и DPIA без полноценных метаданных.
- Непривязка к регуляторным обновлениям: регуляторные требования меняются, и политики устаревают; необходим процесс обновления и мониторинга.
Перспективы развития направления
- Конфиденциальные вычисления и защищённые среды
- Интенсификация использования SGX/ARM TrustZone и аппаратного обеспечения для защиты вычислений над чувствительными данными.
- Федеративное обучение и приватная регрессия/классификация
- Обучение на локальных данных без перемещения исходных данных, сохранение приватности признаков.
- Автоматизация DPIA и реального времени
- Интеграция DPIA в пайплайны: автоматический анализ рисков на входах и уведомления об изменениях в данных.
- Расширение журналирования и мониторинга
- Расширенные телеметрические данные по доступам к признакам и регуляторному контексту, более детальные дашборды.
- Улучшения в политике и управлении секретами
- Автоматическая ротация ключей, автоматическое внедрение обновлённых политик доступа, внедрение Threat Intelligence для политики.
Заключение
Безопасность данных и соответствие требованиям - неотъемлемые элементы архитектуры Feature Store и пайплайнов ML. Правильный подход сочетает защиту на всех уровнях архитектуры, грамотное управление доступами, прозрачный аудит и соответствие нормам GDPR/HIPAA. Важна не только технология, но и культура ответственности, процессы DPIA, управление данными и вовлечение бизнес‑контекстов. Применение политики как код, интеграция с KMS/Vault, и применение privacy‑по‑модели позволяют обеспечить устойчивое и безопасное использование признаков, расширяя возможности повторного использования признаков без рисков для регуляторного соответствия и доверия пользователей.
Вопрос-Ответ (FAQ)
В чем заключается основная задача защиты признаков в feature store?
Ответ: задача** - минимизация рисков утечки PII/PHI, обеспечение законности обработки, поддержка аудита и возможность восстанавливать действия в случае инцидентов. Это достигается через least privilege, маскирование, шифрование, контроль доступа и аудит.
Как реализуется минимизация данных в процессе создания признаков?
Ответ: применяется принцип минимизации на стадии регистрации признаков: хранение только необходимых полей, маскирование чувствительных данных, псевдонимизация, ограничение жизненного цикла данных и поддержка журналов изменений.
Какие регуляторные требования наиболее критичны для ML‑проектов?
Ответ: GDPR (право на доступ, удаление данных, переносимость), HIPAA (PHI) для медицинских данных, требования к аудиту и локализации, а также национальные регуляции по защите данных и кибербезопасности.
Какие технологии поддерживают политическое управление доступами?
Ответ: RBAC и ABAC, OPA (policy as code) для декларативной политики, Kubernetes RBAC, Vault для секрета и ключей, TLS/OAuth2/OIDC для аутентификации и авторизации.
Как обеспечивается аудит и трассируемость?
Ответ: через структурированные журналы действий, хранение в защищённых журнах, неизменяемые хранилища, интеграцию с SIEM и линейку данных, чтобы можно было реконструировать путь данных и действия пользователей.
Что такое DPIA и как она применяется к признакам?
Ответ: DPIA** - оценка воздействия на защиту данных; применяется при добавлении новых источников данных, изменений в пайплайнах и выборе новых признаков. Это документ, анализ рисков и меры снижения рисков.
Какие open-source решения особенно полезны для реализации защиты?
Ответ: Feast (feature store), Apache Atlas (метаданные), OPA (политики), Vault (секреты/ключи), Kubernetes RBAC, TLS/модули криптографии.
Какие российские решения могут использоваться в рамках контекста РФ?
Ответ: Яндекс.Облако DataSphere и сопутствующие сервисы безопасности; СберCloud ML/Data Platform; использование отечественных криптографических модулей (КриптоПро) и ГОСТ‑совместимых инструментов для обеспечения соответствия локальному регуляторному окружению.
Какие типовые ошибки чаще всего встречаются в проектах защиты признаков?
Ответ: избыточные права доступа, недостаточное маскирование, слабая ротация ключей, отсутствие lineage и DPIA, несогласованность политик между этапами конвейера, несанкционированный доступ через журналы.
Какие перспективы в ближайшие годы?
Ответ: конфиденциальные вычисления и секрет‑ориентированная обработка, федеративное обучение с приватной регрессией, автоматизация DPIA, более тесная интеграция с регуляторными требованиями и улучшение процессов аудита и политик.
Feature Store становится важным элементом зрелой AI-платформы, позволяя масштабировать разработку моделей, управлять признаками и повышать повторное использование данных в ML-проектах.
Узнайте, как внедрить искусственный интеллект для бизнеса от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до создания AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в бизнес-процессы компании.


