

Процессы операционной эксплуатации данных и сервис-менеджмент
Операционная эксплуатация данных и сервис-менеджмент представляют собой совокупность практик, процессов и ролей, направленных на обеспечение устойчивой, предсказуемой и безопасной работы данных как ключевого актива бизнеса. В условиях роста объёмов данных, усложнения архитектур и требований к скорости принятия решений эксплуатационные процессы переходят от хаотичной повседневной поддержки к управляемому, сервис-ориентированному подходу. В данной главе рассматриваются принципы DataOps в контексте сервис-менеджмента данных, практики мониторинга и инцидент-менеджмента, управление изменениями, а также организационные изменения, необходимые для устойчивой реализации стратегии работы с данными.
В рамках главы приводятся концепции, структурированные подходы к проектированию сервисов данных и их эксплуатации, практические рекомендации по построению организации и процессов, а также примеры того, как обеспечить согласованность между бизнес-требованиями и техническими решениями. Основной акцент сделан на том, почему данные должны обслуживаться как сервис, каковы критерии качества и надёжности, и какие управленческие практики позволяют снизить риск, ускорить время реакции и повысить ценность данных для пользователей.
- Архитектура операционных процессов и сервисов данных
- Мониторинг, инциденты и устойчивость сервисов данных
- Управление изменениями и практики CI/CD для данных
- Роли, ответственность и организационная культура эксплуатации
Концепции операционной эксплуатации данных
Операционная эксплуатация данных - это систематизированное выполнение рутины и экосистемных процессов, обеспечивающих доступность, качество и устойчивость данных в течение всей их жизненной траектории: от источников до аналитических потребителей. В классическую инженерию данных включаются такие направления как сбор, обработка, хранение и выдача данных, однако без сфокусированной эксплуатации оборачивается рисками: рост technical debt, задержки в поставке новых данных, ухудшение качества и увеличение количества инцидентов.
Ключ к эффективной эксплуатации - переход к сервис-ориентированному подходу. Каждая совокупность данных, её пайплайн, набор метаданных, контракт качества и доступности рассматриваются как отдельный сервис, имеющий владельца, срок обслуживания, набор KPI и регламент реагирования на инциденты. Такой подход позволяет бизнесу формализовать ожидания, а ИТ - управлять изменениями, мониторингом и ресурсами в рамках четко очерченного сервиса.
В рамках DataOps в эксплуатацию включаются элементы следующих компетенций:
- организационная координация между бизнесом, аналитикой и инженерией;
- автоматизация и непрерывную проверку качества данных на всех этапах пайплайна;
- управление изменениями с учётом рисков для downstream-потребителей;
- инфраструктура и операционные инженерии, ориентированные на повторяемость и воспроизводимость.
Эти принципы подчеркивают необходимость структурирования операционных функций и привязки их к бизнес-целям. В то же время следует обеспечить баланс между скоростью изменений и устойчивостью сервисов. Реализация требует определённых архитектурных решений: контрактов данных, каталогов сервисов, систем мониторинга и регламентов реагирования на инциденты.
На практике для достижения цели применяются подходы и технологии, которые позволяют превратить data-платформу в управляемый набор сервисов. Применение таких инструментов, как системы оркестрации данных и мониторинга, обеспечивает единый контроль над доступностью, качеством и безопасностью данных. В то же время важно сохранять гибкость и скорость внедрения изменений, что достигается за счёт внедрения ряда практик DataOps.
- Роль контракта данных и данных как сервиса: контракт описывает ожидаемое качество, частоту обновления, задержки, условия доступа и ответственность сторон.
- Принцип единого каталога сервисов: единая карта доступных сервисов для аналитиков, бизнес-пользователей и разработчиков; ясная структура владения и обновления.
- Концепция устойчивости: предвидение и обработка отказов, план действий в чрезвычайных ситуациях, автоматические механизмы отката.
Управление сервисами данных: каталог, SLA и контракты
Управление сервисами данных требует системного подхода к описанию, контролю и эволюции каждого сервиса. Это включает в себя создание и поддержание каталога сервисов, формализацию соглашений об уровне сервиса (SLA/SLO), контрактов качества и регламентов эксплуатации. Такой подход позволяет снизить риск недопониманий между бизнесом и ИТ, упростить поиск целевых сервисов и обеспечить предсказуемое поведение систем.
Каталог сервисов данных - это живой реестр, в котором агрегируются метаданные о сервисах: владелец, ответственные за качество, входящие и исходящие зависимости, критичность, частота обновления, требования к доступу, политики безопасности и требования к мониторингу. Каталог должен поддерживать версии контрактов и быть доступным для всех стейкхолдеров через централизованный интерфейс. Важной частью каталога является карта зависимостей между сервисами: от источников до потребителей, что позволяет оперативно оценивать влияние изменений и планировать регламент изменения.
SLA и SLO для сервисов данных устанавливают ожидаемое качество, доступность, время задержки, точность обновления и время отклика на запросы. Эти показатели должны быть:
- измеримыми;
- согласованными с бизнес-потребителями;
- привязаны к реальным лимитам инфраструктуры и ресурсов.
Контракты качества данных фиксируют конкретные требования к данным: частоту обновления, полноту, корректность, согласованность и актуальность. Контракты учитывают географическую юрисдикцию, безопасность и соответствие регуляторным требованиям. В процессе эксплуатации данные контрактуются не как одноразовый документ, а как живой артефакт, который переходит через циклы изменения и обновлений.
- Организационные роли владельцев сервисов должны быть четко зафиксированы в SLA и в каталоге сервисов.
- Контракты качества данных должны быть автоматизировано проверяемыми на этапе пайплайна и в процессе мониторинга.
- Важно реализовать механизм уведомления и эскалации при нарушении контрактов: автоматическая сигнализация, планы по устранению причин и корректирующие действия.
Ключевыми практиками являются: внедрение консультационной роли data product owner, создание регулярных пост-incident reviews по критическим сервисам и поддержка runbooks для стандартных сценариев эксплуатации. На практике применяются архитектурные шаблоны, которые поддерживают повторяемость и масштабируемость: стабильно версионируемые схемы данных, использование контрактов схем, управление зависимостями и централизованное хранение конфигураций.
Что касается инструментов и технологий, для открытой экосистемы часто используют современные решения:
- системы потоковой передачи данных и их мониторинг, например Apache Kafka в связке с системой мониторинга для оценки задержек и доставки;
- оркестраторы данных, такие как Apache Airflow, которые позволяют управлять зависимостями, расписанием и качеством данных на каждом этапе пайплайна;
- системы мониторинга и визуализации, например Prometheus и Grafana, для отображения целей SLA/SLO и оперативных сигналов о состоянии сервисов.
Важно помнить, что инструменты должны подбираться под контекст конкретной организации и её регуляторные требования. Оптимальный набор упорядочивает контракты и каталоги так, чтобы бизнес-пользователь мог быстро найти нужный сервис, а инженер - увидеть зависимости и регламент реагирования на события.
Мониторинг, инциденты и устойчивость сервисов данных
Мониторинг должен охватывать не только технические параметры инфраструктуры, но и бизнес-фокусы качества данных: точность, полноту, свежесть и согласованность. Эффективная система мониторинга строится вокруг трех структурных элементов: наблюдаемости (observability), уведомлений и регламентов реагирования на инциденты. В контексте данных это означает сбор метрик на уровне пайплайнов, наборов данных, контрактов и потребителей, а также централизованные логи и трассировки для прослеживаемости событий через конвейеры.
- Набор целей мониторинга включает: доступность пайплайнов, время задержки, пропуски и искажения данных, частоту ошибок в пайплайне, качество данных по набору метрик. Подобные показатели позволяют оперативно оценить влияние изменений и вовремя скорректировать траекторию развития сервиса.
- Мониторинг часто строится на связке инструментов: метрики (Prometheus), визуализация (Grafana), журналы (ELK/EFK или аналог), трассировка потоков (опционально, если есть распределённые пайплайны).
Инцидент-менеджмент в операциях данных опирается на четко регламентированный жизненный цикл: обнаружение, классификация, эскалация, устранение, восстановление и постинцидентный разбор (RCA). В контексте данных RCA часто фокусируется на причинно-следственных связях: изменения в источнике данных, несогласованные изменения схем, регрессионные затраты и влияние на downstream-потребителей. Важной частью является документирование runbooks - пошаговых инструкций по реагированию на типовые сценарии, их обновление и обучение сотрудников.
Некоторые практики, которые повышают устойчивость операций, включают:
- введение сервисно-ориентированного мониторинга, когда каждый сервис имеет собственные целевые параметры QoS (Quality of Service) и соответствующий набор алертов;
- автоматическое тестирование качества данных на стадии входа в пайплайн, включая проверки схем, уникальности ключей и ограничений по бизнес-правилам;
- подготовку плана отката и механизмов отката к предыдущим версиям набора данных или пайплайна, чтобы минимизировать воздействие изменений;
- создание регламентированных post-incident reviews и внедрение корректирующих действий в рамках релизного цикла.
В качестве примеров инструментов можно отметить:
- Apache Kafka как платформа потоковых данных, требующая мониторинга задержек и потребления сообщений;
- системы оркестрации, например Apache Airflow, позволяющие конфигурировать расписания и зависимые задачи с учётом статуса выполнения;
- инструменты визуализации метрик, такие как Prometheus и Grafana, для отслеживания SLA/SLO и выявления отклонений в режиме реального времени.
Особое внимание уделяется развитию observability. В контексте данных observability включает не только системные метрики, но и данные о качестве: валидируемые схемы, сигналы согласованности и качество целевых таблиц. Это требует согласованности между данными и их назначением для анализа. Он включает в себя такие практики, как:
- постановка контрактов качества данных и их автоматизированная проверка;
- настройка инструментов lineage и lineage-based alerting;
- документирование зависимостей между наборами данных и их потребителями.
Управление изменениями и практики CI/CD для данных
Изменения в данных и пайплайнах - источник риска, влияющего на downstream-потребителей и бизнес-решения. Эффективное управление изменениями требует формализованной политики, согласований между заинтересованными сторонами и внедрения методологий CI/CD, адаптированных под данные. В этом контексте важны принципы безопасного и повторяемого внедрения изменений: контроль версий схем, тестирование изменений на стейджинге, аудит изменений и механизм отката.
Ключевые элементы управления изменениями включают:
- управление версиями схем и контрактов - каждое изменение схемы данных сопровождается версионной историей; потребители выбирают совместимую версию;
- проверки на соответствие бизнес-правилам - в процесс входящих данных интегрируются автоматические проверки корректности и целостности;
- контроль доступности и безопасного выпуска изменений - план изменений координируется через CAB (Change Advisory Board) или аналог;
- интеграция CI/CD для данных - автоматизация сборки, тестирования и развёртывания пайплайнов, а также контрактов данных в единый конвейер;
- мониторинг последствий изменений - трассировка и RCA случаев, когда нового поведения не ожидают downstream-потребители;
- режимы отката и rollback-планы - для быстрого возвращения к стабильной версии набора данных или пайплайна.
Практически это реализуется через сочетание нескольких практик:
- создание и поддержка набора тестовых данных и песочницы (sandboxes) для безопасной проверки изменений;
- внедрение тестов на каждый этап пайплайна: валидность данных, консистентность, соответствие контрактам;
- управление секретами и безопасностью изменений - ключевые данные и параметры должны находиться под надлежащим контролем;
- использование feature flags для данных, чтобы вводить новые правила постепенно и без риска для существующего потребителя.
Развитие CI/CD для данных нередко опирается на сочетание инструментов: скрипты автоматизации, интеграционные тесты, тестовые наборы данных и конфигурации, совместимые с существующей архитектурой данных. В открытой экосистеме часто встречаются практики и инструменты, такие как dbt для управления трансформациями и проверки качеств данных, и интеграционные паттерны с конвейерами на основе Airflow или аналогичных систем. Важно помнить о регуляторных требованиях: проверки доступа, аудита изменений и безопасной передачи данных в средах разработки, тестирования и продакшн.
- Ввод изменений в инфраструктуру данных должен быть связан с трассируемыми артефактами: схемы, конфигурации пайплайнов, параметры доступа и политики безопасности должны версионироваться и верифицироваться на стейджинге.
- В рамках архитектуры данных в процесс изменения включаются проверки контрактов: данные, которые формируют контракт между двумя сервисами, должны проходить автоматические проверки на совместимость.
- Оценку риска изменений следует проводить заранее: анализ влияния на downstream-потребителей, оценку потерь качества и вероятного влияния на бизнес-показатели.
Роли, ответственность и команда эксплуатации
Успех операционной эксплуатации невозможно достичь без ясной структуры ролей, ответственности и культуры совместной работы. В рамках сервис-менеджмента данных выделяются роли, которые обеспечивают координацию, качество и устойчивость сервисов на всех этапах жизненного цикла данных.
Ключевые роли включают:
- Data Operations Lead - руководит операционной стратегией, координирует работу сервисов, управляет планами изменений, согласует требования между бизнесом и ИТ;
- Data Platform Engineer - отвечает за архитектуру и устойчивость платформы, обеспечивает техническую целостность инфраструктуры данных, автоматизацию и мониторинг;
- Data Steward - владелец качества и согласованности данных, следит за соблюдением правил качества и нормативов;
- Incident Commander - руководит процессами инцидент-менеджмента в ходе критических инцидентов, обеспечивает своевременность решений и документирование;
- Data Architect и Solution Architect - формируют целевые архитектурные решения и контроль за соблюдением контрактов и интерфейсов;
- аналитики и потребители данных - предоставляют требования, тестируют новые сервисы и участвуют в фазах ревью.
Организационные принципы включают:
- внедрение модели RACI (Responsible, Accountable, Consulted, Informed) для ключевых сервисов;
- создание кросс-функциональных команд, работающих как единый поток: бизнес, аналитика, Data Ops, безопасность и юридика;
- формализация процессов обучений и управления знаниями, чтобы повысить квалификацию сотрудников и снизить зависимость от отдельных специалистов;
- развитие культуры непрерывного улучшения: регулярные ретроспективы, постинцидентные обзоры, план по внедрению улучшений.
Путь к устойчивой эксплуатации лежит через баланс между структурированностью и гибкостью. Необходимо обеспечить достаточную регламентированность процессов и ясность ответственности, в то же время сохранять скорость реагирования на новые бизнес-требования и изменения во внешних условиях. В отдельных организациях применяется сочетание практик: создание центров компетентности DataOps, распределение ролей в рамках инфраструктурных команд, внедрение автономии кросс-функциональных команд и поддержка общей культуры качества.
Эффективные практики обеспечения качества данных и устойчивости
Качество данных - это не одноразовая проверка, а системная характеристика, охватывающая точность, полноту, консистентность и своевременность. Эффективные практики эксплуатации включают автоматические проверки качества на разных стадиях пайплайна, мониторинг данных в контексте их потребителей и аккуратную, документированную регламентацию качественных требований.
Практические принципы:
- определение и применение контрактов качества данных, которые связывают поставщиков и потребителей, а также фиксируют ответственность за нарушение;
- автоматизированные проверки качества на стейджинге и в проде, в том числе валидации схем, ограничений и бизнес-правил;
- мониторинг линии данных и визуализация зависимостей: lineage помогает понять, как данные проходят через пайплайны и где может возникнуть расхождение;
- регулярные аудит и постинцидентные обзоры по качеству данных, экспертиза RCA и реализация корректирующих действий;
- обучение и поддержка культуры ответственности за качество и своевременное уведомление о нарушениях.
Устойчивость в эксплуатации достигается через продуманную архитектуру и управляемый жизненный цикл. Это включает в себя:
- продуманное управление версиями наборов данных и их схем;
- возможность отката к ранее стабильной версии данных и пайплайнов;
- стратегию минимизации риска изменений через использование песочниц и режимов постепенного внедрения;
- обеспечение безопасности данных, контроль доступа и аудирование операций.
В связке с практиками обеспечения качества применяются инструменты и методики, которые поддерживают требования к данным и их использование. В открытой экосистеме можно отметить:
- dbt для управления трансформациями и проверкой качества через тесты и документацию;
- системы мониторинга и управления пайплайнами, такие как Airflow, которые позволяют организовать задачи, зависимости и проверки на каждом шаге;
- централизованные конвейеры данных и платформы для наблюдаемости, которые позволяют видеть состояние сервисов, качество данных и влияние изменений.
Эти принципы помогают выстроить прозрачные и воспроизводимые процессы эксплуатации, где качество и доступность данных становятся частью сервиса, который может быть оценен и улучшен на основе данных и аналитики.
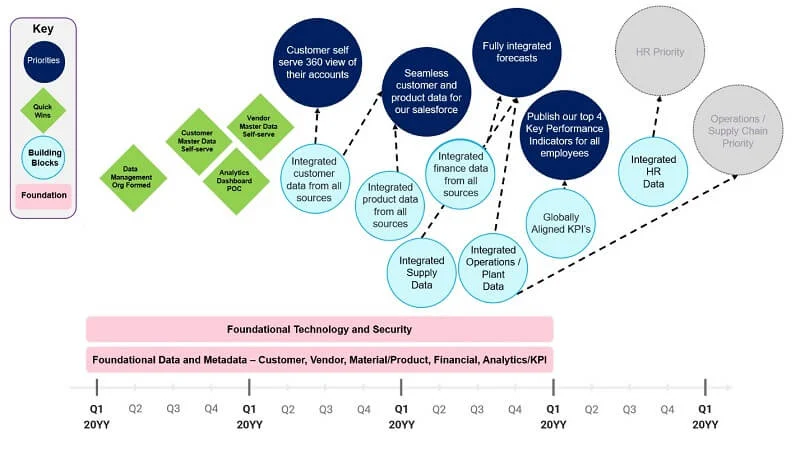
Целостная карта внедрения: как переходить к практике
Ниже приведены ориентиры по внедрению описанных практик в рамках дорожной карты реализации стратегии работы с данными:
- Определение сервисов данных и их владельцев. Создайте каталог сервисов и формализуйте контракты качества и требования к мониторингу.
- Внедрение SLA/SLO и KPI для каждого сервиса. Установите понятные пороги доступности, задержек и качества.
- Разработка и внедрение runbooks. Соберите типовые сценарии: инциденты, изменения, регуляторные требования, восстановление после сбоев.
- Введение процессов мониторинга и алертинга. Определите ключевые метрики на уровне пайплайнов и наборов данных, настройте алерты и панели мониторинга.
- Применение CI/CD для данных. Автоматизируйте сборку, тестирование и развёртывание пайплайнов, схем и контрактов, внедрите тестовые среды для безопасной проверки изменений.
- Обеспечение обученности и культуры сотрудничества. Развивайте роли и структуры, которые поддерживают обмен знаниями и совместное решение проблем.
- Постоянное совершенствование. Выполняйте регулярные ревизии процессов, изучайте уроки из инцидентов и внедряйте улучшения в релизный цикл.
В условиях ограниченных ресурсов разумно начать с нескольких критичных сервисов и постепенно расширять охват. Важно обеспечить приемлемый баланс между устойчивостью и скоростью изменений, чтобы бизнес мог быстро реагировать на новые требования без потери качества и контроля.
Key takeaways
- Операционная эксплуатация данных должна рассматриваться как сервисная функция: данные - это актив, требующий управления как сервисом с владельцами, контракторами и KPI.
- Каталог сервисов и контракты качества служат основанием для предсказуемости и согласованности между бизнесом и ИТ.
- Мониторинг и observability должны охватывать технические параметры и качество данных, а инцидент-менеджмент - полноту жизненного цикла от обнаружения до RCA.
- Управление изменениями требует формализации процессов, версий схем и контрактов, тестирования и отката, чтобы минимизировать риски для downstream-потребителей.
- Роли и культура эксплуатации критически важны: четкие ответственности, RACI-модели и взаимная поддержка между бизнесом, аналитикой и инженерией.
- Качество данных - системная ответственность, требующая автоматизированных проверок, lineage, регулярных ревизий и обучения сотрудников.
- Воспользуйтесь возможностями открытых инструментов и технологий, сохраняя фокус на контрактах, качества и целостности данных.
FAQ
1) Что такое операционная эксплуатация данных и зачем она нужна в стратегии работы с данными?
- Операционная эксплуатация данных - это набор практик, процессов и ролей, обеспечивающих стабильную, безопасную и предсказуемую работу наборов данных и пайплайнов. Она нужна для минимизации рисков, связанных с изменениями в данных, обеспечению согласованности между бизнес-тотребованиями и техническими решениями, а также для повышения скорости реагирования на изменяющиеся требования рынка.
2) Как связать данные как сервис с бизнес-целями?
- Необходимо определить контракты качества, SLA/SLO для каждого сервиса, и поддерживать каталог сервисов. Контракты должны быть понятными бизнес-пользователям, а владение сервисами - четко закреплено. Это обеспечивает прозрачность, ответственность и управляемость изменений.
3) Какие ключевые метрики стоит включать в мониторинг данных?
- Доступность пайплайнов, задержка данных, полнота и точность наборов данных, соответствие контрактам и требования к обновлениям, время реакции на инциденты и время восстановления. Также важны показатели влияния на downstream-потребителей и удовлетворение SLA.
4) Как организовать инцидент-менеджмент в контуре данных?
- Следует определить жизненный цикл инцидента: обнаружение, классификация, эскалация, устранение, восстановление и постинцидентный разбор. Важно иметь runbooks на типовые сценарии, automate alerting и RCA-процедуры, а также регистрировать уроки и корректирующие действия.
5) В чем разница между контрольными точками данных и контрольными контрактами?
- Контракты качества данных фиксируют ожидаемое поведение и ответственность, а контроли - конкретные правила и проверки на этапе пайплайна. Контракты связывают потребителей и поставщиков данных, а контроли (проверки) автоматически проверяют соблюдение контрактов.
6) Что такое CI/CD для данных и почему он важен?
- CI/CD для данных - это набор практик автоматизации сборки, тестирования и развёртывания пайплайнов, схем и контрактов в едином конвейере. Он повышает воспроизводимость, снижает риск регрессий и ускоряет вывод изменений в продакшн.
7) Какие роли критически важны внутри команды эксплуатации данных?
- Data Operations Lead, Data Platform Engineer, Data Steward, Incident Commander, Data Architect и представители бизнес-пользователей/аналитиков. Важно обеспечить ясность ответственности и возможность кросс-функционального сотрудничества.
8) Какие инструменты чаще всего применяются в операциях данных?
- Для потоков данных - Apache Kafka; для оркестрации пайплайнов - Apache Airflow; для мониторинга - Prometheus/Grafana; для управления качеством - dbt и сопутствующие тесты. Инструменты выбираются под контекст организации, учитывая требования к безопасности и регуляторике.
9) Как поддерживать культуру качества и совместной ответственности?
- Внедрять регулярные ревью, обучающие мероприятия, совместные постинцидентные разборы и четко прописанные роли и сценарии. В рамках RACI и операционных практик строить доверие между бизнесом, аналитикой и инженерией.
10) Какие шаги можно предпринять вначале для перехода к сервис-менеджменту данных?
- Начать с формирования каталога сервисов и контрактов качества для критичных пайплайнов, внедрить базовый мониторинг и SLA для ключевых сервисов, подготовить runbooks и реализовать пилотный CI/CD конвейер для одного или двух наиболее важных источников данных. Постепенно расширять охват и укреплять организационные процессы.


