

Интеграция источников: ETL/ELT, CDC, DataOps, качество интеграций
Интеграция источников данных в витрину требует продуманного архитектурного подхода, где балансируются требования к скорости загрузки, точности и управляемости. В составе курса рассматриваются современные паттерны для объединения разнообразных систем - от традиционных баз данных до потоковых источников и файловых хранилищ - с акцентом на стандарты витрин данных, качество данных и операционные практики DataOps.
Глубокое понимание интеграций необходимо для обеспечения единообразной картины данных, поддержания согласованности между источниками и витриной, а также для предоставления бизнес-аналитикам достоверной основы для принятия решений. В данной главе рассматриваются архитектурные решения, механизмы изменений данных, контроль качества и практики эксплуатации, которые позволяют снизить риск ошибок, ускорить внедрение новых источников и обеспечить устойчивость к эволюции схем.
-
Архитектурные паттерны интеграции источников и витрины данных: ETL/ELT, CDC, DataOps.
-
Управление качеством и контролем данных в процессе интеграций: метрики, валидаторы, тесты, мониторинг.
-
Организация процессов и инструментов: оркестрация, наблюдаемость, CI/CD для данных, управление изменениями схем.
-
Практические паттерны внедрения и минимизация рисков: планирование миграций, тестирование на данных, пошаговые переходы.
Краткое содержание главы
-
Архитектура интеграции источников и витрины: слои, коннекторы, трансформации, контроль качества.
-
Эволюция подходов: ETL против ELT, роль CDC и потоковых технологий в современных пайплайнах.
-
DataOps и управляемость: GitOps для данных, CLA/CI, тестирование данных, epoch-уровни наблюдаемости.
-
Практические паттерны и реализация: выбор инструментов, шаблоны архитектур, безопасные режимы внедрения.
-
Контроль качества на каждом этапе: валидаторы, тесты, метрики, обработка ошибок и устойчивость к сбоям.
Контекст и концепции интеграций данных
Интеграция источников данных в витрину - это процесс объединения разнородных источников в единое представление, пригодное для анализа и отчетности. В основе лежит обеспечение корректности и согласованности данных, а также способность быстро адаптироваться к изменениям источников - новым таблицам, колонкам, форматам и структурам бизнес-логики. В современных средах это означает сочетание пакетной обработки для больших исторических массивов и потоковой обработки для реального времени или near-real-time аналитики.
Архитектурные требования к интеграции включают:
-
консистентность данных в витрине, включая горизонтальную и вертикальную совместимость между источниками;
-
управляемость изменений схем и версий моделей данных;
-
масштабируемость обработки и способность обслуживать пиковые нагрузки;
-
наблюдаемость и возможность оперативного реагирования на инциденты.
Что такое интеграция источников и витрина данных
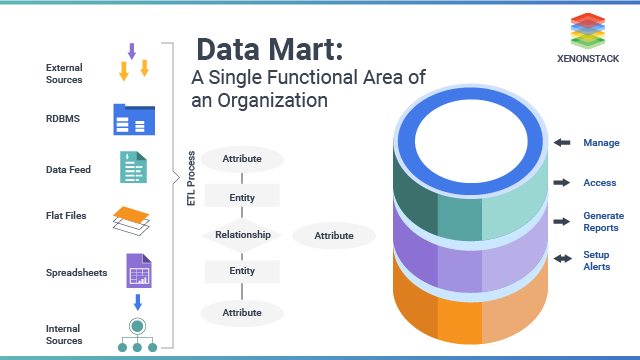
Интеграция источников - комплекс действий по извлечению, преобразованию и загрузке данных из разных систем в целевую витрину. Витрина данных служит единым источником истины для бизнес-аналитики: бизнес-объекты, факты и справочные данные представлены в едином формате и согласованной схеме. В идеале витрина обладает семантикой, согласованной с бизнес-терминами и требованиями регламентов по качеству.
Преимущество такой архитектуры состоит в возможности стандартизировать правила обработки, централизовать логику трансформаций и обеспечить единообразие в доступе к данным. Но для достижения этого необходимы решения по управлению изменениями, мониторингу и качеству, чтобы корректно обрабатывать обновления из разных систем и поддерживать согласованность на протяжении жизненного цикла данных.
Архитектурные принципы и целевые характеристики
Ключевые принципы включают: детерминированность и идемпотентность загрузок, поддержка схемной эволюции, минимизация задержек между источниками и витриной, а также прозрачность цепочек данных для аудита. Архитектура должна быть гибкой: возможность добавления новых источников без разрушения существующей логики загрузки, а также адаптация к различным моделям данных - реляционным, полуструктурированным и полуструктурированным данным.
Важно помнить о балансировки между ETL (extract-transform-load) и ELT (extract-load-transform). В традиционных ETL-подходах бизнес-логика трансформаций выполняется на ETL-сервере до загрузки в витрину, что обеспечивает чистый и согласованный набор данных, но может требовать мощной инфраструктуры на этапе загрузки. В ELT-технологиях данные сначала загружаются в целевую систему, где уже выполняются трансформации, что ускоряет цикл загрузки, но требует сильной поддержки вычислительных мощностей целевой платформы и строгого контроля версий схем.
Эволюция архитектур: от ETL к ELT, потребность CDC и DataOps
Традиционные ETL-практики были ориентированы на централизованные конвейеры с жесткой схемой обработки на ETL-сервере. Такой подход хорошо характеризовал сценарии с предсказуемыми источниками и стабильной схемой, однако сталкивался с задержками и сложностями масштабирования. Появление больших данных, облачных платформ и потоковой обработки привело к переходу к ELT-архитектурам, где основная трансформация переносится в целевую витрину или платформу обработки данных, такую как дата-лейер в облаке или параллельные вычисления в Spark/Databricks.
Change Data Capture (CDC) стал ответом на необходимость минимизировать задержку между изменениями в источниках и их отражением в витрине. CDC позволяет извлекать только изменения, а не полные копии таблиц, что существенно уменьшает нагрузку на сеть и обработку. В сочетании с DataOps подходами CDC становится центральным элементом для обеспечения консистентной и своевременной доставки данных.
DataOps - это набор практик, ориентированных на скорость поставки качественных данных, управление версиями схем, автоматизацию тестирования и мониторинга, а также культуру совместной ответственности между командами разработки данных, аналитики и бизнес-пользователей. В рамках интеграций DataOps требует внедрения инфраструктурных паттернов, аналогичных DevOps: постоянная интеграция и поставка (CI/CD) для пайплайнов данных, контроль версий для скриптов трансформаций и конфигураций коннекторов, а также полноценно настроенная наблюдаемость.
Архитектура интеграций данных: слои, коннекторы и трансформации
Архитектура интеграций источников строится вокруг нескольких слоев: источники данных, коннекторы и конвейеры, слой трансформаций, витрина и слой потребления данных. Правильная комбинация паттернов позволяет достигнуть минимальной задержки, высокого качества данных и упрощенной операционной поддержки.
Архитектурные паттерны ETL и ELT
-
ETL как традиционный паттерн с обязательной обработкой данных до загрузки в витрину. Преимущества - точный контроль над качеством на этапе загрузки, возможность вынести сложные вычисления в отдельные шаги преобразований и использование согласованных схем. Недостатки - потенциальная задержка и зависимость от мощности ETL-узла.
-
ELT как современный паттерн, когда источник загружается напрямую в витрину или в промежуточный слой, а преобразования выполняются «на месте» в целевой системе. Преимущества - ускоренная загрузка и использование вычислительных возможностей целевой среды; недостатки - повышенная ответственность за качество трансформаций внутри витрины и риск непредсказуемых зависимостей в бизнес-логике трансформаций.
Выбор паттерна зависит от характеристик источников, требований к задержке, доступной инфраструктуры и готовности к управлению сложной трансформационной логикой внутри витрины. В реальных условиях часто применяют гибридные подходы: часть данных загружают по ELT, а часть - через более контролируемый ETL-процесс, особенно для критичных бизнес-правил и регламентируемых наборов.
CDC и потоковая интеграция: выбор подхода
CDC реализуется через чтение журналов изменений (log-based) или через триггеры и снимки состояния. Log-based CDC обеспечивает минимальную задержку и минимальную нагрузку на источники, но требует поддержки журнала изменений на стороне СУБД и дополнительной инфраструктуры для обработки изменений (соц. коннекторов, брокеры потоков). В потоковых конвейерах CDC изменения превращаются в события, которые проходят через обработку, нормализацию и агрегацию перед загрузкой в витрину.
Управление временем и порядком изменений критично: изменения несвоевременного применения могут привести к рассогласованию бизнес-процессов и неверной аналитике. Важно проектировать подход с учетом идемпотентности загрузок, обработки дубликатов и корректной маршрутизации событий по шаблонам бизнес-логики.
В рамках практик CDC следует учитывать факторы:
-
детерминированность и повторяемость изменений: каждое изменение должно приводиться к единому идентификатору записи и корректной обработке повторов.
-
обработку ошибок и повторные попытки: гарантия повторной загрузки без дублирования.
-
согласование временных меток и порядков обработки изменений между источниками.
Change Data Capture (CDC): механика, гарантии и примеры
CDC вводит концепцию извлечения только изменившихся данных, что позволяет существенно сократить объем передаваемой информации и ускорить обновление витрины. Реализация CDC может основываться на журнале изменений базы данных, на событиях, создаваемых приложением, или на комбинации подходов.
Механика log-based и чтение журналов изменений
-
В режиме log-based CDC используются журналы изменений СУБД (transaction log, redo log). Коннектор следит за событиями в журнале, формирует поток изменений и публикует их в брокер сообщений или прямо в витрину.
-
В режиме trigger-based CDC применяются триггеры на таблицах для фиксации изменений. Такой подход обеспечивает совместимость с системами без доступны журналов изменений, но может создавать дополнительную нагрузку и сложность поддержки.
-
В гибридном подходе используются промежуточные буферы и периодические снимки, чтобы снизить влияние на производительность источников и повысить устойчивость к задержкам.
Гарантии консистентности и идемпотентности
-
Идемпотентность загрузок - повторные применения одинаковых изменений не приводят к дублированию данных. Это достигается через уникальные ключи и контрольные суммирования стадий.
-
Exactly-once delivery - идеальная гарантия, когда каждое изменение приходит в витрину ровно один раз. Реализация требует точной координации между источником, коннектором и потребителем и может требовать сложной логики смарт-идентификаторов и ретривалпов.
-
Dead-letter и ретрансляция - часть дизайна обработки изменений включает механизм обработки ошибок, перемещения некорректных изменений в отдельную очередь и повторную попытку их обработки.
Примеры паттернов интеграции CDC
-
Подключение к базам данных через Debezium или аналогичные коннекторы, публикующие события в Kafka или другой брокер сообщений, далее - в витрину через слой трансформаций.
-
Реализация CDC поверх облачных дата-платформ с использованием нативных коннекторов: потоковая обработка через Databricks или Snowflake Streams и Tasks.
-
Интеграция через событийно-ориентированные архитектуры: события изменений в источнике приводят к обновлению материалов витрины через подписки на события и последующую трансформацию.
DataOps и управление качеством в интеграциях
DataOps направлен на ускорение поставок данных через автоматизацию, контроль версий, тестирование и мониторинг. Когда речь идет об интеграциях, DataOps обеспечивает согласованность между командами аналитики, инженерами данных и бизнес-пользователями, устраняя узкие места в процессе поставки и упрощая аудит изменений.
DataOps процессы: версии схем, репликация изменений и GitOps для данных
-
Версионирование схем и трансформаций - хранение всех изменений в системе контроля версий, где каждая миграция, SQL-скрипт или конфигурационный файл имеют историю и откаты.
-
GitOps для данных - автоматизация развёртывания пайплайнов через инфраструктуру как код, где любое изменение пайплайна проходит через pull-реквесты, тесты и автоматическую развёртку в окружениях.
-
Контроль качества на уровне пайплайна - что-то, что может быть встроено в CI/CD: статические проверки конфигураций, анализ зависимостей, проверка совместимости схем, тесты на данные и верификация результатов.
Observability и мониторинг качества
-
Метрики пайплайна: задержка, Throughput, вероятность пропуска изменений, доля дублирующихся записей, доля ошибок.
-
Наблюдаемость на уровне данных: lineage (происхождение и путь данных), provenance (история изменений), quality gates (пороги качества и сравнение с эталонами).
-
Алерты и управление инцидентами: автоматическое уведомление команд об отклонениях от ожидаемых параметров, сценарии устранения неполадок и документы по восстановлениям.
Практические паттерны и инфраструктура
Эффективная интеграция источников требует сочетания паттернов и инструментов, которые обеспечивают баланс между скоростью загрузки, точностью и операционной управляемостью. Ниже рассмотрены ключевые направления и их роль в современных пайплайнах.
-
Инструментарий и роль коннекторов: Debezium для CDC, Apache NiFi и подобные инструменты для маршрутизации и трансформаций, Apache Airflow или альтернативы для оркестрации, Great Expectations для качественного контроля, dbt для моделей и тестирования трансформаций.
-
Архитектурные шаблоны: пакетная обработка для исторических массивов и потоковая обработка для обновлений в реальном времени; гибридные решения, сочетающие оба подхода в зависимости от критичности данных и задержки.
-
Безопасность и соответствие: шифрование in transit and at rest, контроль доступа на уровне данных, аудит изменений, соответствие регуляторным требованиям.
Инструменты и их роль в паттернах
-
Debezium и другие CDC-коннекторы позволяют извлекать изменения из источников без полной перезагрузки данных, минимизируя задержку и нагрузку на источники.
-
Apache NiFi/StreamSets для маршрутизации данных, маршрутизации по конвейерам и простых трансформаций.
-
Apache Airflow или Dagster для оркестрации задач ETL/ELT, управления зависимостями и повторных запусков.
-
Great Expectations и аналогичные инструменты для проверки соответствия данных правилам качества, валидатор для столбцов, проверки диапазонов, уникальности и прочего.
-
dbt для управления моделями витрины и тестирования трансформаций в виде декларативных тестов.
Примеры конфигураций и реализаций
Пример 1: настройки CDC-коннектора Debezium (упрощенно)
{
  "name": "inventory-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql MySqlConnector",
    "tasks.max": "1",
    "database.hostname": "db01",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "dbz",
    "database.include.list": "inventory",
    "table.include.list": "inventory.products",
    "database.server.id": "184054",
    "database.server.name": "dbserver1",
    "database.history.kafka.bootstrap.servers": "kafka:9092",
    "database.history.kafka.topic": "dbhistory.inventory"
  }
}
Пример 2: минимальный DAG Airflow для иллюстрации ETL-пайплайна
from airflow import DAG
from airflow.operators.python_operator import PythonOperator
from datetime import datetime

def extract():
    pass  # извлечение данных из источников

def transform():
    pass  # трансформации и обогащение

def load():
    pass  # загрузка в витрину

with DAG('etl_pipeline', start_date=datetime(2024,1,1), schedule_interval='@daily') as dag:
    t1 = PythonOperator(task_id='extract', python_callable=extract)
    t2 = PythonOperator(task_id='transform', python_callable=transform)
    t3 = PythonOperator(task_id='load', python_callable=load)

    t1 >> t2 >> t3
Пример 3: YAML-конфигурация Great Expectations для базовой проверки качества
expectation_suite:
  meta:
    version: 1.0
  expectations:
  - **expectation_type**: expect_column_values_to_not_be_null
    kwargs:
      column: order_id
  - **expectation_type**: expect_column_values_to_be_unique
    kwargs:
      column: order_id
Эти примеры иллюстрируют, как на практике реализуются паттерны CDC, оркестрации и контроля качества. Однако архитектура должна быть адаптирована под конкретные источники, требования к SLA, регуляторные и отраслевые особенности. В реальном проекте важнее всего построить повторяемую, проверяемую и безопасную цепочку поставки данных, где каждый элемент - от источника до витрины - имеет явную ответственность, тестовую безопасность и мониторинг.
Реализация по шагам и внедрение
-
Оценка источников и требований витрины: определить критичные источники, частоту обновления, требования к задержке и регуляторные ограничения.
-
Выбор архитектурного паттерна: определить, какие источники лучше обслуживать через ETL, ELT или CDC; учесть потенциал для гибридной реализации.
-
Проектирование схем и версий: определить общие схемы витрины, правила эволюции, версионирование моделей и миграций.
-
Внедрение DataOps-подходов: настройка GitOps-процессов для пайплайнов, автоматизация тестирования и проверки данных на каждом этапе.
-
Настройка мониторинга и наблюдаемости: определение ключевых метрик, создание дашбордов, настройка алертинга.
-
Рефакторинг и миграции: поэтапная миграция источников на CDC или ELT-подходы, с минимизацией влияния на бизнес-процессы.
-
Тестирование качества данных: разработка и поддержка тест-кейсов, использование наборов эталонных данных для регрессионного тестирования.
-
Обеспечение безопасности и соответствия: внедрение контроля доступа, аудит и шифрование.
-
Обучение команд: распространение лучших практик, документирование стандартов и процессов, совместное участие аналитиков и инженеров данных.
-
Постоянное совершенствование: регулярный аудит архитектуры, обновление паттернов под новые источники, требования бизнеса и технологические тенденции.
Key takeaways
-
Эффективная интеграция источников в витрину требует сбалансированного сочетания паттернов ETL/ELT и CDC, адаптированного под требования задержки, объема и доступности.
-
CDC позволяет существенно снизить нагрузку на источники и ускорить отражение изменений, но требует продуманной архитектуры для обеспечения идемпотентности и Exactly-Once delivery.
-
DataOps превращает пайплайны данных в управляемый продукт: версия схем, GitOps, CI/CD для данных и автоматизированное тестирование поднимают качество и скорость поставки.
-
Наблюдаемость и качество данных должны быть встроены в пайплайн на всех уровнях - от источников до витрины - через lineage, мониторинг, валидаторы и контрольные тесты.
-
Выбор инструментов должен основываться на конкретной предметной области, требованиях к SLA и организационной культуре; примеры открытых проектов (Debezium, Airflow, Great Expectations, dbt) могут служить опорой, но не должны становиться догмой.
-
Архитектурная гибкость и четкие процессы управления изменениями являются критическими факторами устойчивости и масштабируемости витрины данных.
-
Внедрение паттернов DataOps требует культурных изменений: совместная ответственность между командами, прозрачность изменений, документирование и постоянная проверка результатов.
-
Для минимизации рисков миграции на CDC и ELT важно планировать поэтапное внедрение, проводить тестирование на данных и организовывать переходные режимы без потери бизнес-ценности.
-
Пример архитектуры с CDC, потоковой обработкой и контрольными тестами демонстрирует путь к устойчивой витрине, где каждое изменение может быть подтверждено и воспроизведено.
-
Безопасность данных и соответствие требованиям должны быть встроены в концепцию интеграций с самого начала, а не добавлены постфактум.
FAQ
- Что такое CDC и чем он отличается от ETL/ELT?
CDC (Change Data Capture) фиксирует и распространяет только изменения данных, произошедшие в источнике, в то время как ETL/ELT загружает данные целиком или по мере загрузки в витрину. CDC уменьшает объем передаваемой информации и задержку обновлений, но требует сложной инфраструктуры для обработки событий и обеспечения согласованности транзакций. ETL/ELT, наоборот, обеспечивает строгий контроль трансформаций и целостности на конкретном этапе загрузки, что полезно для регламентируемых бизнес-правил, но может вести к более длинным циклмам поставки.
- Какие данные стоит считать критичными для витрины и какие источники требуют приоритета?
Критичными считаются таблицы и объекты, которые непосредственно влияют на управленческие решения и бизнес-процессы: факты продаж, данные клиентов, справочники и ключевые атрибуты операционных систем. Источники с быстрым темпом изменений или требованием реального времени - например, CRM, ERP, мобильные приложения, IoT-устройства - требуют особого внимания к задержке и надежности обновлений, часто через CDC или потоковую обработку.
- Как выбрать между ETL и ELT для конкретной витрины?
Выбор зависит от: доступной вычислительной мощности, требований к задержке, сложности бизнес-логики трансформаций и зрелости инфраструктуры. ETL оправдан, когда нужен жесткий контроль качества до загрузки и когда витрина не обладает достаточной мощностью для сложных трансформаций. ELT предпочтителен при большом объеме данных, необходимости быстро загружать данные и использовании мощности целевой платформы для трансформаций.
- Какие меры обеспечивают идемпотентность загрузок?
Ключевые техники: использование уникальных идентификаторов изменений, хранение контрольных сумм и версий записей, детерминированная идентификация дубликатов, хранение персистентных маркеров выполненных загрузок, повторная обработка с детальной логикой отмены дубликатов. В CDC это особенно важно, так как повторная передача того же события может привести к дублированию данных.
- Какие методологии и практики DataOps наиболее применимы в контексте витрины?
Ключевые практики: версионирование схем и трансформаций, инфраструктура как код (IaC) для пайплайнов, непрерывная интеграция и поставка данных (CI/CD), автоматизированное тестирование данных, наблюдаемость и линейность данных (data lineage). Визия DataOps - это обеспечение уверенной поставки качественных данных в бизнес-пользователям и аналитикам.
- Какие риски сопровождают миграцию на CDC и как их минимизировать?
Риски включают задержки на стороне источников, сложные конфигурации и риск некорректной обработки ошибок. Минимизация достигается через поэтапную миграцию, тщательное тестирование на копиях данных, реализацию идемпотентной загрузки, создание тестовых сценариев с синтетическими данными и детальное документирование процессов.
- Как обеспечить мониторинг и алертинг для интеграций?
Необходимо определить критические метрики: задержку, пропуск изменений, долю ошибок, величину задержки между источником и витриной, долю дубликатов. Включите дашборды lineage, детекторы аномалий, алерты по SLA и автоматизацию ретраев. Важно, чтобы мониторинг был доступен как инженерам данных, так и бизнес-пользователям для аудита и понимания динамики загрузок.
- Какие архитектурные паттерны лучше всего подходят для гибридной загрузки?
Комбинации: частичная загрузка через CDC для реального времени и пакетная ELT для исторических данных. Такой подход позволяет поддерживать актуальные показатели и глубину аналитики без чрезмерного воздействия на источники и витрину.
- Какие примеры открытых решений стоит рассмотреть для старта?
Debezium для CDC и Kafka как брокер событий, Apache Airflow или Dagster для оркестрации, Great Expectations для контроля качества, dbt для моделирования витрины. Эти решения широко известны, имеют активное сообщество и хорошо документированы, что ускоряет внедрение и обучение команд.
- Как выбрать стратегию внедрения паттернов интеграций в рамках крупной организации?
Необходимо начать с целей бизнеса и уровня зрелости инфраструктуры. Построение минимально жизнеспособного набора пайплайнов с ясной ответственностью, версионированием и тестированием, затем расширение функциональности, добавление источников, внедрение CDC и расширение DataOps-практик. Важна последовательная коммуникация между командами, документирование, прозрачность и поэтапная миграция без прерываний бизнес-подразделений.
Глава завершает обзор стратегий и практик, которые позволяют строить и поддерживать качественные витрины данных в условиях роста источников и требований бизнеса. Внедрение паттернов ETL/ELT, CDC и DataOps должно рассматриваться как непрерывный процесс улучшения, а не одноразовый проект.


