

Grafana для observability и мониторинга
Grafana помогает объединить мониторинг инфраструктуры, приложений, микросервисов и data-платформ в единую observability-систему. Такой подход нужен не только инженерам эксплуатации, но и бизнесу: команды быстрее видят деградации сервисов, понимают причины инцидентов и могут управлять доступностью через SLI, SLO, SLA и burn rate.
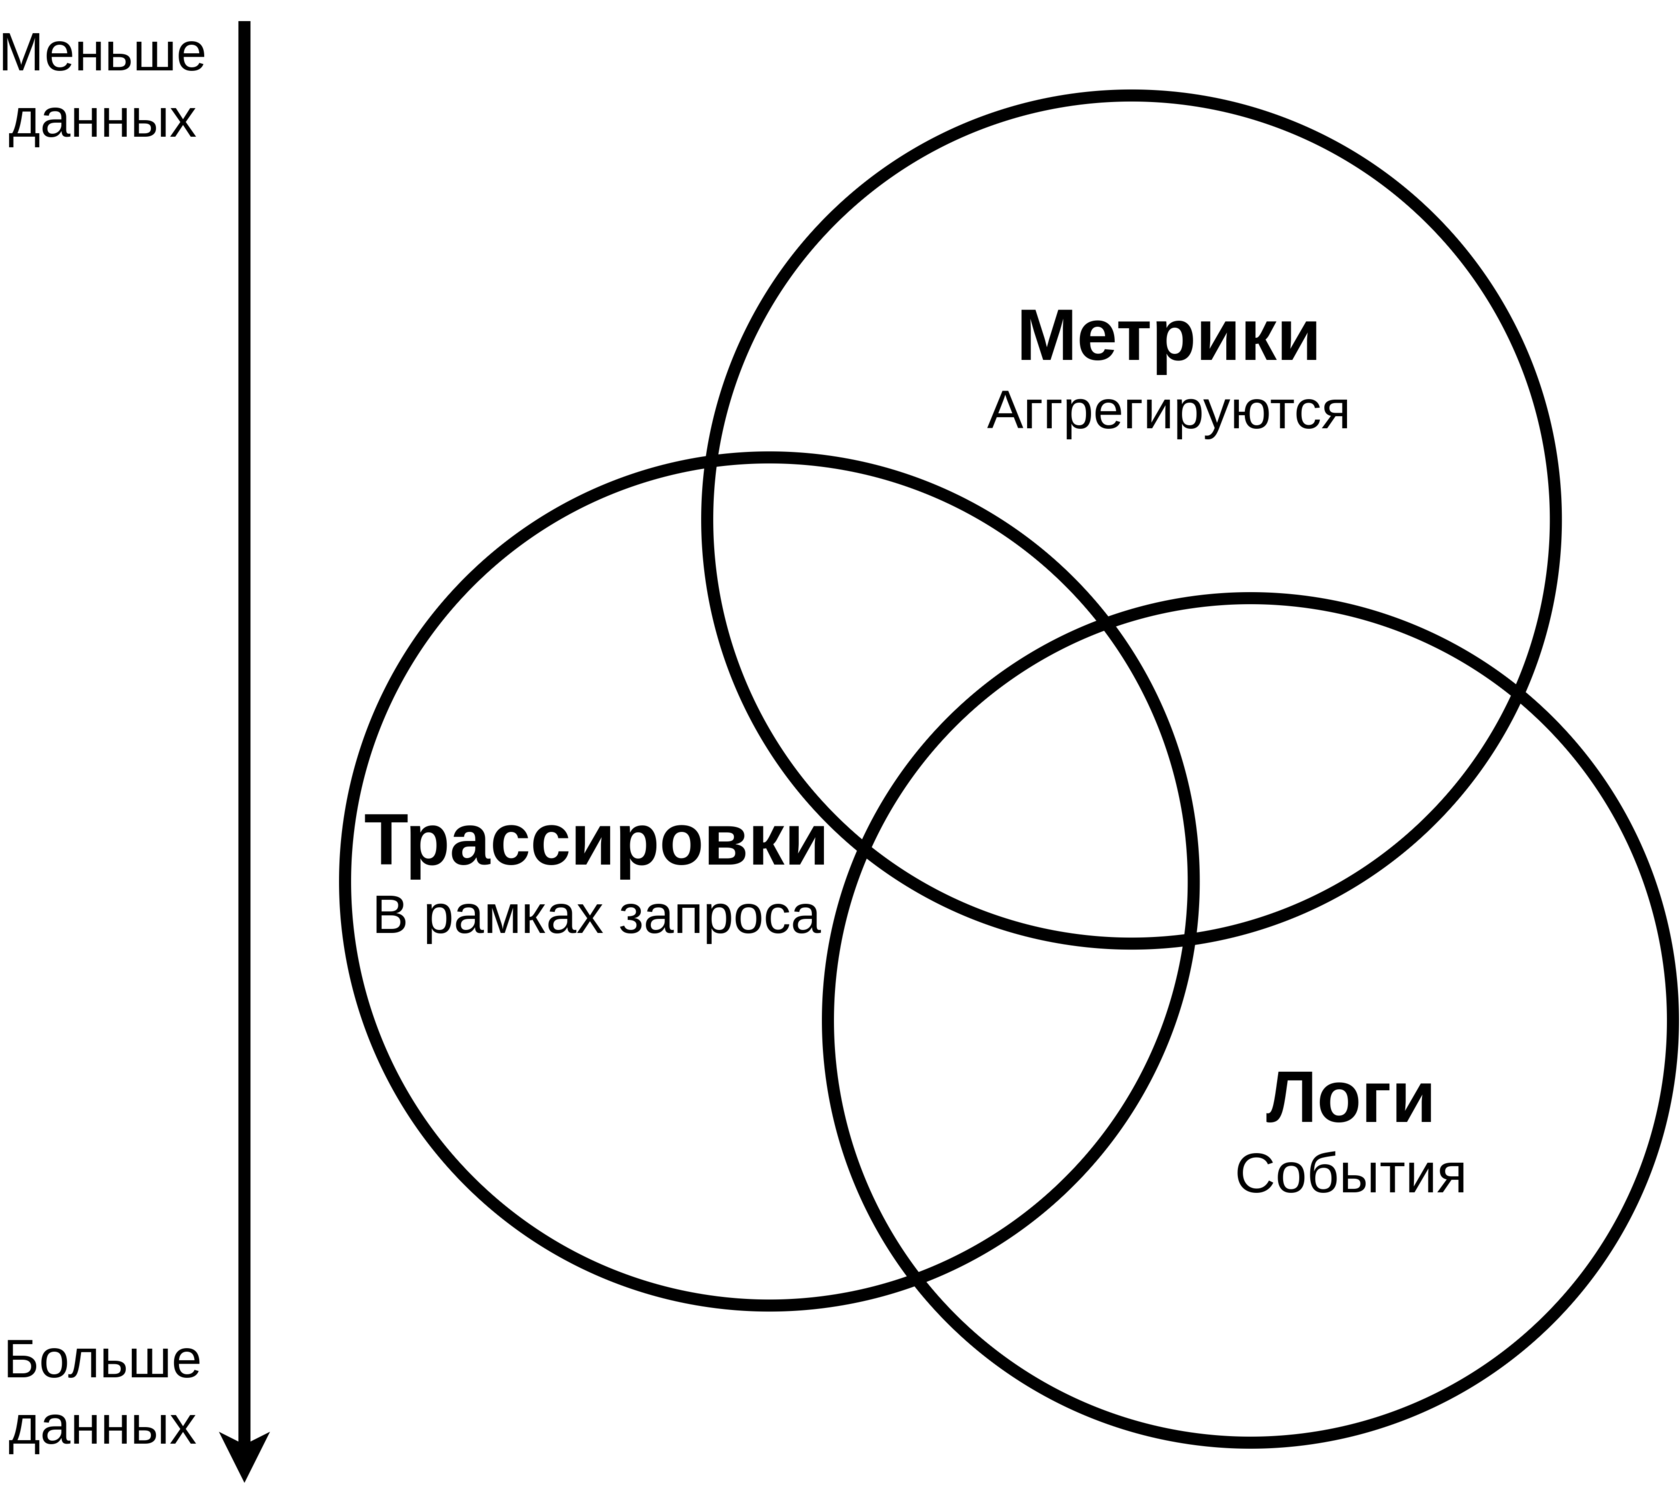
Описание охватывает работу Grafana в связке с Prometheus, Loki и Tempo: сбор и визуализацию метрик, анализ логов, распределённые трассировки, настройку алертов и построение дашбордов для Kubernetes, микросервисной архитектуры и платформ данных. Большое внимание уделяется корреляции метрик, логов и traces, чтобы Grafana использовалась не как набор графиков, а как рабочий инструмент для расследования проблем.
Материал подойдёт командам, которые хотят выстроить зрелый мониторинг: с понятной архитектурой, управлением конфигурациями, runbooks, эскалациями, контролем шума в алертах и дорожной картой развития observability.
- Основы observability: цели, принципы и опорные показатели
- Терминология observability: SLI, SLO, SLA, burn rate и контекст данных
- Архитектура Grafana: компоненты, роли и принципы развёртывания
- Контекст применения: мониторинг инфраструктуры, микросервисов и data-платформ
- Обзор стека Prometheus, Loki, Tempo и Grafana: принципы интеграции
- Архитектурные паттерны масштабируемого мониторинга: федеративность, хранение и доступ
- Метрики, логи и трасировки: модель данных и корреляция
- Методы сбора и агрегации: instrumentation, exporters и client libraries
- Логи в Grafana и Loki: архитектура, индексация и поиск
- Трассировки в Grafana Tempo: distributed tracing, OpenTelemetry и хранение
- Единая консоль observability: дизайн портала и консоли для множества источников
- Интеграция Grafana с Prometheus: data source, PromQL, recording rules и alerting
- Интеграция Grafana с Loki: LogQL, структурированные логи и поиск контекста
- Интеграция Grafana с Tempo: трассировки, выборка и визуализация
- Архитектура визуализации: дашборды, переменные и трансформации данных
- Аллерты и уведомления: правила, маршрутизация и эскалация
- Методы расчета SLO: формулы, доверительные интервалы и кросс-системные зависимости
- Метрики инфраструктуры и Kubernetes: ноды, поды, кластеры, метрики Kubernetes
- Мониторинг микросервисов: зависимости и maps service graphs
- Мониторинг data-платформ: пайплайны данных, качество и lineage
- Безопасность и доступ: RBAC, secrets и приватность данных
- Развертывание Grafana: self-hosted, Grafana Cloud и требования инфраструктуры
- Инфраструктура как код для мониторинга: Helm, Terraform и GitOps
- Архитектура алертинга: стратегии уведомлений и эскалаций
- Масштабирование Grafana: multi-tenant, кэширование и прокси данных
- Управление конфигурацией и версиями дашбордов: репозитории и контроль изменений
- Эксплуатация и поддержка: инцидент-менеджмент, runbooks и операционная практика
- Практические кейсы: электронная коммерция и финансы
- Практические кейсы: дата-платформа и аналитика данных
- Риски, ограничения и типичные ошибки: производительность, конфиденциальность и шум
- Развитие и зрелость observability: maturity model и governance
- План внедрения observability: фазы, дорожная карта, чек-листы


