

Логи в Grafana и Loki: архитектура, индексация и поиск
Современная платформа наблюдаемости опирается на единый подход к обработке логов: их сбор, хранение, поиск и визуализация. В контексте Grafana как визуального слоя Loki выступает как специализированный инструмент для работы с логами: от архитектурной схемы до тонких настроек индексации и эффективного поиска. В этой главе рассмотрены ключевые принципы архитектуры Loki, принципы индексации логов, механизмы поиска через LogQL и практические аспекты интеграции с Grafana. Особое внимание уделяется тому, как конфигурация влияет на масштабируемость, задержки и точность возвращаемых результатов, а также как на основе логов формировать метрики SLA/SLO и оперативные алерты.
Краткое содержание главы
- Архитектура Loki в стекe Grafana: роли компонентов, взаимодействия и точки расширения.
- Архитектура индексации и хранение логов: как формируются потоки, какие данные индексируются и как хранятся сегменты.
- Поиск и запросы в LogQL: как строятся фильтры по меткам, по содержимому и как сочетать поиск с агрегациями.
- Интеграция Grafana с Loki: сценарии визуализации, алерты и создание лог-метрик для SLO/SLA.
- Практические сценарии конфигурации: шаги развёртывания, параметры для масштабирования и способы мониторинга эффективности.
- Производительность, безопасность и операционные аспекты: кэширование, параллелизм запросов, управление доступом и хранением данных.
Архитектура Loki и роль Grafana
Loki представляет собой цепочку компонентов, каждый из которых выполняет конкретную роль в обработке потоков логов. Основные элементы: Distributor, Ingesters, Querier, а также сервисы хранения индекса и чанков. В современном развертывании часто применяется схема с индекс-гейтвеем и «boltdb-shipper» для долговременного индексирования. В Grafana Loki присутствие Grafana как визуального слоя, который выполняет задачи запроса, фильтрации по меткам и отображения в виде панелей, дашбордов и алертов.
- Distributor принимает логи от агентов (Promtail, Fluent Bit и др.) и распределяет нагрузку между Ingester. По сути, Distributor обеспечивает горизонтальную масштабируемость и балансировку.
- Ingester хранит активные чанки логов в памяти и синхронизирует их в долговременное хранилище (object storage или файловую систему). Это обеспечивает устойчивость к сбоям и эффективную запись.
- Чанки содержат сами логи, разбитые по времени и по потокам. Они лежат в распределенном хранилище и читаются по запросу.
- Индекс и индекс-гейтвей (в современных реализациях Loki) хранятся отдельно. Индекс не содержит содержимого логов, а хранит метаданные потоков (лейблы) и указатели на чанки, что позволяет существенно ускорить поиск по времени и по меткам без просмотра полного содержимого.
- Querier - компонент, который оборачивает логи путем обращения к индексу и чанкам, объединяя результаты и возвращая их пользователю или панели Grafana.
- Рулер и хранение правил алертинга (управляется чаще через Loki или интегрированные части стека) обеспечивают реализацию политик на основе логов.
- Взаимодействие с Grafana позволяет строить визуализации и алерты на основе результатов LogQL-запросов, а также использовать общие аутентификационные и авторизационные механизмы.
Почему архитектура Loki выбрана так, а не как у классических систем с полнотекстовым индексом? Главная мотивация - эффективная масштабируемость на больших объёмах логов. Поисковая нагрузка в логах трудно предсказуема и может приводить к затратам на индексацию на уровне содержания текста. В Loki же индексация ограничена метками (label-based indexing), что снижает операционные затраты и упрощает горизонтальное масштабирование. При этом поиск по содержимому выполняется уже как фильтр по чанкам, что компенсируется эффективной структурой хранения и параллелизмом чтения.
Дополнительные аспекты архитектуры, которые важно учитывать:
- Тенантность и сегментация: в многопользовательских окружениях Loki поддерживает разделение по tenants через метаданные на уровне лейблов и изоляцию ресурсами.
- Публичные API и безопасность: аутентификация и авторизация на уровне Grafana и Loki, поддержка TLS и ограничение доступа к индексам.
- Расширяемость: возможность добавления внешних источников логов, расширения через плагины и интеграции с Kubernetes, systemd и другими источниками.
Взаимодействие с Prometheus и Tempo
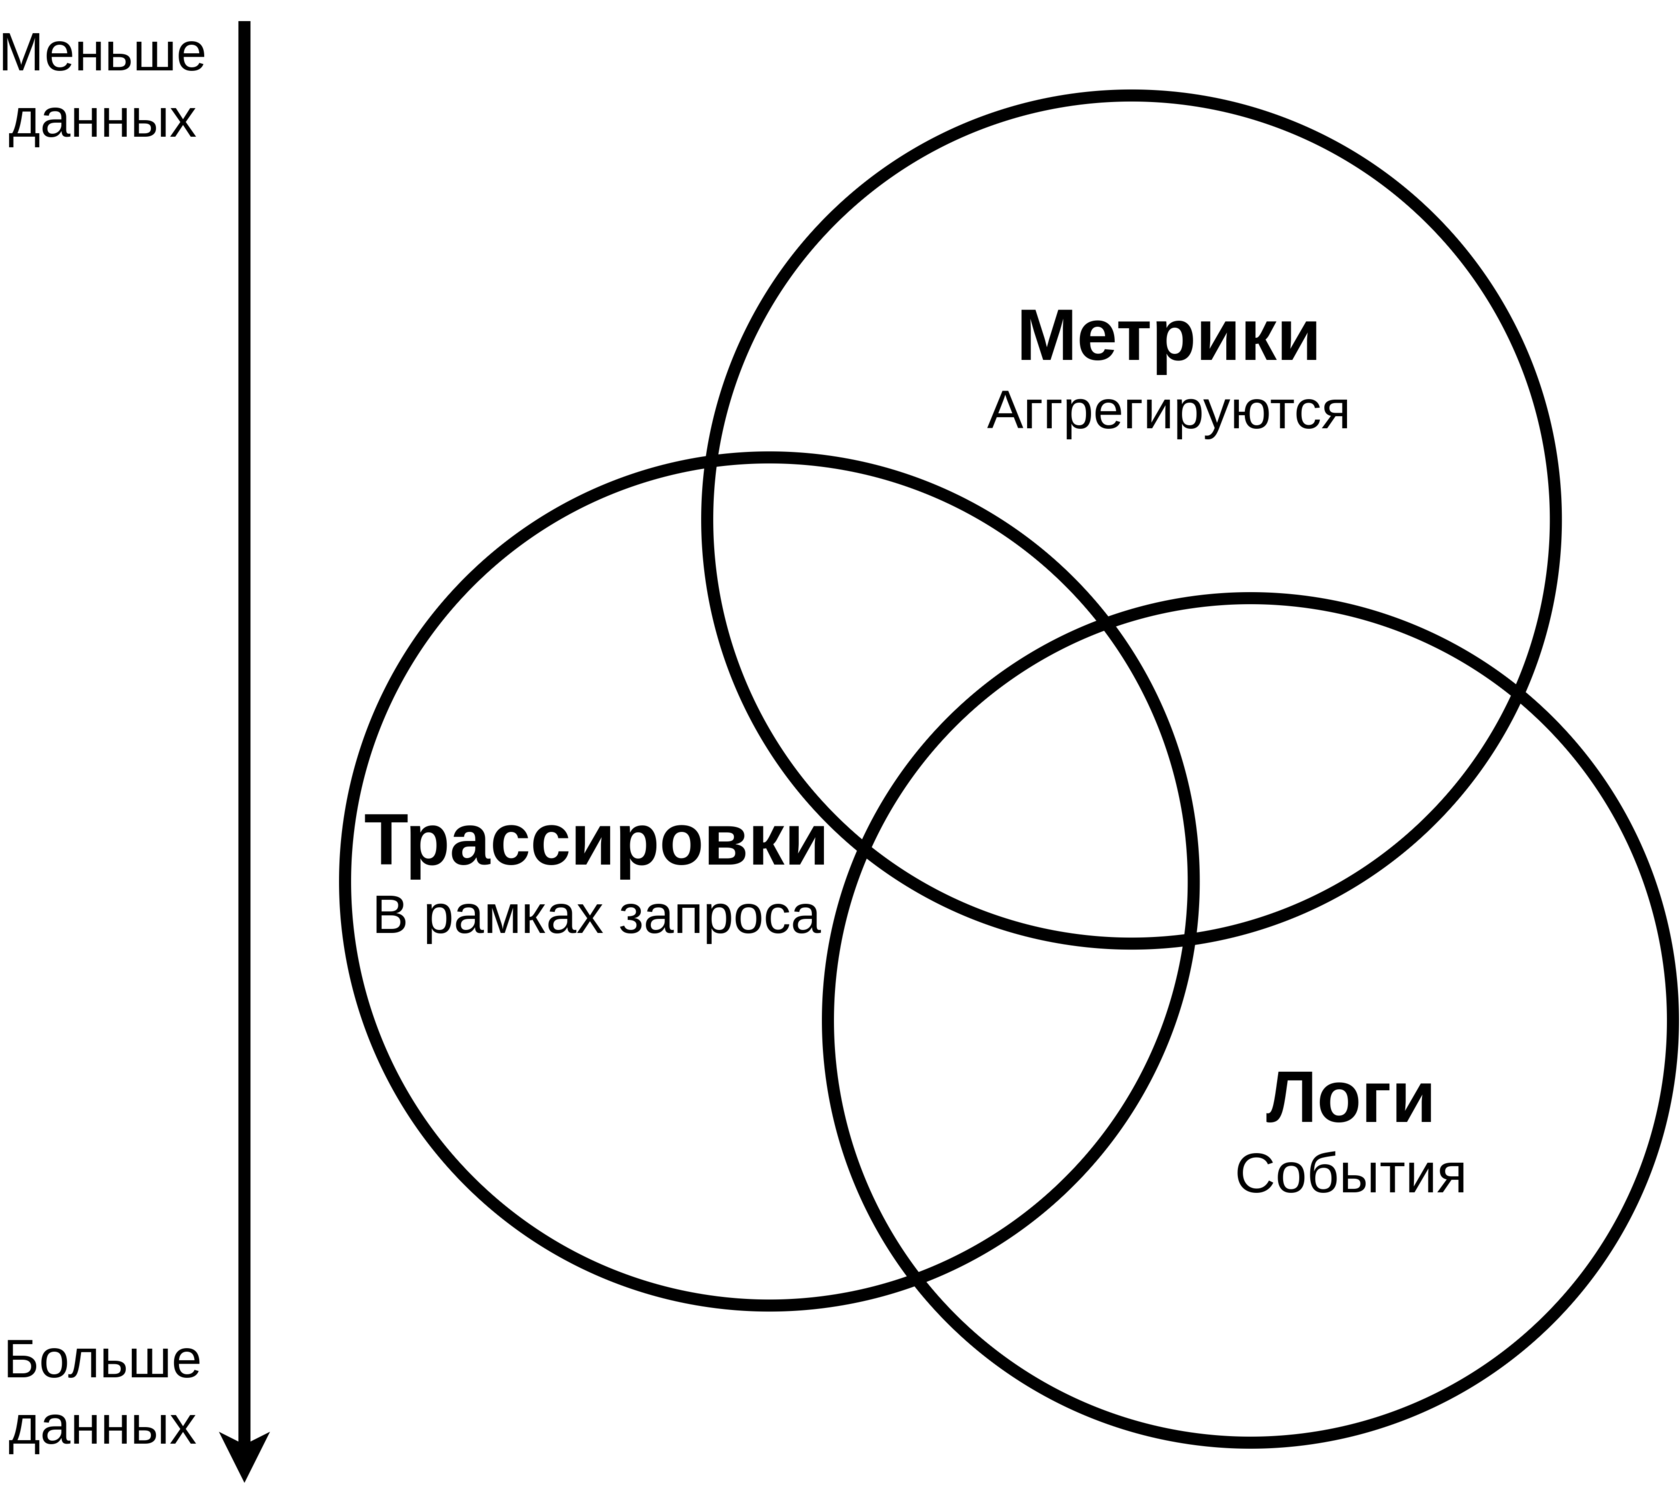
Хотя фокус главы - логи, стоит помнить, что Grafana-платформа обеспечивает единый подход к наблюдаемости: метрики через Prometheus, логи через Loki и трассировки через Tempo. Взаимодействие между этими компонентами обеспечивает correlated search и совместное использование дашбордов. В частности, можно строить кросс-сегментные панели: по метрике Prometheus сопоставить видимую проблему в логе и трассировку через Tempo, чтобы быстро локализовать инцидент.
## Пример минимального запроса LogQL (для иллюстрации возможности поиска)
{job="varlogs"} |~ "timeout|failed" | 10m
Индексация и хранение логов
Индексация логов в Loki устроена иначе, чем в полнотекстовых системах. Основной принцип - индексировать только метаданные потоков (лейблы), а содержимое логов хранить в чанках. Это позволяет быстро отфильтровать subsets логов по меткам и времени, после чего прочитать соответствующие чанки и применить фильтры по содержимому.
- Streams и лейблы: каждый уникальный набор лейблов формирует поток (stream). Потоки группируются по набору ключ-значение меток, например {job="kubelet", container="nginx"}.
- Индекс потоков: индекс хранит соответствие между лейблами и идентификаторами чанков, где этот поток представлен. Поиск начинается с индекса - для поиска по меткам и времени.
- Хранение чанков: сами логи хранятся в чанках, размещённых в объектном хранилище (S3, GCS, локальная файловая система) или альтернативных хранилищах в зависимости от конфигурации. Чанки сопоставляются с индексными записями и читаются при формировании результатов запроса.
- Роль boltdb-shipper: для больших развёртываний используется индексация на основе boltdb-shipper. Этот подход размещает индексы в объектном хранилище и позволяет откатывать и переносить индексы без переконфигурации кластерной памяти. Он обеспечивает устойчивость и возможности переноса индексов между узлами кластера.
Алгоритм работы поиска:
- запрос LogQL формирует фильтр по лейблам и временной рамке.
- Querier обращается к индексу, чтобы получить набор чанков, соответствующих искомым потокам и диапазону времени.
- Loki читает соответствующие чанки из хранилища, применяет фильтр по содержимому (если задан), и возвращает результаты.
- Grafana агрегирует и визуализирует полученные данные, позволяя пользователю анализировать логи в контексте дашбордов и панелей.
Опционные аспекты:
- Кэширование запросов: Frequently accessed ranges и популярные запросы могут кешироваться на уровне Querier или прокси. Это существенно сокращает задержки при повторных запросах.
- Тонкая настройка хранения: выбор между файловой системой и объектным хранением, временные периоды индексов и их периодических обновлений. В крупных инфраструктурах используются политики retention и period-based indexing для балансировки скорости и затрат.
- Balancing по времени: в Loki индексы привязаны к периоду времени. Это позволяет быстро откатываться к конкретным диапазонам времени и уменьшать размер индексов, но требует аккуратной синхронизации с хранением чанков.
- Гибкость в плане лейблов: свойство Loki** - ограничение на индексируемые лейблы, что стимулирует дизайн меток. Неправильно выбранные метки могут привести к чрезмерному количеству потоков и усложнить поиск.
Поиск и фильтрация по содержимому
Хотя основная часть индексации ориентирована на метки, поиск по содержимому логов реализуется на стадии чтения чанков. LogQL поддерживает операции:
- текстовый поиск по строке (contains),
- регэксп-совпадение (regex),
- фильтр по содержимому и по уровню, если это закодировано в строках лога.
Улучшение точности поиска достигается сочетанием лейблов и содержимого: сначала фильтр по меткам и временному диапазону, затем фильтрация содержимого в чанках. Это критически важно для производительности, так как без индекса по лейблам пришлось бы сканировать огромные объемы данных.
Поиск и запросы в LogQL
LogQL поддерживает выражения для фильтрации, агрегации и трансформаций логов. В основной линии поиска ключевые возможности включают:
- выбор по лейблам: {job="api-server", namespace="prod"}** - сужает набор потоков до конкретной подмножества;
- фильтр по содержимому: |= "error", |=~ "timeout|failed" - фильтры по содержимому строк;
- временная агрегация: [5m]** - окрестности времени для агрегаций и анализа трендов;
- сочетание с операторами функций: count_over_time, rate, avg_by, sum by - для формирования метрик на основе логов.
Примеры LogQL для иллюстрации возможностей:
-
Поиск ошибок в конкретном потоке за последние 30 минут:
{job="api-server", namespace="prod"} |= "ERROR" | 30m -
Регулярное выражение по содержимому помимо простого совпадения:
{container="nginx"} |~ "timeout|connection refused" | 1h -
Агрегация количества ошибок по лейблу pod за сутки:
count_over_time({pod!=""} |~ "ERROR" [24h])Диапазонный поиск требует грамотной настройки времени. В Grafana следует устанавливать корректные временные диапазоны на панели, чтобы запросы LogQL не перегружали воркеры и не возвращали избыточные данные.
Интеграция Grafana с Loki: дашборды и алерты
Grafana выступает интерфейсом визуализации для логов, предоставляя пользователю возможность строить панели, дашборды и алерты на основе запросов LogQL. В контексте логов это выгодно, поскольку можно прямым образом связывать логи с метриками и трассировками.
- Данные из Loki подаются через источник данных Grafana Loki. Панели могут базироваться на любых комбинациях запросов, обеспечивая:
- фильтрацию по лейблам и времени;
- отображение последних записей и событий;
- агрегирования по потокам и метрикам, основанных на содержимом логов.
- Алерты по логам: Grafana поддерживает алерты на основе логических запросов. Можно определить условия, при которых запрос LogQL возвращает пороговые значения (например, более чем N ошибок за X минут). Алерты работают с уведомлениями через Alertmanager, Slack, Email и пр.
- SLA/SLO и лог-метрики: можно строить панели, демонстрирующие уровень доступности по логам, скорость обработки ошибок, частоту ошибок по сервисам, времени отклика, задержкам и другим аспектам. Для этого лог-данные можно агрегировать и превращать в показатели типа SLI/SLO.
Сценарий развёртывания может выглядеть следующим образом:
- Развернуть Loki и Promtail в целевом окружении (Kubernetes, виртуальная инфраструктура, облако).
- Подключить Grafana как внешний источник данных и настроить доступ к Loki через API.
- Создать панели с использованием LogQL-запросов, ориентированных на бизнес-цели: например, «процент ошибок по сервису за 24 часа» или «количество ошибок по контейнеру».
- Настроить алерты на основе порогов по логам и связать их с уведомлениями.
- Реализовать процессы поддержки: ретеншн логов, очистку старых данных, мониторинг работы Loki и Promtail.
Ниже приведены примеры типовых сценариев запросов в Grafana, которые можно реализовать на основе Loki:
-
панель ошибок по сервису:
{job="order-service"} |= "ERROR" | count_over_time([24h]) -
панель времени отклика на базе текстовых сообщений:
{service="payment"} |~ "timeout|failed" | unwrap _time | sum by (service) (rate(_time[5m]))Примеры конфигураций для интеграции и сбора логов:
-
Promtail - агент сбора логов:
server: http_listen_port: 9080 positions: filename: /tmp/positions.yaml clients: - url: http://loki:3100/loki/api/v1/push scrape_configs: - **job_name**: varlogs static_configs: - **targets**: [ localhost ] labels: job: varlogs __path__: /var/log/**/*.log -
Loki - минимальная конфигурация (ключевые элементы):
auth_enabled: false

server:
  http_listen_port: 3100

ingester:
  lifecycler:
    address: 127.0.0.1
    ring:
      kvstore:
        store: inmemory
      replication_factor: 1

schema_config:
  configs:
  - **from**: 2020-10-24
    store: boltdb-shipper
    object_store: filesystem
    index:
      prefix: index_
      period: 168h

storage_config:
  boltdb_shipper:
    active_index_directory: /var/loki/index
    cache_location: /var/loki/cache
    shared_store: filesystem
  filesystem:
    directory: /var/loki/chunks
Эти примеры демонстрируют базовую интеграцию и не претендуют на полноту конфигурации в рамках реального кластера. В реальном окружении потребуется настройка безопасности, снапшоты, мониторинг состояния и интеграция с системой аутентификации.
Практические сценарии конфигурации
Эффективная реализация лог-состава требует последовательного подхода к архитектуре и эксплуатации. Ниже приводится конструкторский план, который можно адаптировать под конкретную среду.
- Определить цели и требования к логам
- какие сервисы и горизонты времени должны покрываться;
- какие метки и поля будут индексироваться;
- требования к задержке и объему данных.
- Выбрать архитектуру хранения и индекса
- хранение чанков: объектное хранение vs. локальная файловая система;
- индекс: использование boltdb-shipper или другого подхода в зависимости от масштаба;
- настройка retention и периодичности индекса для баланса между задержкой и стоимостью.
- Установить и настроить Promtail (или аналоги)
- конфигурация источников логов;
- добавление нумерации и маркировки лейблами для ускорения поиска;
- управление объемами и скоростью отправки.
- Конфигурация Grafana
- создание источника Loki;
- проектирование панелей и дашбордов с использованием LogQL;
- настройка алертинга на основе логов.
- Мониторинг производительности и масштабирование
- сбор и анализ медицинских метрик Loki: задержки, пропускная способность, количество чанков;
- настройка горизонтального масштабирования (scale-out) для Distributor и Querier;
- резервирование индекса и данных.
- Безопасность и соответствие
- аутентификация и авторизация на уровне Loki и Grafana;
- шифрование в пути и доступ к хранению;
- аудит доступа к данным и хранению логов.
- Управление жизненным циклом данных
- политики ретеншина и архивирования;
- автоматизированные процедуры очистки;
- мониторинг состояния и обнаружение проблем на ранних стадиях.
Производительность и операционные аспекты
Производительность поиска зависит от таких факторов, как выбор меток, объём индекса, размер чанков и распределение нагрузки между командами. Чтобы обеспечить требуемую производительность:
- ограничивайте число уникальных лейблов: слишком много уникальных потоков приводит к перегрузке индекса и чтения чанков.
- применяйте агрегации на уровне LogQL, а не на клиентской стороне Grafana, чтобы минимизировать объем передаваемых данных.
- на больших кластерах используйте горизонтальное масштабирование и распределение запросов между Querier и Query Frontend.
- применяйте кэширование запроса на уровне Grafana или в Querier, чтобы повторные запросы обходились без повторной загрузки чанков.
Безопасность и доступ к данным - ключевые факторы в операционной среде. В крупных окружениях целесообразна реализация ролей и ограничение доступа по проектам/тенантам, а также внедрение политики ретеншина и аудита доступа к данным и журналам контроля.
Key takeaways
- Loki реализует архитектуру, ориентированную на метки и чанки, что обеспечивает масштабируемость и удобство эксплуатации в больших инфраструктурах.
- Индекс хранится отдельно и фокусируется на метках потоков, что позволяет быстро сузить поиск по времени и лейблам без полного сканирования содержимого логов.
- Поиск в LogQL строится на сочетании фильтра по лейблам, фильтра по содержимому и агрегациях, что дает гибкость для аналитики и мониторинга.
- Интеграция Grafana с Loki обеспечивает мощные дашборды и алерты на основе логов, а также позволяет коррелировать логи с метриками и трассировками.
- Реализация и конфигурация должны учитывать требования к росту объема, задержке и бюджету на хранение, а также политики безопасности и соответствия.
- Практический подход к развёртыванию включает последовательную стратегию: от инфраструктуры сбора логов до настройки дашбордов и алертов, с учётом масштабирования и управления данными.
- Эффективность работы логи в Grafana и Loki зависит от грамотного проектирования лейблов, внимательного выбора политики индексации и разумной архитектуры хранения данных.
FAQ
- Что такое Loki и чем он отличается от традиционных систем полнотекстового индексирования логов?
Loki ориентирован на индексирование меток потоков (лейблов), а не содержания каждого символа лога. Это делает систему более масштабируемой и экономичной для больших объемов логов. Содержимое логов хранится в чанках и читается только в рамках поиска, применяя фильтры по содержимому на этапе чтения. Такой подход позволяет эффективно обрабатывать огромные потоки логов с высокой скоростью.
- Как работает индексация в Loki и какой она имеет смысл?
Индексация в Loki фокусируется на метках потоков. Индекс хранит связь между лейблами и идентификаторами чанков. Это позволяет быстро определить набор чанков, которые содержат логи для конкретного потока в заданном временном диапазоне. Индекс может храниться локально или в объектном хранилище через boltdb-shipper, что обеспечивает долговременное хранение и масштабируемость.
- В чем особенность boltdb-shipper и когда его использовать?
boltdb-shipper - решение для долговременного индексирования, которое хранит индексы в объектном хранилище и предоставляет эффективный доступ к индексу в больших кластерах. Использование shipper позволяет горизонтально масштабировать Loki и уменьшает нагрузку на локальные диски. Это особенно важно в многоузловых кластерах и при большом объёме логов.
- Как строить эффективные запросы в LogQL?
Эффективность запросов достигается сочетанием фильтра по лейблам и диапазону времени, а затем фильтрацией по содержимому на стадии чтения чанков, если требуется. Рекомендовано избегать чрезмерного использования сложных регулярных выражений на больших диапазонах, применять агрегации и использовать конкретные метки для минимизации объема данных, которые нужно просмотреть.
- Какие типы алертов можно строить на основе логов в Grafana?
Можно строить алерты на основе LogQL-запросов, включая пороги по количеству ошибок, задержкам и специфическим строкам в логе. Алерты интегрируются с Alertmanager и могут отправлять уведомления в Slack, PagerDuty, Email и другие каналы. Лог-алерты особенно полезны для быстрого обнаружения критических событий и деградации сервисов.
- Как интегрировать Loki с Tempo и Prometheus в рамках единого дашборда?
Prometheus предоставляет метрики, Tempo - трассировки, Loki - логи. Grafana позволяет создать кросс-дейшборды, которые демонстрируют взаимосвязь между метриками, трассировками и логами. Это позволяет проводить глубинный анализ инцидентов: например, зафиксировать событие по логу, найти соответствующую трасировку и проверить параметры метрик.
- Какие практические риски при масштабировании Loki и как их управлять?
Риски включают перегрузку индекса из-за большого числа уникальных лейблов, задержки при крупных запросах и высокий расход хранения. Управлять ими можно через ограничение числа уникальных лейблов, мониторинг задержек и пропускной способности, выбор подходящей политики ретеншина и масштабирование компонентов (Distributor, Querier, Index Gateway) горизонтально. Важно также обеспечить резервирование индексов и данных и настроить безопасную стратегию восстановления.
- Какие лучшие практики конфигурации Promtail для эффективной индексации?
Лучшие практики включают корректную выборку лог-файлов с помощью шаблонов путей, добавление осмысленных лейблов (job, namespace, pod и т. п.), избегание слишком большого количества необычных лейблов, хранение позиций и контроль за задержкой отправки. Важно также обеспечить согласованность лейблов между Promtail и Loki, чтобы поиск по меткам был предсказуемым.
- Какие примеры критериев SLO/SLA можно реализовать на основе логов?
Логи позволяют измерять долю успешных операций, частоту ошибок, время обработки запроса, долю сбоев по сервисам и время до обнаружения проблемы. Применяя LogQL-агрегации и панельные визуализации, можно строить SLI/SLO по доступности, задержкам и качеству сервиса, что является важной частью контракта с пользователями.
- Как организовать безопасный доступ к логам в рамках мульти-арендной среды?
Необходимо реализовать строгий контроль доступа, ограничение поTenant-identity, а также настройку ролей и политик на уровне Grafana и Loki. Рекомендуется использовать внешнюю аутентификацию, TLS для защиты данных в пути, аудит действий и разделение данных по арендаторам через метки. Важно, чтобы политики доступа не допускали утечек между арендаторами и поддерживали возможность централизованного мониторинга доступа к данным логов.


