

Конфигурация кластера Trino: развёртывание, масштабирование, HA
Trino — распределённый SQL-движок, который обеспечивает единый интерфейс к множеству источников данных. В этой главе рассматриваются проектные решения и практики развёртывания, масштабирования и обеспечения высокой доступности кластера Trino. Ориентир — практическая реализация в условиях реальных корпоративных установок: от локального дата-центра до облачных сред с гибким масштабированием и требованиями к управляемости. Особое внимание уделено архитектурным решениям, протоколам взаимодействия между компонентами, интеграции источников данных и механизмам обеспечения отказоустойчивости и безопасности.
В процессе рассматриваются принципы проектирования кластера, выбор инфраструктурной модели, конфигурационные параметры и практики непрерывной доставки изменений. Для полноты картины приведены примеры конфигураций и минимальные образцы кода, где они необходимы для понимания реализации, а не ради демонстрации синтаксиса.
- Архитектура кластера Trino: роли, компоненты и взаимодействие
- Развёртывание и инфраструктура: подходы, CI/CD, конфигурационные файлы
- Масштабирование, балансировка нагрузки и ресурсное планирование
- Обеспечение отказоустойчивости и мониторинг
- Интеграции, безопасность и управление доступом
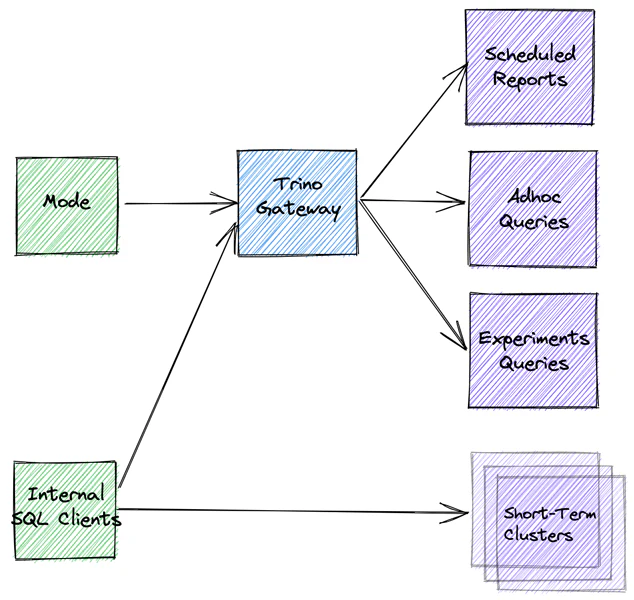
Архитектура кластера Trino: роли, компоненты и взаимодействие
Trino строится вокруг четко разделённых ролей: координатор (или несколько координаторов в режиме HA за счёт балансировщика), воркеры, каталоги данных (через коннекторы) и служба обнаружения (Discovery Service). В этой части раскрываются принципы взаимодействия между компонентами, принципы планирования запросов и роль каждой детали в общем процессе выполнения.
Ключевые концепции:
- Координатор выполняет роль планировщика и координирует выполнение запросов. Он получает запрос, распознаёт доступные коннекторы и каталоги, формирует план выполнения и распределяет задачи между воркерами. В режиме HA может существовать несколько координаторов, однако реальная обработка запросов координируется через балансировщик или механизм выбора активного коордантора.
- Воркеры выполняют вычислительную работу: чтение данных из источников через коннекторы, обработку фильтров, агрегацию и передачу промежуточных результатов между узлами через механизм обмена данными.
- Catalogs и коннекторы (Hive, Iceberg, Delta Lake, JDBC и пр.) соединяют Trino с конкретными системами хранения и метаданными, обеспечивая доступ к данным и кэширование информации о схемах и таблицах.
- Discovery Service упрощает обнаружение узлов, хранение сведений о сервисах и версионирование конфигураций. Он облегчает интеграцию большого числа рабочих узлов и упрощает конфигурацию клиента.
- Протокол взаимодействия: клиентские запросы идут к координационному узлу по протоколу Trino (HTTP/HTTPS). Координатор планирует выполнение и отправляет задания воркерам, которые обмениваются данными через внутренний RPC-поток и сетевые каналы. Весь этот процесс нацеливает систему на высокую пропускную способность и параллелизм выполнения.
- Безопасность и связь: TLS для клиента и между компонентами, а также механизмы аутентификации (LDAP, Kerberos, SSO) и авторизации на уровне ролей. В крупных средах важна интеграция с корпоративной системой управления идентификацией и аудит.
Архитектура клиренса с точки зрения производительности должна учитывать баланс между планированием и исполнением. Традиционная схема: один координатор принимает запрос, затем планирует его оптимальный путь через воркеры. Эффективность зависит от качества выборки данных на уровне коннекторов, от наличия фильтров на уровне источника данных (predicate pushdown) и от правила распределения задач между воркерами. Вопросы архитектуры включают:
- Какое количество воркеров оптимально для заданной нагрузки и объёма данных
- Как распределить каталоги и коннекторы между узлами для уменьшения contention и повышения доступности
- Как выбрать режим HA: активный/пассивный координатор или монолитный координатор с несколькими репликами behind балансировщика
- Как минимизировать задержки планирования и выполнения за счёт конфигурационных параметров JVM и сетевых настроек
# Пример: общая идея разделения ролей (псевдокод конфигурации) # coordinator.properties coordinator=true node.environment=production node.id=coordinator-01 discovery-server.enabled=true discovery.uri=http://coordinator-01:8080worker.properties
coordinator=false node.environment=production node.id=worker-01 discovery.uri=http://coordinator-01:8080
Важная деталь реализации — корректная настройка конфигурационных файлов и секретов. В среде с большим числом источников данных необходимо обеспечить репликацию метаданных и согласование схем через совместимые каталоги. В этой связи роль Hive Metastore и аналогичных систем становится критической: они предоставляют единый источник истины по метаданным, который координирует планирование и фильтрацию данных на уровне источников и партий.
Обеспечение совместимости протоколов и безопасной связи между компонентами требует использования TLS для клиентских соединений и между узлами. В корпоративной среде дополнительно применяются Kerberos или LDAP для аутентификации и управления доступом. В контексте HA критично наличие согласованного discovery-слоя, чтобы каждый активный координатор и воркер корректно регистрировался и получал обновления о состоянии кластера.
-
# Пример: конфигурация безопасного канала и discovery (координатор)
config.properties
http-server.http.port=8080
http-server.authentication.type= Kerberos
coordinator=true
node.environment=production
discovery-server.enabled=true
discovery.uri=http://coordinator-01:8080
-
# Пример: конфигурация воркера
config.properties
http-server.http.port=8080
coordinator=false
node.environment=production
discovery.uri=http://coordinator-01:8080
Безопасность и мониторинг должны рассматриваться как неотъемлемая часть архитектуры. Рекомендуется внедрить централизованный сбор метрик (Prometheus/Grafana), трассировку запросов и алертинг на основе пороговых значений задержки планирования, времени исполнения и частоты ошибок выполнения.
Развёртывание и инфраструктура: подходы, CI/CD, конфигурационные файлы
Развертывание кластера Trino может осуществляться в разных контекстах: на физических серверах, в виртуализированной среде, в контейнерах или на кластерах Kubernetes. Выбор подхода зависит от инфраструктурной стратегии, требований к управляемости, скорости обновлений и стоимости владения. Важнейший принцип — инфраструктура как код: вся конфигурация кластера должна быть воспроизводимой, версионируемой и тестируемой.
Ключевые подходы:
- Bare metal или виртуальные машины: удобство полного контроля над ОС, конфигурациями JVM и сетевыми параметрами. Требуется ручная координация сервисов и обновлений.
- Контейнеризация: упрощает развёртывание, управление зависимостями и масштабирование. Чаще всего применяют Docker-образы и orchestrator (Kubernetes). В большом объёме данных контейнеризация позволяет быстро обновлять версии и гибко масштабировать узлы.
- Kubernetes: наиболее распространённый сценарий для современных дата-центров. Используют Helm-чарты или операторный подход: создание StatefulSet для координатора и воркеров, сервисов для балансировки, ConfigMap/Secret для конфигураций и сертификатов. В Kubernetes упрощается автоматическое масштабирование (HPA), мониторинг и откат версий.
- CI/CD и IaC: инфраструктура должна разворачиваться через конвейеры, где каждая версия кластера сопровождается тестами на функциональность, совместимость коннекторов и регресси. Часто применяют Terraform/Ansible для инфраструктурной части и Helm для развёртывания приложений в Kubernetes.
Развёртывание в Kubernetes как наиболее управляемый и масштабируемый сценарий можно рассмотреть через последовательность шагов:
- Определение ролей: один или несколько координаторов, набор воркеров, discovery-сервис, сервисы для доступности координации.
- Конфигурационные артефакты: trino.properties, jvm.config, config.properties, catalog/коннекторы. Все они хранятся как ConfigMap/Secret и монтируются в поды.
- Секреты и доступ: хранение учетных данных к источникам данных, TLS-сертификаты, ключи шифрования и параметры авторизации в Kubernetes Secrets.
- Мониторинг и логирование: экспорт метрик через Prometheus, централизованный сбор логов (EFK/ELK), дашборды Grafana.
# Пример: простая конфигурация coordinator в Kubernetes
# Не полный YAML, иллюстративный фрагмент
config:
  trino:
    coordinator: true
    discovery-server.enabled: true
    discovery.uri: http://coordinator:8080
    node.environment: production
    http-server.https.enabled: true
    http-server.https.port: 8443
    http-server.authentication.type: LDAP
# Пример: простая конфигурация worker
config:
  trino:
    coordinator: false
    discovery.uri: http://coordinator:8080
    node.environment: production
    http-server.https.enabled: true
    http-server.https.port: 8443
# Пример: каталоги hive на кластере (каталог Hive Metastore)
catalog/hive.properties
connector.name=hive
hive.metastore-uri=thrift://metastore:9083
hive.metastore.catalog.archive.enabled=false
Развертывание в продакшн-среде требует планирования обновлений без остановок. Подход blue/green или canary обновлений в Kubernetes позволяет минимизироватьdowntime, сохраняя рабочий кластер в рабочем режиме во время миграций. Важно обеспечить обратную совместимость конфигураций коннекторов и версий клиента: дополнительные параметры могут потребовать адаптации во время обновления. В качестве рабочего кейса следует заранее определить критерии успешности обновления, тесты совместимости и план возврата к предыдущей версии.
Масштабирование, балансировка нагрузки и ресурсное планирование
С ростом объёма данных и числа одновременных запросов растёт потребность в горизонтальном масштабировании и грамотном распределении ресурсов между узлами. Масштабирование Trino происходит по двум направлениям: горизонтальная добавка воркеров и горизонтальное распределение нагрузки между координацией и воркерами. Вертикальное масштабирование (увеличение ресурсов существующих узлов) остаётся полезным для узких мест, где узлы загружены искусственно в рамках конкретной задачи.
Рекомендованные практики:
- Группировка узлов: координационные узлы отдельно, воркеры — по ролям и нагрузке. При больших кластерах полезно внедрять Discovery Service и балансировщик перед координациями.
- Ресурсы воркеров: разумное соотношение CPU, памяти и I/O. В среднем для крупной среды подбирают 8–32 ядра и 64–256 ГБ RAM на воркера в зависимости от объёма данных и сложности запросов.
- Память и лимиты запросов: настройка параметров query.max-memory, query.max-memory-per-node и memory-limit per-operator помогает избежать перегрузок и OOM-ошибок. Важно задавать разумные ограничители, чтобы один тяжёлый запрос не блокировал другие.
- Планирование задач: параллелизм выполнения и распределение данных по узлам влияет на задержку. Включение фильтрации на источниках данных (predicate pushdown) и динамическое фильтрование может значительно снизить объем передаваемых данных и ускорить выполнение.
- Балансировка нагрузки на уровне сети: использование высокоскоростной сети, минимизация латентности между координацией и воркерами. Виртуализация и размещение узлов в разных зонах доступности помогают устойчивости, но требуют разумной конфигурации сетевых профилей.
Ключевые параметры для настройки масштабирования:
- query.max-memory
- query.max-memory-per-node
- distributed-planner-enabled (включение оптимизаций планирования)
- optimizer/enable-cost-based-optimizer (если доступно в версии)
- http-client.max-total-connections и аналогичные параметры сетевого стека
# Пример: memory-ограничения для воркеров config.properties query.max-memory=50GB query.max-memory-per-node=6GB query.max-total-memory-per-node=8GBПример: включение распределённого планировщика
config.properties distributed-planner-enabled=true optimizer.enable-cost-based-optimizer=true
Мониторинг на уровне кластера обязателен. В идеале должна быть связка Prometheus + Grafana с:
- дашбордами по загрузке воркеров и координатора
- метриками времени планирования, задержки выполнения и распределения задач
- трекингом ошибок соединения с источниками данных и с Hive Metastore
- алертингом по пороговым значениям CPU, памяти и задержкам
Общие принципы балансировки:
- Не перегружать отдельных воркеров — используйте разумный порог по памяти и CPU
- Обеспечьте равномерное распределение задач и данных через выбранные коннекторы
- Планируйте обновления и перераспределение нагрузки между узлами в ночное окно или через canary-процедуры
Обеспечение отказоустойчивости и мониторинг
Высокая доступность кластера требует сочетания архитектурных решений, процедур операционной деятельности и инструментов мониторинга. В контексте Trino основная идея — минимизация downtime при сбоях и быстрый отклик на изменение состояния компонентов.
Руководство по HA:
- Координация: поддержка 2–3 координаторов в зависимости от нагрузки и числа пользователей. В Kubernetes — реплики координатора за счет репликации StatefulSet и балансировщика нагрузки.
- Worker-узлы: достаточное количество воркеров для обеспечения параллелизма и отказоустойчивости. В случае выхода узла из строя задача перераспределяется между оставшимися вузами.
- Discovery Service: служит механизмом согласования и динамической конфигурации. Он обеспечивает корректное уведомление клиентов об изменениях в кластере.
- Каталоги данных и источники: Hive Metastore и аналогичные каталоги должны иметь устойчивый backend и репликацию, чтобы не стать единственным источником отказа для конкретной части данных.
- Бэкап и восстановление: сценарии резервного копирования конфигураций, метаданных и настроек коннекторов. В частности, для Hive Metastore и других метаданных необходимы регулярные бэкапы.
- Балансировщики: для режимов HA на координационной стороне применяют балансировку и тестирование резерва. Это позволяет клиентам автоматически перенаправляться к работающим координаторам.
Мониторинг и управляющие процессы:
- Метрики и трассировка: Prometheus, Grafana, OpenTelemetry. Метрики по времени планирования, задержке между координацией и воркерами, пропускной способности запросов, частоте ошибок
- Логирование: централизованный сбор логов, поиск по событиям ошибок и сбоев. Важна фиксация информации о версиях коннекторов, используемых версиях Trino и конфигурациях
- Операционные процедуры: регламенты обновления, откат к предыдущей версии, проверка совместимости коннекторов, планирование времени простоя
Интеграции, безопасность и управление доступом
Интеграции и безопасность — важные элементы для надёжной эксплуатации кластера. В контексте Trino это включает в себя работу с каталогами данных, конфигурацию коннекторов, а также механизмы аутентификации и авторизации, шифрование и аудит.
Интеграции:
- Каталоги и коннекторы: Hive, Iceberg, Delta Lake, JDBC и другие коннекторы. Каталоги позволяют централизовать метаданные и упростить управление схемами. В корпоративных сценариях Hive Metastore часто выступает единым источником истины по метаданным.
- Метаданные источников: интеграция с Iceberg/Delta Lake обеспечивает корректность и версионирование данных. В зависимости от источника это может требовать дополнительной настройки прав доступа или опций коннектора.
- Безопасность хранения: TLS для соединений между клиентами и координацией, а также между координацией и воркерами. Поддержка Kerberos/LDAP для аутентификации, интеграция с SSO. В некоторых средах применяют Vault или аналогичные средства для хранения секретов и ключей.
Безопасность и доступ:
- Аутентификация и авторизация: деление пользователей на роли и доступные операции. Встроенная система RBAC Trino поддерживает ограничение прав доступа на уровне таблиц, схем и отдельных источников.
- Шифрование: TLS для передачи данных, шифрование в хранилище данных (объектное хранилище, HDFS и т. п.). Важно обеспечить согласованность ключей и периодическую их ротацию.
- Управление секретами: хранение учетных данных доступа к источникам данных в безопасном хранилище секретов, использование секретов Kubernetes или Vault.
- Аудит: ведение журнала доступа и изменений в конфигурациях, а также мониторинг использования ресурсов и запросов к чувствительным данным.
Примеры конфигураций по каталогу и безопасности:
# Пример: безопасность клиента и TLS
config.properties
http-server.https.enabled=true
http-server.https.port=8443
http-server.authentication.type=.. (LDAP/Kerberos)
# Пример: каталог Hive с безопасной аутентификацией
catalog/hive.properties
connector.name=hive
hive.metastore-uri=thrift://metastore:9083
hive.metastore.client.factory.class=com.example.secure.HDFSMetastoreClientFactory
# Пример: пример Kerberos-конфига
# jvm.config
-Xmx16G
-XX:+UseG1GC
Передача данных между источниками должна осуществляться с учётом политики по защите конфиденциальной информации: ограничение доступа к данным, аудит действий и минимизация прав. В крупных организациях рекомендуется сочетать Trino с централизованными политиками доступа на уровне каталога и источника данных, чтобы избежать дублирования правил и обеспечить единообразную миграцию прав при реорганизациях.
Key takeaways
- Архитектура Trino четко разделяет роли координатора, воркеров и каталоги; правильное распределение ролей критично для производительности и устойчивости.
- Развёртывание в Kubernetes или через инфраструктуру как код обеспечивает воспроизводимость и плавные обновления; используйте canary- и blue/green-подходы для минимизации downtime.
- Масштабирование требует сбалансированного подхода: горизонтальное масштабирование воркеров, разумное управление памятью и планированием задач; настройки query.max-memory и related параметров критичны.
- HA достигается через дублирование координаторов, надёжный Discovery Service, устойчивые каталоги и продуманное управление обновлениями; мониторинг и алертинг должны быть встроены в операционные процессы.
- Интеграции с коннекторами и каталогами требуют аккуратной настройки и тестирования, в особенности связь с Hive Metastore, Iceberg/Delta и системами безопасности.
- Безопасность должна покрывать аутентификацию, авторизацию, TLS и аудит; секреты и конфигурации должны храниться в безопасной среде.
- Мониторинг и управление изменениями являются неотъемлемой частью эксплуатации: постройте устойчивую экосистему метрик, логов и алертинга.
FAQ
Какую архитектуру кластера выбрать для средней компании?
Ответ: для средней компании рекомендуется минимальный HA-кластер из 2–3 координаторов (возможна одна активная и одна пассивная реплика) и набора воркеров,scaleable через контейнеризацию в Kubernetes. Такой подход обеспечивает отказоустойчивость и масштабируемость без чрезмерной сложности. Важной частью становится Discovery Service, центральный каталог метаданных и единая стратегия безопасности.
Какие параметры памяти и CPU являются приоритетными при настройке воркеров?
Ответ: ключевыми являются memory для JVM и лимиты запросов. Рекомендуется задать query.max-memory-per-node и query.max-memory так, чтобы один тяжёлый запрос не «съедал» ресурсы всей ноды. CPU-ресурсы должны быть пропорциональны ожидаемой нагрузке, с учётом параллелизма выполнения. В реальных сценариях целевые значения подбираются экспериментально на основе типичных запросов и объема данных.
Как организовать безопасное подключение к источникам данных?
Ответ: используйте TLS для связей с источниками данных, храните учетные данные в секретах, применяйте Kerberos/LDAP для аутентификации и RBAC на уровне каталогов. Рекомендуется хранить конфигурации коннекторов в безопасных конфигурациях и тестировать обновления безопасности на тестовом стенде перед переходом в продакшн.
Что делать при обновлении версии Trino в продакшн?
Ответ: используйте процедуру canary-обновления: сперва обновите часть воркеров на тестовой среде, проверьте совместимость коннекторов и регрессионные тесты, затем постепенно распространите обновление на остальной кластер. Важны откатные сценарии и резервное копирование конфигураций и метаданных.
Какие способы мониторинга наиболее эффективны для кластера Trino?
Ответ: полноценная связка Prometheus + Grafana с готовыми дашбордами по нагрузке на воркеры, времени планирования и задержкам. Дополнительно полезны трассировка запросов (OpenTelemetry), логирование в централизованный хаб и алертинг на критические метрики (OMP/CPU, память, ошибки коннекторов).
Какие принципы следует соблюдать при развертывании коннекторов?
Ответ: тестируйте коннекторы в тестовой среде с аналогичными наборами данных, соблюдайте требования к версии Hadoop/Iceberg/Delta Lake и к версии Hive Metastore. Обеспечьте согласование схем и стабильные источники данных, чтобы избежать несогласованности в планировании.
Как обеспечить высокий процент predicate pushdown и réduction данных на источниках?
Ответ: включите оптимизации на уровне коннекторов, используйте фильтрацию на источнике данных, настраивайте параметры динамического фильтра и соответствующие правила переработки запросов. Эффект заметен на больших объёмах данных и в сценариях, где источники позволяют эффективно фильтровать данные.
Как организовать обновления конфигураций без простоев?
Ответ: применяйте подходы blue/green или canary, где новые конфигурации тестируются на отдельных узлах, затем плавно переключаются на продакшн-среду через балансировщик или Discovery Service. Важно иметь версионирование конфигураций и возможность быстрого отката.
Какие риски возникают при масштабировании и как их минимизировать?
Ответ: основными рисками являются перегрузка памяти, неэффективное распределение данных и задержки из-за нехватки сетевых ресурсов. Минимизировать их можно через контроль памяти, мониторинг планирования и тестирование под нагрузкой, а также через грамотное распределение данных между воркерами и коннекторами.
Какие практики стоит внедрить для управления изменениями в полигонах данных?
Ответ: документируйте все изменения конфигураций и версий коннекторов, применяйте CI/CD для инфраструктуры, тестируйте совместимость новых версий, используйте единый подход к безопасному хранению секретов и контроля доступов, автоматизируйте миграции схем и тестовые наборы данных для проверки поведения в условиях изменений.


