

Введение в контекст аналитических нагрузок и роль Trino
Аналітика современного предприятия требует комплексного доступа к данным из множества источников: дата-ларны, хранилища данных, данные стриминга и внешние источники. Эти нагрузки характеризуются параллельной обработкой немалых объёмов данных, требованиями к задержке, гибкостью доступа и строгими требованиями к безопасности. В таком контексте единого, устойчивого и масштабируемого слоя для аналитических запросов часто не хватает у традиционных инструментов. Trino выступает как распределённый SQL-движок, который позволяет выполнять аналитические запросы сразу по нескольким источникам и хранить результаты в рамках одной логической виде. Это позволяет пользователям видеть единое представление данных и избегать переносов данных между системами только ради аналитики.
Введение в контекст аналитических нагрузок и роль Trino подразумевает понимание того, как организованы современные сценарии анализа: от ad-hoc запросов учёных и аналитиков до периодических дэшбордов и функциональности Data Science. Роль Trino не ограничивается merely ускорением SQL-запросов: он обеспечивает согласованный интерфейс к данным, управление ресурсами и безопасность на границе между источниками. В рамках курса мы исследуем архитектуру Trino, принципы планирования запросов, а также практические подходы к подключению источников и обеспечению устойчивости систем в условиях многоклиентского доступа и высокой конкуренции по ресурсам.
Это введение задаёт основу для следующих глав: как проектировать аналитическую архитектуру вокруг Trino, какие коннекторы и каталоги выбрать под конкретные сценарии, и какие практики позволят достигнуть предсказуемости и управляемости при росте объёмов и числа пользователей.
- Контекст аналитических нагрузок и требования к доступу к данным
- Архитектура Trino: координация и исполнение вычислений
- Подключение источников данных и интеграции
- Планирование запросов, оптимизация и безопасность
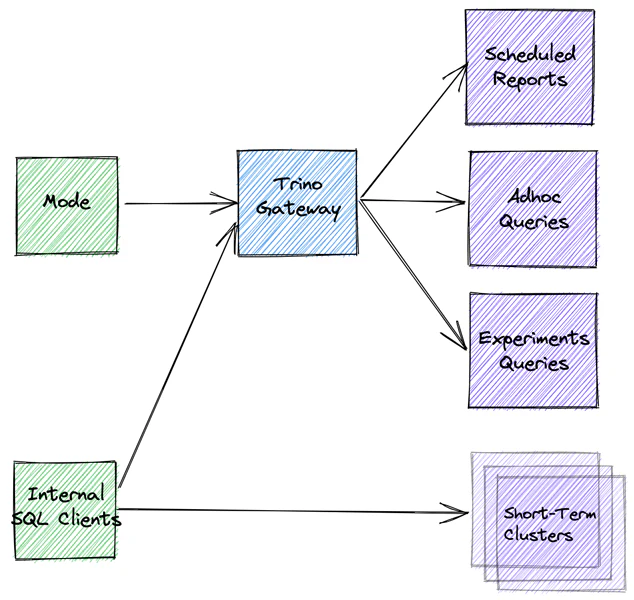
Контекст аналитических нагрузок и требования к доступу к данным
Современные аналитические нагрузки отличаются несколькими общими свойствами. Во‑первых, данные находятся в разных местах: Data Lake, реляционные хранилища, стриминг‑потоки и внешние сервисы. Во‑вторых, пользователи испытывают потребность в быстрых ответах на разнообразные запросы — от интерактивных дэшбордов до больших консолидированных выборок для Data Science. В‑третьих, требования к консистентности и свежести данных различаются: иногда достаточно сниппетов за текущий час, иногда необходима строгая консистентность на уровне транзакций и версий. Наконец, безопасность и соответствие регуляторным требованиям должны быть встроены в инфраструктуру аналитики с самого старта.
Trino отвечает на вызовы этим набором концепций и механизмов. Во‑первых, он представляет собой единый SQL‑слой поверх множества источников. Во‑вторых, благодаря распределённой архитектуре, он обеспечивает масштабируемый параллелизм и устойчивость к нагрузкам. В‑третьих, функциональные коннекторы и каталоги позволяют абстрагировать различия между хранилищами и поставлять единое поведение к запросам. В‑четвёртых, механизмы планирования и исполнения запросов позволяют выбрать между различными стратегиями соединений и перекладывают вычисления ближе к данным или к узлам целевых кластеров в зависимости от конфигурации.
Развитие аналитических процессов требует параллельной поддержки нескольких режимов использования: исследовательские задачи групп пользователей, операционные дэшборды с заданной задержкой, регулярные еженедельные агрегации и выборки для BI‑инструментов. Эти режимы диктуют требования к параллелизму, управлению ресурсами, ограничению памяти и адаптивности к изменению нагрузки. Trino предлагает подход, при котором вычисления может масштабировать горизонтально, применяя очереди запросов, политики очередей и управление ресурсами (workload groups), минимизируя эффект «костра» на соседние задачи.
Компоненты архитектуры Trino влияют на то, как именно обеспечить единый доступ к данным без потери контроля над безопасностью и соблюдением SLA. В частности, архитектура поддерживает:
- распределённый планировщик запросов: parse, analyze, rewrite, optimize и распределение задач на воркеры;
- координационный узел ( coordinator ) и набор рабочих узлов ( workers ), которые исполняют фрагменты планов;
- каталоги и коннекторы, обеспечивающие доступ к данным из разных источников через унифицированный SQL‑интерфейс;
- механизмы безопасности на уровне аутентификации и авторизации, а также шифрования в транзите и на уровне данных;
- инструментальные средства мониторинга и диагностики, позволяющие поддерживать SLA и управлять затратами.
Эта глава представляет собой фундамент для дальнейшего перехода к практическим аспектам: какие источники подключать, как настраивать кластер для многопользовательской аналитики и какие подходы к планированию запросов обеспечивают предсказуемую производительность в условиях реальных нагрузок.
Архитектура Trino: координация и исполнение вычислений
Основной принцип архитектуры Trino состоит в разделении ролей между координатором и воркерами. Координатор выполняет функции планирования, разрешения метаданных и распределения задач между рабочими узлами. Воркеры содержат исполнительные движки, которые обрабатывают фрагменты запросов, обмениваются данными через эффективные механизмы обмена и возвращают результаты координации. Такая схема обеспечивает горизонтальную масштабируемость: можно добавлять новые воркеры по мере роста объёмов данных или числа одновременных пользователей.
Цель распределённого исполнения — минимизировать задержки, поддерживать высокий уровень параллелизма и избегать узких мест в источниках. Архитектура поддерживает несколько критических концепций:
- фрагментная параллелизация: запрос разбивается на независимые или частично зависимые задачи, которые исполняются на нескольких узлах. Это даёт эффективное использование CPU и сетевых ресурсов;
- обмен данными между узлами: данные, необходимые для последующих стадий, перемещаются через стандартный протокол обмена; выбор метода передачи (broadcast, partitioned exchange) зависит от типа операции и объёма данных;
- использование статистик и метаданных: оптимизатор располагает статистическими данными о таблицах и источниках, что позволяет выбирать эффективные планы выполнения, в частности выбор стратегий соединения и фильтрации;
- поддержка динамической фильтрации: раннее применение фильтров к источникам может значительно уменьшить объём данных, который передаётся и обрабатывается в дальнейшем;
- управление памятью и spill‑поведение: на этапе выполнения запросы могут уйти на диск при нехватке памяти, чтобы сохранить устойчивость к перегрузкам и отказоустойчивость.
Работа с heterogeneous источниками требует тщательного взаимодействия между слоями планирования и исполнительного движка. Примерно процесс может быть описан так:
- Парсинг и синтаксический анализ запроса на координирующем узле.
- Семантический анализ и преобразование в план выполнения с учётом доступных коннекторов и каталога.
- Оптимизация: выбор стратегий соединения, перестановка операций, применение предикатного фильтра и вычислительных фильтров на ранних стадиях.
- Разбиение плана на фрагменты и передача их воркерам для исполнения.
- Обмен промежуточными результатами между узлами и сбор итогового ответа.
Эффективность архитектуры во многом зависит от того, как правильно настроены параметры координации, очереди задач и правила распределения ресурсов. В рамках курса особое внимание уделяется проектированию многопользовательской среды: как обеспечить справедливое распределение ресурсов между активными запросами, как управлять пределами памяти и времени выполнения, как реагировать на всплески нагрузки и как поддерживать высокой доступности узлы.
В контексте аналитических нагрузок важно также понять роль коннекторов и каталогов. Каталоги выступают как каталожная оболочка над источниками, позволяя единообразно описывать доступ к данным без привязки к конкретной системе. Коннекторы реализуют конкретную логику доступа к данным и преобразование их в единый SQL‑интерфейс. Так, подключение к Hive Metastore через каталог Hive обеспечивает доступ к таблицам Hive и внешним данным, подключение к Apache Iceberg — к таблицам на основе формата Iceberg, а JDBC‑коннектор позволяет обращаться к внешним СУБД. Взаимодействие между координацией, исполнением и источниками требует согласованных контрактов по метаданным, форматам данных и функциям фильтрации, которые реализованы через пулы соединений, кэширование метаданных и режимы выполнения без потерь производительности.
Безопасность и контроль доступа остаются критическим компонентом архитектуры. В интересах аналитической среды следует учитывать:
- распределение ролей и прав: кто может запускать какие запросы, к каким источникам и таблицам;
- механизм аутентификации: LDAP/ Kerberos, OAuth2 и локальные схемы;
- авторизация на уровне объектов: каталоги, схемы, таблицы и столбцы;
- шифрование в транзите и защита сетевой инфраструктуры;
- аудит и журналирование действий пользователей.
Эффективная архитектура требует и стратегий мониторинга: сбор метрик по времени выполнения, задержке, throughput, потреблению памяти на узел и по узлам координации, а также визуализации через системы мониторинга (например, Prometheus и Grafana). Это позволяет не только реагировать на инциденты, но и прогнозировать рост нагрузки и планировать масштабирование.
Подключение источников данных и интеграции
Trino спроектирован как интеграционная платформа: он соединяет данные из множества систем через коннекторы и каталоги. Эта концепция позволяет формировать единый интерфейс доступа к данным, избегая копирования и дублирования информации. Главные компоненты здесь — каталоги и коннекторы.
- Каталог — это конфигурационная сущность, которая определяет набор коннекторов и параметры подключения к конкретному источнику. Каталог позволяет централизованно управлять доступом и аутентификацией к источнику данных, упрощая развертывание в разных средах (разделение сред, тестирование, продакшн).
- Коннектор — реализация доступа к конкретной системе. Коннекторы поддерживают разные форматы данных, режимы запросов и специальные возможности источника: предикатное фильтрацию на уровне источника, чтение партиций, работу с транзакциями или временными версиями.
Типичный набор источников и коннекторов в аналитической среде включает:
- Hive Metastore и файловые хранилища (S3/ HDFS) через каталоги, интеграции с форматом Parquet и ORC. Подобная связка обеспечивает доступ к таблицам на основе файлового хранилища и метаданных.
- Apache Iceberg или другого формата таблиц на хранении данных, что даёт возможность эффективной эволюции схем, версий и управления временем.
- JDBC‑источники для сторонних СУБД: Oracle, PostgreSQL, MySQL — для сценариев миграции, консолидированных репозиториев и финального этапа консолидации.
- Стриминговые источники через коннекторы к Kafka или другим системам очередей сообщений, когда требуется обработка потоковых данных в рамках единых запросов.
Выбор конкретного набора источников определяется архитектурной моделью организации данных и требованиями к задержкам и SLA. Важной частью интеграции является согласование форматов представления данных на уровне SQL: как привести данные из разных источников к совместимым типам, как обрабатывать различия в схеме и как согласовать единый единый набор правил обработки (фильтры, агрегации, вычисления).
Безопасность доступа к данным во время интеграции играет критическую роль. Технологически это достигается через конфигурацию аутентификации на уровне каталога и источника, а также через механизм авторизации, который ограничивает для каждого пользователя возможности чтения и выполнения операций на конкретных таблицах и схемах. В качестве практических рекомендаций можно учитывать следующие подходы:
- централизованное управление учетными данными для источников через сервис с поддержкой внешних провайдеров идентификации;
- внедрение разделений по средам (dev, test, prod) с различными наборами прав и политиками;
- применение колонной политики доступа (row-level или column-level), когда это поддерживается источником;
- аудит действий пользователей и поддержка журналирования чтения и выполнения операций в целевых источниках.
Кроме того, полезной практикой является активное использование кэширования метаданных и стратегий пространства имён. Это уменьшает задержки при планировании запросов и сокращает количество обращений к внешним системам. В реальных развертываниях рекомендуется на первом этапе внедрять ограниченный набор источников, затем постепенно расширять окружение, применяя принципы постепенного развёртывания и обратной совместимости.
Планирование запросов, оптимизация и безопасность
Планирование и исполнение в Trino — ключ к достижению требуемой производительности на множестве источников. Процесс начинается с разбора запроса, определения целей и ограничений, затем переходит к оптимизации и распределению задач по узлам. Важными аспектами являются:
- этапы планирования: парсинг, семантикая, логическое и физическое преобразование плана;
- выбор стратегий соединения: broadcast join, partitioned join, semi‑join, и их размещение в зависимости от объёмов данных и seletivity;
- предикатное фильтрование и pushdown: чем раньше в источнике применяются фильтры, тем меньше объём данных передаётся между узлами;
- использование статистик: информация о таблицах и разделах позволяет оптимизатору избегать неэффективных стратегий и выбирать наиболее экономичные планы;
- параллелизм и обмен данными: баланс между локальным вычислением и передачей данных по сети, распределение задач по воркерам и эффективная работа блоков передачи;
- управление памятью и spill‑поведение: ограничение потребления памяти и корректная настройка spill на диске для сохранения устойчивости в случае пиков нагрузки;
- кэширование метаданных на уровне координации и узлов: уменьшение задержек планирования и повторных обращений к источникам данных.
Безопасность и соответствие обслуживаются на нескольких уровнях. Аутентификация подтверждает личность пользователя, а авторизация определяет, какие объекты доступны в рамках конкретной сессии. TLS обеспечивает защиту данных в сетевом канале, а аудит позволяет отслеживать активность пользователей и событий. В контексте аналитических нагрузок это особенно важно: чтобы соответствовать регулятивным требованиям и внутренним политикам, необходимо предусмотреть политику доступа на уровне каталогов, схем и таблиц, а также возможность видеть и анализировать журналы доступа.
Мониторинг и наблюдаемость — неотъемлемая часть устойчивой аналитической инфраструктуры. В реальных условиях рекомендуется:
- держать под контролем метрики времени отклика и задержек по источникам;
- отслеживать использование памяти на узлах и долю spill‑операций;
- мониторить очереди и очередности в рамках workload groups, чтобы избежать перегрузки конкретного узла;
- использовать графики чтения и записи для каждого коннектора, чтобы быстро выявлять проблемы на уровне источника или соединения;
- внедрить алерты на критические пороги задержек, ошибок подключения или превышение лимитов ресурсов.
Эти практики позволяют не только оперативно реагировать на инциденты, но и формировать более точные планы масштабирования и оптимизации затрат. В рамках курса следует рассмотреть сценарии миграции аналитических рабочих нагрузок на Trino: какие источники подключать на первом этапе, как выстроить безопасное и управляемое окружение и как оценивать влияние изменений на другие источники и на общую производительность.
Практические сценарии внедрения и архитектурные решения
Внедрение Trino в реальную корпоративную среду — это итеративный процесс, включающий архитектурный дизайн, пилоты, тестирование и постепенное масштабирование. Ниже приведены принципы и практики, помогающие строить устойчивые решения.
- Определение цели и наборов рабочих нагрузок: какие запросы будут выполняться чаще всего; какие источники будут задействованы; каковы требования к задержке и обновлениям данных; какие роли пользователей и BI‑инструментов будут использовать систему.
- Плавное масштабирование: начиная с небольшого кластера, который обслуживает ограниченную группу пользователей, постепенно добавлять воркеры и каталоги, следуя мониторингу загрузки, задержек и SLA.
- Моделирование нагрузки: проведение нагрузочного тестирования с учетом реальных сценариев — ad‑hoc запросы, регулярные дэшборды, консолидированные выборки для отчетности — для определения конфигураций памяти, числа воркеров и политики очередей.
- Архитектурные сочетания: выбор конфигураций источников, которые оптимально сочетаются с бизнес‑целями. Например, использование Iceberg для табличной версионируемой аналитики в сочетании с Hive Metastore может обеспечить эффективную доступность к данным и гибкую эволюцию схем.
- Интеграции с BI и аналитическими инструментами: обеспечение совместимости с популярными инструментами (Tableau, Power BI, Looker) через единый SQL‑API, минимизация кастомных коннекторов и поддержка предикатного pushdown для повышения производительности BI‑запросов.
- Безопасность и соответствие: внедрение политики доступа к данным на уровне каталогов и таблиц, аудит действий пользователей и соответствие требованиям регуляторов. В рамках проекта следует определить роли, схему авторизации и подходы к управлению секретами и учетными данными.
- Управление стоимостью и устойчивостью: выбор стратегий очередей, настройка лимитов памяти и времени выполнения, предотвращение перегрузок и минимизация задержек на межсетевых коммуникациях.
Оценка готовности к внедрению обычно включает следующие этапы:
- аудита текущих источников данных и их доступности в рамках каталога;
- планирование архитектурных изменений и определение целевых SLA;
- пилотный запуск на ограниченной группе пользователей с ограниченными источниками;
- сбор и анализ метрик производительности, корректировка конфигураций и возвращение к этапу пилота до полномасштабного развёртывания.
Key takeaways
- Trino обеспечивает единый SQL‑слой поверх множества источников данных, поддерживая распределённый параллелизм и масштабируемость.
- Архитектура с координационным узлом и пулом воркеров позволяет гибко управлять ресурсами и обслуживать многопользовательские аналитические нагрузки.
- Каталоги и коннекторы дают возможность подключать разнообразные источники данных через унифицированный интерфейс, сохраняя при этом особенности конкретной системы.
- Оптимизация планирования запросов, раннее фильтрование и управление памятью являются критическими для производительности в многосерверной среде и при большом числе одновременных запросов.
- Безопасность, управление доступом и мониторинг должны быть встроены на этапе проектирования, чтобы обеспечить соответствие требованиям и устойчивость к инцидентам.
- Внедрение требует стратегического подхода к архитектуре, пилоту и постепенному масштабированию с учётом SLA, затрат и потребностей бизнес‑пользователей.
FAQ
Что такое Trino и для каких сценариев он предназначен?
- Trino — это распределённый SQL‑передний слой, который позволяет выполнять аналитические запросы поверх множества источников данных. Он незаменим в сценариях многоисточниковой аналитики, где требуется единая точка доступа к данным и возможность объединять данные из Data Lake, хранилищ и потоковых источников без перемещения данных в отдельную систему. Он особенно полезен для BI/аналитических команд, которым нужна оперативная возможность соединять данные из Hive, Iceberg, JDBC‑источников и потоковых систем через единый SQL‑интерфейс.
Как устроена архитектура Trino и почему это важно для производительности?
- Архитектура разделяет функции планирования и исполнения. Координатор отвечает за планирование и распределение задач, тогда как воркеры исполняют фрагменты плана на данных. Это позволяет горизонтально масштабировать кластер, добавляя узлы по мере роста нагрузки или объёма данных. Взаимодействие координации и исполнителей, эффективные механизмы обмена данными и использование статистик позволяют достигать высокой пропускной способности и низкой задержки при запросах.
Какие источники данных поддерживает Trino и как выбрать коннектор?
- Trino поддерживает множество источников: Hive Metastore с файловыми хранилищами (Parquet/ORC), Iceberg, JDBC‑источники (PostgreSQL, MySQL, Oracle и т.д.), Kafka и другие потоковые/хранительские системы. Выбор коннектора зависит от целевой архитектуры: если данные уже лежат в Iceberg, предпочтителен коннектор Iceberg; если данные организованы в Hive, Hive Metastore может быть оптимальным выбором. При этом следует учитывать требования к предикатному pushdown и кэшированию метаданных, чтобы минимизировать задержки.
Что значит планирование запроса в Trino и какие практики здесь работают лучше?
- Планирование включает разбор запроса, анализ, оптимизацию и распределение задач между узлами. Эффективная практика — раннее применение фильтров, использование статистик для выбора лучших стратегий соединения и минимизация передачи данных между узлами. Важно настраивать параметры памяти, управления ресурсами и spill‑поведение. Постоянный мониторинг и настройка параметров на основе реальных сценариев позволяют поддерживать предсказуемость и стабильность производительности.
Как Trino обеспечивает безопасность доступа к данным?
- Безопасность достигается через многоуровневый подход: аутентификация (LDAP, Kerberos, OAuth2), авторизация на уровне каталогов/таблиц/колонок, шифрование данных в транзите и защита сетевых границ (TLS), аудит действий пользователей и событий доступа. Важно заранее определить роли, политики доступа и процедуры управления секретами, чтобы соответствовать требованиям регуляторов и внутренним политикам.
Какие практики мониторинга и управления SLA применяются в Trino?
- Включают метрики времени выполнения, задержек, использования памяти, количества активных запросов, состояния соединений и производительности коннекторов. Мониторинг в сочетании с алертингом позволяет выявлять узкие места, предотвращать срывы SLA и планировать масштабирование. Регулярные ревью конфигураций, тестирование под нагрузкой и моделирование реальных сценариев помогают поддерживать устойчивость и управлять затратами.
Как мигрировать существующие аналитические рабочие нагрузки на Trino?
- Миграцию следует осуществлять поэтапно: начать с пилотного проекта на ограниченном наборе источников и запросов, проверить корректность результатов и совместимость с BI‑инструментами, затем расширять охват и постепенно подключать новые источники. Важно определить роли и политики доступа, настроить мониторинг и убедиться, что бизнес‑пользователи получают ожидаемую производительность. Параллельно можно использовать существующие каталоги и коннекторы для плавного переноса, чтобы минимизировать риски и простои.
Какие узкие места чаще возникают в многоисточниковой аналитике и как их устранить?
- Узкие места включают задержки при планировании из-за большого числа источников, ограниченную пропускную способность сетей, неэффективные коннекторы для конкретных источников и чрезмерную нагрузку на память. Решение лежит в сочетании: оптимизация планирования через статистику и кэширование, настройка очередей и ресурсов, выбор более эффективных коннекторов, а также ограничение параллелизма для отдельных источников и использование предикатного pushdown.
Какие подходы к масштабированию и управлению затратами применяются в Trino?
- Масштабирование проводится горизонтально: добавление воркеров, настройка политики очередей и масштабируемых кластеров. Для управления затратами полезны такие практики, как ограничение памяти на узел, использование динамических фильтров и предикатов, а также оптимизация доступа к источникам с учётом особенностей каждого коннектора. Важно регулярно пересматривать конфигурации в контексте реальных нагрузок и обновлять практики мониторинга.
Какие примеры сценариев использования и типичных рабочих нагрузок вы встречаете в корпоративной практике?
- Интегрированные дэшборды и риск‑менеджмент, где требуется объединить данные из Hive/Parquet и внешних баз данных через единый SQL‑интерфейс; консолидация финансовой аналитики с использованием Iceberg и JDBC‑источников; мониторинг стриминга через Kafka и последующая агрегация в реальном времени; исследовательские проекты, где аналитики соединяют данные из нескольких источников для подготовки дата‑сетов.
Эта глава была направлена на систематизацию концепций и практик, необходимых для понимания роли и возможностей Trino в контексте современных аналитических нагрузок. В дальнейших главах мы углубимся в конкретные архитектурные решения, примеры конфигураций и пошаговые инструкции по установке и подключению источников, чтобы перейти к практическим навыкам работы с Trino с нуля.


