

Data Lakehouse: построение Data Lake нового поколения с помощью Apache Hudi
В этой статье мы представим Вам современную парадигму архитектуры данных, известную как Data Lakehouse. Данная парадигма опбладает целым рядом преимуществ по сравнению с традиционными озерами данных. Мы покажем Вам, как путем модернизации платформы данных и включения озера данных в общую архитектуру были решены такие проблемы, как масштабируемость, качество данных и задержки. Из этой статьи Вы также узнаете о том, как с помощью Apache Hudi построить свой собственный Data Lakehouse.
Предисловие
С развитием IoT, облачных приложений, социальных сетей и машинного обучения объем данных, собираемых компаниями, увеличивается в геометрической прогрессии. Одновременно с этим потребность в высококачественных данных перешла от периодичности в несколько дней и часов к периодичности в несколько минут и секунд.
В течение нескольких лет озера данных выполняли задачу хранения необработанных и обогащенных данных. Однако по мере их становления предприятия осознали, что процесс поддержания высокого качества, актуальности и согласованности данных слишком обременителен. В дополнение к сложностям, связанным с получением инкрементных данных, наполнение озера данных также требует бизнес-контекста и сильной зависимости от взаимосвязанных процессов. Ниже перечислены основные проблемы современных озер данных:
- Сбор данных об изменениях на основе запросов: Наиболее распространенным подходом к извлечению инкрементных исходных данных является использование запроса, который опирается на заданное условие фильтрации. Это приводит к проблемам, когда таблица не имеет допустимого поля для инкрементного извлечения данных, создает непредвиденную нагрузку на исходную базу данных или запрос не фиксирует все изменения в базе данных. CDC на основе запросов не включает удаленные записи, поскольку нет простого способа определить, были ли записи удалены с помощью запроса. CDC на основе журналов является предпочтительным подходом для CDC и решает вышеупомянутые проблемы.
- Инкрементная обработка данных в озере данных: Процесс ETL, отвечающий за обновление озера данных, должен прочитать все существующие файлы в озере данных, внести изменения и переписать весь набор данных в виде новых файлов (поскольку не существует простого способа обновить конкретный файл, в котором может находиться запись, на предмет обновлений и удалений).
- Отсутствие поддержки транзакций ACID: Невозможность обеспечить соответствие ACID может привести к несогласованным результатам при одновременном наличии читателей и писателей.
Все вышеперечисленные проблемы усугубляются увеличением объема данных и частотой, с которой эти данные обновляются. Усилия таких компаний, как Uber, Databricks и Netflix привели к появлению решений, направленных на борьбу с трудностями, с которыми ежедневно сталкиваются инженеры по обработке данных. Apache Hudi (Uber), Delta Lake (Databricks) и Apache Iceberg (Netflix) - это фреймворки для инкрементной обработки данных, предназначенные для выполнения обновлений и удалений в озере данных на распределенной файловой системе, такой как S3 или HDFS.
Кульминацией усилий компаний Uber, Databricks и Netflix стало появление нового поколения озер данных, предназначенных для предоставления актуальных данных в масштабируемой, адаптируемой и надежной форме - Data Lakehouse.
Что такое Data Lakehouse?

Проще говоря: Data Lake + Data Warehouse = Data Lakehouse
Традиционные хранилища данных предназначены для хранения исторических данных, которые были преобразованы/собраны для конкретных случаев использования/доменов данных и используются совместно с BI-инструментами для извлечения информации. Как правило, хранилища данных содержат только структурированные данные, они не являются экономически эффективными и загружаются с помощью пакетных ETL-заданий.
Озера данных были созданы для того, чтобы преодолеть некоторые из этих ограничений, поддерживая структурированные, полуструктурированные и неструктурированные данные со сравнительно недорогим хранением. По сравнению с хранилищами данных, озера данных содержат необработанные данные в различных форматах хранения, которые можно использовать для текущих и будущих задач. Однако у озер данных все еще есть свои ограничения, включая поддержку транзакций (что затрудняет поддержание озер данных в актуальном состоянии) и соответствие стандарту ACID (что предотвращает одновременное чтение и запись).

Хранилища данных используют преимущества недорогих хранилищ данных, таких как S3, GCS, Azure Blob Storage и т. д., наряду со структурами данных и возможностями управления данными хранилища данных. Они преодолевают ограничения озер данных, поддерживая транзакции ACID и обеспечивая согласованность данных при их одновременном чтении и обновлении. Кроме того, озерные хранилища позволяют использовать данные с меньшей задержкой и большей скоростью, чем традиционные хранилища данных, поскольку к данным можно обращаться напрямую из озерного хранилища данных.
Ключевые характеристики Data Lakehouse:
- Поддержка транзакций
- Применение схем и управление ими
- Поддержка BI
- Хранение данных отделено от вычислений
- Открытость
- Поддержка различных типов данных - от неструктурированных до структурированных
- Поддержка различных рабочих нагрузок
- Потоковая передача данных
Чтобы создать озеро данных, необходимо использовать фреймворк для инкрементной обработки данных, например Apache Hudi.
Что такое Apache Hudi?
Apache Hudi, что расшифровывается как Hadoop Upserts Deletes Incrementals, - это фреймворк с открытым исходным кодом, разработанный компанией Uber в 2016 году, который управляет хранением больших наборов данных в распределенных файловых системах, таких как облачные хранилища, HDFS или любые другие хранилища, совместимые с Hadoop FileSystem. Он обеспечивает атомарность, согласованность, изоляцию и долговечность (ACID) транзакций в озере данных.
Транзакционная модель Hudi основана на временной шкале, содержащей все действия, выполняемые над таблицей в разные моменты времени. Она предоставляет следующие возможности:
- Поддержка Upsert с быстрой, подключаемой индексацией.
- Атомарная публикация с откатом и точками сохранения.
- Изоляция моментальных снимков между писателем и запросами.
- Управление размерами файлов и компоновкой с помощью статистики.
- Асинхронное уплотнение строк и столбцов данных.
- Временная шкала метаданных для отслеживания истории.
Примеры использования
1. Вставка/удаление целевых данных с помощью захвата данных изменений
Захват данных об изменениях (CDC) - это процесс выявления и фиксации изменений, внесенных в исходную базу данных. Он копирует изменения из исходной базы данных в целевую, в данном случае в озеро данных. Это особенно важно для захвата операций вставки, обновления и удаления в целевых таблицах.
Существует три наиболее часто используемых метода CDC:
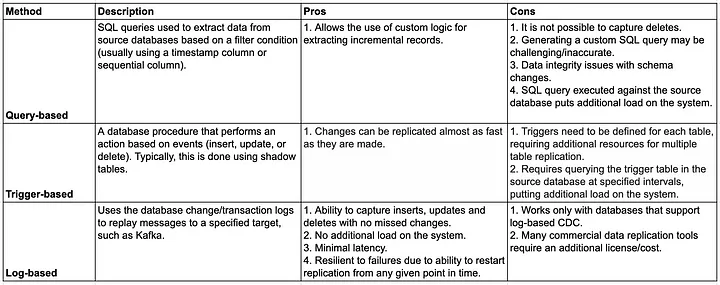
По нашему опыту, CDC на основе журналов обеспечивает наилучшие результаты при репликации изменений из исходных баз данных в озеро данных. Одной из основных причин этого является способность перехватывать удаленные записи, которые невозможно перехватить другим способом, используя CDC на основе запросов, без наличия флага удаления в исходных данных.
Hudi может обрабатывать данные об изменениях, находя соответствующие файлы в существующем наборе данных и переписывая их, чтобы включить все изменения. Кроме того, в ней предусмотрена возможность запроса набора данных на основе определенного момента времени и возможность возврата к предыдущей версии.
С распространением ввода данных практически в режиме реального времени с помощью инструментов CDC, таких как Oracle GoldenGate, Qlik Replicate (ранее Attunity Replicate) и DMS, возможность применения этих изменений к существующим наборам данных имеет очень большое значение.
2. Положения о конфиденциальности
Последние нормативные требования в области конфиденциальности данных, такие как GDPR, требуют от компаний выполнять обновление и удаление информации на уровне записей для того, чтобы удовлетворить право человека на забвение. Благодаря поддержке удаления в наборах данных Hudi процесс обновления или удаления информации для конкретного пользователя или в определенные сроки значительно упрощается.
Типы таблиц: Copy on Write vs. Merge on Read
Copy on Write: Данные хранятся в формате файлов Parquet (колоночно-ориентированное хранение), при этом каждое обновление создает новую версию файлов во время записи. Этот тип хранения подходит для пакетных рабочих нагрузок с интенсивным чтением, поскольку последняя версия набора данных всегда доступна.
Merge on Read: Данные хранятся в виде комбинации форматов файлов Parquet (колоночно-ориентированное хранение) и Avro (хранение на основе строк). Обновления записываются в дельта-файлы на основе строк до момента уплотнения, в результате которого создаются новые версии колоночных файлов. Этот тип хранения лучше подходит для потоковых рабочих нагрузок с интенсивной записью, поскольку фиксации записываются в дельта-файлы, а чтение набора данных требует уплотнения для слияния файлов Parquet и Avro.
Общее правило: Для таблиц, которые обновляются только с помощью пакетных ETL-заданий, используйте Copy on Write. Для таблиц, которые обновляются с помощью потоковых ETL-заданий, используйте Merge on Read. Для получения более подробной информации см. раздел «Как выбрать тип хранилища для моей рабочей нагрузки» в документации Hudi.
Типы запросов: моментальный снимок vs. Инкрементальный запрос vs. Запрос, оптимизированный на чтение
Моментальный снимок: Последний снимок таблицы на момент выполнения действия фиксации/компактирования. Для таблиц Merge on Read запрос моментального снимка будет объединять базовые и дельта-файлы; поэтому ожидается небольшая задержка.
Инкрементальный запрос: Изменения в таблице с момента данной фиксации/компиляции.
Запрос, оптимизированный на чтение: Последний снимок таблицы на момент выполнения действия фиксации/сжатия. Для таблиц Merge on Read запросы, оптимизированные на чтение, возвращают представление, содержащее только данные из базовых файлов без объединения дельта-файлов.
Преимущества Hudi (над пользовательскими реализациями):
- Решает проблемы качества данных, такие как дублирование записей, пропущенные обновления и т. д., которые часто встречаются в традиционных инкрементных пайплайнах пакетного ETL.
- Обеспечивает поддержку пайплайнов реального времени.
- Обнаружение аномалий, сценарии использования машинного обучения, предложения в реальном времени и т. д.
- Создает механизм (временную шкалу), который можно использовать для отслеживания изменений.
- Обеспечивает встроенную поддержку запросов через Hive и Presto.
Вооружившись системой поэтапной обработки данных для создания «озера данных», мы приступили к разработке решения для преодоления ключевых проблем, с которыми сталкивается клиент, желающий усовершенствовать свою платформу данных.
Проблема
Мы работали с клиентом, которому требовалась усовершенствованная, экономически эффективная и масштабируемая платформа данных, позволяющая специалистам по обработке данных делать эффективные прогнозы практически в режиме реального времени на основе самых актуальных данных и с минимальной задержкой. Существующие процессы пакетного ETL выполнялись по отложенному графику и требовали больших вычислительных затрат, поскольку для наполнения озера данных требовалось переработать весь набор данных. Кроме того, в этих процессах использовался метод CDC на основе запросов, что приводило к невозможности учесть все изменения в исходной системе. Сочетание устаревших и неточных данных привело к отсутствию доверия к платформе данных, что свело на нет всю потенциальную пользу, которую можно было бы извлечь из данных.
Решение
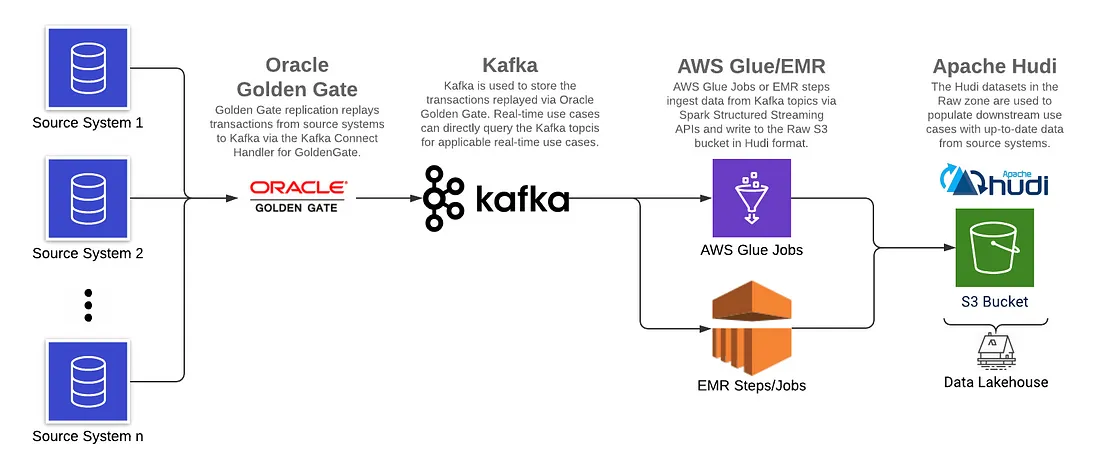
Используя инструмент CDC на основе журналов (Oracle GoldenGate), Apache Kafka и фреймворк для инкрементной обработки данных (Apache Hudi на AWS), мы создали озеро данных на AWS S3 для снижения задержек, улучшения качества данных и поддержки ACID-транзакций.
Целевая архитектура
Среда
- Oracle GoldenGate for Big Data: 19c
- Confluent Kafka: 5.5.0
- Apache Spark (Glue): 2.4.3
- ABRiS: 3.2
- Apache Hudi: 0.5.3
Oracle GoldenGate использовался в качестве инструмента CDC на основе журналов для извлечения данных (т. е. транзакций) из журналов исходных систем благодаря тому, что клиент уже использует семейство продуктов Oracle GoldenGate. Журналы реплицируются в Kafka практически в режиме реального времени, откуда сообщения считываются и объединяются в озеро данных в формате Hudi.
Apache Hudi был выбран в качестве фреймворка для инкрементной обработки данных благодаря его интеграции с AWS EMR и Athena, что делает его идеальным кандидатом для данного конкретного решения.
Алгоритм действий
Шаг 1: Репликация исходных данных с помощью Oracle GoldenGate
Как уже говорилось, CDC на основе журналов - наиболее оптимальное решение, поскольку оно позволяет использовать как пакетные, так и потоковые данные. Необходимости в отдельных шаблонах ввода для пакетных и потоковых источников больше нет. Традиционно для пакетных рабочих нагрузок использовался SQL-запрос, который выполнялся с определенной периодичностью. Вместо этого CDC на основе журналов позволяет фиксировать любые изменения, которые затем воспроизводятся в нужном месте (т. е. в Kafka). Отделение извлечения от ввода позволяет гибко вводить инкрементные данные в зависимости от того, как часто их нужно обновлять в хранилище данных. Это позволяет минимизировать затраты, поскольку данные могут быть получены из Kafka в течение определенного периода хранения.
Oracle GoldenGate - это инструмент репликации данных, используемый для захвата транзакций из исходных систем и их репликации в целевые, такие как темы Kafka или другая база данных. Он работает, используя журнал транзакций базы данных, в котором записывается все, что происходит в базе данных. OGG считывает и переносит транзакции на указанную цель. GoldenGate поддерживает несколько реляционных баз данных, включая Oracle, MySQL, DB2, SQL Server и Teradata.
В этом решении изменения транслируются из исходных баз данных в Kafka с помощью Oracle GoldenGate, который выполняет трехэтапный процесс:
- Извлечение данных из журналов исходных баз данных с помощью Oracle GoldenGate 12c (классическая версия): Транзакции, происходящие с исходными базами данных, извлекаются в режиме реального времени и сохраняются в формате промежуточного журнала (trail log).
- Перекачивание журналов во вторичный удаленный журнал Извлеченные журналы перекачиваются в другой журнал (управляемый экземпляром Oracle GoldenGate for Big Data 12c).
- Репликация журналов в Kafka через Oracle GoldenGate for Big Data 12c с помощью Kafka Connect Handler: Прокачанные транзакции принимаются и реплицируются в сообщениях Kafka. Этот процесс сериализует (с реестром схем или без него) сообщения Kafka и выполняет преобразование типов (если требуется) в сообщениях, воспроизведенных из журналов транзакций, перед публикацией в Kafka.

Примечание: По умолчанию обновленные записи содержат только те столбцы, которые были обновлены при репликации через GoldenGate. Чтобы инкрементные записи могли быть объединены в хранилище данных с минимальными преобразованиями (т. е. реплицировалась вся запись со всеми столбцами), необходимо включить дополнительную регистрацию (Supplemental Logging). Это включает в себя изображения «до» и «после» для каждой записи.
Репликация GoldenGate включает поле «op_type», которое указывает на тип операции базы данных из исходного файла: I - вставка, U - обновление, D - удаление. Это поле полезно для определения того, как вставить/удалить запись в хранилище данных.
Ниже приведен пример записи вставки:
{
  "table": "GG.TCUSTORD",
  "op_type": "I",
  "op_ts": "2013-06-02 22:14:36.000000",
  "current_ts": "2015-09-18T10:17:49.570000",
  "pos": "00000000000000001444",
  "primary_keys": [
    "CUST_CODE",
    "ORDER_DATE",
    "PRODUCT_CODE",
    "ORDER_ID"
  ],
  "tokens": {
    "R": "AADPkvAAEAAEqL2AAA"
  },
  "before": null,
  "after": {
    "CUST_CODE": "WILL",
    "CUST_CODE_isMissing": false,
    "ORDER_DATE": "1994-09-30:15:33:00",
    "ORDER_DATE_isMissing": false,
    "PRODUCT_CODE": "CAR",
    "PRODUCT_CODE_isMissing": false,
    "ORDER_ID": "144",
    "ORDER_ID_isMissing": false,
    "PRODUCT_PRICE": 17520,
    "PRODUCT_PRICE_isMissing": false,
    "PRODUCT_AMOUNT": 3,
    "PRODUCT_AMOUNT_isMissing": false,
    "TRANSACTION_ID": "100",
    "TRANSACTION_ID_isMissing": false
  }
}Примечание: запись GoldenGate содержит null до и not null после. Образец записи update
Примечание: Запись update GoldenGate содержит null до и not null после. Образец записи delete
Примечание: Запись delete GoldenGate содержит null до и not null после.
Шаг 2: Захват реплицированных данных в Kafka
Целью репликации GoldenGate является Kafka. Поскольку GoldenGate for BigData будет реплицировать записи в Kafka через Kafka Connect Handler, поддерживается эволюция схемы и дополнительные возможности, предлагаемые Schema Registry.
Почему именно Kafka? Есть две основные причины, по которым Kafka служит в качестве промежуточного слоя между инструментом CDC и хранилищем данных.
Первая причина заключается в том, что GoldenGate не может напрямую реплицировать данные CDC из исходных баз данных в Lakehouse в формате Apache Hudi (поскольку это механизм обработки на базе Spark). Существующая интеграция между Kafka и Spark Structured Streaming делает идеальным вариант для размещения инкрементных записей в Kafka, которые затем могут быть обработаны и записаны в формате Hudi.
Вторая причина заключается в том, чтобы решить проблемы потребителей, которым требуется задержка, близкая к реальному времени, например обнаружить и предотвратить потерю подписчиков сервиса на основе набора транзакций.
Шаг 3: Считывание данных из Kafka и запись в S3 в формате Hudi
Задания Spark Structured Streaming выполняют следующие операции:
1. Чтение записей из Kafka.
TOPIC_NAME = "topic_name"
KAFKA_BOOTSTRAP_SERVERS = "host1:port1,host2:port2"
# read data from Kafka
df = (
    spark.readStream.format("kafka")
    .option("kafka.bootstrap.servers", KAFKA_BOOTSTRAP_SERVERS)
    .option("subscribe", TOPIC_NAME)
    .load()
)
2. Десериализация записей с помощью реестра схем.
Примечание: любые данные в темах Kafka, сериализованные с использованием формата Confluent Avro, не могут быть десериализованы с помощью Spark API, что препятствует последующей обработке этих данных, необходимой для наполнения хранилища данных. Это касается записей, реплицированных с помощью GoldenGate. ABRiS - это библиотека Spark, которая позволяет десериализовать записи Kafka в формате Confluent Avro на основе схемы в Schema Registry. Версия ABRiS, используемая в данном решении, - 3.2. В следующем видео (@12:34) об этом рассказывается более подробно: https://youtu.be/Lj3StRWJ_7k
from pyspark import SparkContext
from pyspark.sql.column import Column, _to_java_column
from pyspark.sql.functions import col
# instantiates a Scala Map containing configurations for communicating with Schema Regsitry APIs
def get_schema_registry_conf_map(spark, schema_registry_url, topic_name):
    sc = spark.SparkContext
    jvm_gateway = sc._gateway.jvm
    schema_registry_config_dict = {
        "schema.registry.url": schema_registry_url,
        "schema.registry.topic": topic_name,
        "value.schema.id": "latest",
        "value.schema.naming.strategy": "topic.name"
    }
    conf_map = getattr(
        getattr(jvm_gateway.scala.collection.immutable.Map, "EmptyMap$"), "MODULE$"
    )
    for k, v in schema_registry_config_dict.items():
        conf_map = getattr(conf_map, "$plus")(jvm_gateway.scala.Tuple2(k, v))
    return conf_map
# returns deserialized column (using Schema Registry)
def from_avro(col, conf_map):
    jvm_gateway = SparkContext._active_spark_context._gateway.jvm
    abris_avro = jvm_gateway.za.co.absa.abris.avro
    return Column(
        abris_avro.functions.from_confluent_avro(_to_java_column(col), conf_map)
    )
TOPIC_NAME = "topic_name"
SCHEMA_REGISTRY_URL = "host1:port1,host2:port2"
# instantiate Scala Map for communicating with Schema Regsitry APIs
conf_map = get_schema_registry_conf_map(spark, SCHEMA_REGISTRY_URL, TOPIC_NAME)
# deserialize column containing data (using Schema Registry) and select pertinent columns for processing and
deserialized_df = df.select(
    col("key").cast("string"),
    col("partition"),
    col("offset"),
    col("timestamp"),
    col("timestampType"),
    from_avro(df.value, conf_map).alias("value")
)
3. Извлеките нужные Вам изображения до/после на основе «op_type» Oracle GoldenGate и внесите записи в хранилище данных в формате Hudi.
Код Spark использует поле «op_type» из записи GoldenGate, чтобы разделить пакет входящих записей на две группы: одна содержит вставки/обновления, а вторая - удаления. Это делается для того, чтобы конфигурация операции записи Hudi могла быть настроена соответствующим образом. Последующие преобразования позволяют извлечь соответствующее изображение до или после записи. Последний шаг - установка соответствующих свойств Hudi, упомянутых ниже, а затем запись вставок и удалений в формате Hudi в нужное место в S3 с помощью API структурированной потоковой передачи данных foreachBatch Spark Structured Streaming API в потоковом или пакетном режиме
import copy
# write to a path using the Hudi format
def hudi_write(df, schema, table, path, mode, hudi_options):
    hudi_options = {
        "hoodie.datasource.write.recordkey.field": "recordkey",
        "hoodie.datasource.write.precombine.field": "precombine_field",
        "hoodie.datasource.write.partitionpath.field": "partitionpath_field",
        "hoodie.datasource.write.operation": "write_operaion",
        "hoodie.datasource.write.table.type": "table_type",
        "hoodie.table.name": TABLE,
        "hoodie.datasource.write.table.name": TABLE,
        "hoodie.bloom.index.update.partition.path": True,
        "hoodie.index.type": "GLOBAL_BLOOM",
        "hoodie.consistency.check.enabled": True,
        # Set Glue Data Catalog related Hudi configs
        "hoodie.datasource.hive_sync.enable": True,
        "hoodie.datasource.hive_sync.use_jdbc": False,
        "hoodie.datasource.hive_sync.database": SCHEMA,
        "hoodie.datasource.hive_sync.table": TABLE,
    }

    if (
        hudi_options.get("hoodie.datasource.write.partitionpath.field")
        and hudi_options.get("hoodie.datasource.write.partitionpath.field") != ""
    ):
        hudi_options.setdefault(
            "hoodie.datasource.write.keygenerator.class",
            "org.apache.hudi.keygen.ComplexKeyGenerator",
        )
        hudi_options.setdefault(
            "hoodie.datasource.hive_sync.partition_extractor_class",
            "org.apache.hudi.hive.MultiPartKeysValueExtractor",
        )
        hudi_options.setdefault(
            "hoodie.datasource.hive_sync.partition_fields",
            hudi_options.get("hoodie.datasource.write.partitionpath.field"),
        )
        hudi_options.setdefault("hoodie.datasource.write.hive_style_partitioning", True)
    else:
        hudi_options[
            "hoodie.datasource.write.keygenerator.class"
        ] = "org.apache.hudi.keygen.NonpartitionedKeyGenerator"
        hudi_options.setdefault(
            "hoodie.datasource.hive_sync.partition_extractor_class",
            "org.apache.hudi.hive.NonPartitionedExtractor",
        )
    df.write.format("hudi").options(**hudi_options).mode(mode).save(path)
# parse the OGG records and write upserts/deletes to S3 by calling the hudi_write function
def write_to_s3(df, path):

    # select the pertitent fields from the df
    flattened_df = df.select(
        "value.*", "key", "partition", "offset", "timestamp", "timestampType"
    )

    # filter for only the inserts and updates
    df_w_upserts = flattened_df.filter('op_type in ("I", "U")').select(
        "after.*",
        "key",
        "partition",
        "offset",
        "timestamp",
        "timestampType",
        "op_type",
        "op_ts",
        "current_ts",
        "pos",
    )

    # filter for only the deletes
    df_w_deletes = flattened_df.filter('op_type in ("D")').select(
        "before.*",
        "key",
        "partition",
        "offset",
        "timestamp",
        "timestampType",
        "op_type",
        "op_ts",
        "current_ts",
        "pos",
    )


    # invoke hudi_write function for upserts
    if df_w_upserts and df_w_upserts.count() > 0:
        hudi_write(
            df=df_w_upserts,
            schema="schema_name",
            table="table_name",
            path=path,
            mode="append",
            hudi_options=hudi_options
        )
     # invoke hudi_write function for deletes
    if df_w_deletes and df_w_deletes.count() > 0:
        hudi_options_copy = copy.deepcopy(hudi_options)
        hudi_options_copy["hoodie.datasource.write.operation"] = "delete"
        hudi_options_copy["hoodie.bloom.index.update.partition.path"] = False
        hudi_write(
            df=df_w_deletes,
            schema="schema_name",
            table="table_name",
            path=path,
            mode="append",
            hudi_options=hudi_options_copy
        )

TABLE = "table_name"
SCHEMA = "schema_name"
CHECKPOINT_LOCATION = "s3://bucket/checkpoint_path/"
TARGET_PATH="s3://bucket/target_path/"
STREAMING = True
# instantiate writeStream object
query = deserialized_df.writeStream
# add attribute to writeStream object for batch writes
if not STREAMING:
    query = query.trigger(once=True)

# write to a path using the Hudi format
write_to_s3_hudi = query.foreachBatch(
    lambda batch_df, batch_id: write_to_s3(df=batch_df, path=TARGET_PATH)
).start(checkpointLocation=CHECKPOINT_LOCATION)
# await termination of the write operation
write_to_s3_hudi.awaitTermination()
Самые важные характеристики Hudi:
- hoodie.datasource.write.precombine.field: Поле precombine для таблицы является обязательной конфигурацией и не может быть нулевым (т. е. отсутствовать для записи) в таблице. Это может привести к проблемам, если источник данных не содержит действительного поля, используемого для определения ничьей. Если источник данных не соответствует этому требованию, возможно, стоит реализовать пользовательскую логику дедупликации для этих таблиц.
- hoodie.datasource.write.keygenerator.class: Установите это значение в org.apache.hudi.keygen.ComplexKeyGenerator для таблиц, содержащих составной ключ или разделенных более чем на один столбец. Установите это значение на org.apache.hudi.keygen.NonpartitionedKeyGenerator.
- hoodie.datasource.hive_sync.partition_extractor_class: Установите это значение в org.apache.hudi.hive.MultiPartKeysValueExtractor для создания таблицы Hive, разделенной более чем на один столбец.
Установите это значение в org.apache.hudi.hive.NonPartitionedExtractor для создания неразделенной таблицы Hive.
- hoodie.index.type: по умолчанию установлено значение BLOOM, которое будет обеспечивать уникальность ключа только в пределах одного раздела. Используйте GLOBAL_BLOOM, чтобы обеспечить уникальность во всех разделах. Hudi будет сравнивать входящие записи с файлами по всему набору данных, чтобы убедиться, что ключ записи присутствует только в одном разделе. Ожидайте задержку при работе с очень большими наборами данных.
- hoodie.bloom.index.update.partition.path: Убедитесь, что для операций удаления (если используется индекс GLOBAL_BLOOM) установлено значение False.
- hoodie.datasource.hive_sync.use_jdbc: Установите это значение на False, чтобы синхронизировать таблицу с каталогом данных Glue (если требуется).
Примечание (для использования Apache Hudi с AWS Glue)
Доступный в Maven jar hudi-spark-bundle_2.11-0.5.3.jar не будет работать с AWS Glue в исходном виде. Вместо этого необходимо создать собственный jar, изменив исходный pom.xml.
1. Загрузите и обновите содержимое pom.xml.
a) Удалите из тега <includes> следующую строку:
<include>org.apache.httpcomponents:httpclient</include>
b) В тег <relocations>добавьте следующие строки:
<relocation>
    <pattern>org.eclipse.jetty.</pattern>
    <shadedPattern>org.apache.hudi.org.eclipse.jetty.</shadedPattern>
</relocation>
2. Создайте JAR:
mvn clean package -DskipTests –DskipITs
JAR, созданный с помощью приведенной выше команды (расположенный в файле «target/hudi-spark-bundle_2.11-0.5.3.jar», где была выполнена команда), можно передать в качестве параметра задания Glue.
После выполнения этих трех шагов озеро данных готово к использованию. Данные можно получить из Raw S3 с помощью одного из методов запросов, доступных через API Apache Hudi, о которых говорилось выше.
Заключение
Результат решения успешно решает задачи, стоящие перед традиционными озерами данных:
- CDC на основе журнала - это более надежный механизм захвата транзакций/событий базы данных.
- Apache Hudi берет на себя ответственность (ранее принадлежавшую владельцам платформ данных) за обновление целевых данных в хранилище данных путем управления индексами и соответствующими метаданными, необходимыми для гидратации хранилища данных в масштабе.
- Поддержка транзакций ACID устраняет проблемы, связанные с одновременными операциями, поскольку API Apache Hudi могут обрабатывать несколько читателей и писателей без получения противоречивых результатов.
По мере того как все больше предприятий внедряют платформы данных и расширяют свои возможности по анализу данных/машинному обучению, важность базовых инструментов и пайплайнов CDC, обслуживающих данные, должна возрастать, чтобы решать некоторые из наиболее часто встречающихся проблем. Улучшение масштабируемости, задержки данных и общего качества данных, доставляемых конечным потребителям, показывает, что парадигма «Data Lakehouse» - это следующее поколение платформ данных. Она станет основой, благодаря которой предприятия будут извлекать из своих данных больше пользы и смысла.


