

Освоение формата открытых таблиц: подробное руководство по Apache Iceberg, Hudi и Delta Lake
Раскрытие широких возможностей форматов открытых таблиц: Apache Iceberg, Hudi и Delta Lake специально для масштабируемого и надежного управления данными
В эпоху больших данных эффективное управление большими массивами данных стало ключевой проблемой для организаций всех отраслей. Инженеры и аналитики данных ежедневно имеют дело с огромными объемами информации, и чтобы извлечь из них максимальную пользу, они полагаются исключительно на структурированные форматы хранения, которые обеспечивают беспрепятственное управление данными, их обработку и аналитику. Традиционные архитектуры озер данных обеспечивают основу для хранения необработанных данных, однако они сопряжены с такими проблемами, как отсутствие согласованности, сложности с контролем версий и недостаточная производительность.
Со временем появились форматы открытых таблиц - набор технологий, призванных решить многие из этих проблем, обеспечивая структуру, управление и повышение производительности поверх традиционных озер данных. В этой статье мы рассмотрим основы форматов открытых таблиц и сосредоточимся на трех наиболее популярных фреймворках: Apache Iceberg, Apache Hudi и Delta Lake.
Что такое формат открытых таблиц?
Открытые таблицы - это системы управления большими массивами данных в распределенных хранилищах, обеспечивающие уровень абстракции, позволяющий осуществлять транзакции, эволюцию схем и эффективное управление данными. Они располагаются поверх данных, хранящихся в облачных объектных хранилищах, таких как Amazon S3, Google Cloud Storage или Hadoop Distributed File System (HDFS). Вместо того чтобы просто хранить файлы и каталоги, эти форматы вводят такие понятия, как таблицы, схемы и разделы, что упрощает запросы и управление данными.
Они называются «открытыми», потому что построены на принципах открытого исходного кода, что обеспечивает их совместимость с различными инструментами и платформами.
Предлагаю рассмотреть три основных формата открытых таблиц:
- Apache Iceberg (Apache Foundation)
- Apache Hudi (Apache Foundation)
- Delta Lake (Linux Foundation)

Почему именно формат открытых таблиц?
Хотя традиционные озера данных идеально подходят для хранения неструктурированных данных, у них есть ряд серьезных недостатков:
- Отсутствие ACID-транзакций: Традиционные озера данных не поддерживают транзакции, что приводит к повреждению данных и непоследовательным чтениям, когда несколько заданий обращаются к одним и тем же данным.
- Управление схемами: По мере эволюции данных меняются схемы. Озера данных не поддерживают эволюцию схем, что затрудняет внесение изменений без обширной переработки.
- Производительность: Запрос данных, хранящихся в необработанных форматах, таких как CSV, Parquet или ORC, часто приводит к неоптимальной производительности, особенно если данные распределены по разным разделам.
Для решения этих задач был введен формат открытых таблиц, обладающий следующими характеристиками:
- Соответствие стандарту ACID: Обеспечивает надежное транзакционное обновление данных.
- Эволюция схемы: Позволяет вносить динамические изменения в схему без нарушения последующих процессов.
- Путешествие во времени: Возможность запрашивать исторические версии данных.
- Эффективное управление данными: Открытые форматы таблиц предназначены для работы с огромными массивами данных, обеспечивая при этом эффективное чтение и запись.
1. Apache Iceberg
Apache Iceberg был создан Netflix для решения проблем управления огромными массивами данных в облачных объектных хранилищах. Предназначен для создания высокопроизводительного, масштабируемого формата таблиц с поддержкой ACID-транзакций и эволюции схемы.
Ключевые характеристики:
- ACID Транзакции: Обеспечивает целостность данных с помощью атомарных операций.
- Эволюция разделов: Поддерживает изменение стратегий разбиения без переписывания всего набора данных.
- Эволюция схемы: Позволяет добавлять, удалять или обновлять столбцы без необходимости переписывать данные.
- Скрытое разбиение: Автоматически оптимизирует разбиение на разделы для повышения производительности, не обременяя пользователей ручным определением разделов.
- Путешествие во времени: Позволяет пользователям получать доступ к предыдущим версиям таблицы для отладки или аудита.
Iceberg использует подход, основанный на манифестах, где каждый снимок таблицы указывает на описание файлов данных. Это позволяет Iceberg управлять изменениями, не требуя постоянной перезаписи.
Дополнительная литература для более глубокого изучения Iceberg:
- Официальная документация
- Интеграция с Apache Spark
- Чтения дельта-таблиц из клиента Iceberg (для Databricks)
- Интеграция со Snowflake
Примеры использования из реальной жизни:
- Крупномасштабные озера данных: Идеально подходит для организаций, работающих с огромными массивами данных, таких как компании, занимающиеся потоковой передачей медиаданных, например Netflix. Масштабируемость Apache Iceberg и функции эволюции разделов делают его подходящим для управления и запроса больших объемов структурированных и полуструктурированных данных. Согласно технологическому блогу Netflix, Iceberg был разработан с учетом всех уникальных требований их хранилища данных, поддерживая масштабируемость и оптимизированный доступ к данным для крупномасштабной аналитики.
- Сценарии высокой надежности: Подходит для приложений, требующих строгой целостности и непротиворечивости данных, с поддержкой транзакций ACID. Транзакционные возможности Iceberg обеспечивают надежное обновление и последовательное чтение данных, что делает его идеальным для отраслей с нормативными требованиями и требованиями к соответствию данных, таких как финансы или здравоохранение. «Поддержка транзакций ACID и эволюция схемы в Iceberg позволяет компаниям обеспечивать согласованность и целостность данных в самых сложных средах», - подчеркивается в официальной документации Apache Iceberg .
- Масштабируемое долговременное хранилище с управлением: Лучше всего подходит для сред, требующих одновременно масштабируемости и надежного управления данными, таких как электронная коммерция или розничная торговля. Поддержка эволюции схем и разделов Iceberg позволяет организациям адаптироваться к изменяющимся требованиям к данным без дорогостоящего переписывания, обеспечивая эффективное управление данными в соответствии с требованиями времени. В блоге AWS Big Data Blog отмечается, что структура Iceberg делает его совместимым с S3 и другими облачными хранилищами, обеспечивая гибкость для компаний, управляющих данными в гибридных облачных средах.
2. Apache Hudi
Apache Hudi (Hadoop Upsert Delete and Incremental) был создан компанией Uber для поддержки быстро меняющихся данных с инкрементными потоками данных. Он в значительной степени ориентирован на случаи использования, связанные с обновлениями с низкой задержкой и транзакционными данными, что делает его отличным выбором для сред, в которых данные постоянно меняются, например, в потоковой передаче или аналитике в режиме реального времени.
Ключевые характеристики:
- Upsert и Delete: Поддерживает обновление и удаление записей без необходимости переписывать целые разделы.
- Инкрементные запросы: Обеспечивает поддержку запросов только к тем данным, которые изменились с момента последнего запроса (инкрементные запросы), что позволяет сократить объем данных, которые необходимо прочитать.
- ACID-транзакции: Как и Iceberg, Hudi поддерживает ACID-транзакции, гарантирующие согласованность данных.
- Индексирование: Hudi строит индексы, чтобы ускорить процесс поиска записей при вставке или удалении.
Типы таблиц Hudi:
- Copy-on-Write (COW): Режим по умолчанию, при котором обновления записываются в новые файлы Parquet.
- Merge-on-Read (MOR): Данные сначала записываются в файлы журнала, а затем лениво объединяются при чтении.
Дополнительная литература для более глубокого изучения Hudi:
- Cтруктура и концепты Hudi (стек Hudi)
- Быстрое начало работы с Apache Spark или интеграция Apache Spark с Hudi
- Быстрое начало работы с Apache Flink или интеграция Apache Flink с Hudi
Примеры использования из реальной жизни:
- Получение и обработка данных в режиме реального времени: Apache Hudi разработан для сценариев, в которых данные постоянно меняются и должны обновляться практически в режиме реального времени. «Hudi предлагает уникальный подход к управлению и обработке данных в реальном времени, особенно подходящий для высокоскоростных конвейеров данных», - говорится в блоге Uber.
- Инкрементные пайплайны: Благодаря способности Hudi отслеживать и обрабатывать только изменения в данных (инкрементные запросы), это оптимальный выбор для инкрементных рабочих процессов ETL (Extract, Transform, Load). Как объясняется в документации проекта Apache Hudi, «инкрементные запросы позволяют более эффективно обрабатывать данные, фокусируясь только на обновленных записях, что значительно сокращает объемы чтения при работе с озерами данных». (документация Аpache Hudi).
- Частые Upsert и Delete: Для таких отраслей, как логистика и финансы, где записи нуждаются в постоянном обновлении, функциональность upsert в Hudi имеет очень большое значение. «Способность добавлять записи без необходимости переписывания целых разделов делает Hudi отличным вариантом для сред, нуждающихся в частых обновлениях», - говорится в статье Uber, посвященной теме создания крупного транзакционного озера данных, где обсуждается эффективность Hudi в управлении изменчивыми данными в озерах данных.
3. Delta Lake
Разработанный компанией Databricks, Delta Lake - это проект с открытым исходным кодом, который обеспечивает надежность озер данных, добавляя поддержку транзакций ACID и управление схемами поверх Apache Spark и облачных решений для хранения данных. Delta Lake ориентирован на обеспечение надежных, масштабируемых конвейеров данных с акцентом на высокую производительность.
Ключевые характеристики:
- ACID Транзакции: Delta Lake поддерживает ACID транзакции, обеспечивая надежную запись пакетных и потоковых данных. Вот замечательная статья, посвященная ACID транзакциям, проводимым с помощью Delta Lake.
- Применение и эволюция схемы: Delta обеспечивает соблюдение схемы во время записи, гарантируя, что записываются только данные, соответствующие схеме. Кроме того, она позволяет эволюционировать схему, облегчая добавление или изменение полей с течением времени.
- Путешествие во времени: Как и Iceberg, Delta Lake поддерживает запросы к предыдущим версиям данных, что облегчает аудит и отладку.
- Унифицированная пакетная и потоковая обработка: Delta Lake позволяет обрабатывать пакетные и потоковые данные в одном конвейере, унифицируя эти два типа обработки.
- Z-упорядочивание: Для повышения производительности запросов Delta Lake поддерживает оптимизацию расположения данных с помощью Z-упорядочивания, что обеспечивает эффективный доступ к часто запрашиваемым столбцам.
Примеры использования из реальной жизни:
- Высокопроизводительные озера данных для аналитики: Функции оптимизации Delta Lake, такие как Z-упорядочивание и оптимизация расположения данных, значительно повышают производительность запросов, что делает их идеальными для приложений, ориентированных на аналитику. Например, Adobe Experience Platform использует Delta Lake для управления петабайтами данных, обеспечивая эффективную обработку данных и аналитику. Delta
- Масштабируемые конвейеры данных: Delta Lake поддерживает как пакетные, так и потоковые данные в едином конвейере, позволяя организациям беспрепятственно обрабатывать большие массивы данных. Команда T-Mobile по науке о данных и аналитике перешла на архитектуру на базе Delta Lake, чтобы справиться с возросшими объемами и сложностью данных, что привело к улучшению масштабируемости и производительности. Delta
- Унифицированная пакетная и потоковая обработка данных: Delta Lake позволяет организациям управлять как пакетными, так и потоковыми рабочими нагрузками в рамках одной системы, обеспечивая целостный подход к обработке данных. Эта возможность важна для таких отраслей, как финансы и розничная торговля, где понимание в реальном времени и актуальные данные имеют решающее значение для принятия решений и повышения эффективности работы. Databricks
Дополнительная литература для более глубокого изучения Delta:
- Начало работы с форматом Delta Lake (по умолчанию - с Apache Spark)
- Операции CRUD с помощью Delta Lake в Databricks
- Дополнительные учебные материалы
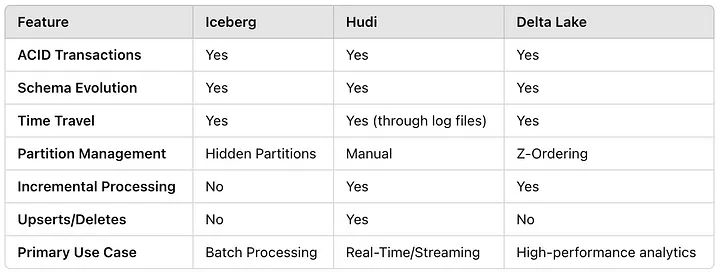
Сравнение: Iceberg vs. Hudi vs. Delta Lake
Заключение
Форматы открытых таблиц, такие как Apache Iceberg, Apache Hudi и Delta Lake, представляют собой будущее управления данными в облаке. Предоставляя инструменты, необходимые для управления большими массивами данных с ACID-транзакциями, эволюцией схем и перемещением во времени, они обеспечивают улучшение структуры и производительности озер данных. Каждая система разработана с учетом конкретных сценариев использования, выбор формата зависит от конкретных потребностей каждой организации.
Если Вам нужна масштабируемость с богатыми возможностями управления, идеальным вариантом может стать Iceberg. Если Вы хотите обрабатывать данные в реальном времени с помощью инкрементных запросов, то выберите Hudi. А если Вы создаете высокопроизводительный пайплайн для аналитики с помощью Spark, то Delta Lake - это именно Ваш вариант.
Правильный выбор формата открытых таблиц может значительно упростить архитектуру данных, уменьшить технический долг и обеспечить производительность и масштабируемость, необходимые Вашей организации для процветания в эпоху Big Data.


