

Data Vault 2.0: Передовая методология построения гибких и масштабируемых хранилищ данных. Полное руководство по внедрению от экспертов
В современном мире данные становятся ключевым активом бизнеса, а требования к их объему, скорости обработки и гибкости стремительно растут. Устаревшие подходы к моделированию данных зачастую не справляются с этими вызовами, приводя к дорогостоящим редизайнам, потере историчности и неспособности оперативно реагировать на изменения бизнес-требований.
В этом материале мы подробно расскажем о методологии Data Vault 2.0 — современном стандарте построения хранилищ данных, который мы успешно применяем в проектах для наших клиентов. Мы не только разберем ключевые принципы и архитектуру, но и на практическом примере покажем процесс внедрения, укажем на частые ошибки и поделимся рекомендациями, которые сэкономят вам время и ресурсы.
Почему именно Data Vault 2.0? Эволюция подходов к моделированию данных
Исторически сложилось так, что для построения витрин данных и систем аналитики доминирующей методологией была схема «звезда» (или ее более нормализованная версия — «снежинка»). Этот подход, популярный в 80-90-х годах, хорошо подходит для стабильных бизнес-процессов с предсказуемыми запросами. Однако его ключевые недостатки становятся критичными в современных условиях.
Во-первых, это низкая гибкость - любое изменение бизнес-требований или добавление нового источника данных зачастую требует полного перепроектирования модели и ETL-процессов.
Во-вторых, это проблемы с историчностью - реализация медленно меняющихся измерений (SCD) сложна в поддержке и часто leads к ошибкам в данных.
В – третьих, это сложность интеграции - объединение данных из разнородных источников в рамках «звезды» — нетривиальная задача.
Data Vault 1.0, представленный Дэном Линстедтом в конце 1990-х, стал ответом на эти вызовы. Он предложил архитектуру «ступица и спицы» (hub-and-spoke), разделяя данные на три основных типа таблиц: хабы (Hubs), ссылки (Links) и спутники (Satellites). Это обеспечило лучшую гибкость и способность хранить историю.
Однако настоящую революцию произвел Data Vault 2.0, представленный в 2013 году. Его ключевые усовершенствования:
- Использование хэш-ключей: вместо последовательных суррогатных ключей (Sequence) теперь используются детерминированные хэши (например, MD5 или SHA-256) на основе бизнес-ключей. Это позволяет загружать данные параллельно, а не последовательно, так как исчезает необходимость ждать генерации ключей. Кроме того, можно упростить ETL-процессы и сделать их идемпотентными (повторное выполнение процесса с теми же данными дает тот же результат). И, наконец, можно достаточно легко выявлять изменения на уровне данных.
- Четкое разделение слоев: появилось разделение на Raw Vault (сырые, неизмененные данные) и Business Vault (данные, обогащенные бизнес-правилами).
- Стандартизация: были введены строгие стандарты именования, моделирования, загрузки и документации, что повысило согласованность и предсказуемость архитектуры.
- Поддержка реального времени и Big Data: методология была адаптирована для работы с потоковой обработкой данных и интеграции с NoSQL-хранилищами.
Важно отметить, что принципы Data Vault — модульность, гибкость и масштабируемость — идеально созвучны современным DevOps-практикам, микросервисной архитектуре и Domain Driven Design (DDD). Это делает Data Vault 2.0 идеальным выбором для сложных, быстро развивающихся digital-компаний.
Архитектура Data Vault 2.0: Трехуровневый подход
Архитектура Data Vault 2.0 строится на трех четко разделенных слоях, каждый из которых выполняет свою специфическую функцию.

Во-первых, это стейджинг (Staging) / ODS (Operational Data Store). Этот слой предназначен для первоначального приема данных из систем-источников. Данные здесь хранятся в том же виде, в каком они были получены, подвергаясь лишь минимальной очистке и дедубликации. Главная цель — быть «буфером» и обеспечить возможность повторной загрузки данных в случае сбоя.
Во-вторых, это Raw Vault. Это ядро хранилища, смоделированное strictly в соответствии с принципами Data Vault 2.0. Здесь данные разложены на Хабы, Ссылки и Спутники без каких-либо преобразований. Этот слой содержит полную историю всех изменений и является «единым источником правды». Его главная цель — сохранность и целостность данных.
И, наконец, это Business Vault и Data Marts. На этом слое данные из Raw Vault преобразуются, очищаются и обогащаются согласно бизнес-логике. Здесь же создаются ориентированные на конкретные бизнес-задачи витрины данных, часто в виде знакомых и производительных «звездных» схем. Его главная цель — эффективность анализа и предоставление данных конечным пользователям в удобной для них форме.
Такой подход обеспечивает надежность (данные в Raw Vault никогда не перезаписываются) и гибкость (изменения в бизнес-требованиях требуют доработок только на уровне Business Vault и Data Marts, оставляя ядро нетронутым).
Ключевые сущности Data Vault 2.0: Хабы, Ссылки, Спутники
Давайте детально разберем основные строительные блоки модели.
Хабы (Hubs)
Хаб — это фундаментальная сущность, которая представляет собой ключевой бизнес-концепт (например, Клиент, Продукт, Заказ).
Его структуру можно описать следующим образом:
- HK_[Entity]_Key: Хэш-ключ, вычисляемый на основе бизнес-ключа. Является первичным ключом хаба.
-
BK_[Entity]_Key: Сам бизнес-ключ (например,
CustomerIDиз CRM илиArticleNumberиз ERP). - Load_DTS: Метка времени загрузки записи.
- Record_Source: Источник данных (например, «CRM_Salesforce»).
К критериям выделения в первую очередь стоит отнести уникальность и стабильность. Бизнес-ключ должен однозначно идентифицировать сущность и по возможности не меняться со временем. Кроме того, это бизнес-значимость - хаб должен представлять объект, критически важный для бизнес-процессов. И, наконец, это правильная гранулярность. Все бизнес-ключи в одном хабе должны быть на одном уровне детализации (не смешивать, например, клиентов-физлиц и клиентов-юридических лиц в одном хабе без признака типа).
Самая распрстраненная ошибка - создание хаба для каждого нового поля из источника без анализа его бизнес-смысла. Это leads к «раздуванию» модели и ее сложности.
Ссылки (Links)
Ссылка представляет собой связь между двумя или более хабами. Она моделирует бизнес-транзакцию или событие (например, «Заказ содержит Товар»).
Структуру ссылки можно описать следующим образом:
- HK_Link_[Description]_Key: Хэш-ключ ссылки, обычно вычисляемый на основе хэш-ключей связанных хабов.
- HK_Hub1_Key, HK_Hub2_Key, ...: Внешние ключи на соответствующие хабы.
- Load_DTS, Record_Source.
Ключевая особенность состоит в том, что все связи в Data Vault по умолчанию моделируются как «многие-ко-многим». Это обеспечивает максимальную гибкость. Даже если сегодня отношение «один-ко-многим» (например, один Заказ — много Товаров), завтра бизнес-правила могут измениться.
Самая частая ошибка состоит в попытке добавить в ссылку описательные атрибуты (например, количество товара в заказе). Это нарушает нормализацию! Все атрибуты должны быть вынесены в спутник к ссылке.
Спутники (Satellites)
Спутник хранит все исторически изменяемые описательные атрибуты хаба или ссылки. Именно в спутниках реализуется механизм медленно меняющихся измерений типа 2 (SCD2).
Структура спутника:
- HK_Parent_Key: Хэш-ключ родительского хаба или ссылки.
- Load_DTS: Метка времени, когда эта версия атрибутов стала актуальной.
- Hash_Diff: Хэш, вычисленный от всех атрибутов спутника. Нужен для быстрого сравнения, изменились ли данные с момента последней загрузки.
-
[Атрибуты]: Непосредственно данные (e.g.,
Customer_Name,Product_Price). - Load_End_DTS: Метка времени, когда версия перестала быть актуальной (для актуальной версии равна NULL).
Для оптимизации производительности и управления данными спутники рекомендуется разделять по источнику данных (данные из разных систем (CRM, ERP) хранить в разных спутниках), а также по частоте изменений - атрибуты, которые меняются часто (например, баланс счета), и атрибуты, которые меняются редко (например, дата рождения клиента), следует выносить в разные спутники. Это позволяет избежать избыточного чтения данных при обновлении часто меняющихся атрибутов.
Критическая ошибка в данном случае состоит в объединении в одном спутнике атрибутов с кардинально разной скоростью изменения. Это приводит к огромному количеству ненужных версий и раздуванию таблицы.
Практический пример: построение хранилища для интернет-магазина на основе AdventureWorks
Рассмотрим реализацию на примере классической учебной базы данных AdventureWorks, которая моделирует деятельность компании, продающей велосипеды и экипировку.
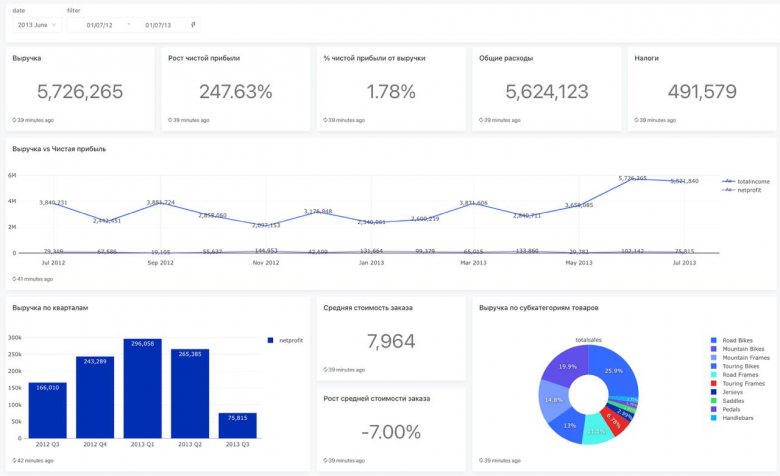
Нам нужно построить дашборд для анализа продаж с метриками: выручка, прибыль, средний чек, динамика продаж по категориям.
Шаг 1: Выделение сущностей из источников
Анализируем исходные таблицы (Sales.SalesOrderHeader, Sales.SalesOrderDetail, Production.Product и др.) и выделяем ключевые бизнес-концепты. Находим бизнес-ключи:
- SalesOrderID — уникальный номер заказа.
- ProductID — уникальный номер товара.
- CustomerID — уникальный номер клиента.
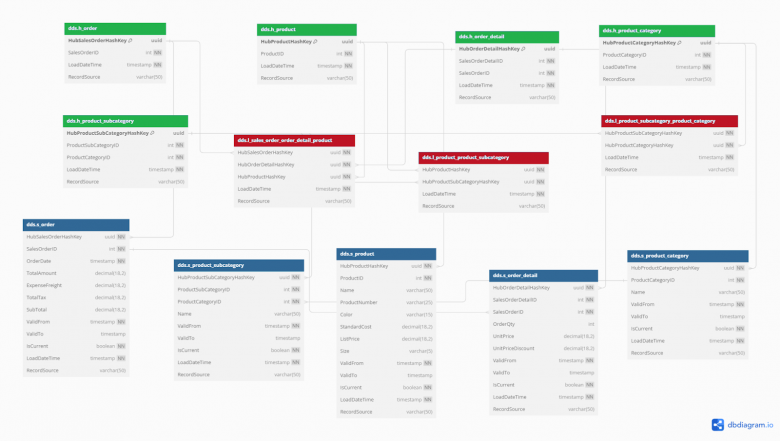
Шаг 2: Создание Raw Vault
Хабы:
-
HUB_ORDER(Бизнес-ключ:SalesOrderID) -
HUB_PRODUCT(Бизнес-ключ:ProductID) -
HUB_CUSTOMER(Бизнес-ключ:CustomerID)
Ссылки:
-
LINK_ORDER_PRODUCT(Связывает хабыHUB_ORDERиHUB_PRODUCT. Ее бизнес-ключ — комбинацияSalesOrderIDиProductID).
Спутники:
-
SAT_ORDER_DETAILS(кHUB_ORDER): атрибуты заказа —OrderDate,SubTotal,TaxAmt,Freight. -
SAT_ORDER_PRODUCT_DETAILS(кLINK_ORDER_PRODUCT): атрибуты позиции в заказе —OrderQty,UnitPrice,UnitPriceDiscount. Обратите внимание: количество и цена относятся не к самому товару, а к конкретной позиции в заказе, поэтому это спутник к ссылке! -
SAT_PRODUCT_DETAILS(кHUB_PRODUCT): атрибуты товара —Name,ProductNumber,Color,ListPrice.
На этом этапе мы получили Raw Vault, который уже содержит полную историю всех заказов, изменений цен товаров и т.д.
Шаг 3: Построение Data Mart (витрины данных)
Прямые запросы к Raw Vault сложны из-за большого количества джойнов. Поэтому поверх него мы строим витрину в виде схемы «звезда» для анализа продаж.
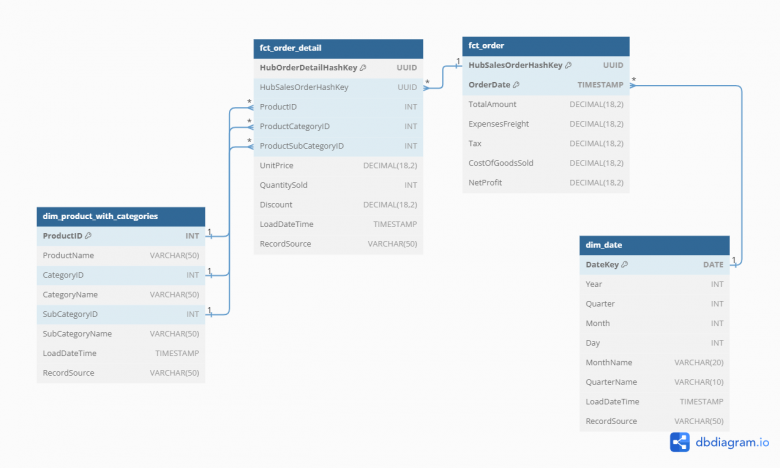
Таблица фактов FACT_SALES создается на основе ссылки LINK_ORDER_PRODUCT и ее спутника. Она содержит метрики: SalesAmount = OrderQty * UnitPrice * (1 - UnitPriceDiscount), TaxAmt, Freight.
Таблицы измерений:
-
DIM_DATE(изOrderDate). -
DIM_PRODUCT(данные изHUB_PRODUCTиSAT_PRODUCT_DETAILS). -
DIM_CUSTOMER(данные изHUB_CUSTOMERи его спутников).
Именно к этой витрине будет подключен наш BI-инструмент (Tableau, Power BI), что обеспечит высокую скорость выполнения запросов и простоту для аналитиков.
Дашборд, построенный на аналитическом слое Information Mart:
Риски, ошибки и наши рекомендации
Внедрение Data Vault — это инвестиция в будущее ваших данных. Чтобы она окупилась, важно избежать следующих распространенных ошибок.
Во-первых, это отсутствие единых стандартов. Разные члены команды называют сущности по-разному, используют разные алгоритмы хэширования, что приводит к хаосу и несогласованности данных. Решение состоит в разработке и внедрении четких, документированных стандартов именования и разработки до начала проекта.
Во-вторых, это неправильный выбор бизнес-ключа. Выбор нестабильного или не уникального ключа (например, телефон или email клиента) ведет к потере целостности данных. Решение - тщательный анализ источников и тесное взаимодействие с бизнес-экспертами для идентификации по-настоящему уникальных и стабильных идентификаторов.
В-третьих, это создание «монолитных» спутников. Помещение всех атрибутов в один спутник убивает производительность на уровне Raw Vault. Возможное решение состоит в строгом следовании принципам разделения спутников по источнику и частоте изменений.
В – четвертых, это попытка сразу сделать идеально. Долгое проектирование «всего и сразу» без получения быстрых побед демотивирует команду и бизнес. Поэтому мы применяем Agile-подход к внедрению Data Vault: начинаем с одного-двух ключевых источников, показываем работающий прототип витрины, получаем обратную связь и iteratively развиваем хранилище.
И, наконец, игнорирование метадaнных и Data Lineage. Риск - потеря контроля над происхождением данных, сложность отладки ETL-процессов. Мы используем современные инструменты (например, Apache Atlas, OpenLineage) и практики для автоматического сбора метаданных и построения карты движения данных от источника до витрины.
Внедрение Data Vault 2.0 — это не просто набор технических задач, это стратегическая инициатива по преобразованию данных в ценный актив.


