

Внедрение методологии Data Vault на Greenplum с использованием DBT
Data Vault — это методология моделирования данных, предназначенная для построения гибких, масштабируемых и аудируемых хранилищ данных предприятия. Ее ключевое преимущество — способность легко адаптироваться к изменениям в бизнес-процессах и источниках данных без необходимости дорогостоящих редизайнов.
Основу методологии составляют три типа сущностей.
Хабы cодержат только информацию о уникальных бизнес-сущностях. Это ядро данных. Хаб хранит исключительно первичный ключ (суррогатный хэш) и один или несколько бизнес-ключей (натуральных ключей), а также технические метаданные.
Например, хаб HUB_PRODUCT может содержать поля PRODUCT_PK (уникальный хэш-ключ) и PRODUCT_ID (бизнес-ключ из源系统).
Спутники хранят все описательные атрибуты и исторические изменения сущностей. Каждый спутник привязан к одному хабу или линку и содержит всю историю изменений его атрибутов по типу SCD2 (Slowly Changing Dimensions Type 2).
Например, спутник SAT_PRODUCT_DETAILS, привязанный к HUB_PRODUCT, может хранить историю изменений названия товара, его категории, цены с указанием периодов действительности каждой версии.
Связи отражают связи между сущностями (хабами). По сути, это многие-ко-многим между хабами, которые также могут иметь собственную бизнес-логику и временные метки.
Например, линк LINK_ORDER_PRODUCT связывает хаб HUB_ORDER (заказы) и хаб HUB_PRODUCT (товары), фиксируя, какие товары входили в какие заказы.
Такой подход обеспечивает высочайшую степень гибкости. Новые источники данных или изменения в существующих интегрируются путем добавления новых спутников или линков, без перестройки всей модели.
Рассмотрим пример: мы хотим хранить информацию о запусках рекламных кампаний, у нас есть информация о том, когда клиенты запускали кампанию и для каких именно товаров. Как в этом случае будет выглядеть ER диаграмма?
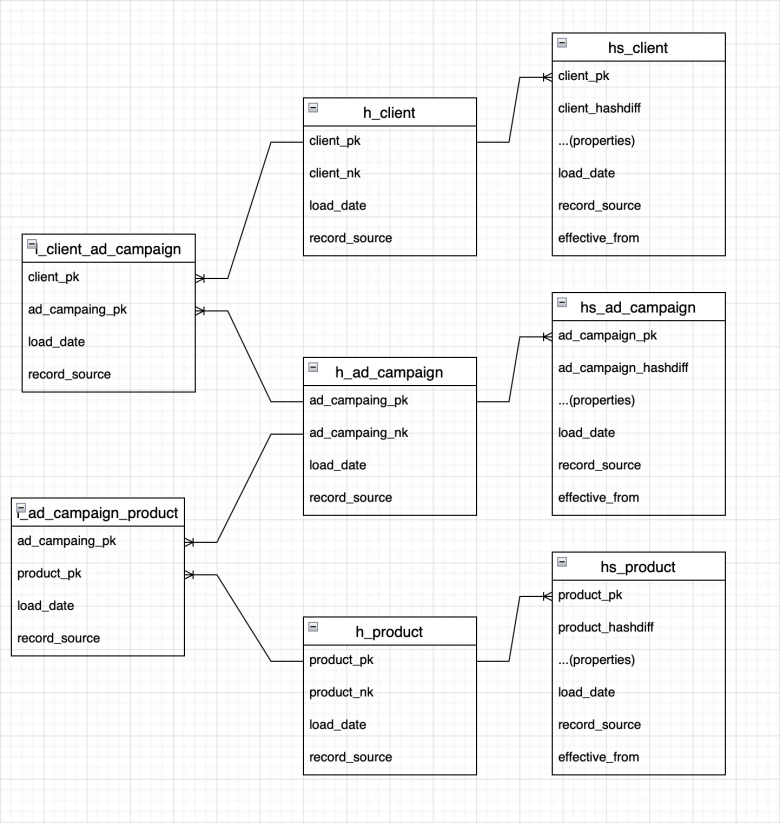
В сателлитах есть поле effective_from и <entity>_hashdiff, благодаря которому в DavaVault реализуется SCD2, что дает возможность реализовывать “версионность” данных.
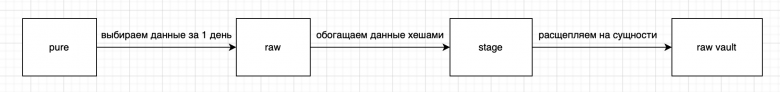
Из внешних источников данных мы загружаем историю покупок в таблицу pure.pure_transactions на Greenplum и хотим преобразовать ее в структуру Data VaultПреобразование происходит в 3 этапа:
- Сначала необходимо подготовить таблицу с данными, которые будут загружаться;
- Далее необходимо обогатить данные всеми хешами;
- И затем необходимо расщепить данные на сущности.
pure.pure_transactions описывает историю покупок пользователей с метаинформацией. Рассмотрим подробнее следующие поля:
- id транзакции(transaction_id);
- дата транзакции(transaction_date);
- цена товара(price);
- количество купленного товара(quantity);
- наименование товара(product_name);
- id категории товара(cat_id);
Выделим из этих данных 2 сущности:
- транзакция или строчка в чеке (transaction_id);
- товар (product_name);
Технологический стек: почему именно DBT и Greenplum?
DBT (Data Build Tool) — это фреймворк, который позволяет инженерам данных преобразовывать данные в хранилище с помощью операторов SQL, применяя лучшие практики разработки ПО: модульность, тестирование, версионирование и документацию. DBT не перемещает данные, а компилирует SQL-код, который выполняется в вашей базе данных. Он идеально подходит для реализации ETL-процедур для Data Vault, так как позволяет организовать код в переиспользуемые макросы и модели.
Greenplum — это массово-параллельная колоночная СУБД с открытым исходным кодом, основанная на PostgreSQL. Она предназначена для анализа больших объемов данных. Ее ключевые особенности – это, в первую очередь, массовый параллелизм (данные автоматически распределяются по сегментам (шардам) на основе ключа дистрибуции), колоночное хранение (оптимизировано для агрегирующих запросов, typical для витрин данных и аналитики.), высокая степень сжатия (колоночное хранение позволяет достичь высоких коэффициентов сжатия) и, наконец, совместимость с PostgreSQL (поддерживает почти весь SQL-синтаксис и функции Postgres, что упрощает разработку).
Сочетание DBT и Greenplum создает мощный синергетический эффект: DBT предоставляет структуру и организацию кода, а Greenplum — производительность и масштабируемость для обработки больших данных.
Одной из первых задач, которую нам пришлось решить, стала адаптация DBT для полноценной работы с Greenplum. Хотя Greenplum и основан на PostgreSQL, стандартный адаптер dbt-postgres не поддерживает всех его специфичных возможностей, критически важных для производительности.
Мы разработали и внесли вклад в open-source сообщество — специальный адаптер dbt-greenplum. Его ключевые особенности:
Функциональность адаптера
Особенность Greenplum — возможность указать поле дистрибьюции. По нему Greenplum будет “раскладывать” данные по сегментам:
{{
    config(
                                                               ...
        distributed_by='<field_name>'
                                                               ...
    )
}}
Сжатие и колоночная ориентация
Greenplum предназначен для работы с Big Data, уменьшение времени на чтение/запись за счет сжатия является значительным фактором. В dbt, это можно имплементировать следующим образом:
{{
    config(
        ...
        appendonly='true',
        orientation='column',
        compresstype='ZSTD',
        compresslevel=4,
        blocksize=32768
                                                               ...
    )
}}
Партиционирование
Для таблиц с миллиардами строк (например, фактовых продаж) партиционирование по дате — необходимость. Оно позволяет отсекать огромные объемы данных на уровне физического чтения. Реализация в нашем адаптере:
{% set fields_string %}
     id int4 null,
     incomingdate timestamp NULL
{% endset %}
{% set raw_partition %}
    PARTITION BY RANGE (incomingdate)
    (
        START ('2021-01-01'::timestamp) INCLUSIVE
        END ('2023-01-01'::timestamp) EXCLUSIVE
        EVERY (INTERVAL '1 day'),
        DEFAULT PARTITION extra
    );
{% endset %}
{{
    config(
                                                               ...
        fields_string=fields_string,
        raw_partition=raw_partition,
        default_partition_name='other_data'
                                                               ...
    )
}}
Это позволяет создавать ежедневные партиции, что значительно ускоряет загрузку новых данных и удаление устаревших.
Практическая реализация: пошаговое построение Data Vault
Рассмотрим реализацию на примере хранения данных о транзакциях (покупках). Исходные данные находятся в таблице pure.pure_transactions и содержат поля: transaction_id, transaction_date, price, quantity, product_name, cat_id.
В первую очередь мы загружаем и очищаем данные за определенный период (например, за день). Важный шаг — дедупликация на уровне источника.
{{
    config(
        schema='raw',
        materialized='table'
    )
}}
with transaction_day_dedup as (
                               select * from (
                                               select *,
                                                                  row_number() over (
                                                                                 partition by pa."transaction_id"
                                              order by pa."savetime" asc
                                          ) as rn
                                               from {{ source('pure', 'pure_transactions') }} pa
                                               where
                                                               '{{ var('raw_transactions')['start_date'] }}' <= transaction_date
                                                               and
                                                               transaction_date < '{{ var('raw_transactions')['end_date'] }}'
                               ) as h
                               where rn = 1
                )
select
                               "transaction_id" as transaction_id,
                               "transaction_date" as transaction_date,
                               "price" as price,
                               "quantity" as quantity,
                               "product_name" as product_name,
                               "cat_id" as cat_id,
    ...
    'PURE_TRANSACTIONS' as record_source
from transaction_day_dedup ra
Важно! Ошибка, которую можно допустить - пропуск шага дедупликации. Это приведет к дубликатам на самом нижнем уровне и исказит все последующие слои данных.
В нашем случае с помощью CTE мы выбирали данные за 1 день и дедублицировали их по полю transaction_id. После запуска модели в raw.raw_transaction у нас оказались данные за 1 день, если указать следующие переменные:
var('raw_transactions')['start_date'] и
var('raw_transactions')['end_date']:
vars:
  raw_transactions:
    start_date: '2022-01-01 00:00:00.0'
    end_date: '2022-01-02 00:00:00.0'
Стадия обогащения (Staging Layer)
Здесь мы подготавливаем данные к загрузке в Data Vault: рассчитываем хэш-ключи для хабов, линков и хэши для отслеживания изменений в спутниках. Для автоматизации мы используем пакет dbtvault.
Чтобы установить необходимые зависимости, мы добавили в корень dbt файл package.yml :
packages:
  - git: "https://github.com/markporoshin/dbtvault.git"
    revision: develop
и вызвали команду:
dbt deps
Мы получили папку dbt_packages, в которой будут находиться исходники установленных пакетов.
В модели stage_transactions мы завели переменную yaml_metadata и указали поля, которые станут основой для ключей 2 типов:
Первичные ключи сущностей: хабы и линки;
HASHDIFF — хеши для отслеживания изменений, которые строятся из полей сателлита.
{{
    config(
        schema='stage',
        materialized='table',
    )
}}
{%- set yaml_metadata -%}
source_model: 'raw_transactions'
derived_columns:
  LOAD_DATE: (SAVETIME + 1 * INTERVAL '1 day')
  EFFECTIVE_FROM: 'SAVETIME'
hashed_columns:
  TRANSACTION_PK:
    - 'transaction_id'
  TRANSACTION_HASHDIFF:
    is_hashdiff: true
    columns:
      - 'price'
      - 'quantity'
      - 'transaction_date'
  PRODUCT_PK:
    - 'product_name'
  PRODUCT_HASHDIFF:
    is_hashdiff: true
    columns:
                   - 'cat_id'
  LINK_TRANSACTION_PRODUCT_PK:
    - 'transaction_id'
    - 'product_name'
               ...
{%- endset -%}
{% set metadata_dict = fromyaml(yaml_metadata) %}
{% set source_model = metadata_dict['source_model'] %}
{% set derived_columns = metadata_dict['derived_columns'] %}
{% set hashed_columns = metadata_dict['hashed_columns'] %}
{{ dbtvault.stage(include_source_columns=true,
                  source_model=source_model,
                  derived_columns=derived_columns,
                  hashed_columns=hashed_columns,
                  ranked_columns=none) }}
В результате мы получаем таблицу с рассчитанными полями TRANSACTION_PK, PRODUCT_PK, LINK_TRANSACTION_PRODUCT_PK, TRANSACTION_HASHDIFF, PRODUCT_HASHDIFF. Эти поля являются фундаментом для следующих этапов.
В данном случае основным риском является неправильный выбор полей для хэширования в HASHDIFF. Если включить не все значимые атрибуты спутника, изменения не будут фиксироваться. Если включить технические или нестабильные поля, это приведет к созданию лишних версий.
Построение Data Vault (Raw Vault Layer)
Хаб хранит только ключи сущностей.
Модель хаба product:
{{
    config(
        schema='raw_vault',
        materialized='incremental',
        distributed_by='product_pk',
    )
}}
{%- set source_model = "stage_transactions" -%}
{%- set src_pk = "product_pk" -%}
{%- set src_nk = "cleanedname" -%}
{%- set src_ldts = "load_date" -%}
{%- set src_source = "record_source" -%}
{{ config(schema='raw_vault') }}
{{ dbtvault.hub(src_pk=src_pk, src_nk=src_nk, src_ldts=src_ldts,
                src_source=src_source, source_model=source_model) }}
Вызываем макрос для генерации кода. В результате появится таблица с следующим DDL:
CREATE TABLE raw_vault.h_product (
                product_pk text NULL,
                cleanedname text NULL,
                load_date text NULL,
                record_source unknown NULL
)
WITH (
                appendonly=true,
                blocksize=32768,
                orientation=column,
                compresstype=zstd,
                compresslevel=4
)
DISTRIBUTED BY (product_pk);
Еще один пример модели хаба (для сущности «транзакция»):
{% set fields_string %}
    transaction_pk text NULL,
    load_date text NULL,
    record_source text NULL,
    transaction_id text NULL,
    transaction_date timestamp NULL
{% endset %}
{% set raw_partition %}
    PARTITION BY RANGE (transaction_date)
    (
        START ('2020-01-01'::timestamp) INCLUSIVE
        END ('2028-01-01'::timestamp) EXCLUSIVE
        EVERY (INTERVAL '1 day'),
        DEFAULT PARTITION extra
    );
{% endset %}
{{
    config(
        schema='raw_vault',
        materialized='incremental',
        compresslevel=4,
        distributed_by='transaction_pk',
        fields_string=fields_string,
        raw_partition=raw_partition
    )
}}
{%- set source_model = "stage_transactions" -%}
{%- set src_pk = "transaction_pk" -%}
{%- set src_nk = "transaction_date" -%}
{%- set src_ldts = "load_date" -%}
{%- set src_source = "record_source" -%}
{%- set src_extra = ["transaction_date"] -%}
{%- set partition_cause = "'" + var('h_transaction')['start_date'] + "' <= transaction_date and transaction_date < '" + var('h_transaction')['start_date'] + "'" -%}
{{ config(schema='raw_vault') }}
{{ dbtvault.hub(src_pk=src_pk, src_nk=src_nk, src_ldts=src_ldts,
                src_source=src_source, source_model=source_model,
                src_extra=src_extra, partition_cause=partition_cause) }}
DDL модели h_transaction:
CREATE TABLE raw_vault.h_transaction (
                transaction_pk text NULL,
                load_date text NULL,
                record_source text NULL,
                transaction_id text NULL,
                transaction_date timestamp NULL
)
WITH (
                appendonly=true,
                blocksize=32768,
                orientation=column,
                compresstype=zstd,
                compresslevel=4
)
DISTRIBUTED BY (transaction_pk)
PARTITION BY RANGE(transaction_date)
(
START ('2020-01-01 00:00:00'::timestamp without time zone) END ('2028-01-01 00:00:00'::timestamp without time zone) EVERY ('1 day'::interval) WITH (appendonly='true', blocksize='32768', orientation='column', compresstype=zstd, compresslevel='4')
          COLUMN transaction_pk ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
          COLUMN load_date ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
          COLUMN record_source ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
          COLUMN transaction_id ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
          COLUMN transaction_date ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4),
DEFAULT PARTITION extra  WITH (appendonly='true', blocksize='32768', orientation='column', compresstype=zstd, compresslevel='4')
          COLUMN transaction_pk ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
          COLUMN load_date ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
          COLUMN record_source ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
          COLUMN transaction_id ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
          COLUMN transaction_date ENCODING (blocksize=32768, compresstype=zstd, compresslevel=4)
);
Создание Спутника (Satellite)
Спутник хранит историю изменений атрибутов сущности.
{{
    config(
        schema='raw_vault',
        materialized='incremental',
        distributed_by='product_pk',
    )
}}
{%- set source_model = "stage_transactions" -%}
{%- set src_pk = "product_pk" -%}
{%- set src_hashdiff = "product_hashdiff" -%}
{%- set src_payload = ["cat_id, productname"] -%}
{%- set src_eff = "effective_from" -%}
{%- set src_ldts = "load_date" -%}
{%- set src_source = "record_source" -%}
{{ dbtvault.sat(src_pk=src_pk, src_hashdiff=src_hashdiff,
                src_payload=src_payload, src_eff=src_eff,
                src_ldts=src_ldts, src_source=src_source,
                source_model=source_model) }}
По аналогии с хабом нам потребовалось внедрить партиционирование для сателлитов:
{% set fields_string %}
                  transaction_pk text NULL,
                               transaction_id text NULL,
                               transaction_hashdiff text NULL,
                               price float4 NULL,
                               quantity float4 NULL,
                               transaction_date timestamp NULL,
                               load_date text NULL,
                               record_source text NULL
{% endset %}
{% set raw_partition %}
    PARTITION BY RANGE (transaction_date)
    (
        START ('2020-01-01'::timestamp) INCLUSIVE
        END ('2028-01-01'::timestamp) EXCLUSIVE
        EVERY (INTERVAL '1 day'),
        DEFAULT PARTITION extra
    );
{% endset %}
{{
    config(
        schema='raw_vault',
        materialized='incremental',
        compresslevel=4,
        distributed_by='transaction_pk',
        fields_string=fields_string,
        raw_partition=raw_partition
    )
}}
{%- set source_model = "stage_transactions" -%}
{%- set src_pk = "transaction_pk" -%}
{%- set src_hashdiff = "transaction_hashdiff" -%}
{%- set src_payload = [
    "price",
    "quantity",
    "itemsum",
    "transaction_id",
    "transaction_date"
] -%}
{%- set src_eff = "EFFECTIVE_FROM" -%}
{%- set src_ldts = "LOAD_DATE" -%}
{%- set src_source = "RECORD_SOURCE" -%}
{%- set partition_cause = "'" + var('hs_transaction')['start_date'] + "' <= transaction_date and transaction_date < '" + var('hs_transaction')['start_date'] + "'" -%}
{{ config(schema='raw_vault') }}
{{ dbtvault.sat(src_pk=src_pk, src_hashdiff=src_hashdiff,
                src_payload=src_payload, src_eff=src_eff,
                src_ldts=src_ldts, src_source=src_source,
                source_model=source_model, partition_cause=partition_cause) }}
Важное замечание: В чистом Data Vault спутники не партиционируются. Однако на практике, при миллиардах строк, мы отступили от канонической методологии и добавили партиционирование к некоторым спутникам и линкам по дате транзакции. Это критически важная оптимизация для Greenplum, позволившая сократить время обработки с часов до минут. Это компромисс между чистотой архитектуры и производительностью.
Создание Связи (Link)
Линк соединяет сущности между собой.
{% set fields_string %}
    link_transaction_product_pk text NULL,
    transaction_pk text NULL,
    product_pk text NULL,
    load_date text NULL,
    record_source text NULL,
    transaction_date timestamp NULL
{% endset %}
{% set raw_partition %}
    PARTITION BY RANGE (transaction_date)
    (
        START ('2020-01-01'::timestamp) INCLUSIVE
        END ('2028-01-01'::timestamp) EXCLUSIVE
        EVERY (INTERVAL '1 day'),
        DEFAULT PARTITION extra
    );
{% endset %}
{{
    config(
        schema='raw_vault',
        materialized='incremental',
        compresslevel=4,
        distributed_by='link_transaction_product_pk',
        fields_string=fields_string,
        raw_partition=raw_partition
    )
}}
{%- set source_model = "stage_transactions" -%}
{%- set src_pk = "link_transaction_product_pk" -%}
{%- set src_fk = ["transaction_pk", "product_pk"] -%}
{%- set src_ldts = "load_date" -%}
{%- set src_source = "record_source" -%}
{%- set src_extra = ["incomingdate"] -%}
{%- set partition_cause = "'" + var('hs_transaction')['start_date'] + "' <= transaction_date and transaction_date < '" + var('hs_transaction')['start_date'] + "'" -%}
{{ dbtvault.link(src_pk=src_pk, src_fk=src_fk, src_ldts=src_ldts,
                 src_source=src_source, source_model=source_model,
                src_extra=src_extra, partition_cause=partition_cause) }}
Ключевые ошибки и рекомендации
На основе нашего опыта внедрения мы выделили ряд критически важных моментов.
Во-первых, никогда не игнорируйте партиционирование и дистрибуции. Иначе вам может грозить резкое падение производительности, перекос данных (data skew) на отдельных сегментах Greenplum, невозможность эффективно удалять старые данные Всегда явно указывайте distributed_by на ключ, по которому часто происходят джойны. Все большие таблицы партиционируйте по временной метке.
Еще одна распространенная ошибка - слепое следование методологии без учета специфики СУБД. Модель Data Vault является чистой и правильной, но совершенно неработоспособной на больших объемах данных из-за миллиардов строк в неподходящих для этого таблицах. Не бойтесь отступать от канона, если того требует производительность. Партиционирование спутников — яркий пример такого обоснованного отступления.
Недостаточное тестирование хэш-функций – еще один критически важный момент. Оно может привести к возникновению коллизий (разные бизнес-ключи получают одинаковый хэш), что приводит к потере целостности данных. Тщательно тестируйте функцию хэширования на уникальность. Используйте комбинации ключей и надежные алгоритмы (например, MD5 или SHA-256).
Еще одна ошибка - отсутствие процесса очистки (vacuum) и анализа. После интенсивных операций DELETE/UPDATE в Greenplum накапливается "мусор" (dead tuples), что приводит к резкому замедлению запросов и раздуванию таблиц. Настройте регулярный запуск команд VACUUM ANALYZE для таблиц, подверженных частым изменениям.
Слабая документация моделей DBT – также важный момент, на который стоит обратить свое внимание. Новым членам команды сложно разобраться в пайплайне, возрастает время на онбординг и риск внесения ошибочных изменений. Активно используйте документационные блоки docs в DBT, описывайте назначение каждой модели и ее взаимосвязи.
Преимущества нашего подхода для бизнеса
Внедрение описанного стека технологий дает бизнесу ряд преимуществ. Во – первых, это гибкость и скорость изменений.Добавление нового источника данных или атрибута не требует перестройки всей модели, а сводится к добавлению нового спутника или линка. Во-вторых, это полный аудит и историчность. Data Vault по своей природе сохраняет всю историю изменений, что обеспечивает полную трассируемость данных. В – третьих, это масштабируемость. Связка Greenplum и DBT позволяет обрабатывать петабайты данных, а архитектура Data Vault гарантирует, что модель не "рассыплется" под нагрузкой. В – четвертых, это снижение TCO (Total Cost of Ownership). Автоматизация процессов через DBT, использование opensource-решений (Greenplum) и высокая производительность снижают совокупную стоимость владения хранилищем данных. В – пятых, это повторное использование. Модели DBT и макросы dbtvault стандартизируют процесс разработки, позволяя повторно использовать код и ускоряя время реализации новых ETL-процессов.
Построение хранилища данных на основе методологии Data Vault с использованием DBT и Greenplum — это сложная, но абсолютно выполнимая задача, требующая глубокой экспертизы как в области моделирования данных, так и в тонкой настройке MPP-СУБД.


