

Эффективное использование Apache Superset
Основные рекомендации по максимально эффективному использованию Apache Superset
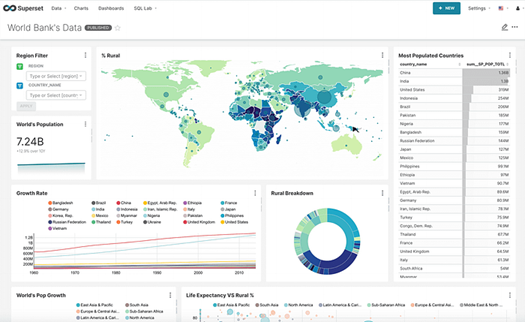
В течение очень долгого времени в королевстве бизнес-аналитики (BI) царствовали такие проприетарные решения, как Tableau, Power BI и чуть позже Looker. И вдруг появился Apache Superset…
Уставший от многочисленных трудностей, связанных с использованием проприетарных BI-решений, сотрудник Airbnb Максим Бошмин запустил хакатон с целью создания простого в использования и при этом эффективного BI-инструмента с нуля.
Проект под названием Caravel был запущен в 2016 году. За пять лет он превратился в сегодняшний Apache Superset, на который обратили внимание десятки крупнейших компаний по всему миру.
Говоря о масштабировании использования данного продукта, вынуждены отметить, что документация в данной области все еще оставляет желать лучшего, поэтому в этой статье мы поговорим о том, как следует масштабировать данное ПО.
Все дело в контейнерах
Независимо от того, на какой платформе или в каком облаке Вы собираетесь работать с Superset, для обеспечения масштабируемости Вам необходимо настроить контейнер , отвечающий Вашим конкретным потребностям.
Отправной точкой должен быть официальный образ Superset (доступный на DockerHub). Чуть позже Вы можете добавить дополнительные зависимости (например, драйверы баз данных), необходимые для решения Ваших задач. Например, если мы хотим использовать Redis, то Dockerfile будет выглядеть следующим образом:
FROM apache/superset:1.0.1
 # We switch to root USER root # We install the Python interface for Redis RUN pip install redis # We switch back to the `superset` user USER superset
Кроме того, необходимо создать файл superset_config.py, который будет содержать Вашу пользовательские настройки. С его помощью Вы сможете перезаписывать некоторые значения в основном файле конфигурации, такие как метод аутентификации или срок выполнения запросов.
Наконец, мы можем обновить Dockerfile, используя следующие команды:
# We add the superset_config.py file to the container
 COPY superset_config.py /app/ # We tell Superset where to find it ENV SUPERSET_CONFIG_PATH /app/superset_config.py
Таким образом, наши пользовательские настройки будут загружены в контейнер и распознаны Superset. Затем Вы можете добавить шаг CMD в свой Dockerfile и запустить Superset.
Кэш, кэш, кэш
Распространенной проблемой, с которой мы сталкиваемся при согласовании нескольких баз данных с Apache Superset, является проблема обработки слишком большого количества запросов после открытия дашборда. Выполнение нескольких запросов будет препятствовать масштабируемости инструмента.
Чтобы решить эту проблему, Apache Superset допускает несколько различных способов кэширования. Как только Вы создадите диаграмму, Apache Superset сохранит ее во вновь настроенном кэше. Это поможет сделать данные мгновенно доступными для нескольких пользователей, не требуя при этом создания новых запросов. Это не только повышает производительность, но и обеспечивает лучшие возможности обработки запросов.
Apache Superset создан с помощью Flask AppBuilder и, соответственно, использует встроенное решение для кэширования под названием Flask-Cache. Это решение для кэширования предлагает поддержку нескольких различных серверных платформ кэширования, включая Redis и Celery.
Celery можно использовать для настройки серверной части для обработки длинных асинхронных запросов.
Управление доступом
Неудивительно, что Superset полагается на Flask AppBuilder и для аутентификации. Инструмент предлагает множество способов аутентификации, таких как OAuth или LDAP, которые можно достаточно легко активировать и настроить.
Для достижения масштабируемости активируйте один из методов аутентификации и позвольте пользователям самостоятельно регистрироваться на платформе. Для этого в файл superset_config.py добавьте следующие две строки:
AUTH_USER_REGISTRATION = True
 AUTH_USER_REGISTRATION_ROLE = "a_custom_default_role"

В разрешениях пользования инструментом царит неразбериха, но это не страшно
Одним из слабых мест Superset является управление разрешениями. До сих пор данный вопрос является до конца не решенным, хотя существует множество предложений по его оптимизации.
К счастью, разрешения достаточно легко настраиваются, и проблема скорее связана с разрешениями, связанными с функциями, которые генерирует Flask AppBuilder.
Для того, чтобы не нужно было управлять длинным списком разрешений, клонируйте одну из существующих ролей и настройте ее в соответствии с Вашими требованиями. Затем предоставьте эту роль всем Вашим пользователям.
Заключение
Благодаря большому и активному комьюнити Superset достаточно быстро превратился в зрелый и востребованный проект (совсем недавно вышла версия 1.0). Поэтому при разработке масштабируемой BI-платформы его определенно следует рассматривать в качестве одного из самых оптимальных инструментов.
Многоэтапный процесс масштабирования Apache Superset – это ничто по сравнению с его возможностями и функционалом. Посмотрите на работу Airbnb и Вам сразу станет все понятно. (Если хотите, прочитайте один из постов, опубликованных в блоге компании).
Наконец, стоит сказать и о том, что Максим Бошмин, создатель Superset, недавно создал Preset – компанию, которая предлагает управляемый облачный сервис для Apache Superset. Если Вы хотите минимизировать усилия, связанные с настройками инструмента, обратите внимание на на данный продукт.


