

Эра DataOps
Найдено ли наиболее оптимальное решение всех современных проблем, связанных с хаосом данных и сотрудничеством в области данных?
Данных становится все больше и больше, и традиционные методы управления уже попросту не справляются с ними. DataOps набирают популярность, обещая справиться с сегодняшним хаосом в области данных и существующими контекстными проблемами.
Давайте посмотрим правде в глаза – традиционные методы управления данными больше не работают. Сегодня около 75% топ-менеджеров попросту не доверяют тем данным, которыми они располагают, и только 27% проектов в сфере данных можно назвать действительно успешными. Удручающие цифры, характеризующие время, которое называют “золотым веком данных”, не правда ли?
Поскольку объем и сложность данных постоянно растут, их все сложнее и сложнее контролировать. Что еще хуже, команды по работе с данными, инструменты и инфраструктура данных также становятся все более разнообразными. В результате мы вынуждены констатировать такой хаос данных, какого еще не было в нашей с Вами истории.
DataOps существует уже несколько лет, но сейчас они особенно популярны, потому что обещает решить эту проблему. С разницей в неделю компании Forrester и Gartner признали важность DataOps в эпоху Big Data.
23 июня этого года компания Forrester выпустила последнюю версию своего Wave отчета о каталогах данных - вместо того, чтобы, как обычно, рассказать о "каталогах данных машинного обучения", компания переименовала эту категорию в "корпоративные каталоги данных для DataOps". Неделей позже, а именно 30 июня, Gartner выпустила свой Hype Cycle 2022, в котором предположила, что DataOps полностью захватят рынок через 2-5 лет.
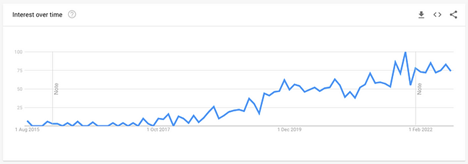
Данные Google Trends о глобальных поисковых запросах на тему "DataOps" с 2015 года. Ось Y временную шкалу, 100 означает пик популярности термина в данном регионе и времени.
Рост DataOps отмечается не только аналитиками. Я лично видел, как DataOps превратился из неизвестного термина в обязательную часть работы с корпоративными данными, а некоторые компании даже построили целые стратегии развития, основанные на DataOps. Результаты, конечно, бывают разными, но я сам видел невероятные улучшения в плане скорости и эффективности работы специалистов по данным.
В этом статье я расскажу Вам все, что следует знать о DataOps - что это такое, откуда он взялся и как его лучше внедрять в Вашей организации.
Что такое DataOps?
Первое и, возможно, самое важное, что нужно знать о DataOps, - это то, что это не продукт. И не инструмент. Фактически, это вообще не то, что можно купить, и все, кто пытается доказать Вам обратное, на самом деле пытаются Вас обмануть.
На самом деле, DataOps - это образ мышления или культура - способ помочь командам данных и людям эффективнее работать вместе.
Понятие DataOps может быть немного сложным для восприятия, поэтому давайте начнем с нескольких наиболее известных определений.
"DataOps - это практика совместного управления данными, направленная на улучшение коммуникации, интеграции и автоматизации потоков данных между менеджерами и потребителями данных в организации".
“DataOps - это способность создавать решения, разрабатывать продукты данных и активировать данные для повышения ценности бизнеса на всех технологических уровнях - от инфраструктуры до опыта".
"DataOps - это метод управления данными, в котором особое внимание уделяется общению, сотрудничеству, интеграции, автоматизации и измерению взаимодействия между инженерами по обработке данных, специалистами по исследованию данных и другими профессионалами в области данных".
Как видите, стандартного общего определения DataOps не существует. При этом очевидно, что все говорят о DataOps, используя термины, выходящие за рамки технологий или инструментов. Вместо этого они делают акцент на такие термины, как коммуникация, сотрудничество, интеграция, опыт и кооперация.
На мой взгляд, DataOps - это объединение современных разнообразных команд, работающих с данными, и помощь им в работе с такими же разнообразными инструментами и процессами. Принципы и процессы DataOps помогают командам эффективнее управлять данными и значительно экономить свое драгоценное время, минимизируя напрасные усилия.
Четыре фундаментальные идеи, лежащие в основе DataOps
Некоторые люди любят говорить, что команды по работе с данными похожи на команды по разработке ПО и пытаются применить принципы разработки ПО к работе с данными. На самом деле не все так просто.
В программном обеспечении у Вас есть определенный уровень контроля над кодом, с которым Вы работаете. В конце концов, его пишет человек. Что же касается команды по работе с данными, здесь Вы часто не можете контролировать свои данные, поскольку они поступают из различных исходных систем в различных форматах. Таким образом, команда по работе с данными больше похожа на производственную команду, превращающую кучу неуправляемого сырья в конечный готовый продукт. Или, на команду по работе с продуктом, которая доставляет этот продукт широкому кругу внутренних и внешних конечных потребителей.
Мне нравится думать о DataOps так: как мы можем взять лучшие наработки других команд и применить их так, чтобы помочь командам данных работать вместе более эффективно? DataOps сочетает в себе лучшие стороны Lean(бережливого производства), продуктового мышления, Agile и DevOps и применяет их в области управления данными.
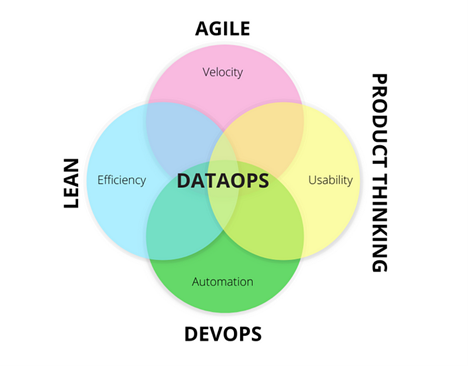
Четыре фундаментальные идеи, лежащие в основе DataOps.
Lean (Бережливое производство)
Ключевая идея: сократить количество отходов с помощью карт потока создания ценности.
Хотя корни Lean восходят аж к трудам самого Бенджамина Франклина, датируемым 30-ми годами XVIII века, окончательно оформленная концепция бережливого производства возникла благодаря работе компании Toyota в 50-х годах XX века. После окончания Второй мировой войны автомобильная промышленность - да и весь мир в целом - вставала на ноги. Сотрудники заводов по производству автомобилей были перегружены работой, заказы задерживались, затраты были непомерными, а клиенты - недовольными.
Для того, чтобы решить все эти проблемы, Toyota создала Производственную систему Toyota , систему экономии ресурсов путем устранения большого количества отходов. Разрабатываемая система была призвана ответить на вопрос: «Как в кратчайшие сроки получить товар наивысшего качества с наименьшими затратами»? Одна из ее ключевых идей заключается в том, чтобы по возможности устранить восемь видов отходов в производстве - от избыточного производства, времени ожидания, транспортировки, недостаточной загрузки работников и так далее - без ущерба для качества продукции.
Предшественницей Lean была TPS, придуманная в 1988 году бизнесменом Джоном Крафчиком и популяризированная исследователями Джеймсом Вомаком и Дэниелом Джонсом в 1996 году. Lean сосредоточилась на идее картирования потока создания ценности. Подобно тому, как Вы составляете карту производственной линии с помощью TPS, Вы составляете карту бизнес-деятельности в мельчайших деталях, выявляете потенциальные отходы и оптимизируете процесс для того, чтобы сохранить качество и устранить избыточные отходы. Если часть процесса не добавляет ценности для клиента, то это отходы - и все отходы должны быть устранены.
Как на самом деле выглядят карты потока создания ценности? Давайте начнем с примера из реального мира.
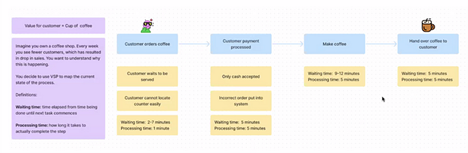
Карта потока создания ценности для заказа кофе в кафе.
Допустим, у Вас есть кафе, и Вы хотите улучшить процесс заказа чашки кофе Вашими клиентами. Первый шаг - составить схему всего, что происходит с клиентом, когда он заказывает кофе: прием заказа, принятие оплаты, приготовление кофе, передача его клиенту и т. д. По каждому из этих этапов Вы объясняете, что может пойти не так и сколько времени может занять этот этап - например, клиент не может найти место, где ему сделать заказ, а затем тратит до 7 минут на ожидание в очереди, когда,наконец, находит то, что искал.
Как эта идея применима к командам по работе с данными? На самом деле, команды по работе с данными очень похожи на производственные команды. Ведь они работают с сырьем (исходными данными), пока оно не превратится в продукт (продукт данных) и не попадет к клиентам (потребителям данных или конечным пользователям).
Итак, если цепочка поставок имеет свои собственные потоки ценности, то как будут выглядеть потоки ценности данных? Как мы можем применить эти же принципы для составления карты потоков ценности данных? И как их оптимизировать таким образом, чтобы исключить потери и сделать работу с данными более эффективной?
Продуктовое мышление (Product thinking)
Ключевая идея: С помощью системы Jobs To Be Done уточнить, какую работу на самом деле выполняет продукт.
Основной концепцией продуктового мышления является концепция Jobs To Be Done (JTBD), популяризированная Энтони Улвиком в 2005 году.
Понять эту идею проще всего через Теорию Милкшейка, историю от Клейтона Кристенсена. Ресторан быстрого питания хотел увеличить продажи своих молочных коктейлей, поэтому руководство перепробовало множество различных изменений, например, сделало их более шоколадными и более дешевыми, чем у конкурентов. Однако ничего не помогало, и продажи оставались на прежнем уровне.
Тогда они отправили сотрудников собирать данные о клиентах, покупающих молочные коктейли. Выяснилось, что почти половина молочных коктейлей продается «одиночным» клиентам до 8 утра. Почему? На следующее утро сотрудники поговорили с этими людьми и узнали, что им предстоит долгая и скучная дорога на работу, и им нужен завтрак, который можно съесть в машине во время движения. Бублики слишком сухие, пончики - слишком жирные, бананы - слишком быстро съедаются... а вот молочный коктейль в самый раз, ведь его можно выпить быстро, а сытость останется на все утро.
Как только руководство ресторана поняло, что для этих покупателей цель или "работа" молочного коктейля заключается в обеспечении сытного и удобного завтрака во время поездки на работу, им сразу же стало очевидно то, что нужно сделать молочные коктейли более «удобными» и наполненными - и тогда продажи сразу же выросли.
Система JTBD помогает создавать продукты, которые действительно нравятся людям, будь то молочный коктейль или дашборд. Например, JTBD менеджера по продукту может заключаться в определении приоритетов различных функций продукта для достижения конкретных бизнес-результатов.
Как эта идея может быть применима к командам, работающим с данными? В мире данных существует два основных типа клиентов: "внутренние" члены команды данных и "внешние" потребители данных, которые используют продукты, созданные командой данных.
Вы можете использовать систему JTBD для понимания задач этих клиентов. Например, JTBD аналитика может заключаться в предоставлении аналитических данных для принятия решений о приоритетности продуктов. Затем, создав JTBD, Вы сможете составить список задач, необходимых для ее выполнения - каждая из них будет являться Потоком создания ценности данных, и может быть отображена и оптимизирована с помощью карты потока создания ценности, указанной выше.
Agile
Ключевая идея: увеличить скорость по методике Scrum и отдавать предпочтение MVP, а не готовым продуктам.
Если Вы когда-либо работали в технологической или любой другой "современной" компании, Вы, вероятно, хорошо знакомы с понятием Agile. Agile – это ни что иное, как это основа для команд разработчиков программного обеспечения по планированию и отслеживанию своей работы, описанная в Agile-манифесте разработки ПО в 2001 году.
Основной идеей Agile является Scrum, итеративная система управления продуктами, основанная на идее создания MVP или минимально жизнеспособного продукта.
Пример: если бы Вы хотели создать автомобиль, то с чего бы Вы начали? Вы могли бы начать с проведения интервью, поиска поставщиков, создания и тестирования прототипов и так далее... но это займет слишком много времени, за которое рынок и мир сильно изменятся, и в итоге с большой долей вероятности Вы создадите то, что людям уже давно не нужно…
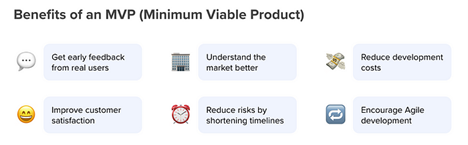
Шесть способов оптимизации разработки продукта благодаря MVP
MVP означает существенное сокращение процесса разработки продукта. Чтобы создать MVP, Вы спрашиваете, в чем заключается на самом деле состоит JTBD задача - в создании автомобиля или в обеспечении транспортировки? Самым быстрым продуктом, решающим задачу транспортировки, может стать велосипед, а не автомобиль.
Цель Scrum - как можно быстрее создать что-то, что можно вывести на рынок. Если Вы сосредоточитесь на поиске минимального решения, а не на создании идеального решения или решения мечты, Вы сможете узнать, чего на самом деле хотят пользователи, когда будут тестировать Ваш MVP - ведь обычно во время опросов они не могут обозначить то, что им на самом деле нужно.
Как эта идея может быть применима к командам по работе с данными? Многие команды по работе с данными работают изолированно от остальной организации. Когда им поручают проект, они зачастую работают над решением месяцами и после его внедрения узнают, что оно неверное или уже неактуально. Возможно, постановка задачи была неверной, или у них не было контекста, необходимого для разработки правильного решения, или, пока они создавали свое решение, потребности организации уже успели измениться…
Как команды по работе с данными могут использовать подход MVP, чтобы сократить время разработки решения и быстрее прийти к правильному ответу? Как они могут сформировать образ мышления, ориентированный на поставку решения, и получить быструю обратную связь от заинтересованных сторон?
Agile можно использовать для того, чтобы минимизировать изолированность команд по работе с данными и улучшить их взаимодействие с конечными потребителями данных. Данная методология может помочь командам по работе с данными быстрее найти нужные данные, запустить модели данных в производство и выпустить продукты в кратчайшие сроки, а также получать обратную связь от бизнес-пользователей и итеративно улучшать и адаптировать свою работу по мере изменения потребностей бизнеса.
DevOps
Ключевая идея: улучшить совместную работу с помощью управления релизами, CI/CD и мониторинга.
Методология DevOps зародилась в 2009 году на конференции Velocity Conference Movement, где дата-инженеры Джон Оллспоу и Пол Хаммонд представили свой доклад об улучшении «сотрудничества dev & ops».
В то время было принято считать, что разработка ПО движется линейным потоком: задача команды разработчиков - добавлять новые функции, а задача операционной команды - поддерживать функции и программное обеспечение в стабильном рабочем состоянии. В докладе, упомянутом выше, было представлено совершенно новое видение: задача и разработчиков, и операторов заключается в том, чтобы обеспечивать жизнеспособность бизнеса.
DevOps трансформировала линейный поток разработки ПО в круговой, взаимосвязанный, который разрушает замкнутость между этими двумя командами. Это помогает командам работать вместе в рамках различных функций. Такие идеи, как управление релизами (соблюдение установленных "стандартов доставки" для обеспечения качества), операции и мониторинг (создание систем мониторинга для оповещения о поломках), а также CI/CD (непрерывная интеграция и непрерывная доставка) сделали это возможным.
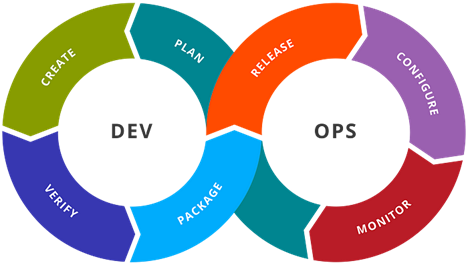
Инструментальная цепочка DevOps, созданная Kharnagy
Каким образом эту идею можно применить к командам, работающим с данными? В мире данных инженерам и аналитикам легко функционировать независимо друг от друга (инженеры управляют конвейерами данных, а аналитики строят модели ) и обвинять друг друга, если что-то вдруг пошло наперекосяк. Вместо решения возникшей проблемы это приводит к затяжным ссорам и всебщему недовольству. На самом же деле крайне важно объединить эти два лагеря одной общей целью - сделать бизнес более ориентированным на использование данных.
Например, при развертывании моделей Ваши специалисты по обработке данных могут зависеть от инженеров или ИТ-специалистов. С помощью DataOps онисмогут самостоятельно развертывать свои модели и быстрее выполнять анализ данных- больше никаких зависимостей.
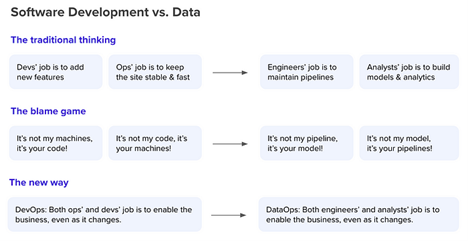
От DevOps к DataOps
Примечание: Подчеркиваю, DataOps - это не просто DevOps с конвейерами данных. Задачи, которые решает DevOps, «находятся» между двумя высокотехничными командами - разработчиками ПО и ИТ-специалистами. DataOps решает сложные задачи, помогая широкому кругу технических и бизнес-команд создавать сложные продукты данных - от конвейера данных до дашборда или документации.Более подробную информацию можно получить здесь.
Как внедрить DataOps?
Сегодня в каждой сфере есть функция поддержки. Например, SalesOps сосредоточены на повышении производительности и эффективности отдела продаж. Команды DevOps и Developer Productivity Engineering сосредоточены на улучшении сотрудничества между командами разработчиков программного обеспечения и повышении производительности разработчиков.
Почему же у нас нет аналогичной функции для команд по работе с данными? DataOps - вот ответ. Так как же внедрить эту парадигму?
Идентифицируйте ключевых потребителей
Команда или функция DataOps не столько реализует проекты по работе с данными, сколько помогает остальным сотрудникам организации получать от данных максимум пользы. Она фокусируется на создании правильных инструментов, процессов и культуры, помогающих другим людям добиться успеха в их работе.
Ключевые потребители DataOps
Создайте специальную команду (функцию) DataOps
Стратегия DataOps будет наиболее эффективной, если за ней стоит специальная команда, в которой есть два ключевых специалиста:
- Руководитель по внедрению DataOps: хорошо разбирается в данных и пользователях и умеет эффективно сотрудничать с другими командами и объединять людей. Как правило, такие специалисты ранее могли быть информационными архитекторами, менеджерами по управлению данными и даже инженерами данных.
- Инженер по внедрению DataOps: «мозг» автоматизации в команде DataOps. Ключевым преимуществом является глубокое знание данных и того, как они перемещаются между системами/командами. Зачастую это бывшие разработчики, архитекторы данных, инженеры по данным и инженеры по аналитике данных.
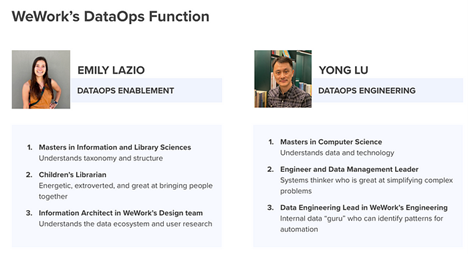
Как WeWork сформировала свою команду DataOps из двух ключевых специалистов
Составьте карту потоков создания стоимости, сократите потери и способствуйте сотрудничеству между сотрудниками
В начале «пути» к DataOps в рамках компании для определения задач в области данных, также известных как потоки ценности данных, руководители по внедрению DataOps могут использовать структуру JBTD. Затем, используя принцип Lean, они могут составить карту потоков ценности, что позволит им выявить и устранить нецелесообразные направления деятельности.
Идеология Scrum из Agile поможет командам по работе с данными понять, как более эффективно и результативно создавать продукты данных, а основные идеи из DevOps покажут, как можно выстроить сотрудничество с остальными сотрудниками организации в процессе работы над этими продуктами данных.
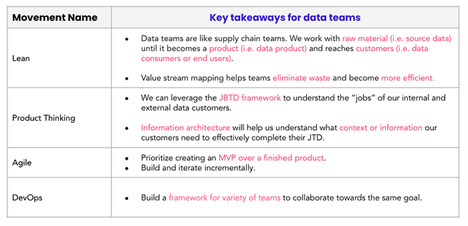
Что команды, работающие с данными, могут вынести из четырех столпов, лежащих в основе DataOps
Создать стратегию и функцию DataOps не просто. Но если Вы все сделаете правильно, DataOps сможет решить некоторые самые острые современные проблемы с данными, поможет сэкономить время и ресурсы всей организации, а также повысить ценность, получаемую от данных.
В следующих статьях я хочу более подробно рассказать Вам о том, как именно стоит реализовывать стратегию DataOps, основываясь на лучших практиках по работе с данными по всему миру, как определить потоки ценности данных, как создать культуру данных в рамках компании и многое-многое другое. Оставайтесь на связи и дайте знать, есть ли у Вас вопросы, которые я пока еще не осветил!


