

FAQ по Apache Airflow и Apache NiFi
FAQ по Apache Airflow

Как отключить вывод в лог всего sql зароса в airflow-clickhouse-plugin?
в сорцах, как вариант
Если я активировал окружение в баш операторе, то в следующем таске в пайтон операторе я в этом окружении работать буду?
Не факт. Разве что c LocalExecutor'ом есть шанс.
Если добавляешь новую таску в даг, есть возможность в предыдущем даг-запуске запустить только её, без перезапуска всего дага?
Backfill
Подскажите как в Докере перезапустить Airflow?
Контейнер рестартануть
А что такое экземпляры одного дага? Несколько дагов одновременно не могут работать?
DagRun. Сам даг — это описание пайплайна, DagRun — конкретный инстанс, запускаемый в определённое время с определёнными параметрами
airflow.providers.microsoft.mssql.hooks.mssql.MsSqlHook
Метод insert_rows Судя по логам, метод сохраняет по 1000 записей за раз.
Подскажите пожалуйста есть ли возможность увеличить количество сохраняемых записей?
Или каким-то иным способом ускорить сохранение данных.
По-моему у метода insert_rows есть параметр commit_every, который как раз задаёт величину пачки вставки. По умолчанию он равен 1000. Просто передайте большее число в этот параметр
Как коннекшн прописывать? Нашел статью, написано как для sqlite, так получается?
Да
Добрый день, подскажите, пожалуйста, как сделать выполнение delete_config_map только, когда было успешно выполнено create_config_map?
В данный момент такие бренчи, и delete_config_map_task не скипается(
branching_step >> create_config_map_task >> spark_submit >> delete_config_map_task
branching_step >> spark_submit
branching_step >> create_config_map_task >> spark_submit
create_config_map_task >> delete_config_map_task
branching_step >> spark_submit
Насколько я вижу, в Airbyte очень многое делается через UI, это плохо из-за отсутствия версионности и возможности автоматизации.
Как-то решали перечисленные проблемы кроме как ""не использовать Airbyte""?
Данные между тасками передавать неправильно. Нужно сделать связь между тачкой2 и 3
Не могу найти mssql в коннекшнах. Только через odbc?
поставить провайдер
в spark-submit можно подключиться к applicationId?
Нет. Там входишь в отдельное приложение
Это же spark-shell фактически
Что значит timeout? может интервал запуска 1 минута и тогда скипается?
dagrun_timeout=datetime.timedelta(minutes=5)
Может start date стоит относительный?
Нет
немного запутался в template_dates
хотел бы уточнить
если start_date стоит 2024-06-03, то ds будет 2024-06-04, поскольку даг выполняется после окончания дня
или же ds так и будет 2024-06-03?
он выполняется к концу времени 06.03, а тут выполнился даг от 06.02
Подскажите пожалуйста, как научить airflow распознавать русский язык?
В последний версии добавили поддержку языков.
Столкнулись с проблемой, что даг был удален из дирректории дагов, но мы по прежнему видим его в UI airflow. Версия airflow 2.8.3. Этот даг остался в таблице dag, судя по всему webserver берет его оттуда. Кто нибудь сталкивался с таким? Как можно удалить даг не прибегая к удалению записей из БД?
Нажмите кнопку Удалить (корзина) в UI
А где понять по ошибке что там на чтение права?
psycopg... ReadOnly
А кто у вас пишет даги?
если разработка через гит идет, то можно в CI/CD настроить поднятие airflow в докере и проверку этих новых дагов там
Можно это делать без вмешательства в оригинальный образ из chelm chart?
Использовать образ с нужной версией, если доп библы только сборка.
Какой синтаксис используется, чтобы передать в sql sensor в запрос параметр из дага (аргумент params) ?
Двойные скобки, обрамление в кавычки и тд
Использую как:
select ... where date < '{{ params.date }}' (не работает синтаксически)
select ... where date < :Date, {'Date':params.date}
Как в Airflow исполняются dag_callback? Логи уходят в скедулер, а кто в реальности выполняет эти операции: сам скедулер или скрытый экзекьютер?
я бы делал через докер, чтобы локальную машину не захламлять
Всем привет, подскажите пожалуйста, параметр в конфиге sql_alchemy_pool_size относится к метабазе airflow?
Да
Можно же из params получить массив необходимых параметров и запустится несколько экземпляров одинаковых тасок с разным входным параметром?
да, можно одной таской тогда
Вопрос можно сформулировать так: как добавить простейшую команду, например sleep 1 в блок command?
Если на примере воркера то вроде должно быть типа того:
command: /bin/bash -c ""sleep 1 && celery worker""
Всем привет! Если добавить в существующий даг, у которого catchup=True несколько тасок, которых до этого не было, то новые таски создадуться с start_date?
таска != dag run
При создании динамических taskgroup, получающих на вход результаты выполнения предыдущего таска с помощью expand(), можно как-то заставить их выполняться последовательно, а не параллельно?
1. Указать параметр @task.python(max_active_tis_per_dagrun=1) - будет запускать только по одной таске из группы. Последовательно
2. Можно попробовать параметр wait_for_downstream.
FAQ по Apache NiFi

FlowFile
Есть задача, которую хотелось бы выполнить на nifi.
Из эластика выдергивается json объект в flowfile-content, который идет по структуре:
{
""message"": ""some-log||some-log2||some-logN""
}
Далее мне необходимо разбить и распарсить ""some-log"" и перезаписать контент распаршеными данными в json формате. Формат лога не меняется. Как это лучше всего сделать и какие процессоры лучше всего использовать?
разные варианты.. Можно через QueryRecord, написать sql разбивающий сообщение. либо ScriptedTransformRecord
Не могу подобрать правильное регулярное выражение или нужную последовательность процессоров, помогите, пожалуйста.
Есть процессор executeSQL, вызывает процедуру в БД, которая возвращает значение в формате avro (название файла в директории) . Это значение надо передать далее процессору FetchFile, что бы тот его переместил.
Процессор executeSQL генерит FlowFile, у которого уже есть атрибут Filename и там сгенерированное значение (скрин). Не могу понять, как значение от ExecuteSQL передать в FetchFile.
convert avro to JSON -> evaluate JSON path
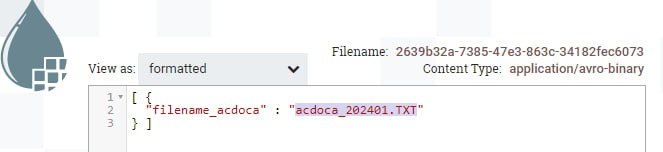
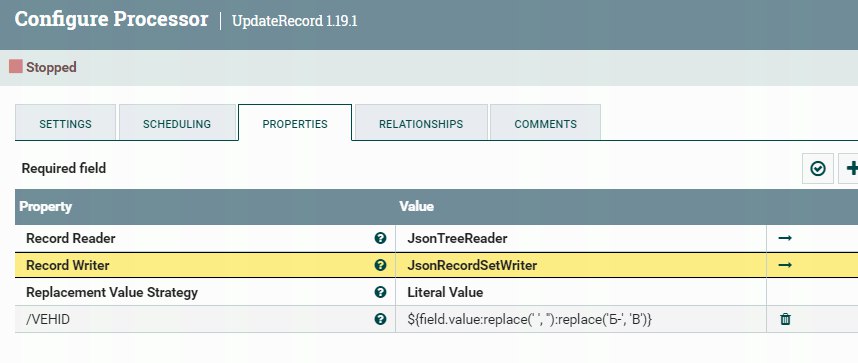
Коллеги, привет. столкнулся с такой проблемой, что после процессора UpdateRecord (с помощью которого я в флоуфайле делаю определнные замены в джсоне) процессор EvaluteJsonPath не выдергивает значения в атрибуты ( в атрибутах вместо значений пусте строки). Как только я убираю процессор UpdateAtribute, то все работает. Хотя и с ним и без него на вход EvaluteJsonPath падает по сути один и тот же джейсон. Может кто сталкивался?
Нужно к EvaluteJsonPath приделать 2 GenerateFlowFile.
Один с JSON до UpdateRecord, другой после.
Проверить. Убрать поля из JSON без которых негативный результат воспроизводится.
Показать ""бракованный"" JSON.
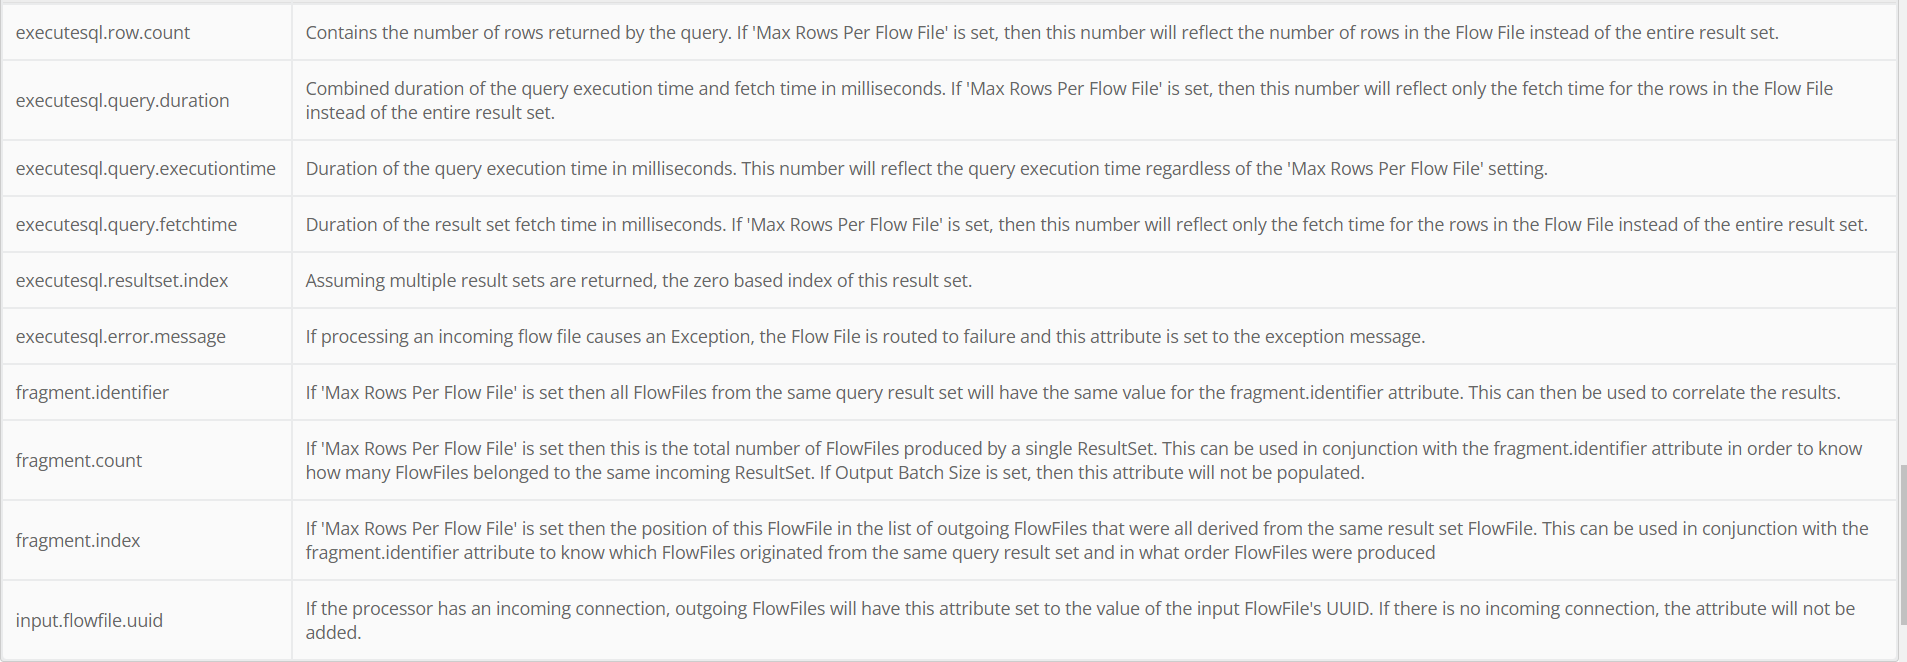
"Вопрос по PutSql (в принципе по любому просессору) - если там выходит какая то ошибка (any Java Exception) - как можно текст ошибки записать в flow file и потом посылать дальше в другие процессоры ?
Например для ExecuteSql есть writeAttribute executesql.error.message - и он уже приходит в flowfile/
Если это не заложено в коде проца то никак, для работы с ошибкоми есть логи и репортинг таски, строить логику на джава ошибках плохая идея (exception driven поток) надо стараться проектировать так чтобы ошибок не возникало встраивая подготовительную логику исключающую их. Ну а ловить и разбирать все отдельно
"а можете подсказать как пропускать flowfile который содержит вот такое {""result"":[],""error"":null}
самый скоростной вариант, это RouteOnAttribure по fileSize():gt(26).
Вариант с парсингом JSON можно сделать через ScriptedFilterRecord
return record.getValue(""error"")!= null
что-то не соображу как массив json забрать в атрибут.
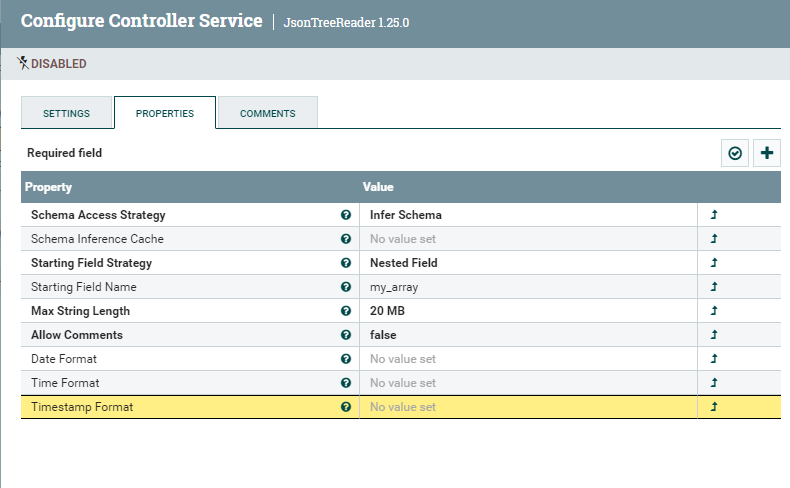
через EvaluateJsonPath забираю массив из json $['component']['processor']['config']['properties'] , получаю ошибку:
EvaluateJsonPath[id=125d1ac5-14ba-10ce-95c6-b6307ba11b3f] Unable to return a scalar value for the expression $['component']['processor']['config']['properties'] for FlowFile 502142. Evaluated value was {File Size=0B, Batch Size=1, Data Format=Text, Unique FlowFiles=false, generate-ff-custom-text=null, character-set=UTF-8, mime-type=null}. Transferring to failure.
Подскажите как забрать?
Вместо scalar определить json
подскажите пожалуйста. я получил два потока json, в них есть общий атрибут id (который я им дал). хотел бы склеить оба json между собой и потом с помощью jolt объединить. не могу разобраться, какой процесс и с каким условием использовать, чтобы найти файлы у которых одинаковый id. или я не по тому пути иду?
Mergecontent если речь про атрибут в flowfile а не в контент
Помогите разобраться с настройкой Wait/Notify в пайплайне
Распишу что делаю по этапам:
1. QueryDatabaseTable / Забираю инкрементом изменения из исходной БД при изменении max(updated_at)
2. PutSQL / Выполняю truncate delta-таблицы в целевой БД
3. PutDatabaseRecord / Выполняю вставку изменений в delta - таблицу
4. PutSQL / Запускаю функцию в БД, которая разгребает дельта - таблицу и помещает данные в основную таблицу по различным сценариям, но это не суть
Основной вопрос в том, как можно «защитить» delta таблицу таким образом, чтобы в неё не писались новые изменения до тех пор пока функция (Пункт 4.) не обработает предыдущую дельту
Сейчас сделал через Wait/Notify вариант что каждый flowfile сразу же запускает эту функцию (пункт 4.) она обрабатывает предыдущий кусок и делает Notify, а потом уже вставляется следущий кусок данных по второй ветке процессоров с wait, тут минус в том что приходится ждать когда придут следующие изменения…
версия nifi 1.24.0
После 3 переключи партицию, запускай обраобтку фоновым процессом, продолжай наполнять свою основную табблицу И не надо городить ожидания А лучше делать это на другом оркестраторе, типа Airflow.
Nifi просто пишет в STG таблицу как у него есть данные. Когда надо запускать обработку, переключаешь партицию, делаешь свою обработку. Непосредственно QueryDatabaseTable и тригерит. Раз в n времени опращивает исходную таблицу на max(updated_at) и сравнивает со своим state
Как можно решить проблему, получаю из kafka json, из json необходимо извлечь параметры и сходить в БД чтобы взять некоторые данные, после получения данных из бд необходимо из полученного json извлечь массив и собрать в один flowfile. Получается что flowfile необходимо разделить на несколько и потом собрать в один. Я правильно понимаю что без Redis или что-то подобного это не решить ?
Это делается штатно с использованием процессоров split и merg
а есть вариант перахватывать логин пользователя под которым зашли в nifi? Вот пример, есть GenerateFlowFile который запускается в ручную. И нужно узнать кто конкретно его запускал
Нет, сессия пользователя и Nifi сервер развязаны и в контексте нет ничего про пользователя
можете подсказать как сделать фильтрацию по flowfile если внутри флоу содержится хотя бы один json который будет иметь определенную маску, в атрибуты это не вынесено, хочется сделать через контент
Пробовал сделать через in и equals, не получилось, делал через проц RoutOnContent
QueryRecord. И запрос на calcite sql пишите или ValidateRecord - валидация по схеме
В Expression Language нет функции, которая возвращает содержимое самого FlowFile (его контент)? Только через ExtractText в атрибут, затем уже использовать дальше?
Да, только ExtractText.
Если json, то EvaluateJsonPath
Подскажите, что лучше использовать, если мне нужно создавать flowfile (POST запрос для Invokehttp) по входящему событию?
Т.е. я получаю flowfile, который служит триггером для генерации POST запроса в теле flowfile. Кроме как UpdateAttribute -> AttributeToJson в голову ничего не идёт.
ReplaceText
Есть задача реализовать отправку sql-запроса в виде html-таблицы в теле email. Поток выглядит следующим образом: GenerateFlowFile»Executesql»ConvertAvroToJSON»ConvertRecord(Reader - Jsontreereader, Writer - CSVRecordSetWriter)»куча ReplaceText'ов для расстановки тэгов и получения целевой структуры хтмл-таблицы»PutEmail.
Путем множества ReplaceText я расставляю html-тэги. Получаю в итоге нормальную html-форматированную таблицу, код которой проверял в различных хтмл-вьюерах.
После этого ставлю PutEmail. ContentType: text/html; charset=utf-8, message={$param.message}, FF content as message=${param.cnt_as_msg}, input character set=utf-8. PutEmail отрабатывает без ошибки, но на почту падает пустое письмо.
Подскажите, что я делаю не так, и как добиться желаемого результата (письмо с таблицей из скуля падает на целевой почтовый адрес в хтмл-формате).
Делал проще.
ExecutesqlRecord (в xml)
TransformXml в html
Добрый день, подскажите пожалуйста, как то можно замерить результат работы процессоров, нужно для того,чтобы узнать, какое из решений работает быстрее
""Решение"" это один процессор или целая группа (пайплайн)?
Впрочем, для оценки времени прохождения flowfile от рождения до updateAttribute где-то в финале я использую формулу.
${now():toNumber():minus(${lineageStartDate}):format(""HH:mm:ss"", ""GMT"")}
Надо учитывать, что NiFi распределяет нагрузку очень неравномерно, поэтому время работы группы может сильно меняться.
Подскажите как из атрибута переложить значение в контент?
ReplaceText
Подскажите пожалуйста. Если от внешнего сервиса получили большой JSON с атрибутом-массивом, как лучше с экономным расходованием ОЗУ разбить его на отдельные JSONчики с нарезанием атрибута-массива кусками по N элементов и сохранением остальных атрибутов верхнего уровня?
Атрибут пишем в БД. В другой ветку лукапатррибут.
как посчитать количество строк:
получаю Селект вывод из ExecuteSQLRecord построчно, в каждой строке есть поле STATUS (значение : 0 или 1), так вот мне нужно сосчитать сколько строк с каким статусом и сколько всего строк.
Реализация:
- в стартовом проц. устанавливаю атрибуты :
a_cnt_all 0
a_cnt_bad 0
a_cnt_good 0
- получил строки забрал значение поля STATUS в атрибут
- а дальше не пойму...
К примеру, получили 10 строк у них разное значение поля STATUS 7 строк = «0» и 3 строки = 1
Как мне получить v_cnt_all = 10, v_cnt_good = 7, v_cnt_bad = 3
QueryRecord В нем пишешь sql запрос
Есть ли в nifi возможность поместить все содержимое (текст) флоуфайла в атрибут и если да, то как это можно сделать?
Есть процессор, который по регулярке результат в атрибут кладёт. Можно регулярку .* поставить. Название не помню
Есть такой вопрос, что-то пока не соображу как сделать, есть Record(Avro), в нем есть поле типа Array of String. В этот список надо вставить значение атрибута. Есть идеи как это реализовать, кроме как скриптом?
Возможно, jolt.
посоветуйте годный гайд по jslt. Надо осваивать техно
Вероятно, отсюда надо начинать копать
https://github.com/schibsted/jslt/blob/master/examples/README.md
А NIFI стал прокидывать атрибуты в JOLT трансформ? Вроде не было раньше
Да, умеет
Я посмотрел avro файл и там для одного поля в разных записях может быть как один тип данных так и другой. предположительно ругается на это.
Есть ли способ в схеме (автосозданной csvreader-ом) принудительно оставлять string? При этом хардкодить схему не хотелось бы (столбцы могут добавляться)
Есть такой проц - ExtractAvroMetadata. Вы можете извлечь схемиу в атрибут. Потом найти строку ['float' ....] и заменить на ['null', 'string']. После этого сделать ConvertRecord, где ридер будет брать Infer схему, а SetWriter будет брать схему из атрибута, и писать ее в Infer
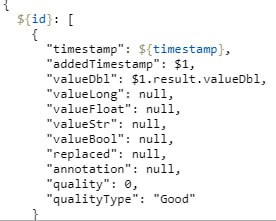
День добрый, можете подсказать на вход приходит flow и мне из его контекста нужно достать значения, пробовал по разному ставить, $1 и тд, но не получал нужного результата, а на вход вот такой json
https://goessner.net/articles/JsonPath/index.html
См. JSONPath
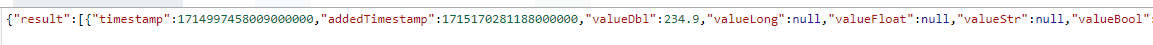
кто знает как забрать эти атрибуты:
Queued Duration 00:00:07.303
Lineage Duration 00:00:07.330${lineageDuration} как только не пробывал не могу подобрать
https://nifi.apache.org/docs/nifi-docs/html/developer-guide.html#additional-common-attributes
подскажите пожалуйста, как можно решить проблему, необходимо прочитать json взять значение и в зависимости от этого параметра сделать запрос в определенную бд, получается на лету необходимо менять connection pool в настройках ExecuteSql.
Создавайте конечное количество подключений. Каждое подключение объединяете в DBCPConnectionPoolLookup, где подключение идентицируется именем.
ExecuteSql может применять его для общенияс БД, достаточно имя подключения поместить в атрибут database.name.
Есть цель сконвертировать XML в JSON используя AVRO-схему (XMLReader -> JSONRecordSetWriter). Возникла проблема c конвертацией значений из элементов вида
<SomeItem bool_value=""false"">qqrgthyj108</SomeItem>
Т.к. не ясно, как вытащить одновременно и атрибут bool_value, и значение qqrgthyj108, которое находится между тэгами.
NiFi предлагает через процессор ExtractRecordSchema такую Avro-схему
""name"": ""SomeItem"",
""type"": [
{
""type"": ""record"",
""name"": ""SomeItemType"",
""fields"": [
{
""name"": ""bool_value"",
""type"": [""boolean"",""null""]
},
{
""name"": ""value"",
""type"": [ ""string"",""null""]
}
]
},
""null""
]
Но в результате конвертации в JSON имеем
{""SomeItem"":{""bool_value"":false,""value"":null}}
Может сталкивался кто-то с таким?
Сработает через указание ""Field Name for Content"" в XMLReader
если в процессоре PutDatabaseRecord , при выборе операции DELETE, нужно настроить условие WHERE, то это условие куда писать?
Читаю доку и не пойму. Правда там говориться что sql-запрос можно поместить в атрибут и выполнить целиком, но пока не хочу так делать.
Вопрос: как при операции DELETE задать условие WHERE в PutDatabaseRecord?
PutDatabaseRecord работает с выходными данными для DELETE используем процессор ExecuteSQL, где в качестве запроса прописываем нужную DELETE команду
Читаю многостраничный экселевский файл, ну то есть конвертирую из экселя в json.
Но почему-то все листы экселя записываются в один флоуфайл.
Как можно сделать так, чтобы каждый лист записывался в отдельный флоуфайл? 1) getfile
2) convertrecord
reader -> excelreader
writer -> jsonrecordsetwriter
""Required Sheets"" используй опцию у ExcelReader
Перед этим размножь входящий файл по списку листов, но нужно знать листы
Имя лисов нужно записать атрибут и атрибут использовать в настройке Required Sheets
у меня есть один процесс в котором условно 10 файлов и текст файл в котором описано как должны называться эти 10 файлов какой размер у них должно быть и сколько строк в них. В этом текст файле 10 строк каждой строке по линии написано название файла размер и сколько строк. Я этот файл разделил на строки всю инфу записал в атрибуты, но не знаю как провести сравнение информации полученную с этого текст файла с моими 10 файлами
Файл, который содержит данные это csv файл. Считаем его базой данных.
Прилётел файл. Читаем его метаданные.
Делаем lookup запрос к файлу csv. Если найдены такие атрибуты, то файл ОК.
(один из вариантов)
Активно использую nifi api , подскажите есть какая то функция или способ забрать id процессорной группы , в которой находится этот процессор в атрибут?
Ну что бы руками не копировать?
context.procNode?.processGroupIdentifier ?
кто знает, почему в дате стоит Т? процессор ListFile, атрибут file.lastModifiedTime, в хелпе The timestamp of when the file in filesystem was last accessed as 'yyyy-MM-dd'T'HH:mm:ssZ'
В дате буква ""T"" используется для разделения даты и времени в формате, который соответствует стандарту ISO 8601. Этот формат часто используется для представления даты и времени в международных стандартах и форматах данных
Источники
Подскажите пожалуйста, какой процессор для записи в базу лучше использовать? В моем случае субд mssql. Я использовал putsql, но возникли проблемы с записью дат, видимо ява не корректно указывает тип при вставке. Datetime2(7) и datetimeoffset. В источнике данные в этих форматах, но при работе процессора пишет ошибку парсинга
PutDatabaseRecord
Как лучше вытащить значения json в параметры и использовать их для запуска процедуры в субд?
evaluateJsonPath
Запрос в кликхаусе не удается выполнить из nifi там запрос truncate * on cluster *; Т.е. похоже будто бы nifi не может обработать ответ на каких нодах выполнился запрос
Нельзя такие запросы отдавать. В конце должен быть select в виде таблицы, даже select 1 as x
Всем добрый вечер, подскажите пожалуйста, можно ли делить контент пополам? На вход идут txt файлы разного объема
Есть counttext и там есть вариант подсчет числа знаков или строк. А дальше через extractrext + updateattribut в котором сделать что-то вроде substring с указанием сколько ( от и до) знаков забирать
Есть задача периодически, раз в сутки, выгружать данные из 1С и складывать их в Postgres, немного трансформируя. Подскажите, пожалуйста, каким образом можно это сделать с 1С? Данных примерно 1-1.5 млн строк, суммарно по всем таблицам. Какой способ будет оптимальным в данном случае?
Если вы выгружаете данные из 1с в виде csv и кладете раз в день то стандартными средставми инсерта csv, а если хотите более оперативные данные то лучше какойнить коннектор повесить на 1с типа бивью и тянут чаще и в постшрессе инкрементально загружать
Версии
Мы установили себе на сервер Redis Sentinel. 1 мастер и 3 sentinel. Не получается подключиться к нему из NiFi. Пишет, что не может найти мастера по имени mymaster. Я попробовал подключиться к этому же серверу редис через C# и все ок - данные пишутся и читаются. В чем может быть подвох? Использую RedisConnectionPoolService и RedisDistributedMapCacheClientService.
У нас 1.25 версия. Ради эксперимента поднял в Кубере redis standalone. И все работает. NiFi читает и пишет. Видимо не все в порядке с sentinel
Как можно посмотреть различия между версиями, например, что добавили и что убрали
Это называется what's new кажется. Идёт к каждому релизу отдельным файлом. https://cwiki.apache.org/confluence/plugins/servlet/mobile?contentId=60624477#content/view/60624477
Вопрос уже обсуждался, но запамятовал результаты. В ранних версиях (до 1.15.3 точно) невозможно было использовать сенситиве параметры в формировании api-запросов, что в адресах, что в данных. Сейчас есть возможность такого использования? Интересует версия 1.22.0.
Через настройки можно прописать вроде какие параметры сенсатив Если про это речь Настройки найфай
Планируем переезжать с NiFi версии 1.12.1 на 1.26. Естественно через тестовый контур. Кто обновлялся со старых версий - подскажите есть ли какие подводные камни? Буду рад если поделитесь статьями, которые вам помогли.
Рекомендую на тесте подсунуть flow.gz, и если все пойдёт хорошо, то принять за рабочий вариант.
Как второй вариант, миграцию можно сделать через Registry
Ребята, подскажите пожалуйста, верно ли я понимаю, что nifi (версия 1.20) по умолчанию пишет логи в файл - nifi-app.log
и нужно только прочитать их процессором TailFile?
Попробовать не могу, похоже прав нет...
там 3 лог файла в зависимости от того что нужно но основной да правильно nifi-app.log
nifi-user.log или как то так для пользовательских действий
и есть совсем системный
Хотел установить iceberg в nifi , оказывается он не идет по умолчанию в сборке. Установил версию 1.26.0 ставлю nar файл в папку lib и запускаю, но он пропускает данный файл . Кто делал схожее?
Без сервисов не будет работать

Дополнительно
Как поставить на мониторинг общее количество данных в очереди? Как в zabbix реализовать?
Недавно рекомендовали вот это ,например
https://youtu.be/2ym_xxuOp1g?si=A8-uFcOa1rYh1s2E
Подскажите, какими способами помимо Join Enrichment, можно соединить в 1 поток 2 json файла
UpdateRecord + Merge + QueryRecord
Подскажите пожалуйста по своему опыту - на сколько хорошая практика включать процессоры найфай через аирфлоу только на момент работы, и выключать их на время простоя? и если это хорошая практика то в связи с чем? ( я предпалогаю что это помогает снизить нагрузку на систему в простое, а так же уменьшает шанс зависания процессора в старом состоянии, например когда поменялись типы поля в таблице, а процессор думает, что они все еще старые)
Если поменялись типы полей, то надо не процессор дёргать, а сервис.
Насколько понимаю, включённый процессор систему, по сути, не грузит.
Подскажите, пожалуйста как используя JsonTreeReader/JsonPathReader для PutDatabaseRecord задать тип в avro.schema для записи в столбец с типом Timestamp в базе. Формат даты в приходящем json следующий: yyyy-MM-dd’T’HH:mm:ss. Это значение указал в Timestamp Format и тип в авро схеме указал как string, но не работает. Пишет следующую ошибку:
column is of type timestamp without time zone but expression is of type character varying
Тип не string.
""type"":{""type"":""long"", ""logicalType"": ""timestamp-millis""}
У меня есть группа процессов, которая запускается по расписанию. Мне нужно избежать повторного запуска цепочки процессов вне расписания. Есть ли какой-то процессор, который бы проверял, запущена ли цеплчка(группа) процессов или нет и в случае такового, мог заблокировать повторный запуск?
Пока что я ищу решения для реализации такой логики
Сразу после запуска, читать флаг (дату запуска) из внешней БД.
Далее RouteOnAttribute если процесс ещё не завершился.
По завершению обновлять влаг в БД.
Стою на перепутье. Не знаю какой инструмент лучше использовать. Может быть подскажете. Задача : надо забирать данные из rest api с различных ендпоинтов по различным токенам( более 100 шт) с различными датами на вход( где период в зависимости от текущей даты, а где опрос на -N дней). У каждого метода свои ограничения на вызов. Расписание - где раз в 4 часа, а где и раз в минуту/секунду. Соответственно должны опрашивать по ендпоинтам по каждому токену/дате и дальше класть в БД. Набор токенов лежит в БД( меняется динамически). Подскажите какой инструмент вам кажется логичней использовать. Смотрел в сторону nifi, но по ощущениям он все же немного для других задач.
Смотрел уже в стороне airflow , airbyte
Airflow. Можно и загружать им данные. нет никаких трудностей, вот только расписание лучше там делать не чаше 1 минуты
Nifi тоже подойдет - создать таблицу метаданных, описать источники данных, токены и т.п.
получаю из mysql набор данных и нужно одно из полей из string перевести в array
как поняла схема авро не поможет❓
Можно через любое преобразование. JOLT, JSLT, либо sriptedtransformrecord.
Везде пишут, что у правила крон нет секунд. Но в нифи есть поля 3 0/15 * * * ?, т.е. 6 полей. Первое поле секунды?
Есть разные форматы крона. В кварце есть секунды
Очень часто тут рекомендуют Авро схемы. Неужели настолько часто можно гарантировать порядок данных ? У меня наоборот, применение схем очень редко, только в случае если я сам селекты в базу делаю. Вопрос скорее риторический.
Или методология такая - сначала гарантируем порядок, потом накручиваем Авро?
Порядок роли не играет.
Хочу миллион строк переложить из Клика в Грин. Nifi сможет затянуть все данные через select * или надо на батчи расскладывать?
Разложи по 100к строк. Или 50к. Трудность вставки в GP в том, что через jdbc формируется многосрочный insert, и там надо выбрать баланс если это разовая заливка, то делай через мастер. если регулярная, то надо другие механизмы делать
не совсем понял, как это сделать с использованием SplitRecord. Я пытаюсь вычитать с использованием JsonTreeReader, указав эти настройки, но он ничего не находит. А при указании Root Node контент не меняется. Где я ошибся, подскажите пожалуйста
Для SplitRecord можно сделать вот такую спецификацию для JoltTransformRecord
[
{
""operation"": ""modify-default-beta"",
""spec"": {
""my_array"": ""=split('\\|\\|', @(1,message))""
}
},
{
""operation"": ""shift"",
""spec"": {
""my_array"": {
""*"": ""[&].message""
}
}
}
]
В результате после SplitRecord будут файлы:
{""message"":""some-log""}
использую lists3 для minio. После него стоит очередь с ограничением 100 элементов. И если даже стартануть процессор в режиме Запустить один раз, то очередь забивается тысячами элементов. Почему не работает ограничение и как ограничить сам процессор lists3 на количество выдаваемых файлов?
Ограничение работает не совсем так. Процессор ограничивается на запуск если очередь после него заполнена. Но в рамках одного запуска может быть создано файлов больше ограничения
Я новичок в дата инженерии и пробую инструмент nifi, и есть пару тупых вопросов
Можно ли интегрировать nifi с гитом и airflow, чтобы отслеживать изменения и вернуть если надо?
И как это будет работать, если nifi развернут на сервере для всех команды разработчиков?
Можете расказать свои опыт использования nifi в команде в целом
Буду благодарен за ответ!
Рекомендую начать и изучения https://nifi.apache.org/projects/registry/
Подскажите QueryRecord не понимает CASE может ее как то обернуть можно? или чем то похожим заменить?мне вообще нужно реализовать логику If else
https://calcite.apache.org/docs/reference.html - судя по описанию должен понимать
"А банально у LookupRecord Run Duration отличен от 0 ?
читаю SQL с помощью ExecuteSQL, дальше пишу с помошью PutFile. Однако, даже пустой запрос сохраняет (передает название колонок). Как то можно отфильтровать, чтобы запись была только если строки в БД появились?
routeonattribute по records.count (как-то так называется)
Кто-то сталкивался с тем, что при чтении из postgres (через executesql select * из таблицы) ругается на NaN? Unable to resolve union for value NaN with type java.lang.Double
Таблицы обрабатываются пачкой в потоке, приходится разводить и для этой отдельной запрос хардкодить с nullif. Хотелось более изящный и универсальный способ
в идеале задать схему на чтение, хотя вроде из постгресса с нулэйбл полями не было проблем
Возможно ли реализовать на Nifi извлечение данных из 500 тегов с периодом 1сек ?
Сделай селект LIMIT 1
нужен счетчик запусков потока, каждый запуск +1, как можно это сделать что бы не писать в БД?
Через DistributedMapCacheServer
ClientId указал в nifi.properties и в authorizers.xml
org.springframework.beans.factory.BeanCreationException: Error creating bean with name 'niFiWebApiConfiguration': BeanPostProcessor before instantiation of bean failed; nested exception is org.springframework.beans.factory.UnsatisfiedDependencyException: Error creating bean with name 'org.springframework.security.config.annotation.method.configuration.PrePostMethodSecurityConfiguration': Unsatisfied dependency expressed through constructor parameter 0; nested exception is org.springframework.beans.factory.UnsatisfiedDependencyException: Error creating bean with name 'org.apache.nifi.web.security.configuration.AuthenticationSecurityConfiguration': Unsatisfied dependency expressed through constructor parameter 2; nested exception is org.springframework.beans.factory.BeanCreationException: Error creating bean with name 'authorizer': FactoryBean threw exception on object creation; nested exception is java.lang.IllegalStateException: clientId required
“ClientId” было неправильно написано
Подскажите nifi логирует работу процессоров (сколько принял данных, какие трансформации выполнил, врем выполнения и т.д.)? ВАЖНО интересуют все логи и даже больше успешное выполнение.
Где это можно найти?
это не логи это не прямые метрики, они логируются но их очень много
Есть NiFi как ETL для DWH. Добавилась задача извлекать события некоторые из 1С и отправлять их в Kafka. Насколько нормальной будет вариант по http отправлять в NiFi сообщения из 1С, а дальше NiFi уже будет писать их в Kafka. Сообщения <1Мб, частота до 100/мин
А в чем трудность сразу в Kafka-Rest отправлять из 1с? При этом nifi ещё и сериализует в Confluent avro. Просто Архитектор против внедрения kafkarest
Подскажите, а как у вас реализована гарантированность отправки сообщений из 1С в NiFi? Очередь исходящих сообщений и если пришёл ответ от NiFi 200 OK, то помечаем как доставленное, а если нет, то повторная отправка в цикле спустя какое-то время? И как обратно в 1С сообщения отправляете? В 1С Http сервер и из NiFi просто на него отправляете? Если блокировки в документах в 1С и изменения в них не внести, то как-то надо в NiFi это обработать и реализовать повторную отправку спустя время?
Всё это возможно реализовать тем или иным способом, как на стороне 1С, так и на NiFi. У вас вопрос, прям, на архитектурный брейншторм тянет... Вам бы начать что-то делать с простого, постепенно усложняя. Глядишь, и вопросы сами разрешатся
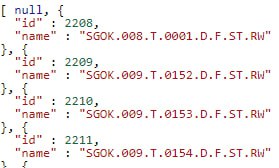
А можете подсказать, как можно убрать вот этот null в начале Json
можно попробовать [] вместо [&x]
"с Vault кто-то работает? Интересует, а есть возможность из vault'а получать не Sensetive данные, например, user_name?
интеграцию не делал, использовали Vault для хранения и тягали данные из него с помощью апи вставляя в NIFI.
В случае с интеграцией я так понимаю vault используется как хранилище для Sensative параметров только
Хочу поставить nifi в докер на линуксовой машине. Для этого надо разметить место, всего есть 500 гб.
Вопрос, как лучше сделать, подать все на var/lib/docker, т.к nifi будет в докере или подать место также на opt/ , т.к. это домашняя директория для nifi? Какая практика лучше?
Может быть нужно выносить opt/nifi папку вне var/lib/docker?
а зачем вам /opt/nifi ? Вынесите отдельно репозитории, и логи с конфигами. Как вариант еще библиотеки если потребуется
Подскажите, PutDataBaseRecordProcessor можно как-то заставить вставлять CSV в Postgres пачкой? Установил Maximum Batch Size = 0, но он всё равно генерит отдельные INSERT INTO на каждую строку
Чтобы этот процессор вставлял данные пачками нужно установить размер батча больше 0. Например, 1000. И на вкладке Scheduling изменить значение Run Schedule на что-то больше 0. Например, 5 sec. В этом случае он будет запускаться каждые 5 секунд. А накопившиеся данные будут разбиваться на группы по указанному размеру батча и вставляться батчем в базу. Надеюсь я правильно понял Ваш вопрос.
Всем добрый день, такой вопрос, приходит вот такой json
{""result"":[{""timestamp"":1714997458009000000,""addedTimestamp"":1715170281188000000,""valueDbl"":234.9,""valueLong"":null,""valueFloat"":null,""valueStr"":null,""valueBool"":null,""replaced"":null,""annotation"":null,""quality"":0,""qualityType"":""Good""}],""error"":null}
я из него в атрибуты достаю timestamp, но в атрибуте получаю timestamp [1714997458009000000] с такими скобками, пробую через replacetext убрать их но пока не получается,подскажите как можно их еще убрать ?
Потому что реплэйстекс работает ток с текстом, а не с атрибутами
может кто знает с помощью Apache NiFi RecordPath можно делать простые математические действия, сейчас интересует сложение (+)
посмотрел документацию RecordPath там нет plus
Хотелось бы в UpdateRecord что то вроде plus( \num +1 )
нет такого !? или через QueryRecord делать SQLем ?
В update record можно literal указать и работать со значение через field.value, в доке по процессору можно глянуть
Подскажите, есть процессор для получения данных из служба каталогов по ldap?
Нет
вроде недавно обсуждали, но кажется немного другой топик про CSV. В Nifi попадает csv, он читается ConvertRecord в Avro при этом в схеме (автосозданная) в одном поле может быть указано два типа (""float,string, null""). Соответственно, когда идем в PutDatabaseRecord (postgres), то получаем ошибку
Routing to failure.: org.apache.nifi.serialization.record.util.IllegalTypeConversionException: Cannot convert CHOICE, type must be explicit
кто-нибудь подсовывал nifi registry недефотную ветку в git при использовании GitFlowPersistenceProvider
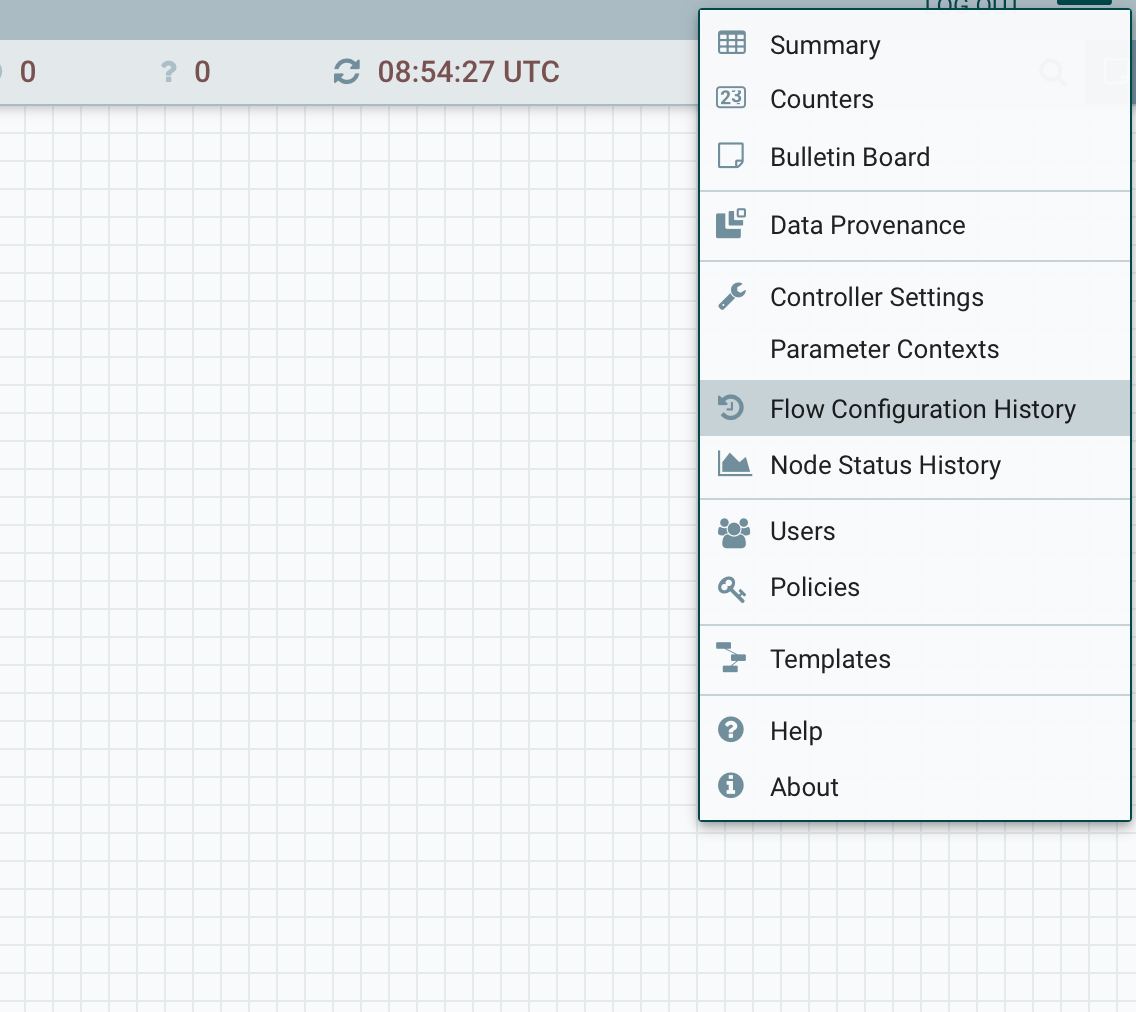
пытаюсь через апи получать информацию из nifi history
это неудивительно, но у меня не получается
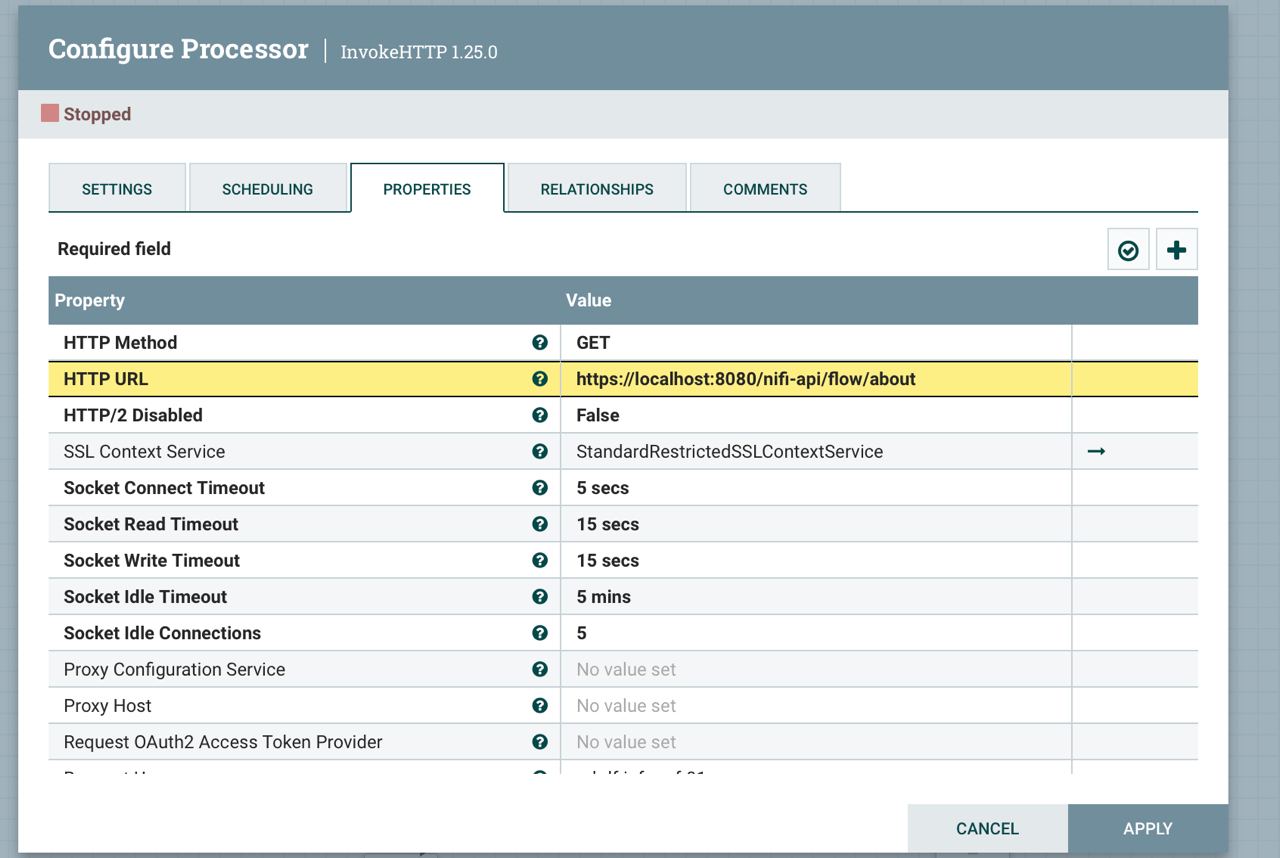
пробую через invokehttp достучаться до api - ничего не падает, но ничего и не отдаёт
Вообще-то, нужно вроде бы /flow/history. Как вариант, можно в браузере открыть консоль в инструменте разработчика и тыкнув в нужный пункт меню, посмотреть запрос
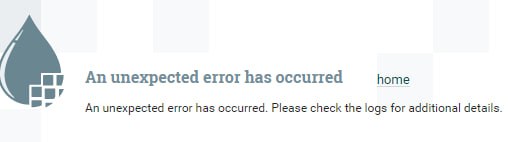
На серверном nifi есть дерево процессорных групп с процессами. Создаю шаблон для корневой группы, закачиваю его на диск, затем делаю аплоад шаблона в локальный nifi, но, когда пытаюсь добавить этот шаблон, то получаю непредвиденную ошибку с отсылкой за деталями к логам, но в nifi-app.log ошибок нет. Может, кто сталкивался с подобным? Используемый Parameter Context создал. Может, какого-то глобального ресурса не хватает? Но как понять какого?
надо посмотреть nifi-user.log или как то так файл в каталоге логов называется может станет понятней
Подскажите, кто знает как в nifi настроить системное время(time zone)? сейчас по умолчанию там стоит UTC, хочу поставить MSK. Что-то ищу-ищу, найти не могу.
ENV TZ=Europe/Moscow в энвы куберу
Кто-то использует сочетание NiFi + Kafka в качестве шины данных? Сейчас стоит шина, но от неё будем уходить. Думаю, насколько это сочетание подходит под шину? Ещё, если кто-то делал интеграцию NiFi с 1С (входящую и исходящую), как реализовывали? Создавали ли очередь в 1С или сразу в NiFi отправляли, как из NiFi отправляли в 1С, какие подтверждения доставки делали, делали ли повторную отправку?
Подходит как с Kafka так и без.
Есть уже production ready реализации (например у ребят из Росатом или ADS от Аренадата).
Знаю еще несколько компаний, которые уже перешли или в процессе перехода с ibm на nifi.
А есть опыт взаимодействия NiFi с SAP? Про IDoc в XML все ясно, используем веб-сервис в SAP (и обратно). Меня интересует IDoc в виде flat file. Кто-нибудь умеет скрещивать NiFi с SAP через SAP Java Connector (JCo)?
Можно тэгнуть alauda_arven(если он не против) и попробовать задать вопросы, они мигрируются с sap на nifi
Nifi v 1.23.0
Java 11.0.18-ea
Подкладываю JDBC для работы с оракловой базой: ojdbc11-23.4.0.24.05.jar
При выполнении запросов периодически получаю ошибку
ORA-17056: Non-supported character set (add orai18n.jar in the classpath)
Собственно вопрос: а как Nifi скормить этот orai18n.jar?
В classpath через , или ; ? В dbcppool сервисе, если не ошибаюсь, есть параметр в котором указывается путь до драйвера, вот туда все прописать
возникла проболема с конвертацией json в sql. После JoltTransformJSON у меня имеется следующего вида json:
{
""first_name"" : ""test"",
""middle_name"" : ""test"",
""last_name"" : ""test"",
""created_at"" : """",
""updated_at"" : """",
""email"" : ""test@mail.com"",
""phone"" : """"
}
Далее я добавляю в артибуты еще UUID и потом через процессор replaceText формирую запрос, его конфиг:
Replacement Strategy - Regex Replace
Search Value - (?s)(^.*$)
Replacement Value:
INSERT INTO test_db (uuid, first_name, middle_name, last_name, created_at, updated_at, email, phone)
VALUES (
'${uuid}',
'${first_name}',
'${middle_name}',
'${last_name}',
'${created_at}',
'${updated_at}',
'${email}',
'${phone}'
);
но на выходе все значения кроме uuid пусты, в чем ошибка, неверно извлекаю данные в запрос или тут еще не хватает какого-то процессора?
Для этого просто применять JSonToSQL процессор. А лучше PutDatabaseRecord
При загрузке json через PutdatabaseRecord некоторые числовые поля грузятся как целые, а другие как .0, причем рандомно
Причем в источнике все целые
Как можно принудительно прописать единый тип?
Использовать Avro схему.
Добрый день, использую процессор PutDatabaseRecord для вставки в postgres. Проблема с таблицей user, так как это имя зарезервированное в postgres и соответственно указав в Table name: user приводит к ошибке 'ERROR: syntax error at or near ""user""'. Если указывать в кавычках ""user"", то процессор уже не может найти эту таблицу, а она есть. Есть способ это имя как-то еще указать что-бы запрос был обработан?
Quote Column Identifiers или Quote Table Identifiers - настройки в теории должна помочь
С использованием процессора JsonQueryElasticsearch получаю документы из индекса эластика. Запускаю процессор каждые 5 секунд, а вытаскивает по приниципу now-5m TO now, соответственно будут документы которые вытащатся несколько раз. После чего мне необходима проверка, с какими документами nifi работал, а какие получает первый раз. В зависимости от результата либо делать по процессу, в котором он потом добавит его в список ""работал с ними"", либо просто пропустит по причине ""уже работал с этим доком""
Была идея поднять отдельную Postgres базенку и там хранить список уже отработанных доков, но может у кого есть идея лучше и производительней?
DetectDuplicate для этого создан.
К нему надо redis
почему HandleHttpRequest съедает так много ресурсов в ожидании? Run Schedule что-ли ему задавать !=0 ?
По умолчанию у него стоит раз в 10 мс. Поэтому так часто. 1. Тут вариантов нет все пуш интеграции будут кушать ресурсы
2. Количество запусков не мапится на ресурсы не в прямую
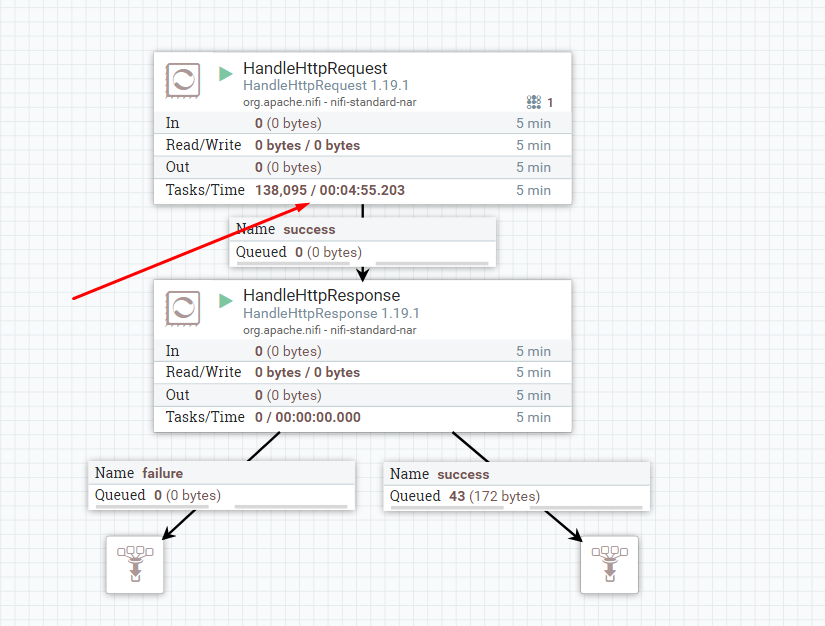
как вы делайте оптимизацию потока данных в nifi,если летит ну очень много flow каждую секунду, current task уже на максиму выкрутил что еще можно сделать ?
Увеличивай время работы проца, даже 25мс дают ощутимый прирост, гораздо лучше, чем конкаррент. Для скриптов - выгребай сразу 100-1000 флоуфайлов и обрабатывай в цикле
Коллеги подскажите как обнулить зависши байты ?
через empty all queuesнажмите по пустому месту правой кнопкой мыши, во всплывающем окне это будет вроде бы самая последняя строчка
Подскажите кто сталкивался: как отловить сообщения об ошибках, если процессор падает?
Необходимо получать нативные сообщения от процессора (сообщения об ошибках), а не те, которые можно самим написать в logmessage.
Они также пробрасываются в Log но можно еще периодически сканить ендпоинт с бюллетенями процессора.
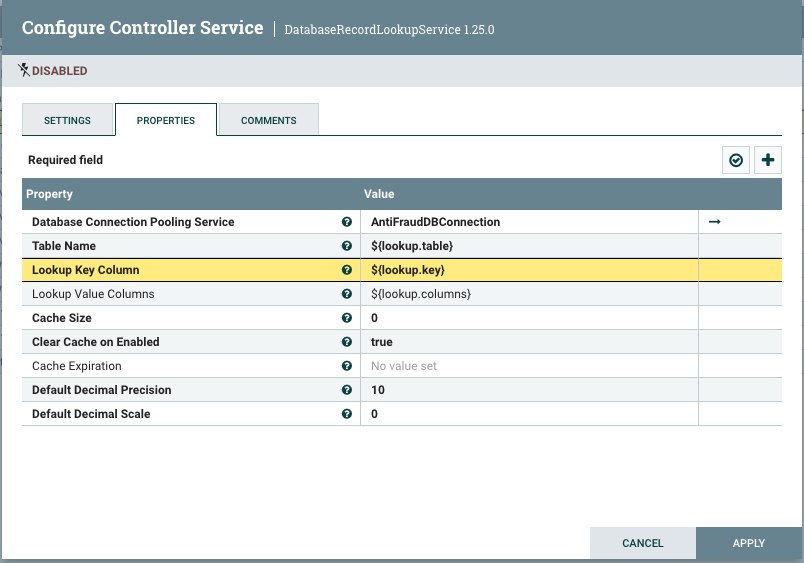
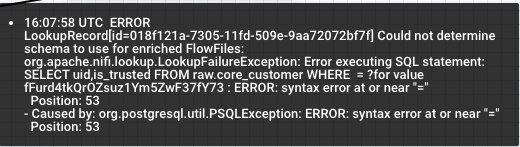
Странное поведение DatabaseRecordLookupService, NIFI 1.25.0 - в поле key не резольвится аттрибут. Во FF аттрибут установлен (скрин 1), прописан в в сервисе (скрин 2), но при этом в запрос не попадает. (скрин 3). Если явно прописать значение аттрибута, то ок, другие аттрибуты нормально резольвятся
Мне кажется, он не поддерживает атрибуты.
При переносе dataflow через nifi registry controller services должны переноситься или их нужно будет заново создавать?
внутренние точно переносятся внешние нет помоему
Не могу отправить post-запросы в сервис nifi, выходит ошибка 403 access forbidden, как можно предоставить права доступа?
Это к админам вашего Nifi. Смотрите доступ, права для пользвоателя, телнетом проверяйте открытый порт и так далее.
У меня есть json в виде массива внутри объектов другого массива.
То есть примерно вот такой json:
[
{
«ВнутреннийМассив»: […]
},
…
]
Я использую JoltTransformJSON и в результате выполнение своего jolt-spec получаю, элементы внутреннего массива как объекты главного массива. Проблема заключается в том, что некоторые внутренние массивы приходят пустые без каких либо элементов внутри: []
И эти пустые массивы выходят в моём конечном json как null:
[
{
…
},
null,
{
…
},
…
]
Подскажите, пожалуйста, как можно избавиться от этих null внутри моего конечного json? Можно ли как-нибудь подправить jolt-spec чтобы всё работало так как мне нужно?
Перейти на JoltTransformRecord.
Вы получите record на выходе, т.е. массив Record, а нуловые записи не пишутся в результат
подскажите, в Controller Settings во вкладке management controller services можно создать сервис, например, AvroReader. Но не получается его использовать в процессорах. А если в процессоре создать сервис, то его не видно в management controller services.
Вопрос как и для чего можно использовать management controller services
они используются, например для ReportingTask это сервисы уровня приложение Сервисы для потоков в конфиге групп или в конфиге рутовой группы
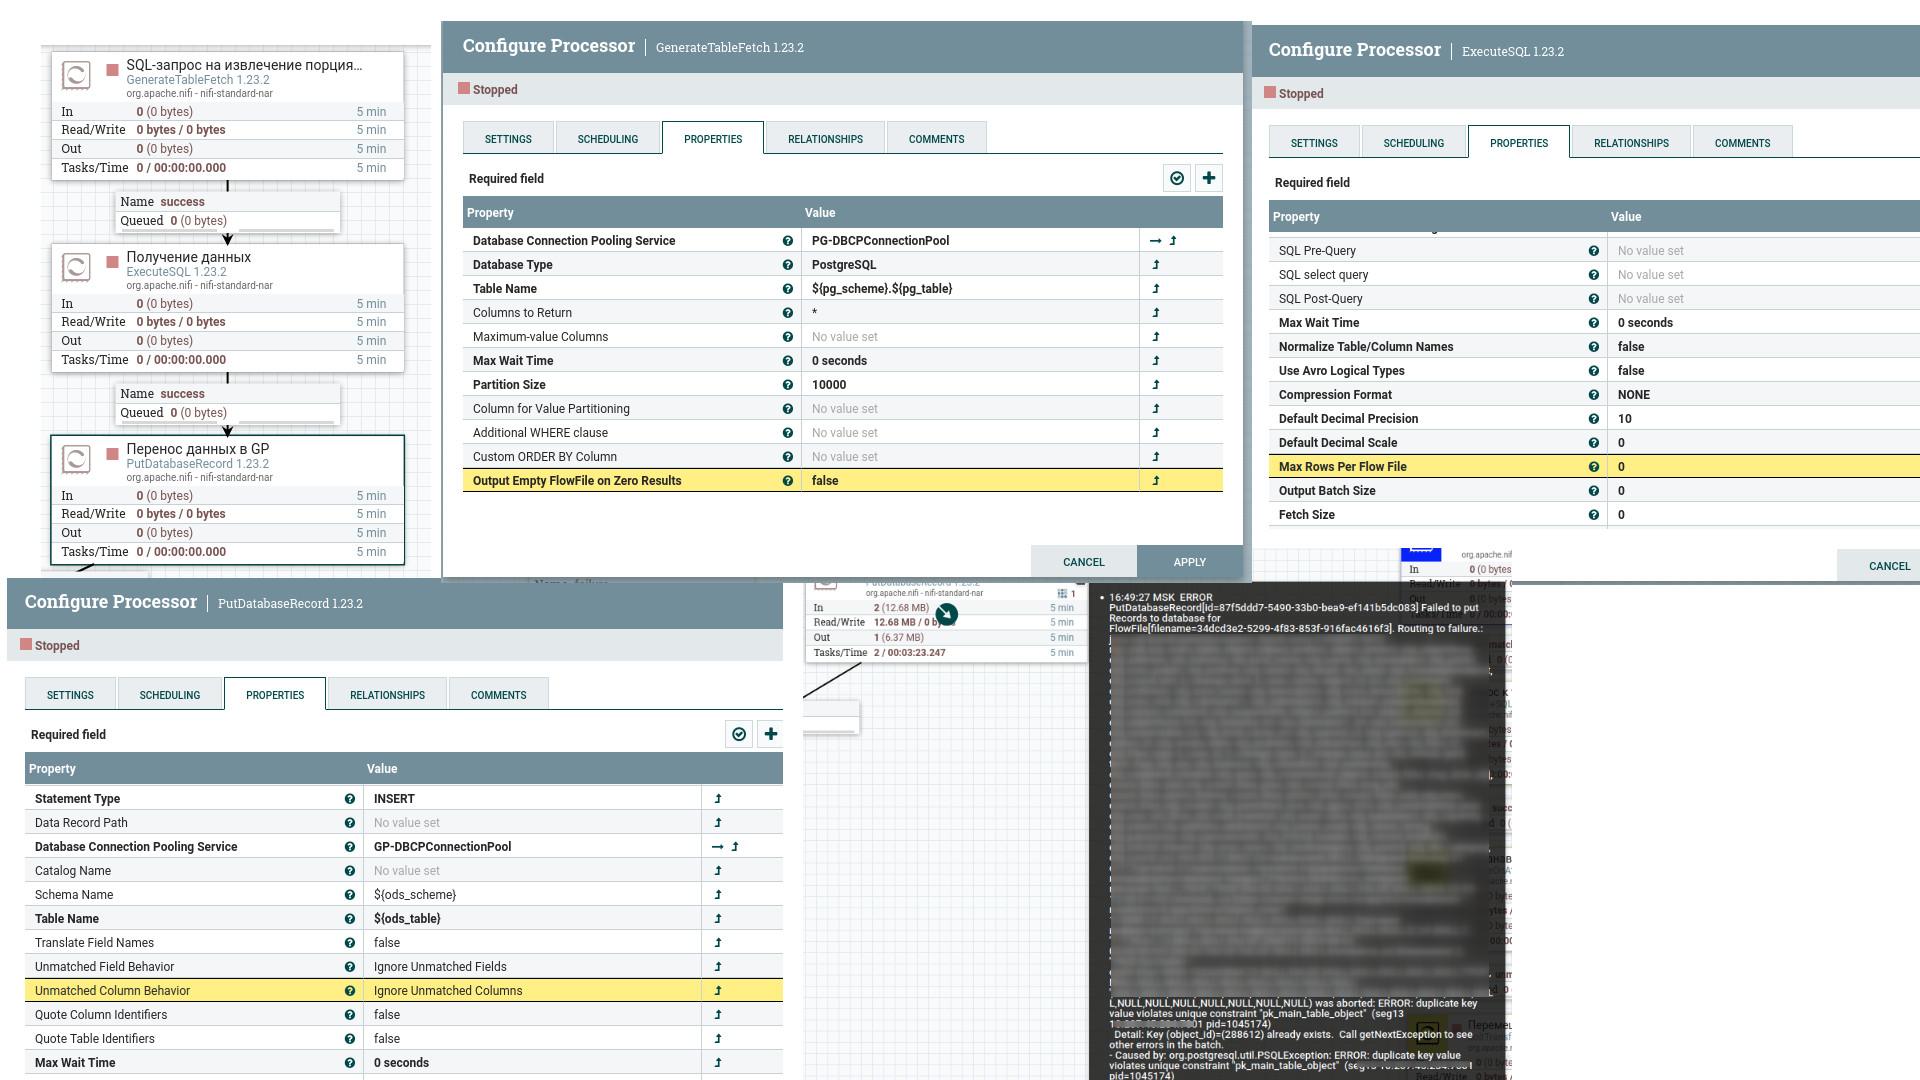
Столкнулся с такой проблемой.
Имею пайплайн на скриншоте. При загрузке вылезает ошибка. Однако проблема в том, что на источнике нет дублирующих записей по PK, на приемнике нет записей (пустая таблица). Есть какие-нибудь особенности настройки GenerateTableFetch? Создается впечатление, что записи загружаются дважды, как такое возможно?
ExecuteSQLRecord надо применять
Ребята в nifi json самый лучший способ чтобы передать данные в бд или есть еще варианты хорошие? В идеале разобрать входящий поток и собрать заново. Просто устал воевать с jolt, каждый раз все сложнее схема становится, слишком много чего может изменяться во входящей схеме
Передавать в бд можно и csv и avro ...
Jolt не виноват))
подскажите пожалуйста где хранится значение sensitive variable, и возможно ли перенести это значение с помощью nifi-registry?
Во флоу, в зашифрованном виде.
Также, если вы применяете какой-то провайдер, то в данных провайдера, например в БД либо в Vault.
Нет, через Nifi-registry эти параметры не переносятся
подскажите пожалуйста, как к примеру переносить процессоры в которых заданны такие переменные ? К примеру password и тому подобное ?
Применять CLI. Также применять настроенные ParameterContext Provider. Например, самое простое - располагаем файл типа key=value, подключаем файл провайдер на параметры контекста. Получаем sensetive параметры. Минусы очевиден - параметры в файле на хосте нифи. Самый самый способ - через Vault
Сейчас пишу на hdfs через nifi.
Компакчу файлы до 100 мб через MergeContent.
Получилось такое:
ConsumeKafkaRecord - >
MergeContent - >
MergeContent - >
PutParquet
Первый MergeContent делает из мелких файлов чуть крупнее файлы, второй уже до 100 мб добивает.
Сейчас это стало подвисать.
Вчем может быть проблема?
Может есть лучше пайплайны для такой задачи?
Применять merdgerecord
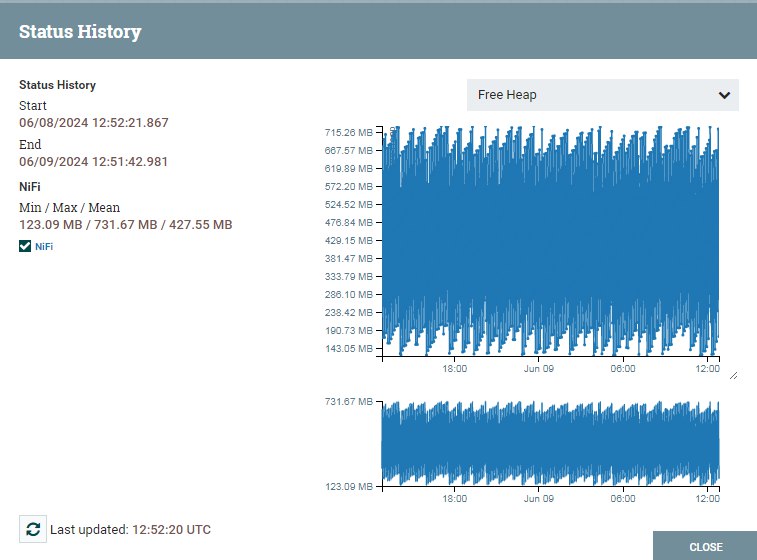
Подскажите, пожалуйста, а как можно мониторить нагрузку внутри nifi не пользуясь какими-либо внешними инструментами? То есть используя только nifi
Я вижу, что можно смотреть через Node Status History, но не совсем понимаю почему такая высокая нагрузка если все процессоры на данный момент выключены
Или я видимо не совсем понимаю данный график и что он отображает)
мониторить можно через ReportingTask
Есть вопрос - время от времени приходится отправлять результаты sql-запросов по email.
Есть ли способ отправки таблиц в виде нормальной html-таблицы, а не в виде csv-шки?
встроенного нет как мне кажется. Только построчно пробегать и replaceText делать с <tr><td>
https://stackoverflow.com/questions/67415315/generate-html-table-and-sen... вот альтернативное решение
Подскажите, пожалуйста, вот есть процессор distributeload, который распределяет флоуфайлы, но он нужен ли(ведь можно использовать load balance strategy?) и когда стоит его использовать? То есть вопрос - можно ли вместо этого процессора просто очередь настроить load balance strategy? И если предпочтительнее distributeload, то в каких случаях?
так он же про другое он между нодами не распределяетю. Процессор поделит файлы по очередям (раскидать в рамках одной ноды)
Стратегия LoadBalance раскидать файлы по разным нодам
Добрый день, подскажите пожалуйста, как указать токен в InvokeHTTP?
в документации в прикладе имеется такой пример с curl
curl --request GET --url http://<ip>/ --header 'Authorization: Bearer dfjngspidjhnpfdsjong' --header 'Content-Type: application/json'
В dynamic property (+) добавить
Authorization - название
Bearer dfjngspidjhnpfdsjong – значение
подскажите какие процессоры применить, в xml в 1 тэге нужно поменять значение, далее добавить новый тэг и потом обновлённый xml буду отправлять дальше пока вижу связку EvaluateXpath/XQuery -> RepalceText, но вот как добавить новый тэг/тэги в существующею структуру xml?
если не ошибаюсь можно использовать встроенный процессор TransformXML, который применяет к флоуфайлу XSLT
а как можно динамически создавать parameter context?
Через API NiFi
Добрый день, такой вопрос, требуется добавить поле в json, возможно ли с помощью LookupRecord сделать аналогичный поиск как например с помощью данного sql запроса
SELECT
MIN(UserPlan.FirstPurchaseDate)
FROM UserPlan
WHERE UserPlan.PlanId = Id;
то есть ключу может соответствовать несколько дат и нужно выбрать минимальную дату, если нет, то как еще можно реализовать данный сценарий?
Точно можно сделать lookupAttribute
Только селект переиграть
SELECT
PlanId, MIN(UserPlan.FirstPurchaseDate) FirstPurchaseDate
FROM UserPlan
group by PlanId
Селект этот подставлять вместо имени таблицы
Получишь дату в атрибуте, далее UpdateRecord
Добрый день, подскажите пожалуйста, как то можно замерить результат работы процессоров, нужно для того,чтобы узнать, какое из решений работает быстрее
По status history можно померять, но не все можно попробовать печатать в лог start и end, понятно, что там будет лаг небольшой, но то же как вариант
Подскажите пожалуйста, какой процессор для записи в базу лучше использовать? В моем случае субд mssql. Я использовал putsql, но возникли проблемы с записью дат, видимо ява не корректно указывает тип при вставке. Datetime2(7) и datetimeoffset. В источнике данные в этих форматах, но при работе процессора пишет ошибку парсинга
PutDatabaseRecord
Подскажите, а кто каким продуктом пользуется? Н-р, чистый отдельный опенсорсный NiFi, или в составе какого-то решения (с модулем ETL на NiFi)? Если не секрет?
Apache.
А еще ADS от Arenadata.
Не подскажете можно ли avro схему настроить так чтобы значение строкового поля json при превышении длины в 1000 байт менялось на какое-нибудь дефолтное значение или на пустую строку “”?
можно сделать через updaterecord и ifElse
Подскажите как прописать параметры get запроса в invokehttp, чтобы не в url?
пользовательские свойства уйдут в заголовки.
Подскажите пожалуйста, как сделать задержку перед следующим процессором дождавшись пока передыдущий доделает все флоу. Например: есть процессор записи в базу, и после обработки его последнего флоу надо стартовать следующий процессор.
это не очень история для NIFI, а так смотри настройки группы там есть батчевая обработка группой, но это однозначно не простая тема.