

FAQ по Greenplum
Версии
Где можно скачать свежую версию GP из России?
https://github.com/greenplum-db/gpdb/releases
версия Арены
https://arenadata.tech/en/products/arenadata-db/
Подскажите пожалуйста, какую версию postgres использует GP 6.23?
9.4
Как работает мониторинг GP? Из коробки вьюхи gp_toolkit - ну просто никакущие.. Просто обёртка над серверным CSV логами, где метрик производительности по промышленным масштабам считай что и нет. Есть упоминания gpperfmon , который для старых версий был актуальным, а для новых - его просто не кладут и отправляют в Greenplum Command Center. Про последний говорят, что он не совместим с perfmon расширением и предоставляет свою версию. Но вот что-то я никак не пойму лицензию и опенсорсность этого CC..
Если внимательно присмотреться к строкам того ELF файла, то можно обнаружить, что репозиторий этого продукта таки сидит на гитхабе, но он закрытый.... Помогите разобраться плиз что да как с мониторингом....
Tanzu - GPCC платный, Arendata - ADCC аналог GPCC, но скромнее и в платном ADB, ванильный GPDB - только самописный
Только начинаю с greenplum. Кто-то пользовался VMware Command Center для управления и мониторинга? Если да, то насколько я понимаю, он бесплатный, я не нашел какой либо информации у них на сайте по лицензии и скачал его без проблем. Может также можете другие инструменты порекомендовать?
Отдельной лицензии нет. Просто работает с платной версией, а в свободной собранной функциональность зачищена нужная.
может кто то сталкивался с такой ситуацией, делаем expand на тестовом кластере, обработка в процессе, хочу посмотреть статус/детали обработки. Но не могу найти схему gpexpand. Раньше помню, создавалась такая схема, где можно было смотреть кое какую информацию. Сейчас ни схемы нет (смотрю в pg_catalog.pg_namespace), ни отдельной базы на мастере. Версия ADB 6.22
В базе postgres смотрите? Схема gpexpand создаётся именно в ней и, на первый взгляд, это поведение захардкожено
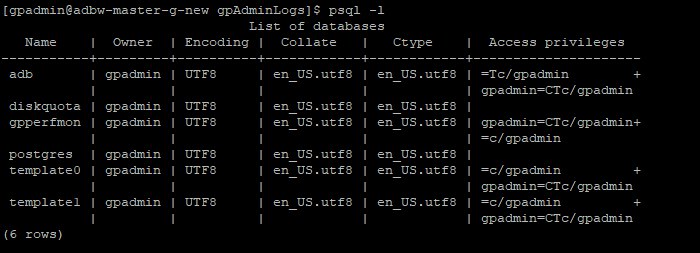
Мне нужно получить список таблиц в определённой схеме. Проблема в том, что в information_schema.tables и pg_catalog.pg_tables есть таблицы вместе с партициями, а мне нужны только партиции. Подскажите, какой наиболее простой способ получить список таблиц без партиций.
P.S. Версия PostgreSQL 9.4.26, соответственно в pg_class поля relispartition ещё нет.
Проверить отсутствие описания партиции в pg_partition_rule? партиции имеют в названии _prt_ шаблон. если таблиц с таким сочетанием нет и название самих партиций дефолтное - like % самый простой способ
ALTER TABLE tname SET (orientation=COLUMN); - не работает
Эта опция только с 7 версии работает
Коллеги, напомните плиз, можно ли на уровне кластера изменить стратегию дистрибуции по умолчанию? Хотелось бы видеть RANDOMLY вместо первой колонки таблицы.
З.Ы. Версия 6.22
gp_create_table_random_default_distribution
Как запустить gp на ноде? Мастер живой, первая года тоже. А вторая не стартует.
В gpAdminsLogs:
could not connect to server
и порты всех мастеров и зеркал
Разница конфигов/версий GP на ноде и мастере. Либо сверьте конфигурацию, либо gprecoverseg -F
Ещё на права файлов сертификатов так реагирует
нужно ли устанавливать potgre или gp сам установит нужную версию?
Ставьте только gp
установка ADB бесплатна то есть в открытом доступе
СЕ версия - да
А в greenplum можно писать хранимые процедуры на plpg/sql?
Или вместо них используют функции?
зависит от версии gp. function работает, в т.ч. для cru - как в раннем pg.
Кластер
Есть кластер Greenplum, у которого две подсети для interconnect. Половина узлов сегментов находится в одной сети, половина - во второй. Мастер сервер подключен в обе сети. В таблице gp_segment_configuration можно указать только один адрес для мастер сервера.
Как правильно скорректировать таблицу для мастер сервер, чтобы он был доступен для всех сегментов? Возможно ли это на существующем кластере?
А это точно хорошая идея? У вас сервера уже в 1 vlan не помещаются? Просто если будет межнодовое взаимодействие, а оно скорее будет, то появятся лишние накладные расходы
Вопрос относительно добавления(изменения типа) колонок в существующую таблицу. При добавлении колонки, сохраняются ли параметры сжатия, указанные при создании таблицы? Есть ли разница в поведении колоночных и строчных таблиц? На что стоит обратить внимание, когда меняешь схему таблицы?
Был просто неприятный опыт, когда в объемную таблицу(размером около 1тб) я изменил тип колонки и у меня процедура шла очень долго нагенерила спил файлов на 400гб. В целом вроде понятно, почему так произошло, но возможно можно как-то этого избежать
В колоночной сжатие надо указывать, иначе будет дефолтное значение сжатия с кластера. Добавление в колоночная таблицу происходит быстрее. Для добавления/изменения столбцов лучше рядом делать соседнюю таблицу с нужными характеристиками, потом заливать туда данные с исходной таблицы. Потом делать switch table. есть ещё такой параметр gp_add_column_inherits_table_setting
левая и правая часть относится к одному сегменту (стата + реальное выполнение), как и весь план кроме некоторых пометок. Плюс gather motion и нижняя итоговая часть, которые описывают общую инфу по кластеру
Левая - усредненная, показателей как в левой части может не быть ни на одном сегменте.
как у нод GP изменить ip и hostname
Если много машин и это те же машины, и вы просто выключаете кластер, меняете ip все включаете назад, то я бы правил
Кто знает, как найти ноду, где хранятся настройки pxf?
На мастере точно есть. У каждого инстанса pxf могут быть свои настройки. На кажом узле свой инстанс. Встречный вопрос как кофигурировался кластер? 8)
Подскажите, как в GP сгенерить uuid ?
https://www.postgresql.org/docs/9.1/uuid-ossp.htmlhttps://www.postgresql...
При попытке добавить новый хост в кластер столкнулся в проблемой Not enough hosts for grouped mirroring. You must have at least 2, т.е. негде создавать зеркала и надо добавлять пару хостов.
Тогда я создал настроечный файл для gpexpand с запуском зеркал на том же добавляемом хосте и создал с его использованием сегменты. Потом сделал настроечный файл для gpmovemirrors, в котором перераспределил зеркала по остальным хостам кластера.
И такая схема даже сработала) но вопрос насколько это принятая практика или лучше таки добавлять хосты попарно?
Это нормальная практика. Можно добавить хост, перенести на него часть мирроров с других хостов, затем в gpexpand указать primary на новом хосте, а mirror на тех, с которых были перенесены. Таким образом более равномерно мирроры распределяются.
Если попарно добавлять и запускать gpexpand по умолчанию, то все мирроры с хоста попадут на соседний хост и в случае их активации нагрузка удвоится, что не очень хорошо
Случилось так, что отключали сервера с Greenplum в ЦОД. После завершения работ включили их обратно, и я пошёл восстанавливать кластер. Кластер нехотя, но поднялся, и сейчас я вижу на всех сегмент-хостах процессы вида fts handler process gpadmin, забивающие CPU до упора. Проверил мониторинг - до отключения такой нагрузки не было. Может сталкивался кто с таким? Как лечили?
Возможно, поможет перезагрузка
Если на нодах на которых развернут гринплам не используются ресурсные группы, то одна транзакция будет использовать все доступные ресурсы? Или я не прав?
Может быть две политики - группы или очереди. А дальше уже все идет от настроек дефолтных групп или очередей.
Групп по дефолту две - admin и default, а настройки надо уже на самом кластере смотреть.
select * from gp_toolkit.gp_resgroup_config;
В postgres есть представление pg_stat_statements, соответственно, пользователь, имеющий роль pg_read_all_stats может собирать статистику извне кластера. Как такое сделать в GP? In reply to this message
Сделать view через функцию и дать грант на его чтение нужным пользователям или группе.
Пример:
CREATE OR REPLACE FUNCTION get_stat_activity()

RETURNS TABLE (pid int, usename name, rsgname text, datname name, query_start timestamp with time zone, query_age interval, query_text text) AS $$

 SELECT pid, usename, rsgname, datname, query_start, age(clock_timestamp(), query_start) AS query_age, query AS query_text FROM pg_stat_activity WHERE state != 'idle' AND query NOT ILIKE '%pg_stat_activity%' ORDER BY query_age desc;

$$ LANGUAGE sql

VOLATILE

SECURITY DEFINER;

CREATE VIEW pg_stat_activity_all_users AS SELECT * FROM get_stat_activity();

GRANT SELECT ON pg_stat_activity_all_users TO my_role;
Прошу помощи сообщества.
Есть кластер из четырех датанод, на каждой датаноде по два сетевых интерфеса по 1Гбит/с.
Задача стоит использовать оба для интерфейса передачи данных в кластере.
Что я сделал.
Привел файл /etc/hosts к виду
192.168.1.5 mdw
192.168.1.5 mdw-1
192.168.2.10 mdw-2
192.168.1.6 smdw
192.168.1.6 smdw-1
192.168.2.11 smdw-2
и т.д.
привел файл hostfile_exkeys к виду:
mdw
mdw-1
mdw-2
smdw
smdw-1
smdw-2
и т.д.
запустил и обменялся ключами со всеми хостами.
gpcheckperf -f hostfile_gpcheckperf -d /data -r N -S 10G продолжает показывать 1Гбит/с для сетевого соединения между мастером и датанодами.
Вопросы:
- какие еще можно использовать способы, кроме gpcheckperf, чтобы проверить скорость соединения между датанодами и мастером?
- по предоставленным мной данным можете подсказать, что я упускаю и что стоит исправить и/или донастроить?
p.s. в гугле не забанен, документацию прочитал. Я что-то упускаю, но ввиду малого опыта не могу точно определить что именно. Добрый человек с напутственным пинком в нужном направлении - найдись!
Вам надо слить интерфейсы в bond. Тогда на этом интерфейсе будет один адрес на два адаптера. Коммутатор должен уметь поддерживать такие вещи. Причём бонд надо сделать именно на расширение канала, а не на отказоустойчивость.
Коллеги, подскажите, есть ли способ провести параллельное обновление кластера гринплам, минимизируя время простоя? Можно ли, например, обновлять сегмент хосты по очереди? Будут ли сегмент хосты разных версий взаимодействовать между собой без проблем?
Нет. Только обновление на всех хостах сразу. Время простоя и без того минимальное. Обновляешь пакеты на всех хостах и запускаешь кластер снова. gpssh в помощь, если хостов достаточно много
Подскажите можно ли как-то в greenplum добавить новую ноду везде пишут что надо использовать gpseginstall но этой утилиты нет в bin
gpexpand в помощь.
help более чем подробный.
Также требуется понимание типов зеркалирования(группы)и выделения кол-ва сегментов на хост.
Так как к примеру при использовании группы spread, при добавлении доп.нод в кластер, следует учитывать что кол-во нод должно быть больше кол-ва сегментов на мастер ноде. Запустите gpexpand без доп. флагов.
Утилита запускается в интерактивном режиме.
Попробуйте сгенерировать файл ответов, для последующей работы gpexpand с флагом -i и этим файлом.
Подскажите бест практис мониторинга кластера
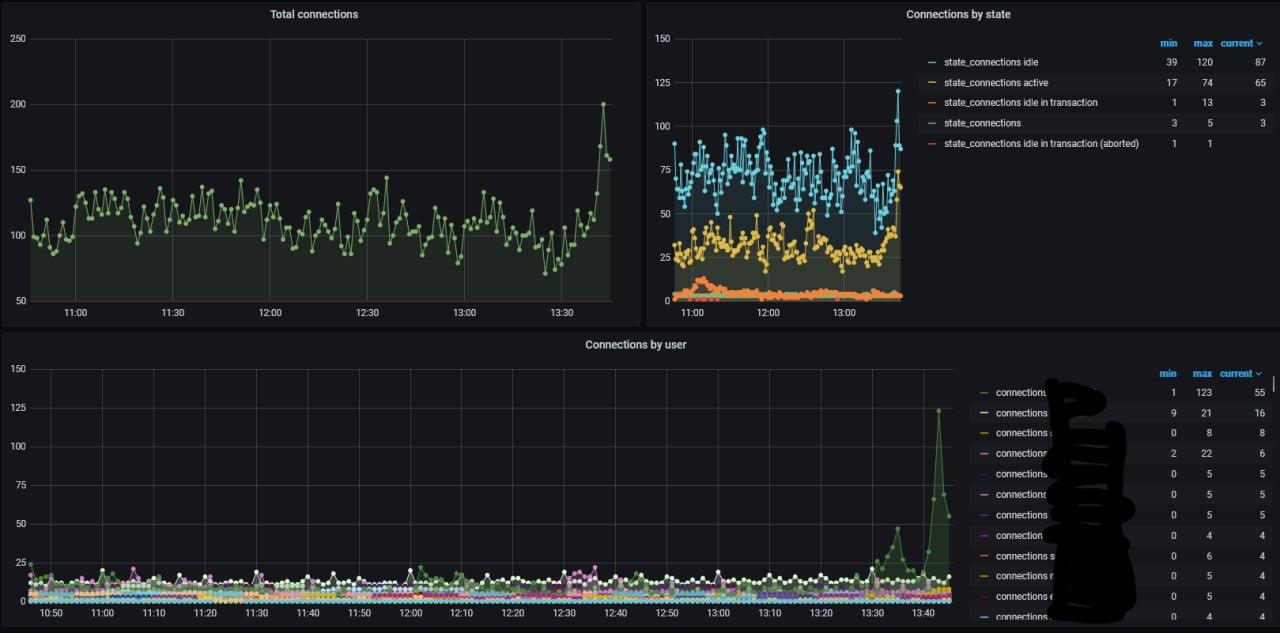
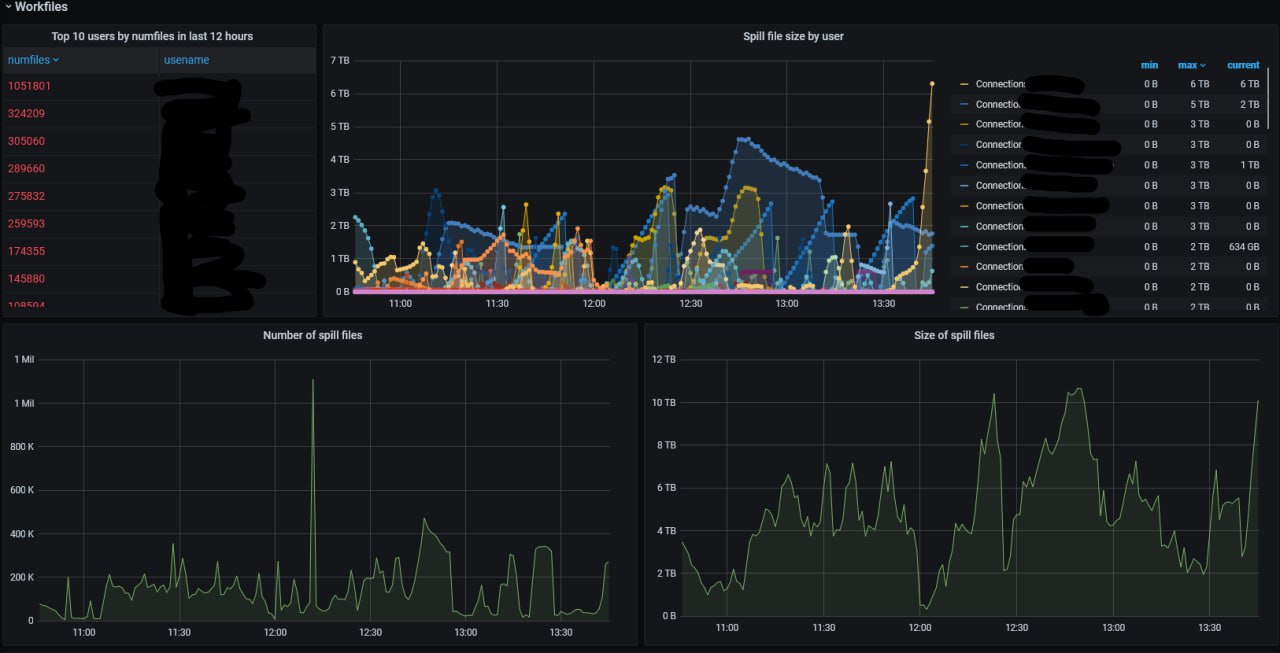
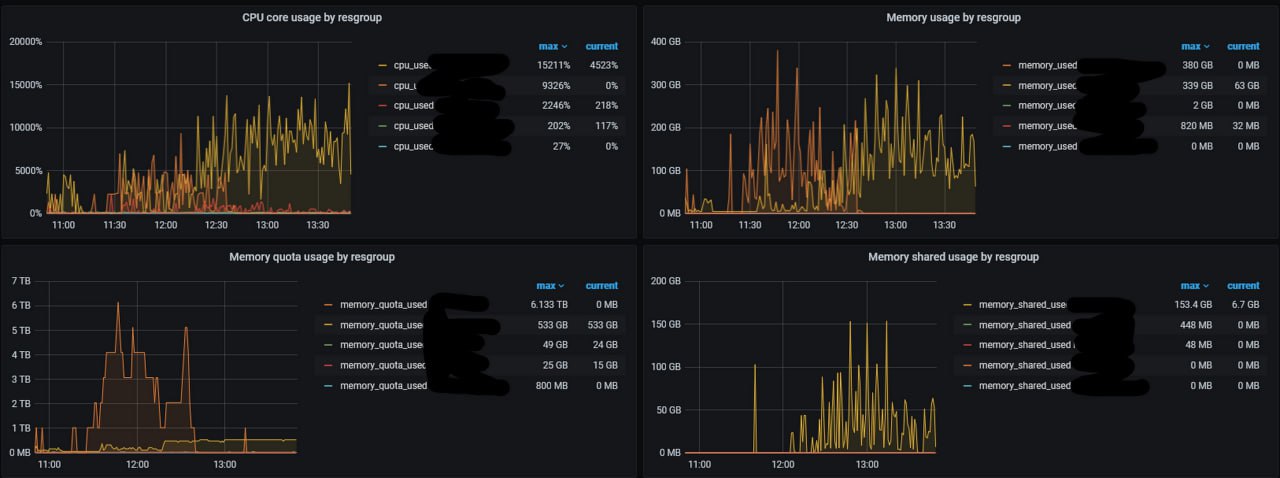
Нагрузка на Дисковую подсистему (iops, await и тд), CPU, Network, скрипты которые вытягивают инфу по спилам, по skew, еще парсим отдельно и вытягиваем инфу по ps_stat_activity, инфа по РГ
1. Имеет ли смысл делить монолитную БД в гринпламе и гонять данные между базами через External table?
2. Имеет ли смысл вообще делить монолитную базу в Гринпламе на несколько баз?
Я бы так не делал, потому что я не вижу, в чём выигрыш. Оверхеды большие. Делать stage -> dds в рамках одной базы удобнее. Марты можно выкатывать в Кликхаус или какой-нибудь duckdb, у кого какие запросы и предпочтения. Это если в БИ показывать, например.
2 прод кластера GP мне кажутся сомнительным решением.
подскажите пжлст какие отличия external от foreign таблиц??
Если не брать последние версии fdw gp, то fdw работает исключительно через мастер.
С external может работать каждый сегмент кластера
Коллеги подскажите, GP были инициализирован как --mirror-mode=spread,
Критично ли для него будет если вдруг упадут сразу 2 сегмента из 4, т.е половина?
Если у вас 4 сегмент-сервера, а сегментов на них 3 - то при spread потеря 2 сегмент-серверов гарантированно положит кластер
Решил посмотреть как распухает каталог. В цикле создал и дропнул 15000 таблиц.
Смотрю pg_stat_get_live/dead_tuples по pg_class. Живых примерно 11 000, мертвых 15 000.
Вопрос - почему распухания каталога не видно в gp_bloat_diag?
это работает:
1) gp_bloat_diag использует gp_bloat_expected_pages
2) та в свою очередь использует pg_class.relpages.
Так вот, пока таблица была маленькая, то relpages не менялся, да же с ростом мертвых строк. analyze не помогал. Таблица доросла до 700 мб и relpages обновился и все заработало.
подскажите несколько узкий вопрос. Кто работает с Greenplum от вендора Arenadata, если связь между adcm и адб потеряна, возможно ли ее восстановить?
К сожалению, необходимо пересоздавать заново. Возможности впихнуть уже существующий кластер в ADCM нет.
какой мониторинг систему посоветовали бы для gp кластера?
Забикс
Используем arenadata cm. Развернул кластер (небольшой), мастер, стэндбай и 4 сегментных хоста. Все завелось, но кластер не выставляет статусы готовности сервисов. Чек говорит, что отсутствует компонент diamond. Подскажите куда копать
Diamond это компонент мониторинга от аренадаты
На работу самого gp он не влияет
По идее adcm должен его ставить если разврнут мониторинг и стоит галочка
Подскажите пожалуйста, можно ли каким-либо образом по кластеру оценить эффективность запускаемого vacuum. Понять что вакуум давно не запускали или что для текущей нагрузке нужно пересмотреть расписание запуска?
gp_bloat_diag
Подскажите, пожалуйста, развернули кластер green plum в ЯО , но он не поддерживает хэширование sha-256 , есть только md5, который не подходит , нужен she-256. Кто нибудь сталкивался с такой проблемой ? Если да, то как решили ?
pg_crypto есть
(обычно хешируют это вне базы, а база просто хранит и выполняет джойны)
Подскажите пожалуйста, как sql запрос утилизирует ядра сегмента.
1) Правда ли что один sql запрос на время своей работы утилизирует от одного CPU на 100%. А если запрос распределённый(со слайсами), то и более одного CPU на 100% на все время работы запроса.
2) Если 1) верно, правда ли что, если на сегменте 4 CPU, то сегмент не может обрабатывать более 4 запросов(любых) одномоментно? То есть в любой момент времени Т на кластере имеем не более 4-ех работающих SQL запросов?
3) В общем случаи, зная конфигурацию кластера, можно ли оценить максимальное количество обрабатываемых запросов в секунду например?
Или все зависит от самих запросов?
2 - не верно при любых раскладах. Любое количество запросов размажется по доступному количеству ядер
Есть кластер greenplum в одном цод, планируем сделать резервирование в другом цод.
Возможно ли настроить репликации баз, что бы они были идентичны?
Нет, полностью синхронный реплики, если на них самих вносятся изменения, сделать пока не получается. При Dual ETL будут дифы по кластерам, при переносе с одного на другой будет отставание. Над этим вопросом сейчас много кто думает (как wal-репликацию на жругой кластер нормально сделать), но решений особо пока нет.
Можете ,пожалуйста,подсказать в каких случаях жизненно необходимо использовать именно tcp? Может кто-то сталкивался с такой ситуацией или видел статейки где рассказываются причины перехода на этот протокол?
TCP, когда совсем плохо с сетью. Но это уже изначально плохо и не стОит разворачивать кластер. Есть ещё прокси для интерконнекта, который даёт профит на не стабильных каналах, или при географическом распределении кластера primary и mirror, например
А на Астра Linux , кто нибудь ставил кластер GP ?
Да, работает

Обучение
А что можно почитать про потоки и ядра? Я думал это одно примерно
Современные операционные системы, Эндрю Таненбаум
https://pc-01.tech/hyper-threading/
https://youtube.com/watch?v=fKl2JW_qrso
Скажите, пожалуйста, существует ли какой-то самоучитель/учебник по GreenPlum (не документация) написанный понятным для новичка языком? https://www.academia.edu/34495138/Data_Warehousing_with_Greenplum_Data_W...
подскажите есть кто с опытом миграции с pg на Greenplum. Как правильно? С чего начать?
Со смены типов таблиц и определения ключей распределения для каждой из них. Главное — это таблицы и слои данных. Стандартизация, в том числе наименований, состава полей, служебных полей.
Нужно собрать правильно кластер, сконфигурировать кучу всего. Огромный плюс, что если вы на постгре, то весь SQL 1 в 1 переходит.
посоветуйте пожалуйста ресурс где можно почитать про установку gp https://cloud.yandex.ru/docs/managed-greenplum/operations/cluster-create
Подскажите как поглядеть дату сбора статистики обычному пользаку. :)
В pg_stat_operations https://docs.vmware.com/en/VMware-Tanzu-Greenplum/6/greenplum-database/G...
А есть какие-то open source решения для Command Center? Или какие популярные есть тулзы в комьюнити?
Нет, к сожалению. Аренадата поэтому свой CC развивает, но это только в поставке ADB Enterprise Edition тоже. В целом можно посмотреть ADB Community Edition как вариант вместо ванильного GP. Там CC нет, но управление через ADCM и встроенный мониторинг самого кластера доступны. Если не нужен web интерфейс . А просто инфа собираемая то достаточно gpperfmon.
а где сейчас документацию по гринпламу читать?
https://docs.vmware.com/en/VMware-Tanzu-Greenplum/index.html
Бэкап
Друзья подскажите способ перекатки данных из pg в gp,
Только с back_up ?
pxf или dump и copy
pxf подходит, если вы регулярно планируете смотреть в pg COPY in csv, потом можно загрузить их через pxf
gpbackup сделанный на gp 5.21 Linux 7, можно ли восстановить на gp 6.20 Linux 8
Рекомендуется восстановить сперва только мету с глобальными объектами, убедиться, что операция прошла успешно, после чего восстанавливать собственно данные.
Я что-то не понял, а что, gpbackup \ gprestore не входят в дистрибутив из коробки Arenadata?
или я опять накосячил?
Входят. Он должен быть в /usr/lib/gpdb/bin вместе с прочим, в частности psql
Подскажите, пожалуйста, best practices (лучшие способы) переброски данных с одного кластера GP с одним количеством первичных и зеркальных сегментов на развернутый рядом кластер с другим количеством первичных и зеркальных сегментов. Насколько я понял, из доступных не по подписке только pg_dump. А gpbackup и gpcopy по подписке и корректно работают только для переноса данных между идентичными по составу кластерами? Может, есть ещё способы, которыми вы пользуетесь для целей переброски данных между кластерами GP?
1)Если версия содержит gpf, можно через него. Метедату через Pg_dump перенести и занести данные через fdw gpf 2)gpcopy можно, но осторожно. Надо проверять скопированные данные. Корректность не гарантируется. Но скорость высокая
3)Можно и на кластера с другим числом сегментов переносить при помощи gprestore. Там опция появилась --resize-cluster. Но можно и руками файлы посклеивать (или новые пустые сделать, если сегментов на целевом больше).
имеется кластер на 28 сегментов, 4 хоста
хочу восстановить с него одну схему на кластере 8 сегментов, 1 хост
gpdb 6.22.2
gpbackup 1.27
используя --resize-cluster сталкиваюсь с проблемой:
Found incorrect number of backup files on 8 segments
или
Error encountered when executing statement: ALTER TABLE ONLY audit.calc_history ADD CONSTRAINT calc_history_un UNIQUE (calc_stage, calc_mode); Error was: ERROR: permission denied for schema audit (seg1 192.168.0.9:60001 pid=40017) (SQLSTATE 42501)
кто-то уже использовал resize-cluster успешно?
какие еще способы восстановления на отличном кластере есть, помимо gpcopy?
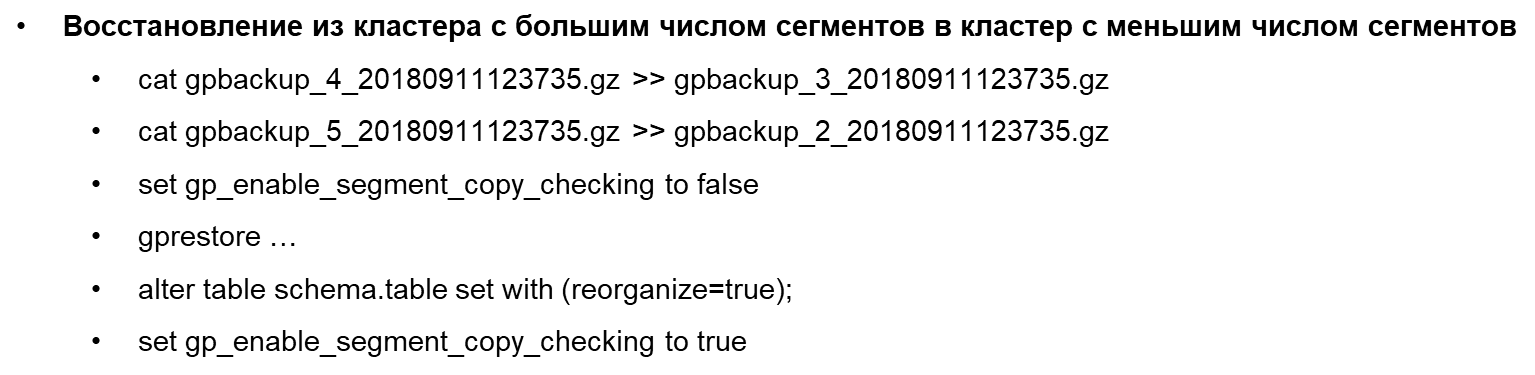
gpbackup+gprestore с ручной склейки файлов данных для сегментов можно использовать. Восстановление из кластера с большим числом сегментов в кластер с меньшим числом сегментов
Просто число файлов бекапа уменьшить, чтобы соответствовало числу сегментов
Сливая их вместе
Отключить проверку на соответствие сегментам
Залить, сделать реорганайз
Включить обратно
Можно и не выключать, но так быстрее будет
Столкнулась с такой проблемой: выполняю insert для таблицы, он выполняется продолжительное время. В это же время запускается backup с помощью утилиты gpbackup. Мой insert замирает на время бекапа. Правильно ли я понимаю, что бекап может влиять и создавать блокировку, которая мешает моему инсерту выполниться?
Блокировки смотрю таким скриптом:
select a.datname, n.nspname, c.relname, l.mode, a.pid, a.usename, a.application_name, a.query, a.state
from pg_locks l
join pg_class c on l.relation = c.oid
join pg_namespace n on c.relnamespace = n.oid
join pg_stat_activity a on a.pid = l.pid
where c.relname in ('таблица')
and
n.nspname = 'схема';
Вижу такие блокировки:
AccessShareLock gpadmin gpbackup_xxxxx
RowExclusiveLock myuser DBeaver
Можно ли сделать так, чтобы бекап не влиял на DML?
Нет нельзя...
Бекап shared блокировку на таблицы накладывает, что в них данные не разъехались пока бекап идет. Хорошая практика вообще всех из базы выгонять на время бекапа.
Может кто то сталкивался с таким кейсом, на тестовом контуре был отказ виртуализации
весь кластер GP ушел в аварийный ребут, после восстановления работы виртуалок, все primary сегменты не работают
при запуске восстановления ничего не происходит
И все, переключение на резервный мастер не помогло
В логе видно что выполняется запрос select gp_segment_id from gp_stat_replication where application_name = 'pg_basebackup';
он висит часами
Надо для начала проверить наличие сегментов gp. Еще можно проверить соответствих хостнеймов и айпишников в gp_segment_configuration актуальным

Кто-то помнит навскидку, gpbackup возвращает человеческий exit code по завершению? 0 = успешно, 1 = фейл?
0 - успех, не 0 - фэйл
Подскажите, пожалуйста, я тут где-то мельком вроде видел, что бекапы не включают в себя внешние pxf таблицы, это так?
Определения внешних таблиц всех есть в бэкапе, там нет только самих данных внешних источников. Включают.
gpaddseg добавляет сегмент а что если надо убрать сегмент ?
бэкап-рестор :)
Есть БД с 15000 таблиц и 300 схем. Есть способы быстро бекапить такие БД?
Сейчас она бекапится 6 часов, дальше будет больше. БД с 300 таблицами схожего размера бекапится за пару часов.
Для реляционных коннектов по jdbc можно пользоваться партиционированием внешней таблицы для достижения того же эффекта.
Функции
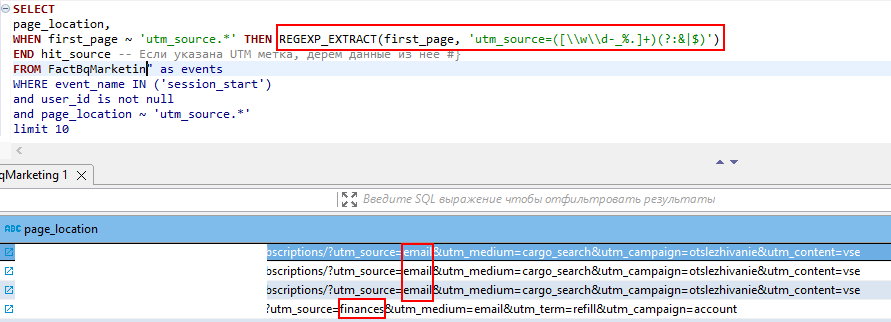
Прошу подсказать, чем в GP можно заменить функцию REGEXP_EXTRACT? На скрине пример, есть ссылка, вставляю условие, что если есть текст utm_source, то беру текст после неё до знака & (в первой строке email). В GBQ/Databricks работала REGEXP_EXTRACT, в GP нашел только пока regexp_substr, regexp_matches, но они немного не то делают.
не воспроизводимый пример
попробуйте:
with z as

( select 'arrr utm_source text what i need & bad text' as v

)

select regexp_replace(v, '(.*)utm_source(.*)&(.*)$', '\2', 'g') as res

from z
Вы можете ещё попробовать string_to_array с нужными разделителями в одном cte, а дальше через unnest выбирать нужный участок строки
кто может объяснить в чём проблема хранимой функции написанной на pl\python например для обучения модели ?
формально: ни в чём. В GP даже есть MAD для этих задач. Но если по уму, то для этого должен быть отдельный фреймворк для дата дрифтов, версионирования моделей, удобной визуализации и разграничения нагрузок
из минусов - тягание данных из базы для для обучения: а потом обратно, для результатов. Но, опять же, обогащение данных стоит делать до попадания данных в двх.
Кто-нибудь пытался с помощью pxf обращаться к функциям на базе-источнике или это невозможно?
https://docs.vmware.com/en/VMware-Greenplum-Platform-Extension-Framework...
Кто подскажет как передать в функцию параметр p_utc_offset для вычисления таймстампа не используя динамический SQL? Сейчас рвет и при компиляции требует задать параметр
CONCAT(p_utc_offset, ' h')::INTERVAL
Коллеги, подскажите пожалуйста, есть большая таблица, с 1000+ дневных партиций, задача схлопнуть все партиции в месячные кроме последнего, пытаюсь написать функцию без перекладывания всей таблицы во временную и что-то не могу найти оптимального решения
Писал нечто подобное год назад, может подойдёт или под свои нужды адаптируете:
https://github.com/overm/greenplum_partition_actualizer
подскажите, пожалуйста, как переложить select date_sub(CURRENT_DATE, 365 * 11) в GP?
select CURRENT_DATE - INTERVAL '4015 day';
есть в gpcc раздел рекомендаций, который формирует
рекомендации по обслуживанию БД
хотелось узнать, куда он пишет эти рекомендации, чтобы потом выдернуть их скриптом и выполнить?
функция gpmetrics.gpcc_recommendations отвечает за это
Подскажите пожалуйста аналог функции string_split.
Обратную для string_agg
unnest
split_part
помогите преобразовать, пожалуйста. у меня вот такая конструкция CAST(DATE_FORMAT(DATE_TRUNC('MM', CURRENT_DATE), 'yyyyMMdd') AS int). Мне надо ее в GP переписать так, чтобы у меня сегодняшнее число было integer
В текст. Потом в инт
Столкнулся с проблемой: хочу hash join, а оптимизатор делает nested loop.
Как можно обмануть оптимизатор и все-таки сделать hash join?)
Исх.данные: Таблица A ~ 100k колоночная, дистрибуция по двум ключам key_A_1, key_A_2 (ключи могут быть null, но не оба),
Таблица B ~> 10kk колоночная, дистрибуция рандом.
Использую A left join B по двум ключам key_A_1 = key_B_1 OR key_A_2 = key_B_2 + в джойне условия на актуальность по датам.
С OR в джойне никак. Но можете добавить в таблицы колонку со значением coalesce(a,b)
Подскажите есть ли аналог функции replicate(Ms sql) на gp?
Repeat
А как узнать какая кодировка в гринпламе?
Функция ввода Greenplum Database для типа данных jsonb более строга. Она не позволяет использовать эскейпы Unicode для символов, не являющихся символами ASCII (те, что выше U+007F), если только кодировка базы данных не UTF8. Он также не допускает \u0000, которые не могут быть представлены в текстовом типе базы данных Greenplum Database, и требует, чтобы любое использование суррогатных пар Unicode для обозначения символов за пределами базовой многоязычной плоскости Unicode было корректным. Действительные эскейпы Unicode, за исключением \u0000, преобразуются в эквивалентный символ ASCII или UTF8 для хранения; это включает складывание суррогатных пар в один символ.
select * from pg_database;
Идет параллельный insert в разных функциях в одну таблицу, с условием where not exists, чтобы не было дублей. Но дубли появляются. Как лучше залочить таблицу, чтобы не было дублей? Уровень изоляции по дефолту read commited.
подойдёт Lock in share update exclusive mode.
Ребят, подскажите, можно ли запустить sh скрипт из plpgsql функции?
В web external есть execute
Подскажите, существует ли для GP экстеншен а-ля cron в unix ( для запуска ф-й средствами БД ) ? функций типа pl\sql? Почему бы не использовать что-нибудь красивое типа airflow \ prefect \ dagster? Пусть стучится в бд и запускает что хочет.
Вопрос от неразработчика но интересующегося
Где прочитать про то, как происходит волшебство МРР?
Что не понятно:
Хорошо, сделали правильную дистрибуцию по сегментах
Но вероятность того, что совпадающие ключи разных объектов окажутся на разных сегментах, видимо высока
Или GP как то старается разместить на правильные сегменты , то есть диапазоны одинаковых ключей различных объектов будут плюс минус одинаковые для каждого сегмента?
Ключом дистрибьюции надо делать поля, по которым будет join. Это если есть хорошее уникальное поле.
Тогда джоин будет проходить на одном сегменте без broadcast motion
Хэш-функция, с помощью которой осуществляется дистрибуция, детерминирована. Одно и то же значение всегда будет попадать в тот же сегмент. Поэтому строки разных таблиц с одинаковым ключом окажутся вместе на одном сегменте.
я тут узнал, что гринплам умеет поднимать контейнеры докера.. а может кто кейсами поделиться? зачем это? plpythonu вроде как и так внутри работает..
Это для безопасного выполнения python и прочих функций в контейнерах. В отличие от plpythonu, который имеет доступ к серверу они безопасны и могут создаваться рядовыми пользователями. Гуглите доки по слову plcontainer
Работа с данными
Какой потолок у GP по объёмы данных? в облаке яндекса вижу совсем небольшое значение квоты 4096 ГБ
Лимита на объем базы нет. https://community.pivotal.io/s/article/FAQ--Pivotal-Greenplum-Limits?lan...
Подскажите, пожалуйста.
Как можно оценить перекос в распределении промежуточных данных запроса?
То есть - есть в плане redistribute таблицы А по полю b, который порождает перераспределенную по хешам таблицу.
Как можно симулировать вычисление хеша и посмотреть насколько кривое получается распределение. Кроме как загнать данные в тестовую таблицу с целевым распределением?
Симулировать не обязательно, можно посмотреть распределение значений по ключу перераспределения
SELECT join_key, COUNT(1) FROM table1 GROUP BY 1 ORDER BY 2 DESC;
Как посплитить дефолтную партицию в новую что бы новая создалась с нужными параметрами хранения?
Никак. Будет того же типа, что и дефолт. Только менять на таблицу потом с переливкой данных
Сплит не позволяет менять параметры
Подскажите, пожалуйста, после завершения работы gpexpand, gpstate продолжает показывать статус
Cluster Expansion = In Progress
Как сбросить?
gpexpand -c
Исследуем перекос данных на сегментах, подскажите, пожалуйста, рабочий запрос, который позволит связать название таблицы с файлом данных сегмента
SELECT pg_relation_filepath('tablename');
Теоретически, можно ли напрямую в сегмент загрузить данные напрямую, используя, например, jdbc и чем грозит? Я так понимаю, что ключ распределения я не угадаю и потом надо будет делать редистрибьюцию?
Для этого и существует pxf.
Подскажите пожалуйста, каким образом можно загрузить данные Excel в gp? И как чаще загружаете данные из разных источников? Что можно почитать, посмотреть на эту тему?
Если нет понимания, как это сделать программно, то
1. любые клиентом поддерживающим загрузку
2. NiFi
csv можно загрузить через \copy
https://docs.vmware.com/en/VMware-Greenplum/6/greenplum-database/admin_g...
А загрузка с помощью утилиты gpfdist редко используется? Только для очень больших файлов?
Если есть etl сервер и доступ к нему, чтобы туда в папку файлы положить, тогда можно gpfdist использовать
кто подскажет оптимальные настройки external table для загрузки данных из GP в PG ( нашёл partition by segment_ID и fetch size может есть ещё какие?)
Настройки пула соединений в jdbc-site.xml
как я могу указать GP, чтобы он генерил большее кол-во малых спилл файлов, а не малое количество больших?
Никак
Большие файлы получаются, когда крутите большие данные. А маленькие- …
Вопрос для тех, кто сталкивался с интеграцией между SAP HANA и GP. Подскажите, пожалуйста, с чем может быть связана проблема? Есть физическая таблица в HANA (строк всего 200 тысяч). В GP создана копия, туда перелиты данные. Необходимо сверить их с исходником – для этого по SDA подключена виртуальная таблица. Элементарный запрос с любой операцией объединения (UNION или EXCEPT) почти всегда выдаёт неполное множество из GP (строк раза в три меньше). Агрегация не используется. Если запускать SELECT по-отдельности, то результат всегда корректный. Также обнаружили, что в GP не формируется запрос, когда в HANA выдаётся неправильный результат.
Эта схема в целом может быть не самой быстрой. если SDA работает через odbc/jdbc - то холодные данные вы будете получать через мастер.
Просветите, почему pg_class.reltuples = 0 для таблицы с данными ? если таблица партиционированная, то в родительской тоже по нулям будет
Читал что greenplum не любит update, но все же как более правильно делать update когда у меня orientation colum Зависит от объёма. Если до 5-10 миллионов строк, то просто, если больше - то имеет смысл сделать новый слой данных в сторонней таблице, а потом его залить вместо старого
Ни у кого случайно скриптов не завалялось чтобы оценить кол-во занимаемого пр-ва таблиц и эффективность их сжатия?
такое попробуйте
select table_schema,
table_name,
pg_size_pretty(pg_relation_size('' || table_schema || '.' || table_name || '')),
get_ao_compression_ratio('' || table_schema || '.' || table_name || '')
from information_schema.tables
where table_type = 'BASE TABLE'
--and is_insertable_into = 'NO'
order by 3 desc;
ранее в качестве медленного стораджа, я использовал hadoop external table, там хранилось всё на hdd, а данные для быстрых графиков были на ssd локально, в новой компании нет хадупа, а поделить данные на те что будут на hdd в 3,5 на 16 тб, для архива, и текущие данные нужно,
как это будет лучше сделать
tablespaces
прошу подсказать кто-нибудь использовал связку debezium->kafka->confluent.connect.jdbc->greenplum и если да, то как впечатления? Если данных не супер много, должно более менее работать?) Находил, что вроде как медленно данные таким образом вставляет
синки по умолчанию вставляют батчем, а не построчно, все зависит еще от того вы хотите выполнять апдейты или просто аппенды, если просто аппенды то да по скорости при больших батчах сильно проиграет pgcopy или gpfdist
Как увидеть в бд статистику по выполнению запросов: время выполнения и ram (не explain analyze).
Пока нашла только pg_stat_segments в postgress, не могу понять, можно ли включить в GP.
В pg_stat_activity не показываются только запросы схемы public. Это нормально? Это может в конфиге параметрами регулируется
gp_enable_gpperfmon
При создании внешней таблицы данные хотелось бы получить в табличном виде.
Например:
CREATE EXTERNAL WEB TABLE adb.admin_tool.ext_df_h_size_hosts (
config text
)
EXECUTE 'df -h' ON ALL
FORMAT 'TEXT' ( delimiter ' ' null '\N' escape '\' )
ENCODING 'UTF8';
Выдает след результат:
<pre>
| Filesystem Size Used Avail Use% Mounted on |
| devt1 3.8G 0 3.8G 0% /dev |
| devt2 3.9G 40K 3.9G 1% /dev/qwerty |
</pre>
Т.е хотелось бы сразу создать для него отдельно поля Filesystem, Size, Used, Avail, Use%, Mounted on, куда будут записываться значения, а не как сейчас, все в одну строку.
Возможно ли такое сделать при создании внешней таблицы или его нужно парсить на питоне?
Сделайте вью над внешней таблицей и распарсите средствами sql
подскажите, в Яндекс облаке в greenplum перегружаю инкрементально таблицу по времени, скрипт одни и тот же обьем данных тоже примерно один и тот же , но с каждой итерацией время на вставку увеличивается и вот уже в 10 раз увеличилась, написал в поддержку, они говорят ,что каждый новый запрос генерирует все больше spill файлов , каких то промежуточных данных , что замедляет запрос , кто нибудь сталкивался ?
если insert into select from join то не мудрено.
1) собирайте статистику по соединяемым таблицам
2) смотрите на атрибуты соединения - скорее всего это не ключи дистрибьюции
насколько GreenPlum накладно апдейтить строки? Вот не хоятт аналитики оконки учить, а надо историзм вести по скд. Из-за этой ситуации нам придется вести две колонки valid_from_ и valid_to_ .. и вторую надо будет апдейтить, после прихода более нового состояния строки.
Скажем так, событие не редкое, условно в день 140 млн строк, из них, я думаю, не меньше нужно будет заапдейтить, может быть даже несколько раз..
существует техника с использованием партиций - актуальный срез с valid_to=+бесконечность кладется в отдельную партицию. при очередной загрузке инкремента формируется новая таблица и ей подменяется актуальный срез через exchange partition, во вторую же партицию с историческими данными подливается то, что должно из актуального среза уйти через insert. т.о. можно обойтись без операций update. насколько это применимо в твоем случае - не знаю, надо проверять
какие права нужны для учетки во внешней таблице при pxf external readable table formatter=writable_import? (в частности, интересует clickhouse, если это имеет значение)
в CH есть настрока readonly и работает pxf external только с настройкой 0 (т е выключенной), каких-то прав не хватает на 2 (2 — разрешены запросы на чтение данных и изменение настроек)
Коллеги! Есть мнение, что PXF стягивает данные на одну ноду, с которой потом идет дистрибуция по ключу на все причастные ? Кто-то проверял это ?
Крайне маловероятно, учитывая скорость. Это возможно, если источник однопоточный (mssql или хадуп без партциционирования) , тогда такой алгоритм вполне вероятен.
как то можно вывести сегменты и мирроры из БД? Например, есть 24 сегмента на 3 серверах, нужно сделать 18 (чтобы данные размазались на 18, вместо 24).
Уменьшение только через пересоздание
Коллеги, нужна помощь:
1. Создал таблицу с партиционированием в схеме1.
2. Перенёс таблицу в схему2.
Итог:
1. Таблица в схеме2, а партиции остались в схеме1.
2. Удалить партиции из схемы1 нельзя, ругается на связь с основной таблицей.
3. Напрямую в партиции в схеме1 данные записываются, но при запросе из схемы2 select * from table - внесённые данные не отбираются.
Вопрос:
1. как перенести партиции из схемы1 в схему2?
2. Это вообще нормальное поведение для GP?
для всех партиций сделайте новую схему. это нормальное поведение.
А подскажите, пожалуйста, где то можно задать размер / пачку вставляемых данных для таблицы с дистрибуцией.
То есть вопрос такой, как GP выбирает куда что засунуть с дистрибуцией по ключу ? Отталкиваясь от размера данных, от количества строк ?
Так по ключу и выбирает. Алгоритм не помню, там вычисляется хэш сумма от значения поля ключа которая и показывает номер сегмента в который нужно положить данные. 1406.2294.pdf
Подскажите пожалуйста можно ли в greenplum создавать как то FK для appendoptimized таблиц. Не для того чтобы целостность поддерживать, а просто для самодокументирования модели данных?
С FK, судя по доке, не должно быть проблем. Обещается, что просто будут игнорироваться. А вот с pk для таблицы, на которую надо сослаться, проблема. Только для heap позволены pk. Поэтому даже для целей документации мало применимо.
Коллеги, У кого-нибудь есть опыт использования временных таблиц для промежуточных рассчётов?
В каких случаях это благо, а в каких случаях - зло?
Был такой опыт, чтобы обойти дедлоки при вставке в одну служебную таблицу. На промежутке оч удобно – создал с commit drop, переложил данные, куда надо, закрыл транзакцию – всё, gtt ушла, вакуумить ничего не надо
Есть ли возможность создания партицирования в линке pxf такми образом чтобы range был от указанного числа до максимально возможного(без предварительного указывания)?
PARTITION_BY=id:int&RANGE=4585499&interval=1000
Чтобы забрать все данные из внешней таблицы, не нужно. Данные не потеряются. Это нужно для равномерного распределения нагрузки на сегменты. Да, какую-то плавающую правую границу желательно для этого организовать. Можно с запасом ее определять, но и не страшно будет промахиваться и недобирать.
Можно ли партиционировать внешние таблицы?
Нет. Можно партиционированную таблицу подключить как внешнюю
Можно организовать чтение из внешней таблицы через pxf в несколько потоков. Тоже называется партиционирование. https://docs.arenadata.io/adb/PXFJDBC/Partitioning.html
PARTITION_BY выбирает способ распараллелить запросы к внешним данным по выбранному полю и способу разбиения. Это не партиционирует данные на внешних системах, а лишь определяет способ распараллеливания доступа к ним. Просто уточняю.
столкнулись с проблемой выборки данных из columnstore AO таблицы, содержащей varchar столбец с длинными текстовыми значениями length(text) от 0 до 32767.
--Изменение стратегии хранения toasts (c vacuum после изменения) не принесло результатов в части ускорения выборки данных
--Изменение степени сжатия compresslevel и типа сжатия compresstype тоже никак не повлияло на скорость выборки.
Какой best practices в гринплам в части хранения и выборки таких данных?
План запроса https://explain.tensor.ru/archive/explain/fabb82001d753a7bb190e780041e30... , сам запрос https://pastebin.com/HcsBysKq
Скорость выборки с text столбцом ~ 28 - 32s
без использования столбца ~ 5 - 7s
Заранее благодарен!
Индекс на sat_text.hub_text_pk повесить
Мне нужно опрашивать БД и получать инфу о созданых типах данных. В частности нужно получать информацию о полях COMPRESSTYPE, COMPRESSLEVEL, BLOCKSIZE. В документации к системным таблицам нашел упоминания этих полей только в одном месте pg_appendonly, и как я понял она мне не подходит так как содержит информацию о таблицах. Подскажите плиз куда гуглить. (прошу прощения если не понятно изложил свою мысль моя джун джавист, если будут не равнодушные люди могу скинуть сокрашенный опрос который уже имеется и к которому мне нужно заджойнить новую инфу)
create function test_int_in(cstring)

  returns test_int

  strict immutable

  language internal as 'int4in';

create function test_int_out(test_int)

  returns cstring

  strict immutable

  language internal as 'int4out';

create type test_int (

  internallength = 4,

  input = test_int_in,

  output = test_int_out,

  alignment = int4,

  default = 123,

  passedbyvalue,

  compresstype=zlib,

  blocksize=65536,

  compresslevel=3

);

select te.*

  from pg_type t

 inner join pg_type_encoding te

         on te.typid = t.oid

 where t.typname = 'test_int';
Есть задача сформировать выгрузку среза данных из одного контура в другой. Пока идея в следующем - пишем данные в файлики, файлики перекидываем на другой контур, восстанавливаем.
Контура изолированы друг от друга.
Скажите, пожалуйста, в целом идея рабочая, какие ещё варианты реализации?
Пока смотрю запись в файл. Срез данных формируется селектом из таблицы с определёнными where ограничениями, какие-то поля модифицированы. Pg_dump не подходит, так как модификацию и предикаты не прокинуть. Copy пока не рассматривал, так как нужно дергать со стороны сервера, что мне менее удобно.
Попробовал через writeable external table pxf (file:text), gpfdist. Эксперименты проводил в песочнице синглноде на вм.
PXF мне моментом гиговую табличку залил в файлы, правда файлов несколько, плюс есть какие-то служебные .crc, .swp. Но если живые файлы склеить, то получается то, что нужно.
А вот с gpfdist минусы:
- файл должен быть создан на сервере, не создаётся на лету
- те же данные лились минуту
Из плюсов - один понятный файлик)
Я ожидал лучше производительности от gpfdist, но тут мб настраивать нужно.
Является ли pxf при таких вводных наиболее производительным средством записи в файлы? Читал тут же, что он кушает cpu, что несколько пугает. Может, есть иные варианты?
gpfdist умеет создавать файлы, при условии, если установлены корректные права для директории в которую он смотрит. Условно LOCATION ('gpfdist://example.ru:9100/data1.csv',) вот data1.csv он должен создать.. Касаемо производительности, то попробуйте несколько gpfdist поднять, так как он однопоточный. Если что, то для одной EXT таблицы вы можете несколько инстансов указать, в том числе на разных хостах - LOCATION ('gpfdist://example1.ru:9100/data1.csv', 'gpfdist://example1.ru:9101/data2.csv', 'gpfdist://example2.ru:9100/data3.csv') равномерное распределение данных между файлами протокол берет на себя.
Еще как вариант, если у вас есть S3 в компании вы можете попробовать вот этот функционал, это тоже должно быстро работать.
Возник вопрос по поводу внешних таблиц. Если кто-то сталкивался с похожей проблемой, поделитесь экспертизой, пожалуйста?
Кратко к сути
Для хранения raw-данных использую hdfs. Там по нужному пути данные разложены по партициям (директориям типа date=20230101, date=20230102 и т.д.). В каждой из них – паркеты.
Необходимо создать внешнюю таблицу на GP, учитывающую эту иерархию источника (т.е. корректно интерпретирующую вынесенный в партиционировании столбец). Посредством накидывания фильтров на date при считке на GP предполагается делать прунинг/илюминейшен партиций для построения инкремента в ETL.
Пока сходу не удается найти подходящих примеров создания таких внешек (копал в сторону pxf).
Делаешь партиции по дням, и внешние таблицу к hdfs по точному пути, с учётом имён партиций.
Каждая партиция = внешняя таблица.
У меня возник вопрос. Я хожу в постгрес через external table и все хорошо работает. Но я почему-то не вижу запроса через pg_stat_activity на постгре, пока выполняется запрос на GP. PFX же через sql интерфейс читает данные? И в чем может быть секрет того, что я не вижу запрос.
Если вы работаете с внешними источниками данных через PXF, то запросы стоит смотреть в логах того сегмента, куда записываются данные из внешнего источника. На мастере этих логов видно не будет.
Насколько я понимаю (да поправят меня сведущие) PXF подключается к источнику при помощи драйвера напрямую и его запросы в pg_stat_activity могут и не отображаться
Подскажите куда поглядеть, запрос через pxf в oracle медленно сплитится на дата ноды. Сессии были максимум с 3, активных сейчас с одной.
У вас будет несколько сессий в jdbc только если используется партицирование в определении внешней таблицы.
И как будут распределены данные между партициями чтения - как вы определите партиции так и будет.
Если партиций нет - то запросы будут с 1 PXF сервера.
Для распараллеливания чтений с сегментов необходимо фрагментирование данных внешних таблиц. Для реляционных бд через jdbc необходимо использовать логическое партиционирование в определении внешней таблицы. Только стоит учитывать, что чтения партиций будут неконсистенты между собой.
Здравствуйте. Помогите пожалуйста с планированием ресурсов для 15 tib данных? Сколько ЦПУ, ОЗУ, дискового пространства на сегмент нужно
Все зависит от профиля чтения-записи. Надо брать стартовую точку какого-нибудь стандартного калькулятора и оставлять запас для маневра.
Подскажите пожалуйста, можно ли натравить gpfdist на паркеты в S3? Пользовался pxf, заххотел сравнить производительность. Но просто смена протокола с pxf на gpfdist не помогла, Нужно указывать прям url в location где файлы в бакете лежат? Не нашел в доке примера с прокидываем gpfdist ключей к S3
Gpfdist может принимать на вход данные из потока, pipe файлов
Кто как следит за data quality в бд? Есть очевидные идеи собирать каждый день статистику по новым данным и отслеживать отклонения по количеству строк, например, на определенную дату, и если отклонение больше 10 процентов, то писать в отдельные логи. И например проверять, что ключ остался уникальным после загрузки. Но может кто-то уже занимался чем-то подобным и имеют более грамотные неочевидные подходы или знает правильные статьи на эту тему? Полистал Гугл одним глазом, но нашел только общие слова о том, как должно быть
Я бы сказал, dbt + great expectations, если опенсорс. Информатика - за деньги
Хотелось бы задать вопрос по pxf
Суть в чем.
Есть таблица переливки, где источник для запроса представлен соответственно 3 столбцами.
Server, schema, table.
Но возник вопрос, как отследить изменения этого источника, вдруг в очередной день туда добавят столбец в таблицу и этого на принимающей стороне никто не заметит.
Есть ли возможность какая получить имена столбцов источника через pxf ?
Спасибо
Получать список атрибутов таблицы источника из словаря данных удаленной системы и процедурно генерировать External Table. Но в случае изменения атрибутов на источнике у вас весь дальнейший процесс может перестать работать.
Устранение ошибок
Прошу подсказать из-за чего может возникать данная ошибка при построении таблицы? Данные берутся из внешний таблицы. Строю ряд таблиц через dbt в GP по тегу и не давно стала такая ошибка по части таблиц появляться, раньше не было. При чем закономерности не найду пока, т.к. ошибка может появится по таблице при первом построении в потоке, потом если её отдельно одну перестроить, то может и не быть уже ошибки
Падают pxf коннекторы на сегментах похоже. Посмотрите логи pxf, может памяти не хватает. Или есть спецсимвтлы в данных, которые pxf не может отработать
Упирался кто-нибудь в следующую ошибку при чтении паркетов через pxf?
SQL Error [08000]: ERROR: PXF server error : class java.lang.String cannot be cast to class java.sql.Timestamp (java.lang.String is in module java.base of loader 'bootstrap'; java.sql.Timestamp is in module java.sql of loader 'platform')
падает на колонке с timestamp. В пандасе выглядит нормально
2023-01-12 11:49:30
Name: asd, dtype: datetime64[ns]
В питоновском словаре тоже
Timestamp('2023-01-12 15:58:50')
Судя по трейсу, PXF считает объект строкой и пытается распарсить его как строку
Pxf сам ничего не знает. Структура ему передается на каждом запросе. Перепроверьте объявление внешней таблицы. И обратите внимание на параметр, который отключает сопоставление по именам стольцов и оставляет только порядок.
Подскажите пожалуйста по ошибке :
SQL Error [58M01]: ERROR: Invalid execution statistics received status node-count mismatch: cdbexplain_recvExecStats() ctx.nStatInst 0 hdr-> nlnst 3
Подсказка: Please verify that all instances are using the correct Greenplum Database software version.
Куда копать или что с этим делать? В гугле ничего не нашел
Версии GP разъехались на сегментах
Обратится к DBA, приложить ошибку, сказать, что наблюдается такая проблема и попросить проверить, что на всех сегментах одинаковая версия
Кто-нибудь сталкивался с ошибкой на ванильном GP 6.21.1?
SQL Error [0A000]: ERROR: ENCODING clause not supported on non column orientated table
Наперед уточню что таблица имеет опции
with (
appendonly=true,
orientation=column,
compresstype=zstd,
compresslevel=1
)
И если взять DDL Таблицы и создать её копию с другим именем, то команда добавления колонки будет отрабатывать корректно.
Колонку добавляю следующей командой:
alter table schema_name.table_name
add column test_col double precision
encoding (compresstype='ZSTD',compresslevel=1)
Модифицируемая таблица партицирована и сабпартицирована.
Таски в airflow, работающие параллельно, вызывают функции в GP, в которых создаются представления и таблицы, падают с ошибкой duplicate key value violates unique constraint “pg_type_typname_nsp_index”. Мб кто-то сталкивался и решал такую проблему? Буду рада любой помощи
Так видимо эти таски пытаются создать в одно время одинаково названные таблицы поведение. Вынесите логику из базы данных, ей там не место.
не могу победить ошибку в PXF User: hadoop is not allowed to impersonate gpdb
Со стороны хадупа настройте proxyuser
hadoop.proxyuser.<name>.groups
hadoop.proxyuser.<name>.hosts
После чего замените core-site.xml на всех сегмент серверах
Столкнулись с проблемой, что при создании EXTERNAL TABLE с использование форматера fixedwidth_in, получаем ошибку:
ERROR: The line delimiter specified in the Formatter arguments: <тут испробовали всевозможные разделители уже> is not located in the data file
Протокол pxf, профиль s3:text
Даже пробуем создать файл с одной строкой и одним значением и всё равно эта ошибка...
CREATE READABLE EXTERNAL TABLE test (f1 varchar(4))
LOCATION ('pxf://<s3 bucket>/test.txt?PROFILE=s3:text&SERVER=s3')
FORMAT 'CUSTOM' (formatter='fixedwidth_in', f1='4');
В файле test.txt только 4 цифры 0099
в доке по pxf нет такого formatter=fixedfidth. Есть, например, pxfwritale_import
Вот так работает:
CREATE READABLE EXTERNAL TABLE test (f1 varchar(4))
LOCATION ('pxf://<s3 bucket>/test.txt?PROFILE=s3:text&SERVER=s3') on all
FORMAT 'CUSTOM' (formatter=pxfwritable_import)
Только начинаю разбираться в GreenPlum,
У меня возник вопрос
Как создаются таблицы с партиционированием в БД
CREATE TABLE table_1
(
id text not null,
date1 date not NULL,
name_ev varchar(36) not NULL
)
DISTRIBUTED by (id)
PARTITION BY Range (date1)
SUBPARTITION BY LIST (name_ev)
Но при попытке создания появляется ошибка
ERROR: no partitions specified at depth 1
подскажите пожалуйста как корректно создавать подобные таблицы, партицируется ли она самостоятельно или нужно самому создавать партицию (если да то как)
Нужно самому прописывать в определении интервалы (для range) или значения (для list) для партиций, или опционально прописать default partition
Вчера удалось разобраться с jsonb - и оно даже очень приятно так зашло).. но вот настало время парсить и я последний затык не могу победить(.. подскажите как тут выпарсить интовую чиселку?
select cast(coalesce(body->>'id_tov'::int, 0::int) as int)
from public.raw_logs_uli;
пока ошибка вылетает:
ERROR: invalid input syntax for integer: id_tov
ну или там без coalesce такая:
ERROR: invalid input syntax for integer: null
Нужно убрать оба ::int
Подскажите, пожалуйста, возможно ли работать с гринпламом и создавать external tables через s3 протокол с какими-либо другими бакетами, кроме aws?
Пытаюсь по инструкции создать конфиг и использовать с s3 digitalocean, но получаю ошибку при выполнении gpcheckcloud:
reader_init caught a S3ConfigError exception: https://s3-fra1.amazonaws.com// is not valid
т.е. ломится в авс
(Greenplum Database) 6.17.1 build
Можно, в старых версиях в hosts поменять или поставить более новую, там хардкод убрали
Ну или PXF тоже может в S3
Сделала в gp ряд конвейерных функций, по большому счету они просто возвращают набор строк из таблиц с фильтром на дату на входе. Несколько дней назад функции начали падать в ошибку, причём у коллеги, который сидит под этим же юзером такой проблемы нет. Может быть, кто-то сталкивался, и подскажет, что это.
In reply to this message
UDF cannot access any tables on segment. Due to the characteristics of MPP, any segment only contains part of the data, so the UDF executed on the segment cannot access any tables, otherwise the data calculation is wrong.
Функции не очень хорошо использовать для получения выборок — в силу вышесказанного данные идут строго через мастер. Ещё это мешает планированию, если вы с полученным от функци сетом ещё делаете. Оптимизатор воспринимает их как чёрный ящик.
Подскажите, а кто-то смог подрубить внешнюю таблицу кликхауза например с помощью SSL?
или pxf не поддерживает ssl?
на стороне ClickHouse вылезает ошибка
Exception: error:1000009 SSL routines:OPENSSL_internal: HTT
Работает внешняя таблица из https://clickhouse.service без проблем.
Посмотрите параметры подключения.
Например, вот так:
location ('pxf://table_name?PROFILE=Jdbc&JDBC_DRIVER=com.clic
подскажите пожалуйста, пытаюсь создать внешнюю таблицу с s3, но когда пытаюсь делать запрос к ней возникает ошибка
ERROR: invalid byte sequence for encoding UTF8: 0x00
я знаю что это связано с null но как вылечить не могу понять
Заранее благодарю за ответ!
Это связано с тем, что в колонке типа text/varchar хранится 0й символ, что запрещено в PG/GP стоит использовать тип bytea
Коллеги, никто не встречался с ошибкой ERROR: PXF server error : Method not supported?
Пытаюсь через pxf настроить подключение к hive по jdbc и натыкаюсь на такие грабли. Файл pxf-profiles.xml корректный, конфигурация тоже… Не могу понять, что ему нужно
Попробуйте использовать profile hive без jdbc драйвера
Кто-нибудь сталкивался с раздутым системным каталогом? Сломался скрипт который обслуживание системного каталога делал, долго не проводился вакуум. Сейчас провели вакуум, но он ничего особо не почистил. Вакуум фулл, кажется, что делать опасно на системных каталогах. Да и эксклюзивный лок на пользу продовой базе точно не пойдет. Есть ли какие-то более щадящие решения, чтобы можно было без проблем почистить?
Системный каталог так распух скорее всего из-за того, что ему не делали vacuum регулярный. Если это так, то это ошибка, и за нее надо расплатиться :)
Сделать vacuum full. Выгнать всех и сделать. Если не выгоните можете получить очень неприятный сценарий в виде лавинообразного наплыва ждущих запросов нехватки коннектов и т.п.
Очень важно не отменять vacuum full таблиц системного каталога, можно и базу сломать.
Если при чтении из нее в процессе не хватает коннектов в пуле в логах получаем - java.sql.SQLTransientConnectionException: HikariPool-11 - Connection is not available, request timed out after 90000ms, НО эта ошибка не пробрасывается ни в какой из клиентов (dbeaver, omnidb, psql), в результате вычитываем из таблица несколько млн. и думаем, что все хорошо. Если коннектов в пуле нет на момент запуска запроса, то эту ошибку получаем в любом из клиентов. Параллельно читаем через PXF из той же БД еще много данных, поэтому конеектов не хватает. Я понимаю, что можно увеличить количество maximumPoolSize и connectionTimeout, НО хочется разобраться почему ошибку не всегда получаем на клиенте, а в логах есть всегда.
Там есть настройки логирования. И их нужно прокатить по всем сегментам. Разные настройки на разных сегментах. И поэтому, когда падает сегмент с логами ошибку видно, а по другим не видно https://greenplum.docs.pivotal.io/6-4/pxf/cfginitstart_pxf.html https://hawq.apache.org/docs/userguide/2.3.0.0-incubating/pxf/TroubleshootingPXF.html
Подскажите пожалуйста по PXF. Есть внешняя таблица table1 на млрд. строк с партицированием на уровне PXF(PARTITION_BY=id:int&RANGE=1:10000000000&INTERVAL=5000000). Читаем из нее запросом:
insert into table2 (field1, .. fieldN)
select field1, ...fieldN from table1.
Если при чтении из нее в процессе не хватает коннектов в пуле в логах получаем - java.sql.SQLTransientConnectionException: HikariPool-11 - Connection is not available, request timed out after 90000ms, НО эта ошибка не пробрасывается ни в какой из клиентов (dbeaver, omnidb, psql), в результате вычитываем из таблица несколько млн. и думаем, что все хорошо. Если коннектов в пуле нет на момент запуска запроса, то эту ошибку получаем в любом из клиентов. Параллельно читаем через PXF из той же БД еще много данных, поэтому конеектов не хватает. Я понимаю, что можно увеличить количество maximumPoolSize и connectionTimeout, НО хочется разобраться почему ошибку не всегда получаем на клиенте, а в логах есть всегда.
Там есть настройки логирования. И их нужно прокатить по всем сегментам. Подозреваю, что разные настройки на разных сегментах. И поэтому когда падает сегмент с логами ошибку видно, а по другим не видно)
Это про pxf
https://greenplum.docs.pivotal.io/6-4/pxf/cfginitstart_pxf.html
https://hawq.apache.org/docs/userguide/2.3.0.0-incubating/pxf/TroubleshootingPXF.html
Вопрос про pxf. Создана внешняя таблица из postgresql, делаю инсерт в GP и получаю такую ошибку workfile per query size limit exceeded. Как её можно решить?
Есть 2 или 3 GUC связанных с workfile limit, они по умолчанию невелики. Попробуйте увеличить.
Подскажите куда смотреть: ошибка при записи в external jdbc таблицу 50млн строк. при 100 строках ошибки нет
В логи pxf. Скорее всего не хватает ресурсов. Может на каком спецсимволе падает. Спецсимвол в 100 строк может просто не попадать
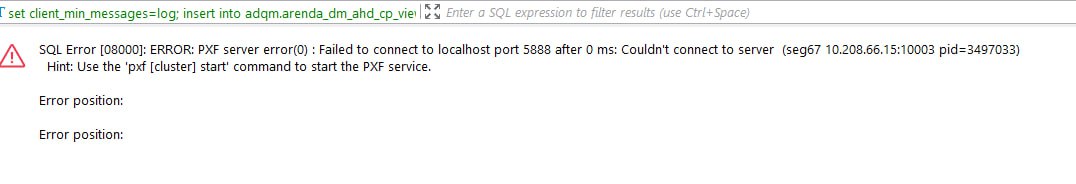
Подскажите, пожалуйста, насчет ошибки перераспределения данных после работы gpexpand. Добавил два дополнительных сегмент-хоста к остальным 12 к кластере, схема распределения зеркал - spread. Два дополнительных хоста добавил по схеме group через файл конфигурации. gpexpand в конфигурационном файле на нашёл ошибок и расширение кластера прошло нормально. За одним исключением, после завершения работы gpexpand директория /data начала расти и заняла всё доступное пространство на диске. Ситуация исправилась после вакуума системного каталога. Запустил gpcheckcat проверить ошибки в таблицах и и получил оттуда следующий результат.
Object oid: 1130582
Table name: pg_extension
Name of test which found this issue: inconsistent_pg_extension
extconfig is '{1130659,1130668}' on content -1 (srv-mgp-001:5432) content 96 (srv-dbgp-013:6000) content 97 (srv-dbgp-013:6001) content 98 (srv-dbgp-013:6002) content 99 (srv-dbgp-013:6003) content 100 (srv-dbgp-013:6004) content 101 (srv-dbgp-013:6005) content 102 (srv-dbgp-013:6006) content 103 (srv-dbgp-013:6007) content 104 (srv-dbgp-014:6000) content 105 (srv-dbgp-014:6001) content 106 (srv-dbgp-014:6002) content 107 (srv-dbgp-014:6003) content 108 (srv-dbgp-014:6004) content 109 (srv-dbgp-014:6005) content 110 (srv-dbgp-014:6006) content 111 (srv-dbgp-014:6007)
extconfig is 'None' on all other segments
extcondition is ',' on content -1 (srv-mgp-001:5432) content 96 (srv-dbgp-013:6000) content 97 (srv-dbgp-013:6001) content 98 (srv-dbgp-013:6002) content 99 (srv-dbgp-013:6003) content 100 (srv-dbgp-013:6004) content 101 (srv-dbgp-013:6005) content 102 (srv-dbgp-013:6006) content 103 (srv-dbgp-013:6007) content 104 (srv-dbgp-014:6000) content 105 (srv-dbgp-014:6001) content 106 (srv-dbgp-014:6002) content 107 (srv-dbgp-014:6003) content 108 (srv-dbgp-014:6004) content 109 (srv-dbgp-014:6005) content 110 (srv-dbgp-014:6006) content 111 (srv-dbgp-014:6007)
extcondition is 'None' on all other segments
поиски по документации ответа по корректной интерпретации вывода теста не дали. Подскажите, пожалуйста, как корректно интерпретировать вывод и чем такие ошибки грозят кластеру gp?
Вывод gpcheckcat указывает на то, что поля extconfig и extcondition имеют значения на мастер-сегменте (content -1) и на дополнительных сегментах (content 96-111), но не имеют значений на всех остальных сегментах. Это указывает на несогласованность данных между сегментами. Попытайтесь воспроизвести проблему с неконсистентностью данных, выполняя запросы к таблице pg_extension или обращаются к значениям extconfig и extcondition. При наличии проблемы ваши запросы могут возвращать разные результаты в зависимости от того, на каком сегменте они выполняются.
Если проблема воспроизводится, вы можете попробовать исправить её вручную, сравнив значения extconfig и extcondition между сегментами и корректируя их, чтобы они были одинаковыми на всех сегментах.
Рекомендуется иметь бекап перед любыми манипуляциями.
Как быть в ситуации, когда greenplum expansion ушел в ошибку?
Т.е всё произошло так:
1) expansion Greenplum failed -> попытка перезапустить сервер -> не стартует, просит gpexpand --rollback
2) gpexpand --rollback сделать можно только после старта - поэтому на этот случай даже в документации написано, стартаните только мастер через gpstart -m и на нем уже сделайте gpexpand --rollback
3) стартуем мастер, пытаемся сделать там gpexpand --rollback, но появляется следующая ошибка: “-gpexpand failed: Failed to query gp_stat_replication: FATAL: System was started in master-only utility mode - only utility mode connections are allowed”
PGOPTIONS='-c gp_session_mode=utility' - тогда подключится к мастеру только
Пытаюсь создать и прочитать внешнюю таблицу с использованием PXF из PostgerSQL БД. В таблице присутствует поле типа jsonb,
Создаю таблицу так:
CREATE EXTERNAL TABLE схема.таблица (поле jsonb) location
('pxf://схема.таблица?profile=jdbc&server=имя_сервера"E_COLUMNS=true') FORMAT 'CUSTOM' (FORMATTER='pxfwritable_import');
Ошибка такая:
SQL Error [08000]: ERROR: PXF server error : Field type 'UNSUPPORTED_TYPE' (column 'ColumnDescriptor [dbColumnTypeCode=3802, dbColumnName=поле, dbColumnTypeName=jsonb, dbColumnIndex=0, ...
Есть ли возможность использовать поля типа jsonb через PXF? Сам гринплам их поддерживает насколько я поняла. а как мне выкрутиться? Создавать вьюшки на стороне источника?
https://docs.vmware.com/en/VMware-Tanzu-Greenplum-Platform-Extension-Fra...
тут описаны типы, которые pxf поддерживает. Можете попробовать неявное преобразование, например, указать в external тип text
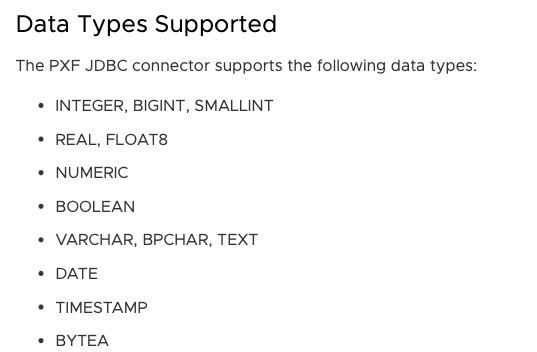
из локальной функции (clean_obj) можно сослаться на переменную родительской get_fn_tables2 ( не параметром )
чтобы не рвалось с ошибкой sqlerror: column v_src does not exist ?
Через такой трюк https://stackoverflow.com/questions/39983154/how-do-i-create-a-nested-function-in-pl-pgsql
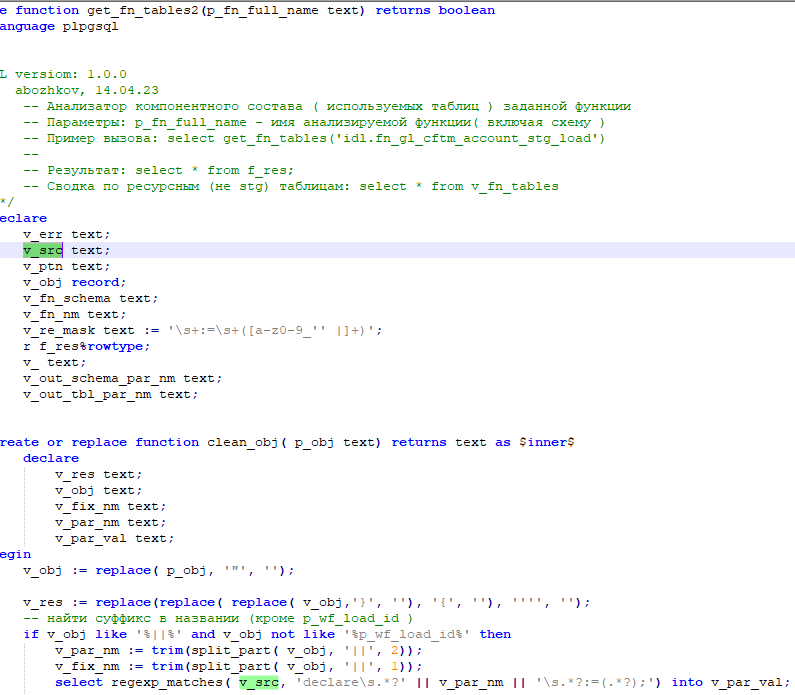
тестирую подключение к minio из гринплама используя pxf.
CREATE EXTERNAL TABLE ext.pxf_s3_csv (
terms text)
LOCATION (
'pxf://bucket_name/test.csv?PROFILE=s3:csv&SERVER=s3srvcfg&accesskey=accesskey&secretkey=secretkey&endpoint=host:9000') ON ALLFORMAT 'CSV' ( delimiter ',');
выводит ошибку что ERROR: extra data after last expected column. и дальше непонятный html c javascript кодом.
до этого уже прописывали в директории servers в файл minio-site.xml настройки для minio
Попробуйте другой символ разделитель вместо,
В строке данных скорее всего есть запятая и на вход приходит больше колонок чем он ждёт в структуре таблицы
выкинуть .csv, использовать .parquet/.orc
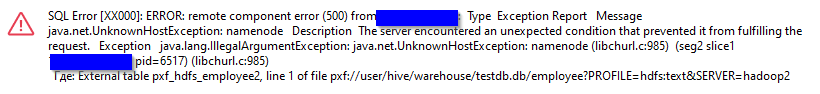
настраиваю чтение данных из Hadoop в ArenadataDB.
Делаю согласно инструкции от аренадаты, скопировал файлы core-site.xml, hdfs-site.xml, hive-site.xml в отдельный каталог в каталоге servers, на каждом сегменте.
Создал external table, Но при чтении, ловлю ошибку. Хадуп развёрнут в докере, на отдельном сервере. Хост сервера указывал в ip формате, в hdfs-site.xml.
Подскажите пожалуйста, что ещё стоит проверить
Сетевой доступ с сегментов GP до хадупа
Столкнулись с интересным кейсом:
есть два ClickHouse-a, первый отдает данные несжатые, а второй отдает сжатые lz4 (дефолтно прописано в клике)
ПРи заборе маленьких табилц через pxf все вроде окей работает на обоих кликах, но вот сжатую 700 гиговую табилцу со второго клика отдавать уже не может. При получении этих данных скорость падает кратно..
pxf, без добавления этой штуки -https://mvnrepository.com/artifact/org.lz4/lz4-java/1.8.0 в jdbc выдает ошибку: поставьте компрессию 0.,
Многочисленные тесты показывают, что idle начинает триггерить реконнекты для потоков уже через 30 секунд, а когда через psql, то реконнекты не триггерятся, но если их отменить, то скорость кратно вырастает, правда данные не появляются
Т.е. спустя 30 сек происходит отвал, мы отменяем запрос, пропадает процедура записи на диск и тогда pxf зависает и выкачивает с клика на 1,5 гигабитах. Скорость согласуется с нодами GP.
Если же не отменять запрос, то скорость будет 200-300 Мбит, и на перелив нужно 2-е суток..(
ПРобовали менять количество потоков, от 30 до 1.. пробовали 16 и 8.. коннекты не отваливаются на 4 потоках и меньше, но скорость убогая..
Вопрос: что можно сделать, чтоб создать внешнюю табилцу на GP, источником которой будет клик? Многопотоково. А то через мастер это занимает 5 часов, а это очень долго.. но применение pxf к сжатым данным удлиняет ещё до 2-х суток..
Я бы для начала поставил драйвер CH самый свежий с постфиксом all
И включил сбор метрик pxf через актуатор
https://docs.vmware.com/en/VMware-Tanzu-Greenplum-Platform-Extension-Fra...
А там уже дальше бы смотрел
Прошу подсказать, возможно кто-то сталкивался с подобной задачей.
Настраиваю соединение между adb и hadoop. Hadoop развёрнут в докере на отдельном сервере.
Настроил ssh подключение под pxf с сегментов adb на сервер hadoop.
core-site.xml, hdfs-site.xml, hive-site.xml скопировал из докера в адб.
Но при чтении из external table adb, ловлю ошибки UnknownHostException.
Может кто-то знает, какие параметры должны быть дополнительно указаны, в cite файлах, чтоб достучаться, до hadoop развёрнутого в докере?
Доступны порты 50070 и 50075, я так понимаю, через настройки в site файлах, надо достучаться до hdfs://namenode:8020
кто-нибудь сталкивался с проблемой
при обращении к внешней таблице подключенной через pxf получаю ошибку
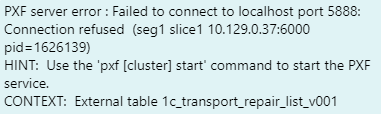
ERROR: PXF server error : ERROR: relation public.fact_stock_pxf does not exist (seg0 slice1 10.193.49.93:10000 pid=215495)
HINT: Check the PXF logs located in the '/var/lib/pxf/logs' directory on host 'gp-data-01' or 'set client_min_messages=LOG' for additional details.
CONTEXT: External table fact_stock_pxf
пересоздание не помогает, в логах pxf та же самая ошибка
2023-06-07 08:39:37.633 YEKT ERROR [62686-0000000005:pg_olap:1 ] 20413 --- [sponse-100] o.g.p.s.c.PxfErrorReporter : ERROR: relation public.fact_stock_pxf does not exist
Position: 234
org.greenplum.pxf.api.error.PxfRuntimeException: ERROR: relation public.fact_stock_pxf does not exist
с другими внешними таблицами проблем нет
неверный путь в LOCATION
Ошибка в логах ADCM (раз в 5 сек) :
[WARN] log.go:86: HOST_NOT_FOUND unknown host
[WARN] log.go:86: HC_NOT_FOUND Component #5 is not present on host #7 (похоже на внутренний номер мастера)
Конфиг: Community ver., 2 хоста, на хосте 4 мастера и 4 зеркала.
Компонент #5 это второй мастер сегмент на втором хосте получается?
Данный warning проявляется морганием статуса хоста в ADCM.
Куда копать? Пинги ровные, gpcheckperf около 91%
Можно попробовать заново установить statuschecker на хост, или поковырять каталог /usr/lib/adcm-status-checker
Кто-нибудь сталкивался с применением оконных и агрегатных функции в CTE? Пользуемся ADB 6.18 - там они работают, в 6.23 выпадает ошибка: SQL Error [0AM01]: ERROR: window functions in the target list of a recursive query is not supported in Greenplum
https://github.com/greenplum-db/gpdb/issues/13299
хотел узнать кто нибудь сталкивался с такой ошибкой
psycopg.errors.InternalError_: Canceling query because of high VMEM usage. current group id is 33137, group memory usage 7384 MB, group shared memory quota is 6192 MB, slot memory quota is 32 MB, global freechunks memory is 136 MB, global safe memory threshold is 144 MB (runaway_cleaner.c:197) (seg56 slice180 10.42.100.84:10002 pid=9741) (cdbdisp.c:254)
проверить наличие статистики у объектов в запросе, оптимизировать ресурсные группы, оптимизировать запрос
Есть таблица.Владеет ей роль Х. Есть функция , которая удаляет патриции старше определенного периода из этой таблицы. Владельцем её тоже является роль Х. Запускает эту функцию юзер у1 роли У. При запуске функции выдает ошибку что нет прав у у1.
Вариант с перенести пользователя y1 в роль Х - не подходит. Сделать владельцем таблицы пользователя у1 тоже не подходит.
Подскажите, есть ли еще какие варианты?
Создать функцию по удалению типа security definer от имени роли x
Помогите пожалуйста с попыткой записи в external table.
Согласно оф.документации, в GP можно подключить внешнюю таблицу(таблица базы Postgresql), или только для чтения, или только для записи.
С подключением к PG таблицы на чтение, проблем не возникло, при ее селекте отдаются данные.
Пример подключения внешней таблицы:
CREATE READABLE EXTERNAL TABLE pxf_pg_read(xxx, xxx, xxx) LOCATION ('pxf://таблица базы для чтения?PROFILE=JDBC&JDBC_DRIVER=org.postgresql.Driver&DB_URL=jdbc:postgresql://ip адрес PG:5432/подключаемая база&USER=логин&PASS=пароль') FORMAT 'CUSTOM' (FORMATTER='pxfwritable_import');
Проблема с записью в внешнюю таблицу.
Пример подключения таблицы в режиме записи:
CREATE WRITABLE EXTERNAL TABLE pxf_pg_write(xxx, xxx, xxx) LOCATION ('pxf://таблица базы для записи?PROFILE=JDBC&JDBC_DRIVER=org.postgresql.Driver&DB_URL=jdbc:postgresql://ip адрес PG:5432/подключаемая база&USER=логин&PASS=пароль') FORMAT 'CUSTOM' (FORMATTER='pxfwritable_import'); Так вот.
Таблица для записи создается, но при попытке инсерта данных, получаю ошибку
ERROR: formatter function pxfwritable_import of type writable was not found
Перевод:
ОШИБКА: функция форматирования pxfwritable_import типа с возможностью записи не найдена
Надо pxfwritable_export
Здравствуйте!
Нужна помощь сообщества.
При попытке выполнить gprecoverseg -F получаю ошибку вида:
20230807:20:43:28:008697 gprecoverseg:gps01:gpadmin-[CRITICAL]:-gprecoverseg failed. (Reason='Failed to query gp_stat_replication: error 'ERROR: could not open file base/16384/2566700: Operation not permitted (seg18 10.10.10.14:6002 pid=25294)
' in 'SELECT pg_catalog.set_config('search_path', '', false)'') exiting...
или
20230807:20:37:16:007916 gprecoverseg:gpn01:gpadmin-[ERROR]:-Unable to update pg_hba conf on primary segment: cmd had rc=255 completed=True halted=False
stdout=''
stderr='kex_exchange_identification: Connection closed by remote host
'
20230807:20:37:16:007916 gprecoverseg:gpn01:gpadmin-[ERROR]:-Unable to update pg_hba.conf on the primary segments
20230807:20:37:16:007916 gprecoverseg:gpn01:gpadmin-[CRITICAL]:-gprecoverseg failed. (Reason='Unable to update pg_hba.conf on the primary segments.') exiting.
сегменты не поднимаются, ни после рестарта кластера, ни после рестарта серверов.
Я в некотором замешательстве. Подскажите, пожалуйста, куда копать? Может, случалось у кого такое в практике?
По первой ошибке - безопасность накинула на кластер агент Касперского, который резво блокировал доступ к файлам БД Грин Greenlum. Отключили везде lightagent и ошибка ушла.
По второй ошибке - битый файл pg_hba.conf. Восстановил файл из бэкапа и ошибка ушла. Кластер восстановился и работает ок.
у меня последнюю неделю начал падать gpbackup. Выражается в том, что застревает на какой то таблице и команда COPY .. TO PROGRAM 'zstd ...' висит пока не снимешь. В логах нашел ошибку read err msg from pipe, len:38 msg:zstd: /*stdout*\: Input/output error. Причем сегменты с этой ошибкой чередуются и выскакивают на разных нодах.
Есть у кого-нибудь идеи, с чем это может быть связано?
С большой долей вероятности будет падать с ошибкой can not start command, и SQLSTATE 53000, такое не раз встречал на версии 1.20 и 1.23, но эти версии хотя бы такие ошибки вываливают и РК падает с ошибкой. А версия 1.27 просто зависает. Пока проверил 1.23, в ней есть поддержка zstd, попробуйте эту версию поставить
Ощущение, что каких-то системных ресурсов не хватает, надо логи ОС сильно копать.
я пытаюсь с помощью pxf прочитать таблицу из pg в которой есть тип данных jsonb, указывал при этом тип данных text и bytea, получал одинаковую ошибку о том что такой колонки не существеет ?
Вопрос: Как с помощью pxf прочитать колонку с типом данных jsonb ?
захардкодить запрос с конвертацией в текст. и зделать внешнюю таблицу смотрящую на запрос
либо вьюху в ПГ замутить
При перезапуске GreenPlum Возникает такая ошибка:
gpadmin-[CRITICAL]:-Error occurred: non-zero rc: 1
Command was: 'env GPSESSID=0000000000 GPERA=None $GPHOME/bin/pg_ctl -D /home/gpadmin/data/master/gpseg-1 -l /home/gpadmin/data/master/gpseg-1/pg_log/startup.log -w -t 600 -o -p 5432 -c gp_role=utility start'
rc=1, stdout='waiting for server to start.... stopped waiting
', stderr='pg_ctl: could not start server
Examine the log output
Перед этим:
gpadmin-[DEBUG]:-Running Command: env GPSESSID=0000000000 GPERA=None $GPHOME/bin/pg_ctl -D /home/gpadmin/data/master/gpseg-1 -l /home/gpadmin/data/master/gpseg-1/pg_log/startup.log -w -t 600 -o -p 5432 -c gp_role=utility start
20230905:17:49:36:003415 gpstart:msk-es04-app192:gpadmin-[CRITICAL]:-Failed to start Master instance in admin mode
В логе vim /home/gpadmin/gpdata/gpmaster/gpseg-1/pg_log/startup.log:
2023-09-05 17:40:12.787987 MSK,,,p3153,th90770688,,,,0,,,seg-1,,,,,FATAL,58P01,could not access file pg_stat_statements: No such file or directory,,,,,,,,internal_load_library,
dfmgr.c,202,sh: addr2line: command not found
1 0xbdbe88 postgres errstart + 0x2b8
2 0xbe133d postgres <symbol not found> + 0xbe133d
3 0xbe19e4 postgres load_file + 0x24
4 0xbeb99a postgres <symbol not found> + 0xbeb99a
5 0xbecafe postgres process_shared_preload_libraries + 0x1e
6 0xa1c4d7 postgres PostmasterMain + 0x8f7
7 0x6de1fb postgres main + 0x42b
8 0x7f82020fed85 libc.so.6 __libc_start_main + 0xe5
9 0x6e9fde postgres _start + 0x2e
Подскажите, в чем ошибка и как это исправить?
Ошибка очевидна, нет библиотеки pg_stat_statements.
Как бороться с SQL Error [53500]: ERROR: Out of memory
Подробности: System memory limit reached, failed to allocate 98360 bytes from system ?
Это ошибка связана с нехваткой памяти для выполнения запроса. В общем случае требуется проанализировать план выполнения запроса. Можно ещё посмотреть в sysctl.conf - параметр vm.min_free_kbytes выставить в 3% от Ram. Есть статья от вендора. И управлению памяти в GP есть два варианта
Resource Queues и Resource Groups.
Предварительно нужно понять какой из них используется
https://docs.vmware.com/en/VMware-Greenplum/7/greenplum-database/admin_g...
Подскажите пожалуйста, не могу настроить подключение через gpfdist. А именно не получается вставить данные из плоского файла в готовую таблицу в GP.
External_table, функция для записи данных все это есть
Как мне кажется проблема в самом gpfdist
Смените винду на линукс, потом можно пробовать. Конкретно этой ошибке: он же чётко говорит, ч о не может создать сокет на порту 8080. Либо порт уже чем-то занят в системе, либо файрвол виндовый
Ролевые модели
Возник вопрос, связанный с механизмом, регламентирующим политику доступов в GP. Существует ли какая то утилита, которую можно отдать допустим отделу безопасности и которая позволит наглядно настраивать гранты? Пытался отыскать сам, ничего не нашел.
Нет там такого, только привязка роль- ресурсная групп
помогите пожалуйста разобраться. Хочу в таблице изменить владельца, получаю такое сообщение
ERROR: must be member of role
я не очень понимаю, почему он требует для смены владельца таблицы быть членом групповой роли
Если вы не супер пользователь, то назначить владельца можете только в том случае, если у вас с ним есть общие роли.
Т.е вы должны с новым владельцем пересекаться в общих ролях
А вообще более правильно в таких случаях ставить владельцем объекта общую роль, и не иметь головной боли по смене владельца. Т.е user1 и user2 входят в роль role1. Ставите владельцем role1 и много проблем решается
Поделитесь, пожалуйста, скриптом, для выгрузки всех доступных пользователю для чтения схем и таблиц.
https://telegra.ph/Novyj-instrument-dlya-GreenPlum-i-PosgreSQL-10-18
Ссылка на github: https://github.com/dns-technologies/gppm
А есть возможность защитить пароль в pxf-профиле пользователя, кроме подключения к Hadoop? Смущает, что пароль пользователя СУБД лежит в открытом виде в файлике настроек профиля.
Ну у Арены по идеи есть их надсройка, так называемый Keystore file
https://docs.arenadata.io/ru/ADB/current/references/adcm-config.html
Keystore file
Абсолютный путь к файлу хранилища ключей (keystore) JKS. Например, /var/lib/pxf/conf/pxfkeystore.jks
Но там по сути просто хранилище с паролями, и злоумышленику придется сделать на шаг больше, если он попадет на хост
с первого грепа так сказать не наберет паролей
придется на 5 минут дольше посидеть подумать
А можно ли при создании EXTERNAL TABLE на запись в CH с использованием протокола pxf использовать профиль подключения, а не светить пользователя и пароль в LOCATION?
Что-то вроде такого: CREATE WRITABLE EXTERNAL TABLE ch_write(key int) LOCATION ('pxf://default.test?PROFILE=clickhouse&SERVER=ch_server') FORMAT 'CUSTOM' (FORMATTER='pxfwritable_export');
CREATE WRITABLE EXTERNAL TABLE load_test_1.ext_click_test
(a int)
LOCATION ('pxf://test?PROFILE=JDBC&SERVER=clickhouse')
FORMAT 'CUSTOM' (FORMATTER='pxfwritable_export');
и в /home/gpadmin/pxf-base/servers/clickhouse/jdbc-site.xml чет типо <?xml version=1.0 encoding=UTF-8?>
<configuration>
<property>
<name>jdbc.driver</name>
<value>ru.yandex.clickhouse.ClickHouseDriver</value>
</property>
<property>
<name>jdbc.url</name>
<value>jdbc:clickhouse://xxx.xxxx.xx:8123/test</value>
</property>
<property>
<name>jdbc.user</name>
<value>testuser</value>
</property>
<property>
<name>jdbc.password</name>
<value>testpwd</value>
</property>
</configuration>
PXF
а чего за метрики c pxf собираете ?
В pxf не так давно появилось из коробки api, которое умеет в прометеусовский формат
Может вывести больше 50 метрик
Можно забирать как прометеем, так и забиксом через http-агент
Метрики с данными доступны по HTTP, необходимо обратиться к хосту с установленным сервисом PXF по следующему пути - http://hostname:5888/<endpoint>[/<name>].
В данным момент (версия PXF доступная нам 6.3.1) доступны следующие endpoint:
actuator – возвращает список endpoint’ов
actuator/health – возвращает информацию о здоровье сервиса
actuator/info – возвращает информацию о версии сервиса
actuator/metrics – возвращает данные указанных метрик
actuator/prometheus – возвращает данные всех метрик в формате Prometheus.
http.server.requests

jvm.buffer.count

jvm.buffer.memory.used

jvm.buffer.total.capacity

jvm.classes.loaded

jvm.classes.unloaded

jvm.gc.live.data.size

jvm.gc.max.data.size

jvm.gc.memory.allocated

jvm.gc.memory.promoted

jvm.gc.pause

jvm.memory.committed

jvm.memory.max

jvm.memory.used

jvm.threads.daemon

jvm.threads.live

jvm.threads.peak

jvm.threads.states

log4j2.events

process.cpu.usage

process.files.max

process.files.open

process.start.time

process.uptime

pxf.bytes.sent

pxf.fragments.sent

pxf.records.sent

system.cpu.count

system.cpu.usage

system.load.average.1m

tomcat.cache.access

tomcat.cache.hit

tomcat.connections.config.max

tomcat.connections.current

tomcat.connections.keepalive.current

tomcat.global.error

tomcat.global.received

tomcat.global.request

tomcat.global.request.max

tomcat.global.sent

tomcat.servlet.error

tomcat.servlet.request

tomcat.servlet.request.max

tomcat.sessions.active.current

tomcat.sessions.active.max

tomcat.sessions.alive.max

tomcat.sessions.created

tomcat.sessions.expired

tomcat.sessions.rejected

tomcat.threads.busy

tomcat.threads.config.max

tomcat.threads.current
Возможностью s3 external таблицы можно только csv и text файлы передавать? Нет возможности передавать туда byte значения фото, чтобы потом только по ссылке обращаться к фотографии в minio s3
Да. Произвольные бинари из GP в виде файлов писать, пожалуй, не получится из коробки. Разве что расчехлить джаву и написать сериалайзер свой, который подсунуть в PXF.
такой вопрос сейчас возник, а как gp научить в спарк ? У АДБ есть прямой коннектор для PXF, а ваниль как ? Через hadoop как-то ?
https://network.tanzu.vmware.com/products/vmware-tanzu-greenplum#/releases/1226395/file_groups/11354
А подскажите, если отбросить gpfdist, есть какой-то вариант законнектить GP - GP по PXF ? jdbc:postgre ?
GP-GP через PXF это будет тогда на стеке сегменты ломятся в 1 мастер, насколько я правильно помню. Я бы попробовал сделать это через буферную зону, например S3
https://gpdb.docs.pivotal.io/6-0/pxf/jdbc_cfg.html
Подскажите пожалуйста как подключить таблицу из clickhouse через pxf в Greenplum
Заранее благодарю
Создаете профиль в servers и засовывайте в lib jar-файл драйвера
Есть руками собранный из аренадатовского гита GP с единственным изменённым параметром namedatalen. В ADCM всё видно, красиво. PXF через этот же ADCM прекрасно устанавливается, я могу запускать команды вроде pxf cluster sync.
Однако в самой базе при создании экстеншена для pxf, оно ругается
create extension pxf
[58P01] ERROR: could not access file $libdir/pxf: No such file or directory
такой переменной в списке env нет, где он что смотрит - непонятно, тем более, что сам pxf работает. Отказаться от кастомной длинны мы не можем. Примерно та же фигня и с PostGIS, но это менее важная проблема.
Я бы посмотрел в направлении настройки GP dynamic_library_path или других со словом library, а также переменной среды LD_LIBRARY_PATH
Из Hive в GP через pxf загрузка будет идти в один поток или распределенно?
https://greenplum.docs.pivotal.io/6-0/pxf/intro_pxf.html
Your Greenplum Database deployment consists of a master node and multiple segment hosts. A single PXF agent process on each Greenplum Database segment host allocates a worker thread for each segment instance on a segment host that participates in a query against an external table. The PXF agents on multiple segment hosts communicate with the external data store in parallel.
подскажите, как состыковать greenplum и oracle? есть ли возможность использовать oracle_fdw на greenplum? буду очень благодарен за любую информацию
pxf
https://gpdb.docs.pivotal.io/6-2/pxf/overview_pxf.html
А такой вопросик у коллег возник, если через PXF в HDFS создавать объект, его можно как-то партиционированно создать ?)
Учитывая как сделано партицирование обычных таблиц... Ну - также создать в несколько таблиц с checkами и объединять вьюхой...
Есть ли возможность PXF-ом читать xlsx?
Это ж XML в принципе. Как текстовый файл всырую по идее можно, а для разбора структуры форматтеров не встречал. У xlsx/xls есть odbc или oledb провайдер. Так что в принципе можно настроить провайдер, если он для Linux есть.
Можно но ли по PXF передать на БД-источник фильтр на ограничение строк (limit 1, например, на PostgreSQL)?
Нет. Named query разве что
Подскажите можно ли как то проверить отрабатывает фильтр при обращении к внешней таблице (gp_external_enable_filter_pushdown) . Доступа к внешней СУБД нет.
В логах pxf видно будет
Скажите пожалуйста parquet через pxf проливаю в бд , в parquet формат даты timestamp[ns] при заливке в GP добавляется часовой пояс +3 , как это можно исправить ?
timestamp
если timestamp WITH TIME ZONE то результат такой же
Подскажите как можно избежать добавления PXF-ом часового пояса к дате?
В parquet лежит 10 утра, в external тэйбл + 3 часа вне зависимости от типа, указанного в схеме внешней таблицы: timstamp/timestamp without timezone/varchar
Поставить ту жэ таймзону, что и при добавлении.
Кто нибудь сталкивался с PXF session flood в Oracle? Сессии не дропаются, забивают SESSIONS_PER_USER и вообще ведут себя слишком вызывающе :)
и это всё при сравнительно не большом количестве сегментов ~200 и без jdbc.session.property.alter_session_parallel force.query
Нашел oracle.net.disableOob=true зависимости от версий jdbc и сервера oracle
Коллеги, можно ли для external table в качестве источника для pxf в location указать несколько файлов из директории minio, при условии, что в директории есть ещё файлы отличные по структуре от нужных, которые браться не должны?
Т.е. нужно именно перечислить несколько файлов из файлопомойки, как источник для таблицы.
Можно указать путь с помощью регулярных выражений
например, pxf://путь/файл/year=*/month=*
такой вопрос, а может ли читать pxf или gpfdist паркеты? Просто паркеты, в обычной папке. Без хадупа.
Gpfdist это совсем не про хадуп. Это, по сути, веб сервер. Parquet он не может. Согласно документации pxf может, из nfs, примонтированной к сегмент-хостам. Но, как я понимаю, чтение только однопоточное. Gpfdist только с помощью утилиты-трансформации, которая конвертирует в csv
Ребят, подскажите пожалуйста, есть csv файл, в котором в некоторых строках колонки невалидный формат date, можно ли как-то заставить pxf readable external table конвертить их в null при неудачной попытке спарсить date, а не кидать ошибку invalid input syntax for type date ?
Проще пред обработку файла сделать перед загрузкой, приведя значения в нужное. Airflow, NiFi и прочие ETL инструменты в помощь. Зато сможете не только дату преобразовывать в файлах.
при установке pxf.rpm требуется ли jvm?
Да
А может кто в курсе, как через pxf подключить несколько экземпляров кликхауса через один сервер ?
В мануале указано, что можете перебором
ip_addr:port, ip_addr2:port/database
но не принимает так PXF
chproxy возможно поможет перед CH
поделитесь знаниями по установке pxf у меня ванильная установка rpm пакетов
https://docs.vmware.com/en/VMware-Greenplum-Platform-Extension-Framework...
https://github.com/greenplum-db/pxf
Подскажите, пожалуйста, есть какой-нибудь гайд установки опенсорсного PXF с гитхаба?
Apache Hawq
Дополнительно
Есть ли в Greenplum какие-то средства для аудита DDL-операций?
Только лог
Знает ли кто-нибудь конфигурацию сервера по cpu/ram, для greenplum, что бы на нем могло спокойно работать ~25 DS’ов?
https://network.arenadata.io/arenadata-db/calculator-adb
А какие есть основные минусы развертывания greenplum на одном сервере?
Одно из основных преимуществ Greenplum это возможность распараллеливания нагрузки горизонтально и возможность наращивания ресурсов.
20230111:11:49:44:043619 gpstart:GP-1:gpdb-[INFO]:-DBID:25 FAILED host:'GP-4' datadir:'/opt/gpdb/data2/primary/gpseg23' with reason:'cmd had rc=2 completed=True halted=False
stdout='20230111:11:49:41:038379 gpsegstart.py_GP-4:gpdb:GP-4:gpdb-[INFO]:-Starting gpsegstart.py with args: -M mirrorless -V postgres (Greenplum Database) 6.23.0+dev.25.g0da3911d46 build dev -n 24 --era f7540b3adf591a5a_230111114940 -t 600 --master-checksum-version 1 -D 20|18|p|p|n|u|GP-4|gp-4|6000|/opt/gpdb/data1/primary/gpseg18 -D 21|19|p|p|n|u|GP-4|gp-4|6001|/opt/gpdb/data1/primary/gpseg19 -D 22|20|p|p|n|u|GP-4|gp-4|6002|/opt/gpdb/data1/primary/gpseg20 -D 23|21|p|p|n|u|GP-4|gp-4|6003|/opt/gpdb/data2/primary/gpseg21 -D 24|22|p|p|n|u|GP-4|gp-4|6004|/opt/gpdb/data2/primary/gpseg22 -D 25|23|p|p|n|u|GP-4|gp-4|6005|/opt/gpdb/data2/primary/gpseg23 -b 64
20230111:11:49:41:038379 gpsegstart.py_GP-4:gpdb:GP-4:gpdb-[CRITICAL]:-gpsegstart.py failed. (Reason='Local Software Version does not match what is expected.
The local software version is: 'postgres (Greenplum Database) 6.23.0+dev.30.g6f73f4d190 build dev'
But we were expecting it to be: 'postgres (Greenplum Database) 6.23.0+dev.25.g0da3911d46 build dev'
Please review and correct') exiting...
15:52
сегмент побился можно как-то восстановить или пересоздать?
Версии разъехались, на проблемном надо сделать такую же. На 5 этот способ точно работал, на 6 тоже должен. https://community.pivotal.io/s/article/5000e00001kyvj11595959354523?language=en_US
поднял тестовый GP и столкнулся с проблемой, транзакции после работы 25 минут уходят из режима active в idle в чем может быть проблема, какую настройку нужно поменять?
Если запрос долгий, то, возможно, фаервол срезает соединение. А там в зависимости от результатов, либо перенастроить ПО, которое срезает. Либо настроить тем или иным образом keep alive на стороне клиента
Подскажите плз, где можно посмотреть параметры resource queue? Типа gp_toolkit.gp_resgroup_config для ресурсных групп
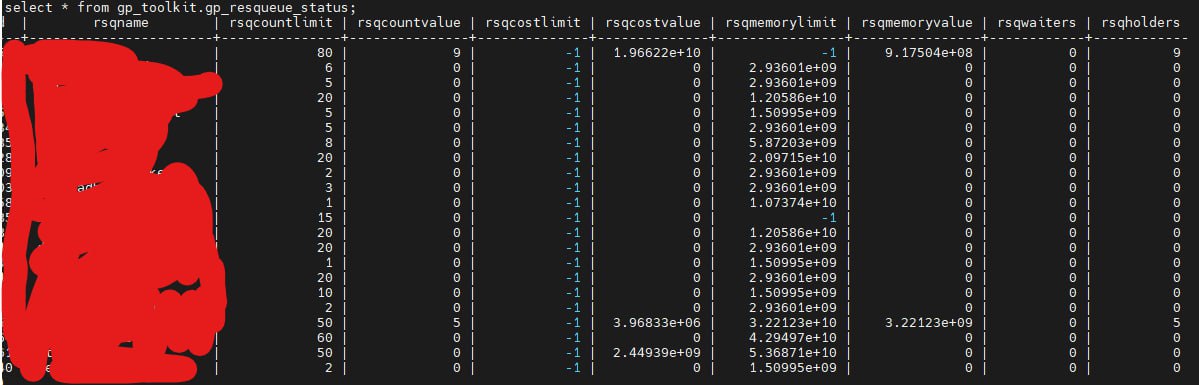
Как правильно выбирать ключ для равномерной дистрибьюции по нодам?
Уникальность, тип данных желательно int или что-то подобное. В идеале если по этому полю происходит join
Если есть сомнения лучше использовать рандомную дистрибуцию
Крайне нежелательно использовать date и text
Так же нежелательно использовать поля, чаще всего используемые в условиях отбора wherehttps://www.bigdataschool.ru/blog/data-distribution-and-partitioning-in-...
Подскажите, в гринпламе можно разграничивать пользователей по квотам потребления ресурсов?
ну условно чтобы аналитики adhoc запросами не положили регламент. https://docs.vmware.com/en/VMware-Tanzu-Greenplum/6/greenplum-database/G...
попробуйте dbt, а уже генерирование моделей вызывайте через airflow
Кто какие cdc использует чтоб доносить батчи изменений с источников в гринплам? Особенно в свете ухода вендоров оракл и клик
рекомендую посмотреть в сторону Debezium.
Уже достаточно распространенный в РФ опенсорсный CDC
есть таблицы в mssql с полями [from], [to], как правильно в GP создать внешнюю таблицу с такими полями? - не помогает
Добавь в location
"E_COLUMNS=true
Кто как анализирует планы, кроме рассматривания в текстовом виде?
Ранее на сайте GP была ссылка на Web App которая раскрашивала планы. Сейчас недоступна.
В ADCC, там и графический вид есть, и объекты, ресурсы и т.п. указываются отдельно ещё.
Greenplum начинает плохо себя чувствовать при более чем 500 одновременных соединений. Так ли это? И если да, то насколько это критично?
По дефолту 250 конннектов, изменение количества коннектов за собой подтягивает и другие лимиты, есть формулы в документах и манах.
А какие причины делать добавление именно через switch, кроме того, что надо прописывать параметры колонки?
Исходная таблица не блокируется надолго
А переключение происходит мгновенно
Кто-то проходил модерацию у VMWARE TANZU NETWORK чтобы скачать gpfdist ?
В целом есть инструкция как установить gpfdist на любой дистрибутив, лишь бы не дожидаться модерации акка у vmware, вообще непонятно сколько ждать
Не указывайте при создании аккаунта страну СНГ и проходите модерацию безусловно.
А как в pg_class называется поле для join-а ?
oid
А есть какие-то best-practices для интеграции Kafka с Greenplum?
Гринплам предлагает коннектор для спарка, а спарк умеет разговаривать с кафкой.
А GP6 в explain analyze выбирает план самого медленного сегмента?
Для самого загруженного выводятся показатели по строкам, времени и т.п.
всегда, то что выделено красным цветом относится к одному всегда самому загруженному сегмену. При чем он нигде не подписан?
Только правые параметры. Первая часть - среднерасчетное (где cost вместо actual time). Внизу ещё сегмент, потребивший максимум памяти указан (seg0), чаще всего это тот самый загруженный сегмент и есть
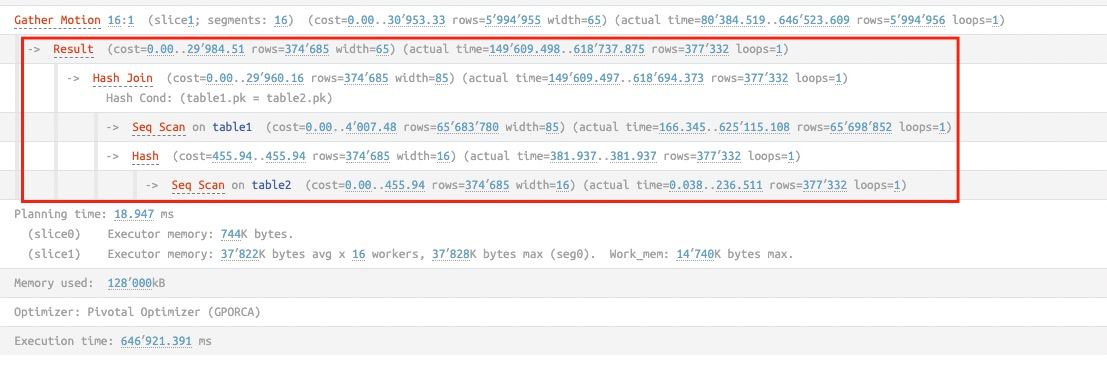
А почему первая часть - среднерасчетное (где cost вместо actual time)? Разве она берется не из статы того же сегмента?
Это то же самое, что выводится при explain. Там берется усредненное значение из статистики. Условно: в статистике есть информация о том, что в таблице 4000 строк, есть 4 сегмента. В той части будет 1000 строк (4000/4). По разнице между параметром rows в левой и правой части можно судить о наличии skew (перекоса) или о несвоевременно собранной статистике.
Если все 4000 строк лежат на одном сегменте, там все равно будет 1000 в левой части.
gp_segment_configuration
Но это делается только в мастер-онли, надо еще какой-то флаг дернуть, что можно воровать-убивать.
И это опасная операция.
Еще всякие pg_hba.conf надо поправить....
Лучше не делать :
Вопрос к знатокам, почему то при интеграции с ад, не хочет ходить по всему дереву ldapbasedn=dc=test, dc=com, нужно хотя бы первую ветвь указать ldapbasedn=ou=отдел1,dc=test, dc=com. Но это приводит к большому кол-ву записей по каждому отделу в pg_hba. Кто-то сталкивался с таким и как-то решили? Адб 6.20 если что, делал по примеру host all john 0.0.0.0/0 ldap ldapserver=ldap_host ldapbasedn=dc=example,dc=com ldapbinddn=cn=Manager,dc=example,dc=com ldapbindpasswd=changeme ldapsearchattribute=samaacount
Смутно припоминаю, что в сложных конфигурациях AD для хождения по всему дереву годится не всякий контроллер домена, а какой-то специально настроенный. Ваш ли это случай, точно не скажу.
Коду для взаимодействия с ldap внутри gp точно без разницы, откуда начинать поиск, так что это 100% проделки AD
Есть смысл погонять запросы руками через ldapsearch или какой ldapbrowser графический, обычно это проясняет обстановку
А в GP есть сворачивание по ключу?
Нет
кто может подсказать лучшие практики для создания правильной вставки без дублей и обновление по ключу?
вариант 1
вставляйте в постгрес и пользуйтесь фишками консистентности, а далее переливайте в гринплам
вариант 2
вставляйте в кликхаус и используйте движок CollapsingMergeTree, а далее переливайте в гринплам
Подскажите Greenplum Comand Center платный? У него нет особого EULA - попадает в общий Вмварный, где нет конкретики про этот продукт и про платность. Разве что запроещено декомпилировать. Я его спокойно скачал после регистрации и успешно установил. Но кто может конкретно показать, что он платный и нельзя им бесплатно пользоваться?
EVALUATION LICENSE. . If you license the Software for evaluation purposes (an “Evaluation License”), your use of the Software is only permitted for a period of thirty (30) days (unless we specify otherwise), and you may not use the Software with production data. Notwithstanding any other provision in this EULA, an Evaluation License of the Software is provided “AS IS” without indemnification, support or warranty of any kind, express or implied.
подскажите пожалуйста как правильно поправить. Мне нужно цифру 1 если она находится внутри двойных кавычек заменить на букву М
На выходе хочу получить: приМер меня укусил 1 коМар
select regexp_replace('при1ер меня укусил 1 ко1ар', '(.*?)(1)(.*)', '\1М\3', 'g');
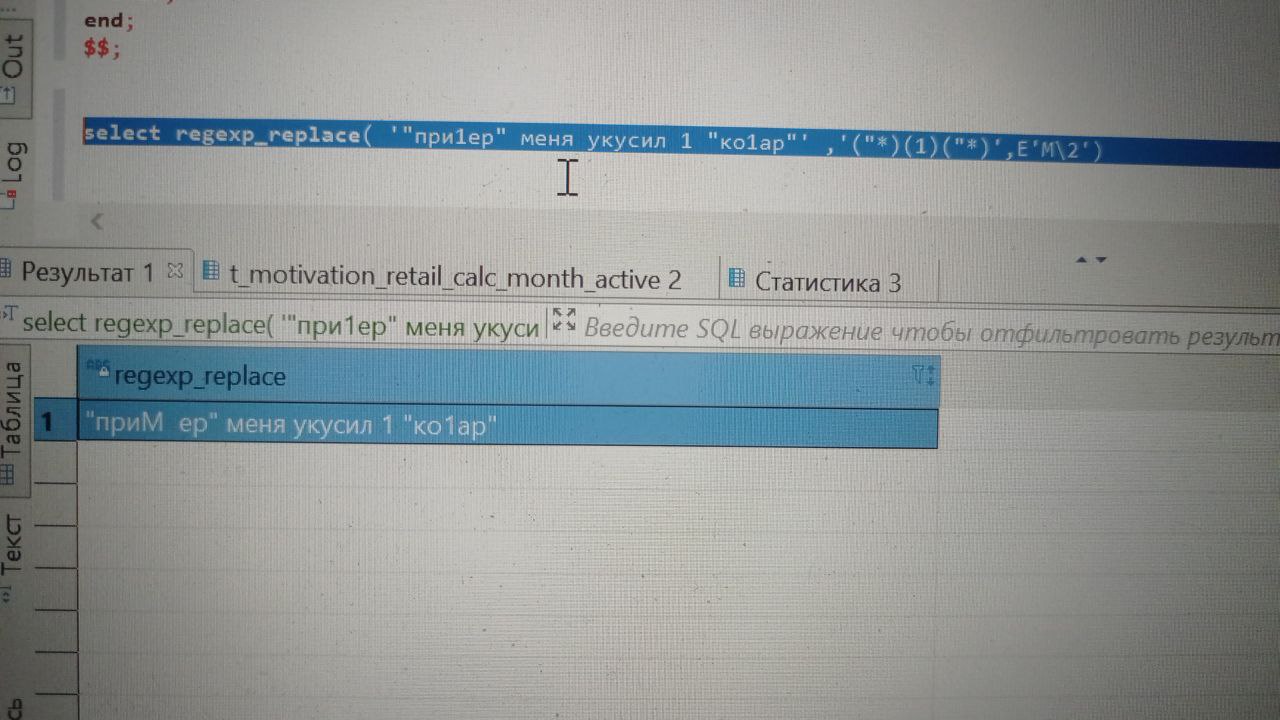
Коллеги, кто как относится к использованию CTE в запросах к Greenplum?
Просто я обучался гринпламу в команде, где CTE считается абсолютным злом и заблочен на уровне автотестов. В качестве причины назывались проблемы с распределением вплоть до расчета на одном сегменте.
Позднее, работая в других командах, встречал CTE неоднократно (за исключением рекурсивного). Но по привычке использовал временные таблицы.
В качестве причины назывались проблемы с распределением вплоть до расчета на одном сегменте.
Подскажите, на сколько безболезненно снимать задание vacuum ? могут ли быть негативные последствия ?
Проблем замечено не было. Если только не через kill -9 процесс убивать.
Здравствуйте
подскажите, alter table X truncate partition Y блокирует всю таблицу, тогда как правильно было бы блокировать только секцию. Это ограничение непоправимо?
Заменить партицию на новую пустую, дропнуть старую
А если транкейт сделать явно для соответствующей партиции таблицы ?
Так та же блокировка
Вопрос по jsonb, а как это теперь кастануть в int[] поле папарсилось из jsonb?
Вот строка вот так в массив парсится нормально и складывается ... там типы полей _varchat и _int4. А вот _int ни в какую((
INSERT INTO mart.test1 (
filter_list
,product_id)
select
string_to_array(body->>'filter_list', ';') AS filter_list
,cast(
coalesce(
nullif(
body->>'id_tov'
, '')
, '0')
as int[]) AS story_id
from public.raw_logs_uli
where cast(body->>'source' as int) in (2,3,4,5,0,10);
string_to_array(body->>'id_tov', ',')::int[] AS product_id
Расскажите пожалуйста про concurrently control, есть какие-то отличия от postgresa. Хочется узнать как это реализовывается и работает и поддерживается в гринпламе
На AO таблицах на апдейт и делит висит эксклюзивный лок. Не могут две транзакции менять одновременно. На heap - затрудняюсь ответить. Ответ в доках по постгресу. Думаю, что select for update на АО таблице разведется на локе уровня таблицы
На heap тоже эксклюзивный если не включать global deadlock detector (какой-то параметр)
Кто-то ставит greenplum на десктопные процессоры? Будет ли профит от высокой частоты на ядро? Задача:
Уехать из облака с их 2,1ghz скажем на amd под 4ghz, строить gp на bare metal
Возьмите нормальный сервер в аренду -- и поставьте нормальный postgres.
Можно пример конфига bare metal машины для 8TB? https://docs.arenadata.io/adb/equipment/variant.html#id4
Расскажите, пожалуйста, существует ли способ без пересоздания таблицы изменить её ориентацию? Забыли, что нужно писать orientation=column и теперь хотим всё таки это исправить.
подскажите пожалуйста, как строки на сегментах посчитать? я пару раз делал
select count(*), gp_segment_id
from public.uag_segmentation group by 2;
а сейчас обратил внимание, что тут оно не изменяется О_о ... при создании табилцы ключ дистрибуции указывал и там уже сотни миллионов строк, но парсинг идёт совсем мелденнно, подозреваю дистрибуцию..
у меняж там парсинг jsonb, а я и 10 дней ещё не залил, а там уже половина интервала времени парсингом перекрывается.. не могу понять почему гринплам так проседает.. мне туда год надо залить, а не 10 дней..
*кстати, у меня последний дибивер и он не правильно показывает ddl по созданию табилц в гринпламе:
у меня осталься скрипт, которым я создавал табилцу, на следующий день смотрю - дибивер говорит что поля дистрибуции нету.. коллега смотрит в дата грип - все ок, нужное поле выставлено в ддл. Я делаю реконнект и у меня дибивер начинает показывать DISTRIBUTED RANDOMLY, хотя там на самом деле указано конкретное поле)
Select count(*) from gp_dist_random(table);
подскажите, как поле дистрибуции поменять,
ALTER TABLE public.raw_logs_uli SET DISTRIBUTED by _date_start;
ALTER TABLE public.raw_logs_uli SET DISTRIBUTED by (_date_start);
А где подглядеть можно рейнджи партиций? у партиций с датами надобно поглядеть такое. или это чисто в ддл хранится?
В pg_partitions вся информация по партициям есть.
Подскажите, каким запросом можно получить информацию о дистрибуции и сжатию таблицы? select pg_get_table_distributedby('schema.table'::regclass::oid) - дистрибуция
сжатие - либо select reloptions from pg_catalog.pg_class where oid = 'schema.table'::regclass::oid ,
либо select * from pg_catalog.pg_appendonly
Как современный GP (6.22) переваривает иерархические запросы WITH RECURSIVE?
Как-то привык к тому, что это зло, но времена-то меняются...
Переносили из функционал из oracle, где дерево родитель/ ребенок разворачивалось в плоскую структуру с формированием полного пути до каждого листа. Прошло нормально. Объёмы не очень большие на выходе получилось 250000 строк
Подскажите пожалуйста возможно ли через pgfdist подгружать json файлы?
Как текст только. Можно обрабатывать при помощи трансформаций gpfdist перед загрузкой ещё, чтобы разбирать на значения, если такой вариант подходит
А как оцениваете вероятность коллизии?
Есть метод оценки. Но все равно это вероятностный процесс, гарантии что этого не случится вы дать не сможете.
Значит - в алгоритме загрузки это нужно проверять и обрабатывать
Авторы dv2 нескольку лукавят здесь и говорят у вас должна быть стратегия при коллизии хешей. Но не говорят какая
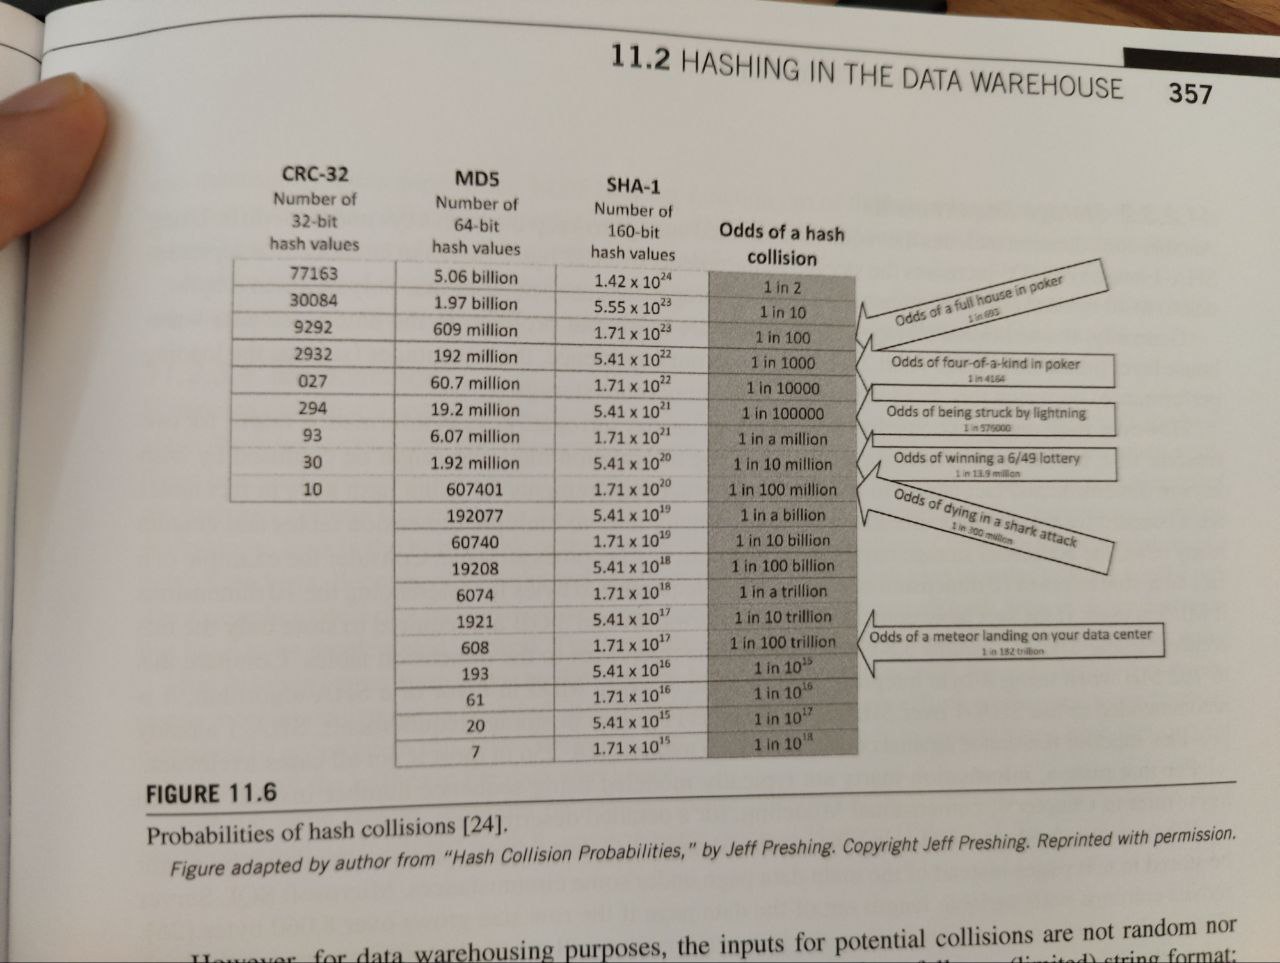
Вопросец. а можно как-то указать СТЕшке, чтобы она распределилась по сегментам? А то создаю СТЕ мелкую записей на 32, джоиню её с таблицей в 446413001 записей И происходит вот что:
-> Broadcast Motion 104:104 (slice1; segments: 104) (cost=0.00..431.01 rows=1 width=28) (actual time=0.081..3607647.121 rows=446413001 loops=1)
как вообще принудительно сказать планировщику, чтобы он СТЕ раскидывал а не тяжёлую таблицу?
Так проблема ж в статистике большой таблицы)
cost=0.00..431.01 rows=1 width=28
analyze big_table
Кто знает как узнать диапазон Range партиции ?
SELECT partitionboundary FROM pg_partitions WHERE partitionname='PARTITION_NAME' and tablename='TABLE_NAME';
Подскажите, пожалуйста, расширение pg_state_statement чем заменено в greenplum, как отдать метрики для внешнего мониторинга?
Нужно будет установить gpmom
Подскажите, пожалуйста, а как можно к таблице добавить партицию, которая партиционирована по дате по 1 дню, для не вошедших в диапазон партиций дат? т.е. бывают единичные строки, которые в партицию ни в одну не подходят.. их бы все в одну какую-то засовывать.. м? может такое возможно..
Default partition
К имеющимся добавить партицию которая партиционирована — вы говорите про второй уровень. Это не может быть одна партиция физически. Вы либо на первом уровне их разбиваете так, чтобы каждая строчка нашла свой диапазон, либо лишние будут все в кучу в дефолтной, либо лишние будут по сабпартициям дефолтной. Варианты 1 и 3 плохие, так как у вас будет много пустых партиций.
Лучше единичные лишние строки свалить в дефолтную
А ANALYZE работает для внешних таблиц? внешняя таблица на базе PostgreSQL.
When use_remote_estimate is true, postgres_fdw obtains row count and cost estimates from the remote server and then adds fdw_startup_cost and fdw_tuple_cost to the cost estimates. When use_remote_estimate is false, postgres_fdw performs local row count and cost estimation and then adds fdw_startup_cost and fdw_tuple_cost to the cost estimates. This local estimation is unlikely to be very accurate unless local copies of the remote table's statistics are available. Running ANALYZE on the foreign table is the way to update the local statistics; this will perform a scan of the remote table and then calculate and store statistics just as though the table were local. Keeping local statistics can be a useful way to reduce per-query planning overhead for a remote table — but if the remote table is frequently updated, the local statistics will soon be obsolete.
Документация postgres. По идее со времён postgres 9.4 не сильно изменилось поведение
Подскажите, пожалуйста, нужно ли в GP делать вакуум на таблицах, к которым применяется только select и insert?
Вот статья о том, для чего вакуумить insert-only таблицы в PG, в GP аналогично
https://www.cybertec-postgresql.com/en/postgresql-autovacuum-insert-only...
Если кратко: чтобы фризить xid, чтобы обновлять карту видимости, чтобы обновить статистику и commit log
Кто знает как победить. Вылетает на запросах.
Памяти дать в рг
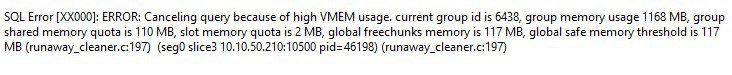
А обязательно ли делать VACUUM FULL регулярно? Или достаточно раз в неделю делать обычный VACUUM?
И ещё вопрос: лучше делать VACUUM по очереди или можно параллельно нескольким табличкам делать VACUUM?
Параллельно не желательно. Я блокировки ловил друг на друга. Проще по одной. Там всего 75 таблиц, если память не изменяет.
Вопрос, как в Greenplum обычно решается вопрос с тем чтобы при инсёрте удалить дубликаты по ключам?
Т.е. удалить строку, если в строке такие же timestamp и id. В клике помню что replicated merge tree для таких задач применяют, а вот в gp вообще ниразу не приходилось и не могу найти аналогов
Взять хеш от этих полей, поджойнить, промаркировать те, у которых есть соединение
Учтите, что запросы к таблице с партициями во внешних таблицах сразу выключают orca планировщик.
Может кто пролить свет на феномен в GP, почему появляются в нижних 3 строчках, тогда как на входе их нет ?
Видимо, regexp ищет не до первой открывающей скобки в шаблоне поиска '(', а до последней
А что такое GUC?
Global User Configuration параметры
А как обстоят дела с якорной моделью на GP? На сколько я понимаю тут merge join не так здорово работает, как например в вертике, т.к нет проекций. До какого условного объема gp может это вывозить ?
Плохо обстоит, не надо. Лучше DV
а у кто-то пользует OGG для вставки в GP на какой-то более-менее нагруженной реплике ?
Если только вставки , то используя батчи можно как-то это представить. А если с источника приходят обновления и удаления, то ...
срочно нужно поставить gp в докер, кто-нибудь может поделиться ссылкой где может быть описан этот процесс, а то я не смог нагуглить ничего понятного?
Вот, к примеру, готовый вариант https://hub.docker.com/r/projectairws/greenplum
WAL-архивацию Greenplum можно рассматривать просто как архивирование WAL-файлов для каждого сегмента, как отдельного Postgres инстанса? Или есть подводные?
Кажется есть, https://www.youtube.com/live/HZCge6ZkrP0?feature=share ребята из Яндекса тут рассказывали как wal-g реализацию постгресовую адоптили под gp
А у кого-нибудь настроена GP на ldap через керберос ?
https://github.com/yandex/odyssey
Все тоже самое что и для постгреса
https://www.opennet.ru/tips/3212_postgresql_kerberos_ldap_activedirector...
подскажите, кто-то рейд не 1\10 использует ?
Лучше не надо. Много мелких дисковых операций, на которых другие raid помрут
может кто-то подсказать, как в постгре привести timestamp к московскому времени?
Select now() at time zone 'MSK';
Коллеги, подскажите, что не так ? GP не поддерживает алиас на апдейт ?
В левой части не должно быть alias, только в правой он разрешён
Т.е, не set x.c_name, а просто set c_name =
Куда GP пишет spill файлы? Чем это управляется?
Есть всякие GUC которые управляют количеством спиллов, а вот где они лежат? /data/primary/gpseg???/base/pgsql_tmphttps://gpdb.docs.pivotal.io/6-12/admin_guide/ddl/ddl-tablespace.html
кто использовал нежурналируемые таблицчки в GP? (unlogged)
Плохая идея. Ну они и без перезагрузки могут потеряться.
что такое статистика для таблицы и как можно его увидеть?
Статистика - это информация о содержимому таблицы, сохраняется в pg_statistics. Используется при построении плана запроса и выделении памяти для него. Собирается командой ANALYZE имя_таблицы;
Посмотреть, как давно собиралась статистика, можно в pg_stat_operations
Не совсем понял…utility mode включен автоматически при старте с флагом “m”. И на хосте уже запущен только мастер инстанс
это_ подключение_ с utility_mode, т.е. напрямую к сегменту, а не к кластеру. Чтобы GP разрешил такое подключение надо ему прописать этот самый mode
Господа, помогите советом
Есть boolean поле в гринпламе, оно часть заполнено null, часть [ ] (без галочки типа) . При передаче в оракл конвертируется в бесконечно великое множество, которое познало жизнь 202020202020202000000000000000000. в оракле намбер тип
как это пофиксить можноCase
может кто подсказать, фильтрую внешнюю таблицу(пхф на бд оракла) по датам(все строки столбца заполнены)-выполняется относительно быстро, добавляю ещё фильтр(в значениях поля есть nulls), что бы уменьшить объём в 2 раза - выполняется в несколько раз дольше, как корректно добавить условие на доп. поле, чтобы производительность не упала? объёмы большие выполняется всё в сумме долго - тестирую по мере возможности.
Если хочешь в оракле выбрать null то сразу пойдет fullscan потомучто нуловые значения не индексируются. в том то и дело, нулы мне не нужны, но на сколько я знаю, в оракле даже если есть нулы в значениях поля, и битмап индексов, то он фулсканит
Подскажите, пожалуйста, как определить, на каком именно сегменте выполняется сейчас запрос?
Процессы посмотреть на сегментных серверах. Там будут процессы вида con234533, где числа - это идентификатор открытой сессии сквозной.
Есть такой вопрос. При конфигурировании GP с двумя сетевыми интерфейсами как их GP воспринимает, как один основной а второй резервный или как расширение канала? Настраиваете агрегацию портов на уровне ос и коммутатора https://duckduckgo.com/?q=network+routing
or
https://duckduckgo.com/?q=network+bonding
Бондинг - объединение нескольких интерфейсов в один.
Например, 4 гигабитных интерфейса можно превратить в один 3.8 гигабитный.
Или 2 с двумя зеркалами для устойчивости. Или как угодно...
Роутинг - таблица маршрутизации. Можно к любому адресу обращаться через определенный интерфейс.
Проще всего - объясните своему систадмину, что вам надо. С этим любой джун справится.
Это все на ОС и GP ни при делах.
может кто боролся с broadcast motion, статистику собирали, но орка почему то все равно делает broadcast motion.
Пример:
2 таблицы, одна 200М вторая 2К (и по ней идет фильтрация), Простой джойн двух таблиц и почему то арка считает что нужно сделать broadcast motion для таблицы 200М.
Может у кого были такие проблемы работы с оркой, куда копать?
Это проблемы дистрибьюции таблиц
подскажите, пожалуйста, как поставить pip в greenplum ?
А то он ругается, что не видит такого модуля
pip - это менеджер пакетов для python, он идет с ним в комплекте
как можно изменить значение reloption таблицы (в частности все что относится к storage_parameter) и возможно ли это, через SET у меня не получается. для GP7 нашел как менять параметр orientation. спасибо за ваше внимание.
если задача поменять ориентацию и аппендонли, то да, дропнуть старую и создание новой https://docs.vmware.com/en/VMware-Greenplum/6/greenplum-database/ref_guide-sql_commands-ALTER_TABLE.html
Коллеги, а как так получается, что размер AOCS не ограничен?
По доке, AOCS может иметь до 128 segfiles(и то, если была конкурентная вставка). Но размер файла же ограничен по крайне мере файловой системой.
Скорее ограничен диском. Ограничения файловых систем это петабайты.
Подскажите пожалуйста, если у меня на хостах будут разные модели процессоров, GP будет работать?
да, но со скоростью самого медленного сервера
А можно ли развернуть гринплам в режиме single node?
Можно
Commit idle стоит что это означает, заранее спасибо !
commit - последний запрос
idle - подключение есть но простаивает
Подскажите, почему LEFT OUTER JOIN и RIGHT OUTER JOIN работают по-разному (для right неоптимальный план выполнения получается, хотя логика идентична)?
Gp 6, ORCA
Это фича из 6.14! GPORCA now generates a plan alternative for a right outer join transform from a left outer join when equivalent. GPORCA's cost model determines if/when to pick this alternative; using such a plan can greatly improve query execution performance by introducing partition selectors that reduce the number of partitions scanned.
После восстановления сегментов, столкнулся с проблемой, что на части таблиц селект ошибается с:
could not open file pg_tblspc/24896/GPDB_6_301908232/796513/34832972: No such file or directory (seg20 slice1 <ip>:<port> pid=1190)
gpcheckcat показал несколько тысяч подобных записей:
Object oid: 321
Table name: pg_proc
Name of test which found this issue: inconsistent_pg_proc
prodataaccess is 'n' on content -1 (master:5432) content 20 (segment5:10000) content 21 (segment5:10001) content 22 (segment5:10002) content 23 (segment5:10003) content 24 (segment5:10004) content 25 (segment6:10000) content 26 (segment6:10001) content 27 (segment6:10002) content 28 (segment6:10003) content 29 (segment6:10004)
prodataaccess is 'c' on all other segments
Это, собственно, соседи, между которыми и было переключение\восстановление сегментов.
При этом поискал файлик у соседа, он есть на файловой системе, но пустой.
Что тут можно сделать, кроме пересоздания проблемных таблиц?
Восстановление и ребаланс при этом прошли без ошибок, стоп\старт тоже без проблем.
Unlogged таблицы так себя ведут при падении primary сегментов. Пересоздание только и перезаливать данные, таблица нетчитаема. Если unlogged были отдельные партиции, то можно попробовать их отстегнуть в обычные. Но может не получится
Кто знает, откуда такие объемы?
копия на каждом сегменте, хранятся поля для каждой таблицы - а значит для каждой партиции.
Это хип таблица, ее надо vacuum'ить время от времени. Если долго не делали vacuum - то можно сделать vacuum full, но предварительно всех выгнав с кластера
Подскажите, хочу попробовать greenplum локально. Как это проще всего сделать? Привык, что для других БД есть docker образы и docker-compose.yml где всё запускается с адекватными дефолтами, а для Greenplum такое есть? Поиск по докерхабу ничего внятного не дал. Версия 6.20 opensource, если это важно.
Мне попробовать именно базу - DDL, запросы и т.д. Так что в принципе, даже с одним сервисом-сегментом устроит (ну или 2-3).
Да. Каноническая статья как поставить мастер + два сегмента на одну ubuntu https://greenplum.org/install-greenplum-oss-on-ubuntu/
Подскажите пожалуйста, имеется ли аналог pgcompacttable для GP?
нет. https://habr.com/ru/companies/axenix/articles/710806/
Подскажите, в ресурсных группах есть memory_limit - в рамках GP он задается gp_vmem_protect_limit илии же что то другое ?
ALTER RESOURCE GROUP ktulhu_fhtang SET MEMORY_LIMIT 666; процент от общей памяти выделенной для сегмента, то есть процент памяти GP на ноде деленное на количество сегментов на ноде
вопрос на засыпку - зачем на слейв-хосте развёртывать n сегментов-инстансов посгреса?
На первый взгляд логично было бы иметь один инстанс на ноду, чтобы не было разделения ресурсов ноды (два инстанса, если так строить миррор).
Для лучшей утилизации ресурсов
cte от постгрешной отличается в gp?
Синтаксис или ограничения какие-то
Ограничение - не более одного модифицирующего cte на один запрос.
подскажите более удобный способ установки GP
Самое удобное - не ставить GP, поставьте что-нибудь другое.
А так, ADCM от Аренадаты самый простой. https://wiki.salo.vip/index.php?title=Kon:services:greenplum
где можно посмотреть перечень стандартных коннекторов, которые поддерживаются в GreenPlum
HDFS, Hive, HBase и JDBC. Про S3 не помню, есть ли в ваниле у PXF.
кто может помочь мне, я сам разработчик, но не имею опыта в поднятии Greenplum, может подскажите ресурс как поднять локально гренплам с видео https://wiki.salo.vip/index.php?title=Kon:services:greenplum
Distributed randomly
В разных источниках встречаются разные варианты пояснений
От round robin до
Greenplum Database random distribution is not round-robin, so there is no guarantee of an equal number of records on each segment. Random distributions typically fall within a target range of less than ten percent variation.
Как на самом деле?
Не раунд робин. Там распределение гаусса. Мы это тестировали специально. Если записей меньше 1кк это видно, после 1кк все становится более-менее ровно.
Подскажите, пожалуйста, сталкивался ли кто-нибудь с тем, что гринплам по-разному себя ведет при сборе статистики для партиционированных таблиц? А именно: есть 2 полностью одинаковые по структуре, дистрибуции и партиционированию таблицы, в одной - порядка 5 млн строк в каждой месячной партиции, в другой - 50 млн строк. Для первой, при выполнении ANALYZE <partition name> база пробегает только по этой партиции. При выполнении этого же запроса на второй таблице, выполняется еще и второй шаг - analyzing table_name inheritance tree, то есть собирается стата вообще по всем остальным партициям, и этот этап бежит заметно дольше первого. Есть ли какие-то конфиги для сборщика статистики, по которым определяется, нужно ли анализировать inheritance tree? Пока не очень понятно, что кроме объема партиций и условной границы в 10 млн строк может на это влиять
Есть параметр optimizer_analyze_root_partition. Но не 100% бьётся с указанным поведением.
Можно предположить, что параметр включен. И для первой таблицы при сборе статистики на одной партиции есть другие партиции с пустой статистикой. Тогда на родительской таблице не будет собираться статистика (правильней сказать агрегироваться). А во втором случае, возможно, это последняя партиция без статистики. И она триггернула обновление статистики на родительской таблице.
Подскажите, чтобы подключиться к greenplum базе нужен специальный драйвер просто в datagrip postgress подтягивается?
postgres драйвера достаточно
Может у кого-то есть ссылка на статью или заготовки какие метрики необходимо мониторить по таблицам gp. Место, блокировки, упавшие сегменты и прочее
Ну примерно так.
https://docs.vmware.com/en/VMware-Greenplum/6/greenplum-database/admin_g...
Остальное практически как в ПГ.
в GP как можно узнать как overcommit_ratio задан? или он идет по умолчанию 0.5?
sysctl vm.overcommit_ratio
как быстро посмотреть суть таблицы в psql? АО или не АО, сжатие, дистрибуция
\d+ <name>
Планирую потестить сливу для частичного переезда с oracle. Проконсультируйте, пожалуйста, по применимости GreenPlum для моего юзкейса:
1) основные запросы имеют 3-6 джоинов
2) джоинятся довольно большие таблицы
3) часто встречаются left/right join
4) неэквивалетные джоины
5) куча агрегатов
Насколько хорошо гринплам будет справляться с данными скриптами?
Есть ли подводные камни при переписывании скриптов с оракла под особенности сливы, да и вообще насколько это трудозатратный процесс?
от конфига нод зависит, в целом ничего страшного не перечислено.
что такое парсеры sql? что они парсят и с какой целью?
парсят сам sql запрос на прдемет имени таблицы например, и для других целей в том числе
Подскажите, есть ли простой способ посчитать распределение записей по партициям? Что-то типа gp_segment_id, только для партиций?
select format('select ''%s'', count(*) from %s union all', relname) from pg_class where relname ~~ 'hub_transaction%'
Только последний union all убрать
Подскажите пожалуйста может кто знает, в PG 9 есть pg_event_trigger_ddl_commands и pg_event_trigger_dropped_objects. В GP только pg_event_trigger_dropped_objects. pg_event_trigger_ddl_commands нужно устанавливать отдельно или с ней какие то проблемы?
Это функционал заехал в 9.5. gpdb 6 базируется на 9.4
Коллеги, подскажите пожалуйста, что это за варнинг и как с ним бороться? С ходу не нашёл решения
у вас два зеркала стали праймари, потому что в какой-то момент праймари упали
Если сейчас ничего не лежит, то нужно сделать ребаланс, чтоб исходные роли вернулись
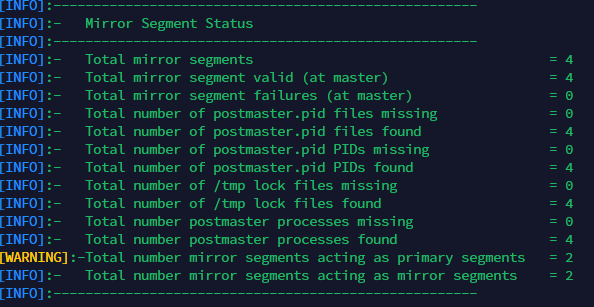
кто-нибудь заводил гринплам на Debian 11 ?
Теоретически возможно, но в случае с GP от ArenaData сейчас возможности нету.
какие ОС зарегламентированы под 7 грин Greenlum?
https://docs.vmware.com/en/VMware-Greenplum/7/greenplum-database/install...
Operating Systems
Greenplum Database 7 runs on the following operating system platforms:
Red Hat Enterprise Linux 64-bit 8.7 or later
Oracle Linux 64-bit 8.7 or later, using the Red Hat Compatible Kernel (RHCK)
Rocky Linux 8.7 or later
только начинаю учится green plum поделитесь пожалуйста ресурсом с установкой на двух серверах, буду благораден
Ничем не отличается от установки на многих
при интеграции со сторонними инструментами, вообще есть такое явление как порты у gpfdist?
На каком порту запустите, на таком и будет работать. Всё просто. Как веб сервер. А сколько вы на этот порт загоните потоков - уже ваше дело.
Есть одно но: утилизировать 1 процесс может не более 1ядра
как вытащить schema name из pg_proc ?
select * from pg_proc p
inner join pg_namespace n on p.pronamespace=n.oid
если вдруг нужен ещё владелец и атрибуты, то это делается так:
select n.nspname,
p.proname,
pg_get_userbyid(p.proowner) as proowner, pg_get_function_identity_arguments(p.oid) as function_arguments
from pg_proc p
join pg_namespace n on n.oid = p.pronamespace
where n.nspname = 'yourschemaname'
А как-то можно посмотреть очередь запросов на выполнение в ресурсную группу?
В pg_stat_activity
По времени запуска запроса
Помогите пожалуйста разобраться: у меня есть 2 таблицы с полем file_id. Можно ли как-то это поле сделать ключом дистрибуции, чтобы строки с одним и тем же file_id были на одном сегменте для обеих таблиц? Или это поведение по умолчанию?
Именно так и работает.
важна ли ос при установке gp на adcm ?)
Centos/RHEL
А есть где-нибудь репозиторий с docker-compose файлом для разворачивания ADB из нескольких нод? Или ванильного greenplum, например. https://www.programmersought.com/article/86743619511/ . Думаю, для ADB можно по аналогии поднять несколько одинаковых сегмент-серверов и мастер-сервер, затем с помощью ADCM установить все
Подскажите пожалуйста, что обычно делается при: Out of memory (... VM Protect failed to allocate 32944 bytes, 0 MB available
Падает процесс
А после этого начинают управлять ресурсами на запрос. Проверяют перекосы,наличие статистики. Корректировать ресурсные группы.
Очень часто причина - неактуальная статистика по таблице. Выполните ANALYZE
Подскажите пожалуйста, как мне выкрутить memory_spill_ratio для группы или иные параметры, чтобы заставить запрос писать в диск и не падать?
Canceling query because of high VMEM usage. current group id is 6438, group memory usage 856 MB, group shared memory quota is 438 MB, slot memory quota is 40 MB, global freechunks memory is 40
MB, global safe memory threshold is 40 MB
Поставь memory_spill_ratio 5-10%. Он считается от объёма гарантированной памяти на запрос в рг. Если поставить 0 то будет от параметра сервера браться
Кто как в автотестах на Python эмулирует Greenplum? Через мок psycopg2 ?
Проще эмулировать PostgreSQL, просто взять именно целевую версию. В GP5 это 8.3, в GP6 это 9.
Поделитесь, кто чем визуализирует планы из GP Что бы приятнее было его анализировать, а не ползать глазами по текстовому представлению. У меня глаза болят от такого занятия
Greenplum Command Center, Еще есть explain.dalibo.com - красивая отрисовка планов Postgres https://explain.tensor.ru/
Здравствуйте, у меня вопрос по HLL: я правильно понял, что при использовании этого модуля результат может иметь погрешность в отличие от обычного COUNT DISTINCT
Есть несколько преимуществ:
1. не требуется редистрибуция
2. можно хранить предагрегаты, а потом доагрегировать.
3. соответственно быстрее
Например, если вы хотите храните так количество уникальных пользователей за день, то для расчета уникальных за месяц можно выполнить доагрегацию
В итоге не нужно хранить самих пользователей каждый день, достаточно хранить предагрегаты.
Как я могу сказать оптимизатору, чтобы он делал redistribute вместо broadcast? У нас 80 логических сегментов и броадкаст таблиц становиться больной историей в некоторых кейсах
gp_segments_for_planner не помог
GPORCA
Кто-нибудь знает хорошо про gp_toolkit.gp_bloat_diag? Делаю vacuum_full таблицы, она оттуда пропадает. Собираю статистику - возвращается с примерно теми же показателями, что и до вакуума.
Алгоритм такой:
1) Открываете код этой вью
2) Под капотом ещё одна вью
3) Анализируете вью и понимаете, что берется отношение фактических занятых страниц к прогнозному. И то и то считается по статистике(+/- деталей не помню)
В вашем случаи надо сравнивать базу расчета из статистики до вакуума и после.
Если видите, что база не меняется или меняется незначительно, то надо в этом разбираться.
В моем случаи оказалось, так как таблица маленькая, статистика факту не соответствовала. Как только таблица стала достаточно большой (700 мб), статистика собралась корректно и проведение bloat_diag стало объяснимым.
Подскажите, плз, существует ли эффективное решение, позволяющее автоматизировать миграцию хранилища с Oracle на Greenplum? Вроде как продукты от Диасофт и Ispirer это умеют, но при ближайшем рассмотрении там все не так радужно…
Автоматизации по полному переводу PSQL на PgSQL нет. Поэтому с хранимками отдельная чехарда. Плюс не факт, что после переноса 1 к 1 вы получите хороший результат, так как подходы к работе с СУБД отличаются
Можно ли куда то сохранить в грин Greenlum креды для подключения через dblink ?
через fdw. если подключение к gp - сервер postgres_fdw и мэппинг пользователя
Подскажите пожалуйста, как можно облегчить запрос в GP?
У меня в условии where есть строчка, где через not in перечисляются более 10 значений из словаря.
Вот что можно сделать, чтобы снизить нагрузку для выполнения запроса?
используй not exists
Есть ли какой-то гайд по установке Greenplum на Windows? Да, в плане виртуалки и хотел узнать
Достаточно ли будет просто консоли Ubuntu LTS или нужно прямо виртаулку с рабочим пространством собирать?
Сначала нужно поставить вируталку с linux.
Я еще не разу не видел, что бы собирали бинарники под windows У встроенной ubuntu много ограничение. Например, что бы вывести порт наружу, это целая пляска с бубном.
Гораздо проще поднять отдельную виртуалку. гайд https://greenplum.org/install-greenplum-oss-on-ubuntu/
https://greenplum.org/install-greenplum-oss-on-ubuntu/
стоит задача миграции с MS SQL на Greenplum. Пользуетесь ли вы какими-то конвертерами схемы и что можете посоветовать?
Написать схему с нуля, иначе вы будете пользоваться не GP, а допотопным девятым PG
Скажите пожалуйста, как сделать vacuum по всем таблицам в схеме? Написать в процедуре нельзя. Может вызывать sql из питона, сгенерировав запросы под все таблицы в схеме? https://stackoverflow.com/questions/29710618/vacuum-analyze-all-tables-in-a-schema-postgres
Почему в партицированных таблицах не обновляется статистика? Т.е. поле n_dead_tup всегда = 0 (pg_stat_all_tables)
select * from gp_toolkit.__gp_aovisimap_compaction_info('test_ao.ao_table_test'::regclass);
Уважаемые специалисты, подскажите плиз, мы можем как-то подключиться не к мастеру а к конкретной ноде через psql ?
Нам это понадобилось для снятия метрик с каждой ноды для прометея
Можно в utility mode
Подскажите, пожалуйста, есть ли какие-нибудь варианты для сжатия таблиц?
подскажите пожалуйста ставил gp на 2 cpu 4 ram, щас добавили сделали 16 ram и 8 cpu нужно ли менять какие то конфигурации? Устанавливал ваниль VMware
Для утилизации ресурсов и производительности || операций. Обычно ставят кол-во ЦПУ/2 сегментов на сервер.
сделал set work_mem = value и получил ответ от сервера work_mem: setting is deprecated, and may be removed in a future release. Значит ли это что настройка work_mem ни на что не влияет?
gp_resqueue_memory_policy=manual means using parameter work_mem per operator node (this is obsolete, left for compatibility only)
Pivotal Greenplum Memory Configuration
Не подскажете, в gp_workfile_entries логируется тольок сам SQL запрос, или его подзапросы тоже в рамках той же сессии ?
Текущий выполняемый запрос.
Есть небольшой инстанс Greenplum 3 ноды с мастером, по 4 процессора каждая. Есть запрос который работает без нагрузки за 30-32 секунды и около 2 минут, под нагрузкой (типа нагрузочного тестирования).
Так как на сегментах 4 + 4 ядра запустил 7 параллельных процессов (как я понял по 1 ядру на процессор с небольшим запасом, может надо было 6?). Вижу потребление cpu почти 100% (99.64), а ram используется около 1 GB.
По параметрам: statement_mem: 768MB, max_statement_mem: 2000MB, gp_vmem_protect_limit: 13824MB
Можно ли как-то настроить параметры, чтобы больше расходовалась память?
Что можно предметно почитать?
Ресурсные группы
Mem и spill ratio https://s3.amazonaws.com/greenplum.org/wp-content/uploads/2022/08/09154511/PracticalGuidetoGreenplumDatabaseResourceGroups-v1.pdf
Порекомендуйте любые ресурсы для знакомства с грин Greenlum.
Документация vmware. Бесплатные курсы https://datafinder.ru/products/uchebnyy-kurs-po-greenplum , Курс BI Consult https://education.biconsult.ru/courses/559/.
Что корректно использовать вместо merge ... using query
http://web.archive.org/web/20160909164831/http://www.pivotalguru.com/?p=104
Задача такая. Выгрузить все логи в сторонний логгер (Vector), чтобы их там анализировать. Логгер умеет читать логи только построчно. Когда встречает символ переноса - перескакивает на следующую строку и уже её записывает. Так происходит с логом GP, который имеет в своем составе запросы, к примеру.
Вырезайте sed'ом переносы для запросов либо напрямую в текстовых логах, либо вытягивать селектом с regexp_replace и пихать результат в файл.
Второе кстати ещё надо проверить, не уверен, что селект будет в одну строку - одну запись вытягивать.
Со вторым посложнее, там оконные функции надо использовать - всё-таки запросы тоже по строчкам разбиваются.
Если вдруг кто-то может подсказать как завести ADB на RedOS 7.3, буду благодарен безмерно. Пока уперся в желание ADB увидеть библиотеку libperl.so и libgdbm.so.4.
Если проходили это уже - подскажите как поставить зависимости и не сломать систему при этом.
А оно и не работает на ней, на альте только
Как должен выглядеть файл pg_hba.conf на тестовом сервере (один хост) для user-а gpadmin, может есть у кого пример?
В итоге помогла только перезагрузка виртуальной машины, наверное, лаг был
Подскажите, сколько допустимое время рассинхронизация между сегментами по системному времени? Периодически возникают проблемы синхронизации между сегментами. в gp_configuration_history появляются записи: FTS: update role, status, and mode for dbid 264 with contentid 262 to p, u, and в это время тормозят запросы
во время нормальной работы - расхождение по времени от 12 до 47 сек. В проблемный момент - неизвестно
В GP не один сегмент не может отствать от мастреа (включая зеракла)
Я бы обратил внимание на: 1. состояние сети
2. колчестов странзакций на кластре
3. Состояние дисковой подсистемы. FTS probe может не проходить из-за космических await на дисках
Подскажите как решали/решаете проблему по автоматическому добавлению партиции в таблицы GP?
https://github.com/overm/greenplum_partition_actualizer/tree/main
Постигаю Greenlum, сделал успешный MVP с помощью DBT, пришла пора ехать с DEV на PROD.
Подскажите, есть ли бест-практики по размещению дев- и прод- контуров? Их следует размещать внутри одного инстанса BD Greenplum, или не возбраняется сделать отдельную БД для продакшен?
По логике хочется сделать одну прод базу, и несколько DEV - под каждого девелопера, не попаду ли на какие-нибудь грабли?
Лучше прод и дев на разном железе держать.
Подскажите пожалуйста,
строю external-таблицы над minIO с паркетом. В Location указываю имя бакета и имя партиции.
Вопрос - а можно ли как-то предварительно узнать из GP, существует ли такая партиция в бакете?
Hive metastore
В документации сказано, что при каскадном удалении схемы могут быть затронуты (удалены) объекты из других схем: С указанием CASCADE эта команда может удалить объекты не только в данной схеме, но и в других. В каком случае это произойдет? Если мы, например, селектим из вьюхи/функции объекты другой схемы они ведь вряд ли должны удаляться?
Логика обратная. Удалятся объекты, которые ссылаются на удаляемый объект. Иначе ты просто не сможешь дропнуть свой объект.
Народ, вопрос по оптимизации. Переводим процедуру с Oracle на gp.
Суть в чем.
Есть 500 лямов строк
Есть текстовое поле Col1 вида
ТекстА+Тексты+.... Поле не является индексом.
Есть условие с 15 условиями вида
Where lower(col1) like '%example1%' OR так далее 15 вариантов
В оракле запрос отрабатывает за 3 минуты..
В gp виснет все(после получаса вырубил)..
То есть gp явно агрится на
Where lower(col1) like '%example1%' OR так далее 15 вариантов
На большое количество like or
Кто нибудь может знает или сталкивался с этим проявлением ? Есть рецепты может ?
Можно попробовать переписать в один регексп через |
А кто нибудь знает у arenadata есть какой-нибудь калькулятор по железу ? Например как в yandex cloud
Только общие рекомендации. Либо, если куплен энтерпрайз с соответствующей поддержкой - можно в консалтинг обратиться.
коллеги. подскажите есть ли для GP аналог pg_bench?
ну или другой способ что бы понять почему простейшие запросы выполняются по несколько сек
TPC https://github.com/pivotal/TPC-DS
а что, execute on all segments не работает в select func(col) from конструкциях?)
Работает, но возвращает разный результат
Есть ли сейчас программа обучения, доступная для частного лица? А то и Big Data, и Arenadata требуют, чтобы договор был заключён с компанией.
есть курс на слерме, для администраторов
Коллеги, по system_history в gpperfmon можно вычислить объем IO(read/write) за квант времени, попадающий в эту статистику (15 с) ? Если нет, то как можно ?
Ответ в части read IO найден в pg_stat_database.blks_read. Для write IO пока вопрос открыт.
В greenplum нельзя создавать переменные с типом int или varchar? Например вот так я создаю в ms sql declare @my_var int
без @
Есть бест практисы по настройке планов резервного копирования gp?
Хотим по расисанию делать фул, от него дифы (инкремент не нужен) и чистить автоматом. 1)bash + cron
2)airflow
3)nifi+cron
коллеги, доблестные разработчики загнали процесс, похоже, в бесконечный цикл. из dbeaver не убивется, через psql pg_cancel и pg_terminate не убивается, kill, kill -TERM, kill -15 не помогают. Процесс на мастере. Есть еще варианты, кроме kill -9 ? GP9.4.26 adb 6.22.1
Там есть эта функция, она с 6.18 или 6.20 появилась
предварительные настройки сервера требуются? Или bundle сам всё сделает?
Для серверов БД не требуется. Для установки нужна будет машина ещё подткластер-менеджер, там надо SELinux отключить.
установил arenadatadb, ток не могу найти pg_hba чтоб разрешить все IP
Ничего не менял при установке , не подскажите где?
На мастер сегменте должен быть $MASTER_DATA_DIRECTORY/pg_hba.conf
Здравствуйте.
Подскажите, как получить список таблиц определённого типа?
AO и heap
select

n.nspname as schemaname,

c.relname as tablename,

case c.relstorage

when 'a' then ' append-optimized'

when 'c' then 'column-oriented'

when 'h' then 'heap'

when 'v' then 'virtual'

when 'x' then 'external table'

end as data storage mode

from pg_class as c

inner join pg_namespace as n

on c.relnamespace = n.oid

where

n.nspname not in ('gp_toolkit',

'information_schema',

'pg_catalog',

'pg_aoseg',

'pg_toast')

-- and c.relstorage = 'c' -- use to filter for column store tables only

order by n.nspname, c.relname ;
Дорогие и уважаемые друзья подскажите пожалуйста от чего отталкиваится при выборе количества сегментов на хостах?
в первую очередь от кол-ва ядер И предполагаемого количества одновременных запросов И ещё нужно учесть число дисковых массивов.
Но, судя по 8 ядрам, это, похоже виртуалка - и тут это не актуально.
Друзья вопрос на счет green plum command center его можно установить при том что я gp устанавливал от arenadata
Нет, по нескольким причинам. Причина первая: адб не совместим с gpcc, причина вторая: и adcc и gpcc доступны только с энтерпрайз лицензиями продуктов.
GPORKA в 7 GP осталась?
Да
Подскажите, пожалуйста, логи запросов на мастере и на сегментах дублируются? Имеет смысл искать и на мастере и на сегментах одновременно? Допустим, хочу найти все запросы DROP. Они же все равно через мастер идут и там и записываются? Чтобы найти их все нужно ли и на мастере и на сегментах искать?
На мастере лог грубо говоря, как клиенты обращаются к СУБД и работа мастера
А на сегментах логи каждого маленького постгресса, который считает свой кусочек данных, который поручил ему мастер
Нужда читать логи с сегментов бывает примерно раз в год
А какие kafka connector'ы в данный момент умеют читать avro и класть greenplum?
в авро 2 года назад уже умело
Если кто разобрался, то просветите, как интерпретировать queries_history.cpu_elapsed ? На примере 2х запросов сравниваю cpu_elapse с продолжительностью запроса tfinish - tstart и ни разу не пропорционально выходит и не похоже на доку: CPU usage by all processes across all segments executing this query (in seconds). It is the sum of the CPU usage values taken from all active primary segments in the database system.Для запроса длит-ю 5 сек cpu_elapsed = 36660, для другого 18 сек и 7003930
Один много с диска читал или блокировки ждал, а другой много вычислений делал. Как пример
А чем арена отличается от апстрима?
сертификатом минфицры
Greenlum работает в WSL2 (Linux for Windows)
Как минимум gpfdist и gpload заработает
Они самодостаточны. Wsl2 должно всё заводится что работает на одноймашине линукс. Это не предыдущий wsl с иммитацией.
Могут быть проблемы с сетевой связностью. Но это настройками лечится
UBUNTU просит ввести имя и пароль, но при вводе окно сразу исчезает https://github.com/microsoft/WSL/issues/8849
Обнаружил феномен в GP - баг или нет ? Запрос к вью возвращает неупорядоченный набор по 2й колонке - есть идеи почему ?
Гарантируется упорядочивание только финального селекта с помощью order by. Все остальные оптимизатор волен сокращать, если они не влияют на логику. В оракле можно было включать/выключать такое поведение. Здесь, вероятно, неотключаемое.
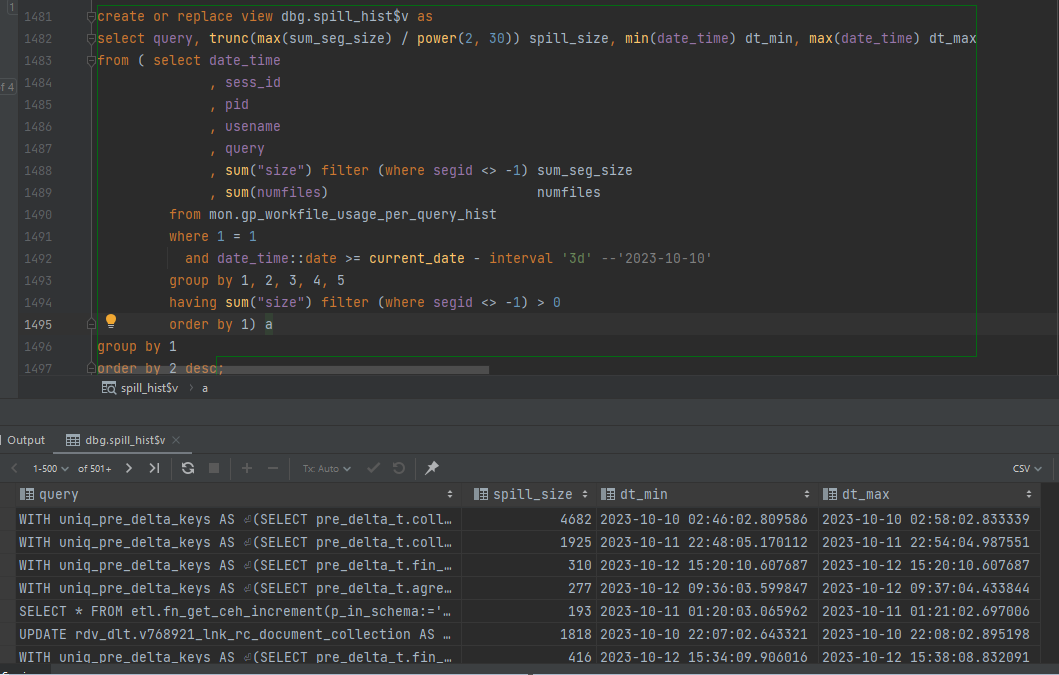
Здравствуйте! Не подскажите как исправить >>>>> [WARNING]:-Total number mirror segments acting as primary segments = 8
Gprecoverseg гуглите, у вас мастера упали и зеркала теперь вместо них
Запустите gprecoverseg с опцией -r, чтобы вернуть сегментам их предпочтительные роли.
$gprecoverseg -r
Это если мастера поднялись
Кто-нибудь знает где хранятся wal-журналы? Имею ввиду путь
pg_xlog


