

Гигиена данных: качество, валидаторы, тесты и lineage
Гигиена данных — это фундамент любого проекта машинного обучения и продвинутой аналитики. Без понимания того, что именно зашло в ваш набор признаков, какие параллельные источники данных были применены, и каким образом изменяется качество данных во времени, ваши модели рискуют деградировать или давать неверные выводы. В этом разделе мы сосредоточимся на четырех взаимосвязанных аспектах:
- качество данных (data quality): точность, полнота, консистентность, своевременность и валидность;
- валидаторы и тесты данных: инструменты и методики проверки соответствия данных заданным контрактам;
- lineage и датаконтракты: прослеживаемость происхождения данных и соглашения о формате и содержимом;
- реализация в Lakehouse: как эти практики работают в рамках современных архитектур на базе Data Lake + Data Warehouse, включая открытые решения и отечественные инструменты.
Мы не ограничиваемся теорией: приведены практические примеры, кодовые фрагменты, конфигурации и пошаговые инструкции по внедрению валидаторов, тестов и метрик качества в ваш пайплайн. Также обсуждаются риски и ограничения внедрения, чтобы вы могли планировать работу с учётом реальных условий эксплуатации.
Что такое гигиена данных?
Гигиена данных — совокупность практик, методологий и инструментов, направленных на обеспечение того, что данные, используемые в аналитике и моделировании, соответствуют заранее установленным контрактам по качеству и формату. Основные понятия:
- Data Quality (качество данных): совокупность качественных характеристик данных, включая точность (accuracy), полноту (completeness), непротиворечивость (consistency), своевременность (timeliness), валидность (validity) и уникальность (uniqueness).
- Data Validation (валидация данных): процесс проверки данных на соответствие заданным контрактам, порогам и бизнес-правилам.
- Data Quality Gates (ворота качества): пороговые проверки, которые данные должны пройти перед загрузкой в хранилище признаков или перед использованием в моделях.
- Data Lineage (линейность данных): прослеживаемость происхождения данных от источников до целевых потребителей (моделей, дашбордов). Включает зависимости, форматы, трансформации и версии.
- Data Contracts (контракты данных): формализованные соглашения о структуре и содержимом данных между поставщиками данных и потребителями (например, таблица признаков должна иметь столбцы A, B, C с типами и ограничениями).
Ключевые характеристики качества и как их измерять
- Точность (Accuracy): соответствие значения истинной величине или ожидаемому диапазону.
- Полнота (Completeness): доля отсутствующих значений. Низкая полнота часто указывает на пропуски в источниках или плохие трансформации.
- Консистентность (Consistency): отсутствие противоречий между связанными наборами данных (например, между признаками и целями, между временными отметками в разных источниках).
- Валидность (Validity): соблюдение форматов и бизнес-правил (например, диапазоны значений, допустимые категории, уникальные ключи).
- Свежесть/Своевремененность (Timeliness): насколько данные опозданы во времени по отношению к бизнес-событиям.
- Уникальность (Uniqueness): отсутствие дубликатов ключевых записей.
Контракты данных и схемы в Lakehouse
- Data contracts позволяют бизнес-аналитикам и data scientists формализовать ожидания по данным. Контракты отражаются в схемах, типах, ограничениях и бизнес-правилах.
- Эволюция схем: как управлять изменениями схем без разрушения существующих потребителей. В Lakehouse это часто достигается через schema registry, эволюцию типов и версии ATLs (Architectural Treatment Layers).
- Валидация на момент загрузки (inbound validation) и на этапе подготовки к обучению (feature validation) — два разных аспекта, которые помогают предотвратить «мёртвые» признаки в обучении.
Валидаторы и тесты: уровни и подходы
Основные уровни:
- Низкоуровневые проверки форматов и типов (schema validation).
- Проверки содержимого (business rules): диапазоны значений, допустимые категории, уникальные ключи.
- Проверки качества на уровне контрактов признаков (feature contracts) для наборов признаков в Feature Store.
- Интеграционные тесты между источниками и целевыми системами.
Подходы:
- Data-first validation: валидируем данные на источниках и в слое ingestion.
- Model-first validation: валидируем признаки перед использованием в обучении и проде.
- Continuous validation: автоматические проверки с CI/CD и ежедневными/пакетными прогоном по расписанию.
- Contract testing: тесты контрактов между поставщиками данных и потребителями.
Инструменты и подходы к lineage и тестированию
- OpenLineage, Marquez: открытые протоколы/инструменты для сбора метаданных, lineage и статусов задач.
- Great Expectations: мощная платформа для описания ожиданий (expectations) к данным, поддержки пайплайнов на Python и интеграций с Spark, Pandas, Snowflake и др.
- Deequ (AWS строит на вершине Apache Spark): декларативные Checks для размещения на больших дата-пайплайнах.
- dbt: тестирование моделей SQL и проверка результатов на уровне дата-моделей, включая тесты уникальности, не-null и ссылочные ограничения.
- SQL-гейты и проверки на уровне базы данных: простые SELECT-запросы для проверки условий.
Практические примеры
Ниже представлены примеры практических реализаций валидаторов, тестов и lineage на реальных сценариях Lakehouse-архитектур. В раздел включены open-source инструменты и отечественные контексты (на русском сообществе и характерными реалиями).
Пример 1: Валидаторы данных с Great Expectations (open-source)
Цель: проверить набор признаков перед записью в Lakehouse (Parquet/Delta/Iceberg) и перед использованием в модели.
Архитектура: источники данных -> ingestion -> feature_store/parquet -> validation -> срабатывание опыта (alerts, пропуск данных) -> продакшн.
Конфигурация и пример кода (упрощённый):
# requirements: great_expectations
import pandas as pd
import great_expectations as ge

# загрузка данных (пример упрощённый)
df = pd.read_parquet("/lakehouse/feature_store/features.parquet")

# создаём набор ожиданий
suite = {
  "expectation_suite_name": "features_suite",
  "expectations": [
    {"expectation_type": "expect_column_values_to_not_be_null",
     "kwargs": {"column": "feature_id"}},
    {"expectation_type": "expect_column_values_to_be_of_type",
     "kwargs": {"column": "feature_value", "type_": "float64"}},
    {"expectation_type": "expect_column_values_to_be_in_set",
     "kwargs": {"column": "source_system",
                "value_set": ["source_a", "source_b", "source_c"]}},
    {"expectation_type": "expect_column_min_to_be_greater_than",
     "kwargs": {"column": "timestamp", "min_value": "2020-01-01"}}
  ]
}

# создаём контекст GE и выполняем валидацию
context = ge.get_context()
batch = ge.read_parquet("/lakehouse/feature_store/features.parquet")
validator = context.get_validator(batch.batch_id, suite)
results = validator.validate()

print(results["success"])
Что видно на практике:
- Возможность задавать ожидания по столбцам (null, типы, значения в списке, диапазоны).
- Валидация может быть выполнена как часть конвейера ingestion, так и перед обучением модели.
- Результаты ведутся в журнал, можно автоматически инициировать алерты в Slack/Email и блокировать публикацию данных, если качество не удовлетворяет контрактам.
Ключевые принципы внедрения GE:
- Разделение контрактов по слоям: сырые данные vs. преобразованные признаки.
- Создание повторно используемых suites для одинаковых источников.
- Интеграция с оркестраторами (Airflow, Dagster, Prefect) для автоматических прогонов.
Пример 2: Валидаторы и тесты SQL с dbt (open-source)
dbt удобен для тестирования моделей на уровне SQL. Ниже пример YAML-настройки тестов для модели, которая создаёт набор признаков.
dbt_project.yml (упрощённо)
name: my_kaggle_like_project
version: 1.0.0
config-version: 2

profile: default
models/ features/ schema.yml features.sql
models/features/schema.yml
version: 2
models:
  - name: features
    columns:
      - name: feature_id
        tests:
          - not_null
          - unique
      - name: feature_value
        tests:
          - not_null
          - relationships:
              to: ref('target')
              field: target_id
Команды dbt:
- dbt run — собрать модели и сохранить результаты;
- dbt test — прогнать тесты на соответствие контрактам;
- dbt source freshness — проверить свежесть источников.
Преимущества dbt:
- Простая интеграция в пайплайн;
- Удобные тесты “на уровне SQL”;
- Легко описывать зависимости между моделями и обеспечивать повторяемость.
Пример 3: Проверки качества с Deequ (Spark, open-source)
Deequ позволяет описывать Checks на основе Spark DataFrame и вычислять качество данных в рамках больших пайплайнов.
Пример на Scala:
import org.apache.spark.sql.SparkSession
import com.amazon.deequ.checks.Check
import com.amazon.deequ.verification.{VerificationResult, VerificationSuite}

val spark = SparkSession.builder()
  .appName("FeatureQualityCheck")
  .getOrCreate()

val df = spark.read.parquet("/lakehouse/feature_store/features.parquet")

val check = Check(CheckLevel.Error, "FeatureQualityChecks")
  .hasSize(_ >= 1000)
  .isComplete("feature_id")     // не-null для feature_id
  .isNonNullable("feature_value") // аналогично
  .isNonNegative("feature_value")

val result: VerificationResult = VerificationSuite()
  .onData(df)
  .addCheck(check)
  .run()

println(result.status)
result.checkResults.foreach(println)
Применение:
- Динамическая проверка больших наборов данных на ранних стадиях пайплайна.
- Вычисление метрик качества и передачa результатов в мониторинг.
Пример 4: Data Lineage и OpenLineage
Цель: собрать и передать информацию о зависимостях между источниками, трансформациями и целевыми системами.
Python-пример (OpenLineage):
from openlineage.client import OpenLineageClient
from openlineage.client.facet import SourceCodeHook, DataSource, DataSet

client = OpenLineageClient("http://localhost:5000/api/v1/lineage")

lineage_event = {
  "eventType": "TRANSFORM",
  "eventTime": "2025-01-01T12:00:00",
  "job": {
    "name": "train_features_model",
    "type": "JOB"
  },
  "inputs": [
    {
      "namespace": "data",
      "name": "raw_features",
      "dataSet": DataSet(...),
      " facets": {
        "schema": {"fields": [{"name": "feature_id", "type": "string"}]}
      }
    }
  ],
  "outputs": [ /* outputs datasets */ ]
}

client.emit(lineage_event)
Что даёт OpenLineage:
- Возможность централизованного сбора lineage across multiple инструментов.
- Легче отслеживать версии данных и зависимости между этапами пайплайна.
В реальной практике:
- Интегрировать события lineage в Airflow, Dagster или Prefect.
- Комбинировать с метриками качества и тестами, чтобы видеть влияние изменений на downstream.
Пример 5: Локальная/SQL-гейтовость и валидаторы (Russian контекст)
- Валидация на стороне базы данных (Postgres, ClickHouse) через простые SQL-запросы или хранимые процедуры.
- Пример: проверки условий до загрузки признаков в хранилище.
SQL-проверка (PostgreSQL или аналог):
-- Проверка на пропуски и диапазон
SELECT
  SUM(CASE WHEN feature_id IS NULL THEN 1 ELSE 0 END) AS missing_ids,
  SUM(CASE WHEN feature_value < 0 THEN 1 ELSE 0 END) AS negative_values
FROM features_stage;
Типичный подход в российских проектах:
- Использование ClickHouse для аналитических проверок, хранение результатов в специальных таблицах для аудита.
- Прямые SQL-проверки в оркестраторе (Airflow/Dabster) для быстрого реагирования на проблемы.
Пример 6: Data contracts и схемы в российской практике
В качестве контракта данных часто применяют схемы для признаков: имена столбцов, типы, ограничения. Инструменты:
- Schema registry (Avro/JSON Schema) для упорядочивания контрактов.
- Использование Iceberg или Parquet с явной схемой.
В российской практике важна поддержка на русском языке и локальные настройки регулятивных требований, что приводит к внедрению локальных или гибридных решений, котрые позволяют хранить данные внутри страны и управлять доступами в соответствии с регуляторикой.
Архитектура гигиены данных в Lakehouse
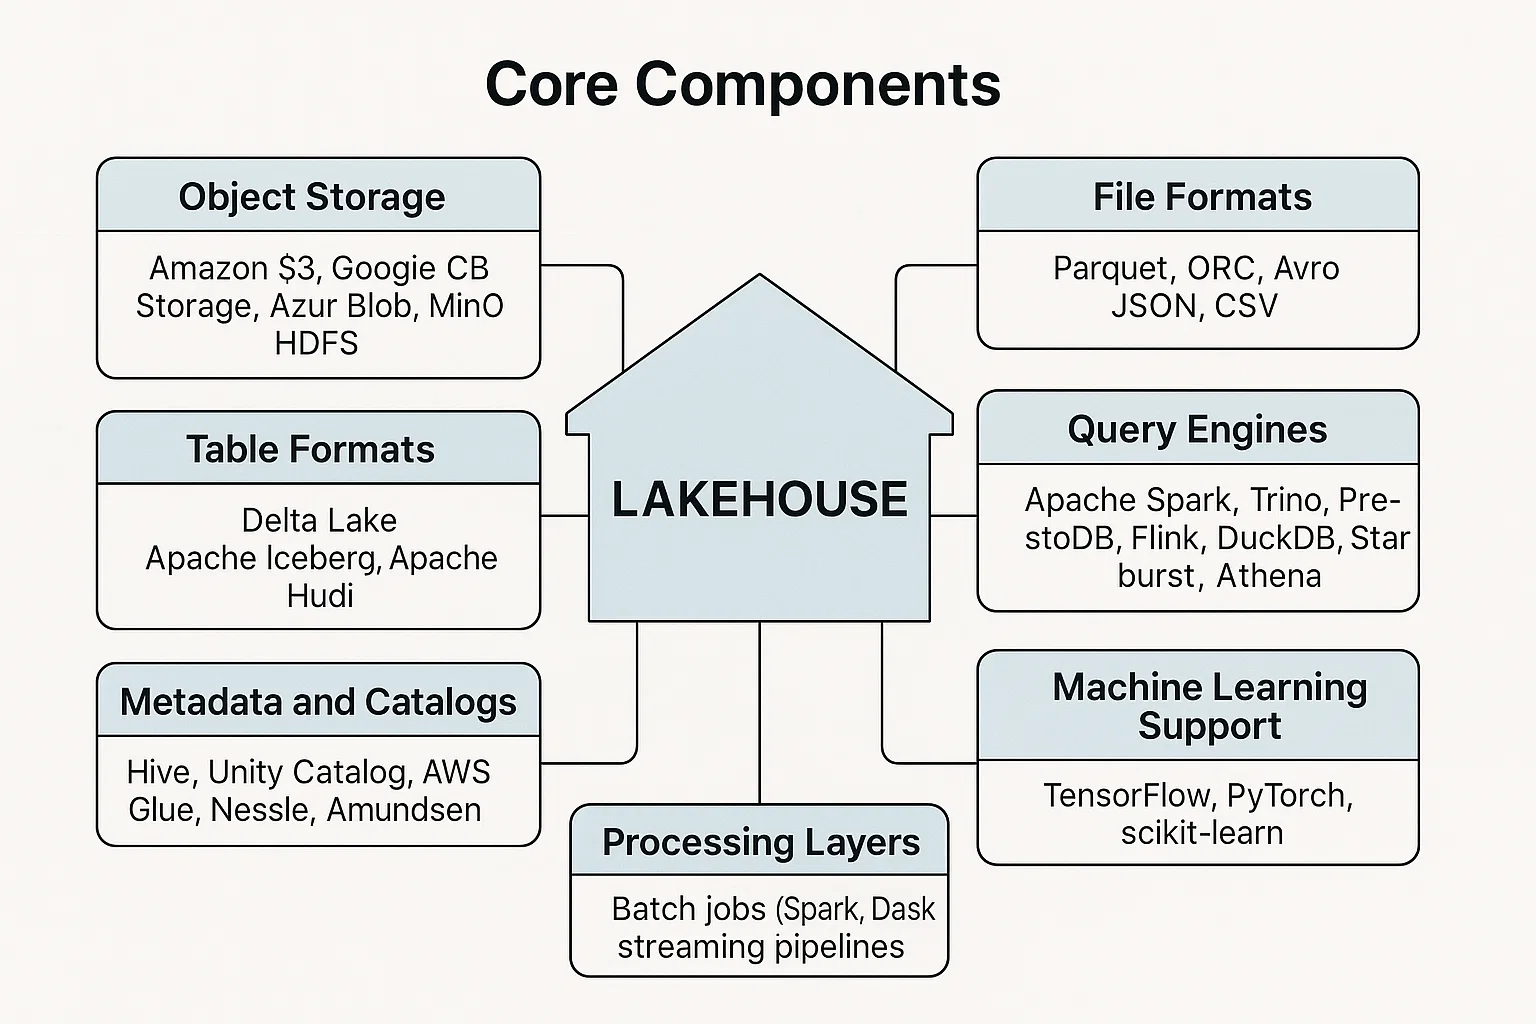
Источники данных -> Ingestion слой (ETL/ELT) -> Raw/bronze layer -> Cleansed/silver layer -> Feature Store (gold layer) -> Модели и инструменты анализа.
Валидаторы и тесты размещаются на каждом этапе:
- Ingestion validation: проверки на этапе сбора данных.
- Feature validation: проверки признаков в Feature Store.
- Model validation: проверки качества перед обучением и перед продакшеном.
Lineage и Data Catalog:
- OpenLineage / Marquez для lineage.
- Метаданные: источники, схемы, версии, зависимости, дата обновления.
Инструменты:
- Great Expectations, Deequ, dbt для тестирования и валидаторов.
- OpenLineage для lineage.
- ClickHouse, Iceberg, Delta Lake в качестве хранилищ и форматов.
- DAG/Dagster/Airflow для оркестрации.
Мониторинг качества данных:
- Пебежные алерты: Slack/Email/Teams.
- Метрики: доля ошибок, среднее время обнаружения проблемы, повторяемость контрактов.
Пример архитектурной таблицы сопоставления инструментов
| Инструмент | Тип | Основное назначение | Поддерживаемые источники | Преимущества | Ограничения |
|---|---|---|---|---|---|
| Great Expectations | Open-source | Валидаторы и suites, контракты | Pandas, Spark, SQL/BI источники | Гибкость, легко описывать контракты, интеграции | Может потребовать сложной настройки для больших пайплайнов; хранение результатов требует инфраструктуры |
| Deequ | Open-source | Checks на Spark DataFrames | Spark | Масштабируемость в больших пайплайнах | Требуется Spark; Java/Scala код |
| dbt | Open-source | Тесты моделей SQL, контракты | Любые БД/LDW через SQL | Простота внедрения в аналитические пайплайны | Ограничен SQL-тестами; контракты ограничены SQL-логикой |
| OpenLineage / Marquez | Open-source | Линейность данных и метаданные | Различные источники данных | Централизованный lineage | Требует внедрения в пайплайн; интеграции |
| ClickHouse | Open-source (русский контекст) | Быстрая аналитика, проверки через SQL | Лог, telemetry, транзакции | Высокая скорость, хороша для больших данных | Функционально ограниченность по некоторым типам валидаторов |
| Iceberg / Delta | Open-source | Форматы хранения, совместная работа | Lakehouse слои | Эволюция схем, версии | Нужны грамотные настройки и админка |
Практические детали внедрения
- Контракты данных: централизованный репозиторий контрактов для признаков (название признака, тип, допустимый диапазон, единицы измерения, описания). Контракты живут вместе с кодом пайплайна, версионируются и протестируются.
- Эволюция схем: внедрение системы миграций схем, четких правил обновления схем и совместимости (backward compatibility), чтобы потребители могли адаптироваться к изменениям без сбоев.
- Валидация на стадии обучения: обязательно наличие шага в пайплайне ML, который валидирует характеристики признаков (заносит предупреждения и блокирует обучение при нарушениях).
- Метрики качества: мониторинг по ключевым метрикам качества данных и пропуск товара в случае снижения качества.
- Документация: обеспечение доступной документации по контрактам и lineage для аналитиков и data scientists, чтобы они понимали, какие данные и в каком виде приходят в модель.
Риски и ограничения внедрения
- Рост объёма и сложности контрактов: слишком детальные контракты могут привести к «contract debt», трудностям в поддержке и частым обновлениям. Рекомендуется начинать с минимально необходимого набора контрактов и постепенно расширять.
- Задержки в пайплайне: валидаторы, особенно в больших данных, могут замедлить конвейер. Решение — параллельные проверки и выборочные валидаторы, а также агрессивное кэширование метаданных.
- Непредвиденные изменения источников: частые изменения форматов данных или бизнес-правил требуют гибкого процесса версионирования контрактов и схем.
- Регуляторные и локальные требования: в российском контексте важна локализация данных, хранение внутри страны, контроль доступа и аудитируемость, что может ограничивать возможности облачных сервисов за пределами страны.
- Совместимость инструментов: разные инструменты могут использовать разные типы контрактов и форматов данных; требуется унифицировать контракт на уровне проекта.
- Обучение персонала: для эффективной эксплуатации валидаторов и lineage необходимы компетенции в области Data Quality, SQL, Python/Scala и orchestration tools.
Выводы
Гигиена данных — не «красивый дополнение» к Lakehouse, а его двигатель надёжности и предсказуемости. Инструменты валидаторов, тестов и lineage позволяют:
- обеспечить единый контракт по данным на всем пути — от источника до модели;
- автоматизировать обнаружение отклонений и предотвратить попадание плохих данных в обучающие наборы и продакшен;
- обеспечить прозрачность и управляемость данных благодаря lineage и метаданным;
- ускорить исследования, тестирование гипотез и совершенствование признаков за счёт повторного использования контрактов и тестов;
- снизить риск регуляторных несоответствий через документирование и аудит данных.
Для практической реализации важно держать баланс между строгими контрактами и гибкостью развития пайплайна, учитывать локальные регуляторные требования и выбирать набор инструментов под конкретную технологическую стековую рамку вашей организации.
FAQ (Вопрос–Ответ)
1. В чем разница между валидаторами и тестами данных?
- Валидаторы — инструменты, которые проверяют соответствие данных контрактам и бизнес-правилам на этапе передачи или обработки. Тесты — набор предопределённых сценариев, которые проверяют конкретные ожидания в моделях и трансформациях. Валидаторы чаще работают в реальном времени/перед публикацией, тесты — в рамках CI/CD и развёртываний.
2. Зачем нужен lineage в Lakehouse?
- lineage обеспечивает прослеживаемость происхождения и зависимостей данных, позволяет понять, как и откуда пришёл признак, какие ресурсы и трансформации повлияли на его формирование. Это критично для аудита, регуляторики и репродуцируемости экспериментов.
3. Какие инструменты лучше выбирать для валидаторов в открытом сообществе?
- Great Expectations и Deequ — ведущие open-source инструменты, поддерживающие множество источников данных и интеграции. dbt — полезен для тестирования моделей SQL. OpenLineage/Marquez — для lineage. В зависимости от вашего стека можно комбинировать эти инструменты.
4. Как внедрять гигиену данных без торможения пайплайна?
- Начинайте с минимального набора контрактов и тестов для ключевых признаков, используемых в моделях. Постепенно расширяйте coverage. Внедряйте параллельные проверки и используйте выборочные проверки для быстрого цикла разработки.
5. Какие российские особенности стоит учитывать?
- В российском контексте часто важна локализация и хранение данных в рамках страны, регуляторная аудируемость и поддержка русского языка документации. Можно применять отечественные решения и инфраструктуру (например, локальные развёртывания Lakehouse на базе Iceberg/ClickHouse) и сочетать их с open-source инструментами.
6. Какие типичные ошибки встречаются при внедрении гигиены данных?
- Недостаточная спецификация контрактов, излишняя сложность контрактов, игнорирование эволюции схемы, плохая интеграция с оркестраторами, отсутствие мониторинга и алёртов, незавершённая интеграция lineage и метаданных.
7. Как связать валидаторы с производственным обучением моделей?
- Включите процесс проверки в конвейер перед обучением: валидаторы проверяют качество признаков, а затем данные проходят в обучение. Если валидаторы находят нарушения, пайплайн останавливается и отправляет уведомления. Это обеспечивает репродуктивность моделей и уменьшение риска деградации.
8. Что ещё можно добавить в качестве примера в нашей компании?
- Добавьте кейс по существующему набору признаков, например подтвердите, что все признаки для модели требуют минимального набора контрактов (feature_id не-null, feature_value в заданном диапазоне, timestamp актуален). Затем расширяйте контракты по мере роста модели и данных.
9. Какие шаги дать новичку для быстрого старта?
- Изучить базовые концепции качества данных и lineage; освоить OpenLineage, GE/Deequ/dbt; настроить простой пайплайн в репозитории, добавить базовые валидаторы и тесты для двух ключевых признаков; внедрить мониторинг и алерты.
10. Можно ли начать с простого примера и постепенно усложнять?
- Да. Хороший старт — реализовать минимальный набор контрактов на двух признаках, затем добавить lineage, интеграцию с оркестратором и расширить набор валидаторов по мере роста пайплайна.
Если вы рассматриваете переход к архитектуре Lakehouse, мы поможем оценить текущую data-инфраструктуру, спроектировать целевую архитектуру и подготовить поэтапный план внедрения. Узнайте больше о Lakehouse.


