

Глубокое погружение в Apache Parquet: Эффективное хранение данных для аналитики
В современную цифровую эпоху объем генерируемых данных растет со скоростью света. Этот взрыв данных привел к появлению концепции «больших данных». Под большими данными понимаются чрезвычайно большие и сложные массивы данных, которые невозможно обрабатывать или анализировать с помощью традиционных инструментов и методов обработки данных.
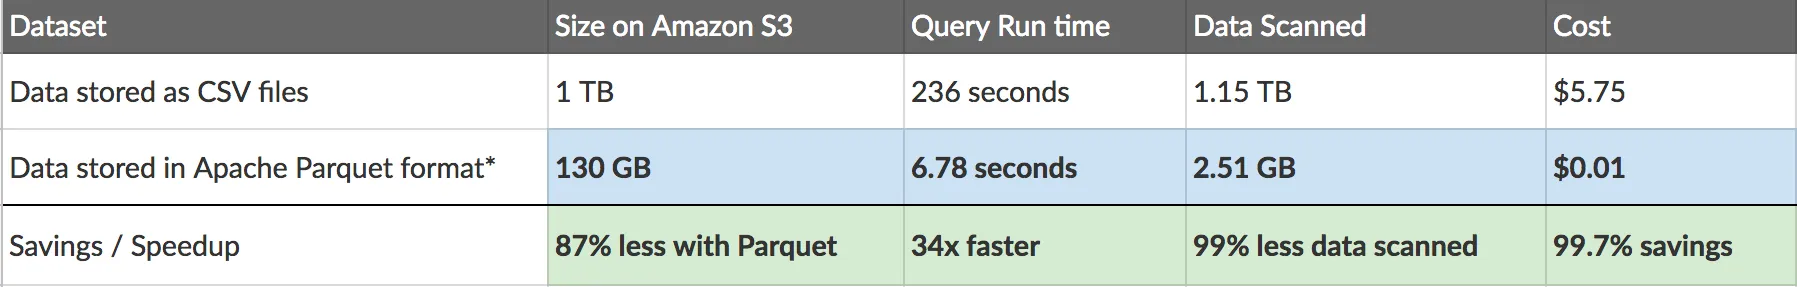
Какова производительность файла формата Parquet по сравнению с файлом CSV? Он занимает на 87 % меньше места и выполняет запросы в 34 раза быстрее (1 ТБ данных, хранилище S3)
Почему эффективное хранение и обработка данных так важны в средах Big Data
- Масштаб: Среды больших данных работают с огромными объемами данных. Традиционные методы хранения и обработки данных становятся слишком медленными и неэффективными по мере увеличения объема.
- Скорость: в сценариях с большими данными решения часто приходится принимать в режиме реального или близкого к реальному времени. Медленная обработка данных может привести к упущенным возможностям или запоздалым выводам. Эффективная обработка помогает извлечь ценность из данных именно тогда, когда это нужно.
- Стоимость: хранение и обработка больших объемов данных может быть дорогостоящей. Эффективные методы позволяют снизить затраты на оборудование, хранение и вычисления, что делает управление и анализ больших данных более целесообразным.
- Сложность: Большие данные часто неоднородны и поступают из различных источников в разных форматах. Эффективные методы обработки упрощают сложность и облегчают интеграцию, преобразование и анализ различных типов данных.
Введение в колоночное хранение
Колоночная система хранения данных - это современный подход к хранению данных, который позволяет решить многие проблемы, возникающие в средах Big Data. В отличие от традиционного хранения на основе строк, где данные для каждой строки хранятся вместе, столбцовое хранение хранит данные в столбцах. В каждом столбце хранятся значения одного атрибута для всех строк.
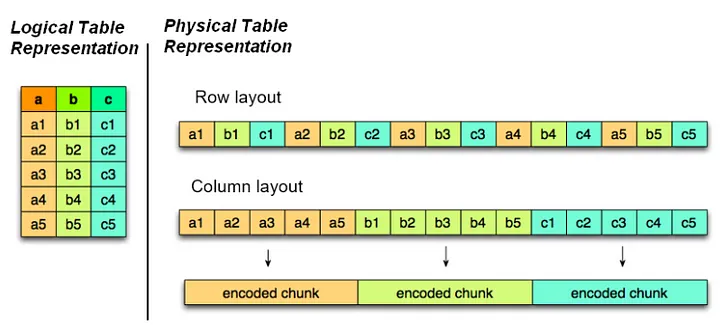
Чем колоночное хранение отличается от хранения, ориентированного на строки:
- Эффективность сжатия: Колоночное хранение позволяет использовать более эффективные методы сжатия. Поскольку значения столбцов часто имеют один и тот же тип, алгоритмы сжатия могут быть адаптированы к этому типу, что приводит к более высоким коэффициентам сжатия. Это снижает требования к хранению и ускоряет передачу данных.
- Обрезка столбцов: При выполнении запросов столбцовые базы данных могут пропускать неактуальные столбцы, что сокращает объем операций ввода-вывода и повышает производительность запросов. В хранилищах, основанных на строках, приходится считывать целые строки, даже если требуется всего несколько столбцов.
- Производительность агрегации: Колоночные хранилища высокоэффективны для агрегированных запросов, поскольку агрегирование включает операции над отдельными столбцами. Это позволяет повысить производительность запросов для аналитических задач.
- Вытеснение предикатов: Колоночные базы данных могут применять фильтры на ранних этапах выполнения запроса, анализируя метаданные, что позволяет минимизировать объем данных, считываемых из хранилища. Эта функция значительно ускоряет обработку запросов.
- Аналитика и хранилища данных: Колоночные хранилища хорошо подходят для аналитических рабочих нагрузок, создания отчетов и хранилищ данных. Оно позволяет быстро анализировать и создавать отчеты по большим наборам данных.
- Эволюция схем: Такие форматы колоночных хранилищ, как Parquet, поддерживают эволюцию схемы, позволяя добавлять новые столбцы или изменять существующие столбцы без нарушения существующих данных.

Введение в Apache Parquet
Что такое Parquet?
Apache Parquet - это формат колоночного хранения данных с открытым исходным кодом, разработанный специально для использования в средах обработки больших данных и аналитики. В отличие от традиционных форматов хранения данных, основанных на строках, таких как CSV или JSON, где каждая запись хранится в виде отдельной строки, Parquet организует данные в столбцовом формате. Это означает, что значения каждого столбца хранятся вместе в смежных областях памяти, что позволяет сжимать, кодировать и обрабатывать данные более эффективно.
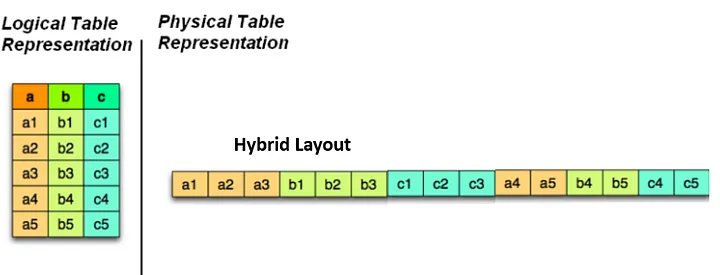
Parquet использует гибридный подход к последовательному хранению столбцов. Гибридные компоновки действительно очень эффективны, особенно для рабочих процессов OALP, поскольку они поддерживают как проекцию, так и предикаты. Проекция - это процесс выбора столбцов, а предикаты - это критерии, которые используются для выбора строк.
Базовые характеристики и преимущества Parquet
- Колоночное хранилище: Столбцовая схема хранения Parquet оптимизирована для выполнения аналитических запросов. Она минимизирует количество операций ввода-вывода, считывая только те столбцы, которые необходимы для запроса, что приводит к ускорению выполнения запросов.
- Компрессия и кодирование: Parquet использует различные алгоритмы сжатия и методы кодирования, специфичные для каждого столбца, что позволяет использовать пространство для хранения более эффективно и повышает скорость передачи данных.
- Pushdown: Возможность переноса фильтров в формат Parquet означает, что запросы могут пропускать нерелевантные данные, сокращая объем считываемых данных и повышая производительность.
- Эволюция схемы: Поддержка эволюции схемы позволяет легко адаптироваться к изменяющимся требованиям к данным без значительных усилий по их преобразованию.
- Производительность: Благодаря эффективности хранения, сжатию и возможностям вытеснения предикатов Parquet способствует повышению общей производительности аналитических рабочих нагрузок по сравнению с традиционными форматами, основанными на строках.
- Совместимость: Совместимость Parquet с различными инструментами обработки больших данных обеспечивает беспрепятственную интеграцию в существующие экосистемы обработки данных.
- Типы данных: Parquet поддерживает широкий спектр типов данных, что делает его универсальным для хранения различных наборов данных.
- Метаданные: Файлы Parquet содержат метаданные, описывающие схему и кодировку данных, что улучшает оптимизацию запросов.
Архитектура Parquet
Давайте постараемся вникнуть во все тонкости структуры файлов Parquet, организацию метаданных и страниц данных, а также разберемся в том, почему такие понятия, как кодирование словарей и вытеснение предикатов, играют важнейшую роль в оптимизации хранения данных и производительности запросов.
Структура файлов Parquet
- Файлы Parquet организованы в формате колоночного хранения, то есть вместо того, чтобы хранить данные в строках, как это делают традиционные базы данных, Parquet хранит их в колонках. Такая колоночная структура дает значительные преимущества с точки зрения сжатия и производительности запросов.
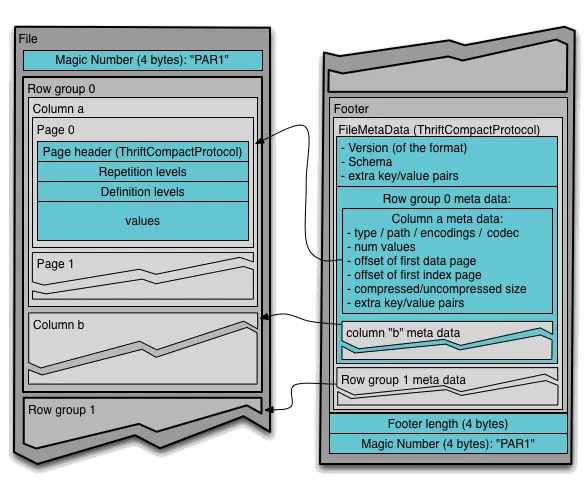
- Столбцы и группы строк: Данные в файле Parquet разделены на столбцы, а группы столбцов организованы в «группы строк». Каждая группа строк содержит раздел данных, а столбцы в группе строк хранятся вместе для оптимизации сжатия и минимизации операций ввода-вывода.
Метаданные и страницы данных
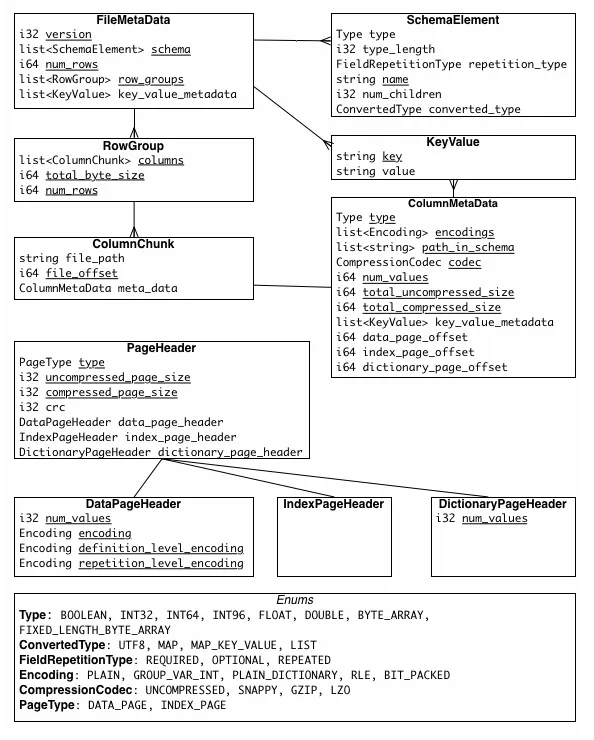
Файлы Parquet содержат метаданные, которые описывают структуру данных и позволяют эффективно их извлекать. Существует три основных типа метаданных: метаданные файла, метаданные столбцов и метаданные заголовков страниц.
- Метаданные файла: Высокоуровневая информация о файле Parquet, включая версию, схему, группы строк и нижний колонтитул, обеспечивающая эффективную навигацию по файлу и поиск данных.
- Метаданные столбцов: Информация о столбцах в группе строк, такая как кодировка, статистика, тип данных и сжатие, оптимизирующие хранение данных и производительность запросов.
- Метаданные заголовков страниц: Информация в каждой странице данных, такая как размер, ссылки на словарь, кодировка и количество значений, способствующая эффективному декодированию и обработке колоночных данных во время запросов..
Кодирование словаря
Кодирование словаря - это техника, используемая для сжатия повторяющихся или избыточных данных. В таких форматах хранения данных, как Parquet, часто существует высокая вероятность повторения данных в одном столбце. Кодирование словаря заменяет повторяющиеся значения более короткими идентификаторами (или индексами), которые ссылаются на словарь уникальных значений.
Преимущества кодирования словаря:
Эта техника значительно сокращает объем памяти, поскольку повторяющиеся данные хранятся в словаре только один раз. Она также повышает общую производительность запросов, поскольку столбцы, закодированные в словаре, могут эффективно сжиматься и разжиматься прямо во время выполнения запроса.
Predicate pushdown:
Predicate pushdown- это техника оптимизации запросов, которая фильтрует данные в источнике данных перед их чтением в память. В контексте файлов Parquet predicate pushdown подразумевает перенос условий фильтрации на уровень считывателя Parquet, что позволяет ему пропускать нерелевантные данные в процессе чтения.
Значение Predicate Pushdown: Благодаря применению условий фильтрации на ранних этапах процесса чтения в память загружаются только релевантные данные, что позволяет сократить объем передаваемых данных и повысить производительность запросов. Это особенно полезно при работе с большими наборами данных.
Создание файлов Parquet
Создание файлов Parquet - важнейший шаг в использовании преимуществ столбцового хранения для эффективной обработки данных. В этом модуле мы рассмотрим, как записывать данные в файлы Parquet с помощью Python, и изучим различные варианты конфигурации для оптимизации процесса записи.
Создание файлов Parquet на Python
Python предоставляет несколько библиотек, которые позволяют записывать данные в файлы Parquet. Одной из самых популярных библиотек является pyarrow:
pip install pyarrow
Вот простой пример того, как записать Pandas DataFrame в файл Parquet с помощью pyarrow:
import pandas as pd
import pyarrow as pa
import pyarrow.parquet as pq
# Create a sample DataFrame
data = {'Name': ['Alice', 'Bob', 'Charlie'],
        'Age': [25, 30, 28]}
df = pd.DataFrame(data) # Convert the DataFrame to an Arrow table
table = pa.Table.from_pandas(df) # Write the table to a Parquet file
pq.write_table(table, 'sample.parquet')
Возможные конфигурации для создания файлов Parquet
При записи файлов Parquet Вы можете гибко настраивать различные параметры, которые могут повлиять на размер, сжатие и производительность результирующего файла. Вот некоторые важные параметры конфигурации, которые следует учитывать:
- Сжатие: Parquet поддерживает несколько алгоритмов сжатия, таких как snappy, gzip и lz4. Вы можете выбрать алгоритм сжатия, основываясь на компромиссе между степенью сжатия и нагрузкой на процессор.
pq.write_table(table, 'sample.parquet', compression='snappy')
- Размер страницы: Параметр page_size определяет размер каждой страницы данных в файле Parquet. Большие размеры страниц могут повысить производительность чтения за счет увеличения объема памяти.
pq.write_table(table, 'sample.parquet', page_size=4096) # Specify page size in bytes
- Размер группы строк: Файлы Parquet делятся на группы строк. Вы можете контролировать количество строк в каждой группе с помощью параметра row_group_size.
pq.write_table(table, 'sample.parquet', row_group_size=100000)
- Кодирование словаря: Parquet поддерживает кодирование словарей для столбцов с повторяющимися значениями. Это позволяет значительно сократить объем памяти.
pq.write_table(table, 'sample.parquet', use_dictionary=True)
- Версия страницы данных: Вы можете указать версию страницы данных, которую следует использовать для кодирования данных. Это может повлиять на совместимость с различными программами чтения Parquet.
pq.write_table(table, 'sample.parquet', data_page_version='2.0')
Чтение файлов Parquet
Чтение данных из файлов Parquet - одна из основных задач в конвейерах обработки данных. Колоночный формат хранения Parquet разработан для повышения производительности запросов и минимизации операций ввода-вывода, что делает его предпочтительным вариантом для аналитических рабочих нагрузок.
import pyarrow.parquet as pq
import pandas as pd
# Read Parquet file
parquet_table = pq.read_table('sample.parquet')
# Convert Parquet table to DataFrame
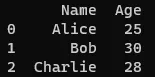
df = parquet_table.to_pandas() print(df)
Партиционирование в Parquet
Разбиение на разделы и бакеты - две мощные техники в Apache Parquet, которые могут значительно повысить производительность запросов при работе с большими массивами данных.
Разбиение на разделы
Разбиение на разделы разделение данных на подкаталоги на основе значений одного или нескольких столбцов. Каждый подкаталог представляет собой отдельное значение столбца (столбцов) разделения. Например, если у Вас есть набор данных, содержащий данные о продажах, и Вы разделили его по столбцам «год» и «месяц», Parquet создаст структуру каталогов следующего вида:
/sales/year=2023/month=01/
 /sales/year=2023/month=02/ ...
Преимущества разбиения на разделы:
- Обрезка данных: Во время выполнения запроса, если фильтры запроса включают столбцы разметки, Parquet может пропустить чтение целых каталогов, которые не соответствуют критериям фильтра, что приводит к повышению производительности запроса.
- Сокращение операций ввода-вывода: Разбиение на разделы помогает минимизировать объем данных, считываемых с диска, поскольку запросы могут быть направлены на определенные разделы.
- Упорядоченные данные: Данные становятся более упорядоченными, что упрощает управление и запросы к определенным подмножествам.
Разбиение на бакеты в Parquet
Бакетное хранение, также известное как «кластерное» или «сортированное» хранение, предполагает разделение данных на фиксированное количество бакетов на основе хэш-значения выбранного столбца. Данные внутри каждого бакета сортируются на основе значений столбца бакета. Бакетное хранение обычно используется при наличии большого набора данных и необходимости равномерно распределить данные по бакетам для сбалансированного запроса.
Преимущества бакетного хранения:
- Равномерное распределение: Bucketing обеспечивает равномерное распределение данных по бакетам, предотвращая перекос данных и появление «горячих точек» при обработке запросов.
- Оптимизация объединения: Если две таблицы объединены в бакет по одному и тому же столбцу, операция объединения становится более эффективной, поскольку данные в каждом бакете уже отсортированы.
- Предсказуемая производительность запросов: Поскольку данные уже равномерно распределены и отсортированы, производительность запросов становится более предсказуемой и стабильной.
Экономия производительности и ресурсов по сравнению с CSV, хранящимся в бакете S3
Parquet занимает на 87 % меньше места, чем CSV, а запросы выполняются в 34 раза быстрее (1 ТБ данных, хранилище S3).
Заключение
В заключение можно сказать, что Apache Parquet - это мощный колоночно-ориентированный формат хранения, обладающий многочисленными. Его эффективное сжатие, возможности predicate pushdown и поддержка эволюции схем способствуют оптимизации производительности запросов и уменьшению занимаемого пространства.
Однако, несмотря на то, что Parquet имеет преимущества в аналитических нагрузках и экосистемах Big Data, он не является универсальным решением. Как и в случае с любой другой технологией, для принятия взвешенного решения по интеграции Parquet в конвейеры данных требуется глубокое понимание его сильных и слабых сторон.


