

Мифы вокруг Parquet: что есть правда, а что – ложь?
Формат файлов по умолчанию в области Data Science
Вы когда-нибудь использовали pd.read_csv() в pandas? Так вот, эта команда могла бы выполняться в ~50 раз быстрее, если бы Вы использовали Parquet вместо CSV.
В этой статье мы расскажем об Apache Parquet, чрезвычайно эффективном формате файлов. Данный пост ориентирован на практиков в области данных (ML, DE, DS), поэтому мы сосредоточимся исключительно на высокоуровневых концепциях и использовании SQL для обсуждения основных понятий (ссылки на дополнительные ресурсы даны по ходу повествования).
Без лишних слов, к делу!
Технический TLDR
Apache Parquet - это формат файлов с открытым исходным кодом, обеспечивающий эффективное хранение и высокую скорость чтения. Он использует гибридный формат хранения, в котором последовательно хранятся куски столбцов, что обеспечивает высокую производительность при выборе и фильтрации данных. Помимо поддержки сильных алгоритмов сжатия (snappy, gzip, LZO), он также предлагает несколько умных трюков для сокращения времени сканирования файлов и кодирования повторяющихся переменных.

Если Вам нужна скорость, обратите внимание на Parquet.
Что происходит на самом деле?
Хорошо, давайте немного сбавим обороты и обсудим Parquet на понятном всем нам языке.
1 — проблема хранения данных
Допустим, мы инженеры по обработке данных и мы хотим создать архитектуру данных, которая облегчит онлайн аналитические процессы (OLAP), которые представляют собой выборочные запросы, направленные на анализ данных. Некоторые примеры функций данных, которые оптимизируются в среде OLAP, - это исследовательский анализ данных или наука о принятии решений.
Но как мы должны хранить наши данные на диске?
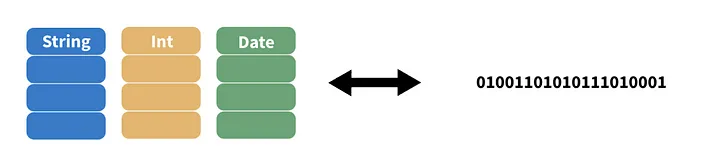
Когда мы думаем о том, хорошо или плохо наше преобразование, у нас в голове пролетает огромное количество мыслей, но в контексте рабочих процессов OLAP нас в основном интересуют следующие два соображения …
- Скорость чтения: как быстро мы можем получить доступ и декодировать необходимую нам информацию из двоичных файлов
- Размер на диске: сколько места занимает наш файл в двоичном формате
Обратите внимание, что существуют и другие показатели успешности алгоритма сжатия файлов, такие как скорость записи и поддержка метаданных, но мы пока остановимся только на двух вышеперечисленных.
Итак, как же работает Parquet по сравнению с CSV-файлом? А вот так: он занимает на 87 % меньше места и выполняет запросы в 34 раза быстрее (1 ТБ данных, хранилище S3)
2 — Ключевые характеристики Parquet
Но в чем именно Parquet эффективнее CSV и других популярных форматов файлов? Первый ответ - это схема хранения...
2.1 — схема гибридного хранения
Когда мы преобразуем двумерную таблицу в последовательность 0 и 1, мы должны тщательно продумать оптимальную структуру. Следует ли записывать первый столбец, затем второй, затем третий? Или хранить строки последовательно?
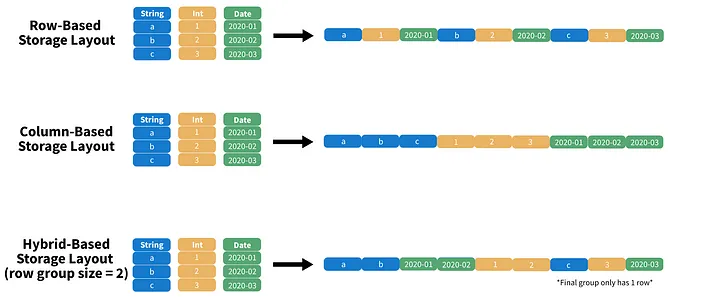
Традиционно существует три основные схемы преобразования двумерной таблицы в одномерную:
- На основе строк: последовательное хранение строк (CSV).
- На основе столбцов: последовательное хранение столбцов (ORC).
- Гибридная основа: последовательное хранение кусков столбцов (Parquet).
Графическое представление каждого из этих форматов показано на рисунке 2.
Теперь гибридные макеты действительно эффективны для рабочих процессов OLAP, поскольку они поддерживают и проекции, и предикаты.
Проекция - это процесс выбора столбцов, который можно представить себе как оператор SELECT в запросе SQL. Проекцию лучше всего поддерживает макет на основе столбцов. Например, если бы мы хотели прочитать первый столбец таблицы, используя столбцовую верстку, мы могли бы просто прочитать первые n индексов в нашем двоичном файле, десериализовать их и представить пользователю. Здорово, не правда ли?
Предикаты - это критерии, используемые для выбора строк, - их можно представить как пункт WHERE в запросе SQL. Предикаты лучше всего поддерживаются в хранилищах, основанных на строках. Если нам нужны все строки в соответствии с некоторым критерием, напримерInt >= 2, мы можем просто упорядочить нашу таблицу по Int (по убыванию), просканировать ее до тех пор, пока наш критерий не будет удовлетворен, и вернуть все строки выше этого значения.
В обоих этих сценариях мы стремимся проработать как можно меньше файлов. А поскольку в науке о данных часто требуется подмножество как строк, так и столбцов, гибридная схема хранения дает нам нечто среднее между столбцовым и строковым форматами файлов.
Прежде чем двигаться дальше, важно отметить, что Parquet часто описывается как колоночный формат. Однако из-за того, что он хранит куски столбцов, как показано в нижней части рисунка 2, более точным описанием является гибридная схема хранения.
Отлично! Значит, если нам нужно вытащить данные, мы можем просто хранить последовательные куски столбцов и, как правило, получать хорошую производительность. Но масштабируется ли этот метод?
2.2 — метаданные Parquet
Ответ - однозначное «да». Parquet использует метаданные, чтобы пропускать части данных, которые можно исключить в соответствии с нашим предикатом.
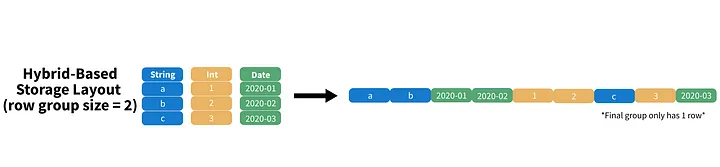
На примере таблицы на рисунке 3 мы видим, что размер группы строк равен 2, то есть мы храним 2 строки данного столбца, 2 строки следующего столбца, 2 строки третьего столбца и так далее.
Когда у нас заканчиваются столбцы, мы переходим к следующему набору строк. Обратите внимание, что в приведенной выше таблице у нас всего 3 строки, поэтому в последней группе строк будет только 1 строка.
Теперь предположим, что в группах строк хранится не 2, а 100 000 значений. Если мы хотим найти все строки, в которых столбец Int имеет заданное значение (т. е. предикат равенства), то в худшем случае придется просканировать каждую строку таблицы.
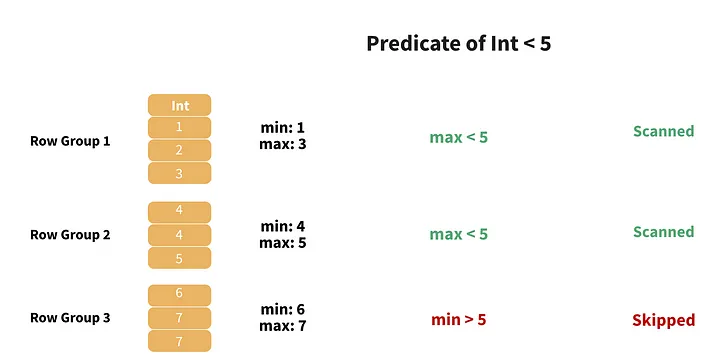
Parquet разумно решает эту проблему, сохраняя максимальные и минимальные значения для каждой группы строк, что позволяет нам пропускать целые группы строк, как показано на рисунке 4. Но это еще не все! Поскольку Parquet часто записывает множество файлов .parquet в один каталог, мы можем просмотреть метаданные столбцов для всего файла и определить, нужно ли его сканировать.
Включив дополнительные данные, мы можем пропустить целые массивы данных и значительно увеличить скорость запросов.
2.3 — структура файла Parquet
Итак, мы уже немного намекнули на то, как данные преобразуются из двухмерного формата в одномерный, но как все-таки устроена вся файловая система?
Как уже говорилось выше, за одну запись Parquet может записать много файлов .parquet. Для небольших наборов данных это является проблемой, и Вам, вероятно, следует перераспределить данные перед записью. Однако для больших наборов данных разбиение данных на несколько файлов может значительно повысить производительность.
В целом Parquet имеет следующую структуру:
Корень > файлы Parquet > группы строк > столбцы > страница данных
Во-первых, наш корень файла - это просто каталог, в котором хранится все. Внутри корня у нас есть множество отдельных файлов .parquet, каждый из которых содержит раздел наших данных. Один файл parquet состоит из множества групп строк, а одна группа строк содержит множество столбцов. Наконец, внутри наших столбцов находятся страницы данных, на которых хранятся исходные данные и некоторые необходимые метаданные.
Упрощенное представление файла .parquet показано на рисунке 4 ниже.
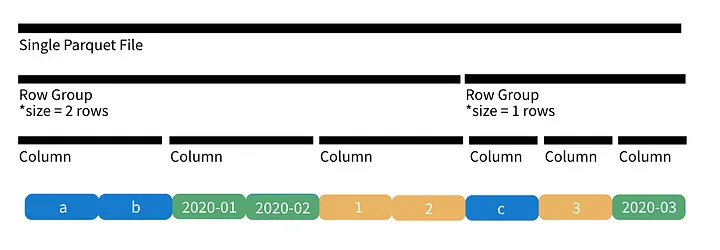
Если Вам нужна более подробная информация, тогда рекомендуем Вам изучить официальную документацию. Уровни повторения и определения также важны для полного понимания того, как работает страница данных, но это лишь некоторые бонусы.
3 — дополнительные оптимизации
С момента своего появления в 2013 году parquet стал намного умнее. Базовая структура осталась в основном неизменной по сравнению с приведенным выше форматом, но было добавлено множество интересных функций, повышающих производительность для определенных типов данных.
Давайте рассмотрим несколько примеров...
3.1 — В моих данных много дублирующихся значений!
Решение: алгоритм RLE
Допустим, у нас есть столбец с 10 000 000 значений, но все значения равны 0. Чтобы сохранить эту информацию, нам нужно всего два числа: 0 и 10 000 000 - значение и количество его повторений.
Как работает RLE: когда найдено много последовательных дубликатов, Parquet может закодировать эту информацию в виде кортежа, соответствующего значению и количеству. В нашем примере это избавит нас от необходимости хранить 9 999 998 чисел.
3.2 — я работаю с очень большими типами данных!
Решение: кодирование словаря с Bit-Packing
Допустим, у нас есть столбец, содержащий названия стран, некоторые из которых очень длинные. Если бы мы хотели хранить «Демократическая Республика Конго», нам бы понадобился строковый столбец, который может обрабатывать не менее 32 символов.
Кодировка словаря заменяет каждое значение в нашем столбце маленьким целым числом и сохраняет это соответствие в метаданных страницы данных. На диске наши закодированные значения упаковываются в биты, чтобы занимать как можно меньше места, но при чтении данных мы все равно можем преобразовать наш столбец обратно в его исходные значения.
3.3 — Я использую сложные фильтры для своих данных!
Решение: Проекция и Predicate Pushdown
В среде Spark мы можем избежать чтения всей таблицы с помощью проекции и predicate pushdown. Поскольку операции Spark оцениваются медленно, то есть они не выполняются до тех пор, пока мы не запросим данные, Spark может извлекать в память наименьшее количество данных.
Напоминаем, что предикаты подставляют строки, а проекция - столбцы. Таким образом, если мы знаем, что нам нужно только несколько столбцов и подмножество строк, нам не придется считывать всю таблицу в память - она будет отфильтрована во время чтения.
3.4 — я работаю с разными типами данных!
Решение: Deltalake
Наконец, Deltalake - это фреймворк с открытым исходным кодом, который сочетает в себе динамическую природу озера данных и структуру хранилища данных. Если Вы планируете использовать Parquet в качестве основы хранилища данных Вашей организации, дополнительные функции, такие как гарантии ACID и журналы транзакций, будут очень полезны.
Заключение
Parquet - это действительно эффективный формат файлов, который особенно хорош при минимизации сканирования таблиц, а также при сжатии данных до небольших размеров. Если Вы занимаетесь изучением данных, то Parquet должен стать для Вас самой настоящей находкой.


