

Greenplum для Data Science: Расширенный текстовый анализ и текстовый поиск на Greenplum с помощью GPText
Контекст
Greenplum минимизирует разрозненность данных, предоставляя единую, масштабируемую среду для объединения передовых аналитических и операционных рабочих нагрузок.
Сегодня мы познакомимся с расширенными возможностями Greenplum по анализу текстов для обработки и поиска большого количества текстовых данных: Greenplum Text (или GPText), который:
- Объединяет сервер баз данных Greenplum с массивно-параллельной обработкой данных и корпоративный поиск Apache SolrCloud.
- Включает в себя мощный текстовый поиск, а также поддержку текстового анализа.
- Позволяет проводить текстовый анализ для нескольких источников документов: Greenplum Text может индексировать документы, хранящиеся в таблицах Greenplum Database, или записи, полученные из внешних хранилищ, таких как HTTP или FTP-серверы, Amazon S3 или другое S3-совместимое хранилище, или Hadoop HDFS.

Обзор набора данных
Во всей этой серии статей мы использовали набор данных Daily Financial News for stocks, доступный на Kaggle под лицензией CC0: Public Domain . Мы будем использовать Greenplum и следовать циклу Data Science (исследование данных – подготовка данных – моделирование данных – оценка модели – развертывание модели) для обучения NLP-модели для анализа тональности новостей.
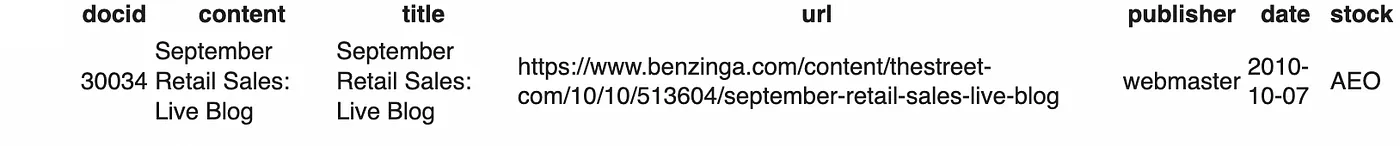
Мы очистили и предварительно обработали данные, которые затем сохранили их в таблице ds_demo.financial_news :
%%sql
SELECT * FROM ds_demo.financial_news LIMIT 1;
Итак, давайте начнем с индексирования данных и выполнения простого, а также расширенного (сложного) поиска с помощью GPText.
Индексирование GPText
GPText предоставляет возможности текстового анализа для платформы Greenplum. Он использует стандартные библиотеки Solr для анализа и индексирования текста. Все функциональные возможности открываются через SQL и могут быть объединены со всеми другими возможностями движка Greenplum.
1. Создадим пустой индекс
Во-первых, мы создадим индекс GPText для нашей таблицы с помощью функции базы данных create_index():
%%sql
SELECT * FROM gptext.create_index('ds_demo', 'financial_news', 'docid', 'content');
2. Включим таблицу терминов
Затем, чтобы выйти за рамки простого поиска по документам, мы включим и извлечем векторы терминов из поля содержания:
%%sql
SELECT gptext.enable_terms('warehouse.ds_demo.financial_news', 'content');
3. Заполним индекс
Заполним ранее созданный индекс:
%%sql
SELECT * FROM gptext.index(
    TABLE(select * from ds_demo.financial_news),
    'warehouse.ds_demo.financial_news'
);
4. Зафиксируем индекс
Выполним коммит транзакции:
%%sql
SELECT * FROM gptext.commit_index('warehouse.ds_demo.financial_news');
Теперь, когда индекс GPText заполнен и зафиксирован, мы можем искать документы в базе данных с помощью полнофункциональной поисковой системы, а не просто обычных выражений.
Опции простого поиска GPText
Для обработки поиска можно выполнять запросы с помощью функции gptext.search(), которая использует следующий синтаксис:
gptext.search(<src_table>, <index_name>, <search_query>, <filter_queries>[, <options>])
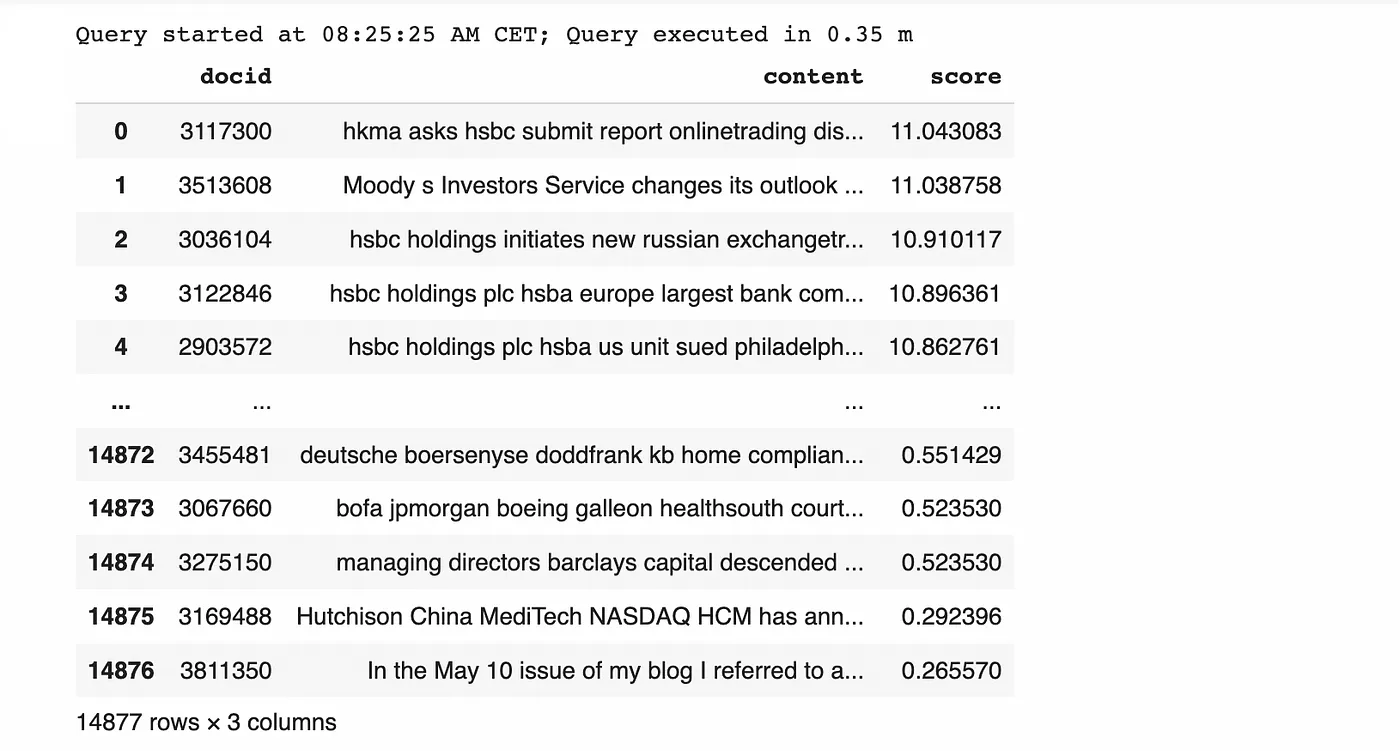
Например, попробуйте найти слово hsbcin в наборе данных:
%%read_sql search_example

SELECT t1.docid
    , t1.content
    , t2.score -- the TF-IDF score
FROM
  ds_demo.financial_news t1,
  (
    SELECT *
    FROM gptext.search(
            TABLE(SELECT * FROM ds_demo.financial_news)
            , 'warehouse.ds_demo.financial_news' -- source table
            , 'hsbc' -- index name
            , NULL -- filter queries, if none, set this parameter to NULL
        )
  ) t2
WHERE t1.docid::text = t2.id
ORDER BY score DESC
;
Или воспользуйтесь гораздо более мощной функцией GPText и извлеките векторы терминов из текстового поисковика в таблицу базы данных:
%%sql
CREATE TABLE ds_demo.stock_market_terms AS
  SELECT * FROM gptext.terms(
    TABLE( SELECT 1 SCATTER BY 1 )
    , 'warehouse.ds_demo.financial_news'
    , 'content'
    , '*:*'
    , NULL
  );
1. Используйте AND для поиска более чем одного термина
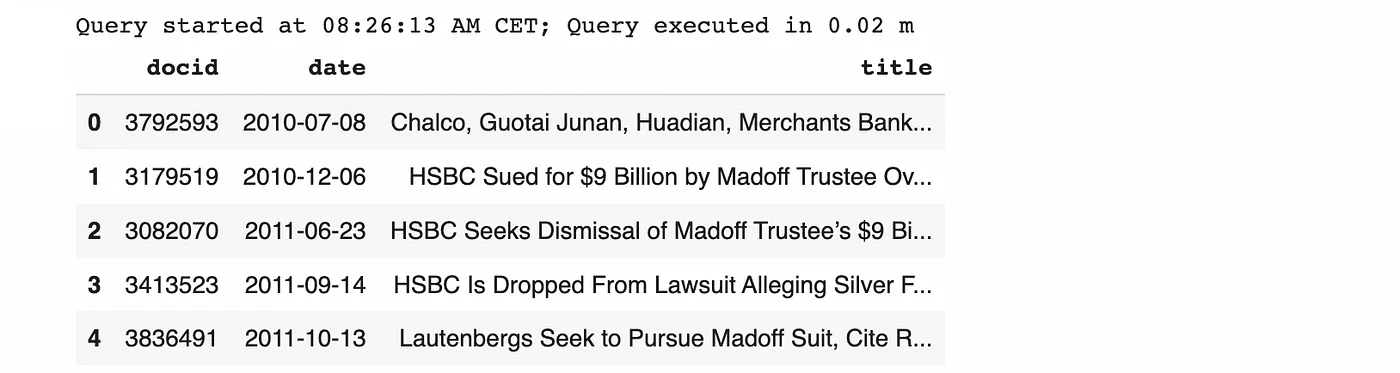
В следующем примере мы ищем в индексе theds_demo.financial_news новости, содержащие поисковые термины complaint и hsbc. Аргумент rows=5 - это опция Solr, определяющая 5 лучших результатов, которые будут возвращены из каждого сегмента. На кластере Greenplum с 24 сегментами этот запрос возвращает до 24 * 5 = 120 строк.
%%read_sql df_advanced_search
SELECT a.docid, a.date, a.title
FROM
  ds_demo.financial_news a
  , gptext.search(
      TABLE(SELECT 1 SCATTER BY 1)
      , 'warehouse.ds_demo.financial_news'
      , '"complaint" AND "hsbc"'
      , NULL
      , 'rows=5'
    ) q
WHERE q.id::text = a.docid::text
LIMIT 5;
2. Используйте OR для поиска любого из двух (или более) терминов.
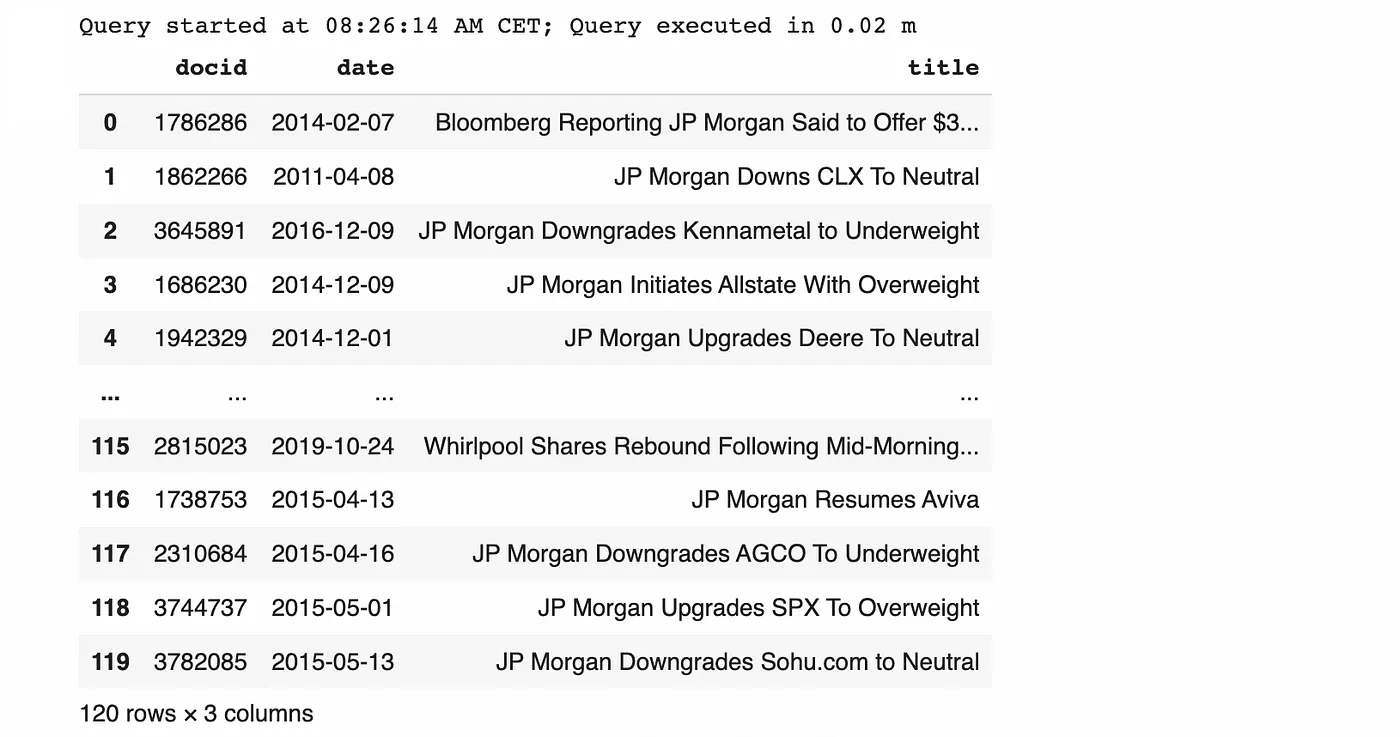
Этот поиск находит новости в индексеnds_demo.financial_news, которые содержат либо поисковый термин jp morgan, либо термин hsbc:
%%read_sql df_advanced_search
SELECT a.docid, a.date, a.title
FROM
  ds_demo.financial_news a   , gptext.search(       TABLE(SELECT 1 SCATTER BY 1)
      , 'warehouse.ds_demo.financial_news'
      , '"jp morgan" OR "hsbc"'
      , NULL, 'rows=5'
    ) q WHERE q.id::text = a.docid::text
;
3. Использование AND и OR со скобками
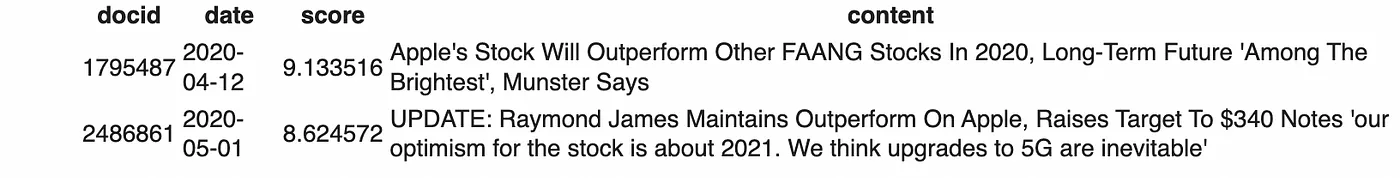
Следующий пример ищет в таблице ds_demo.financial_news новости, содержащие текст stock either outperform or bullish, и отфильтровывает акции Apple (AAPL):
%%sql
SELECT t.docid, t.date, q.score, t.content
FROM ds_demo.financial_news t,
     gptext.search(        TABLE(SELECT * FROM ds_demo.financial_news)
       , 'warehouse.ds_demo.financial_news'
       , '(stock AND (outperform OR bullish))'
       , '{stock:AAPL}', 'rows=5'
      ) q WHERE t.docid = q.id::int4
ORDER BY score DESC;
4. Использование нескольких AND со скобками
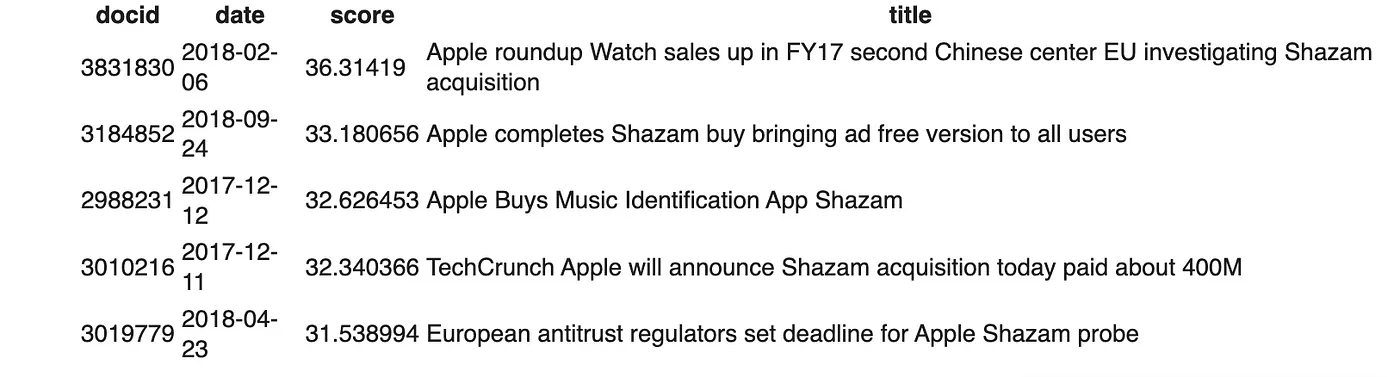
Поиск новостей, упоминающих приобретение Apple x Shazam:
%%sql
SELECT t.docid, t.date, q.score, t.title FROM ds_demo.financial_news t,      gptext.search(        TABLE(SELECT * FROM ds_demo.financial_news)        , 'warehouse.ds_demo.financial_news'
       , '((merger and acquisition) AND (apple) AND (Shazam))'
       , NULL, 'rows=5'
      ) q WHERE t.docid = q.id::int4
ORDER BY score DESC LIMIT 5;
5. Фасетный поиск по полям
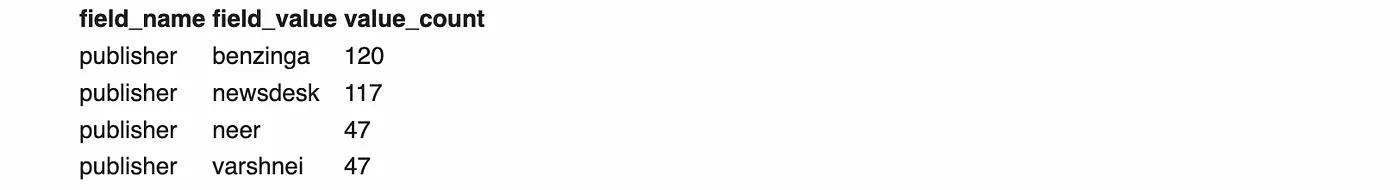
Функция фасетного поиска по полям gptext.faceted_field_search() разбивает результаты запроса на несколько категорий с подсчетом количества документов в индексе для каждой категории.
Вот пример, в котором мы подсчитываем количество новостей одного издательства, в которых AAPLstock упоминается более 40 раз:
%%sql
SELECT * FROM gptext.faceted_field_search(
    'warehouse.ds_demo.financial_news', '*:*', '{stock:AAPL}', '{publisher}', -1, 40
);
6. Выделите условия поиска
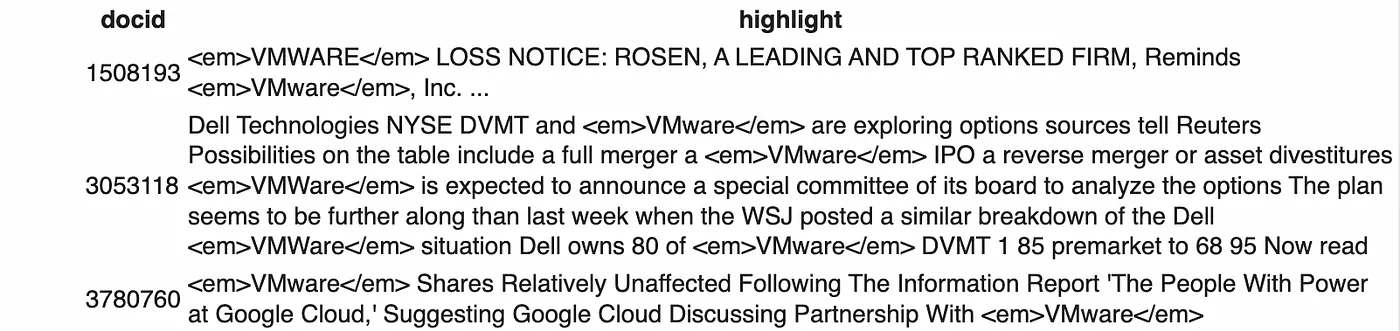
Подсветка GPText вставляет теги разметки до и после каждого ввода поисковых терминов в запрос. Например, если поисковым термином является AAPL, каждое вхождение AAPL в поле помечается как:
<em>AAPL</em>
В приведенном ниже примере функция gptext.highlight() возвращает новости с текстом vmware, выделенным в поле содержимого, по одной строке из каждого сегмента. На кластере базы данных Greenplum с 24 сегментами этот запрос возвращает до 24 строк, то есть 24 * 5 = 120 строк.
%%sql
SELECT t.docid, gptext.highlight(t.content, 'content', s.hs)
FROM ds_demo.financial_news t,
     gptext.search(        TABLE(SELECT 1 SCATTER BY 1)
       , 'warehouse.ds_demo.financial_news'
       , '{!gptextqp}vmware', NULL
       , 'rows=1&hl=true&hl.fl=content'
      ) s WHERE t.docid = s.id::int8
LIMIT 3;
7. Поиск по нестандартным полям (включение и исключение терминов)
Этот пример ищет новости, которые содержат crypto в колонке «Content», но не содержат bitcoin в колонке «Title»:
%%sql
SELECT a.docid, a.date, a.title, q.score FROM ds_demo.financial_news a,       gptext.search(         TABLE(SELECT 1 SCATTER BY 1)
        , 'warehouse.ds_demo.financial_news'
        , 'crypto and -title:bitcoin'
        , NULL, NULL       ) q  WHERE q.id::int8 = a.docid
ORDER BY score DESC LIMIT 5;
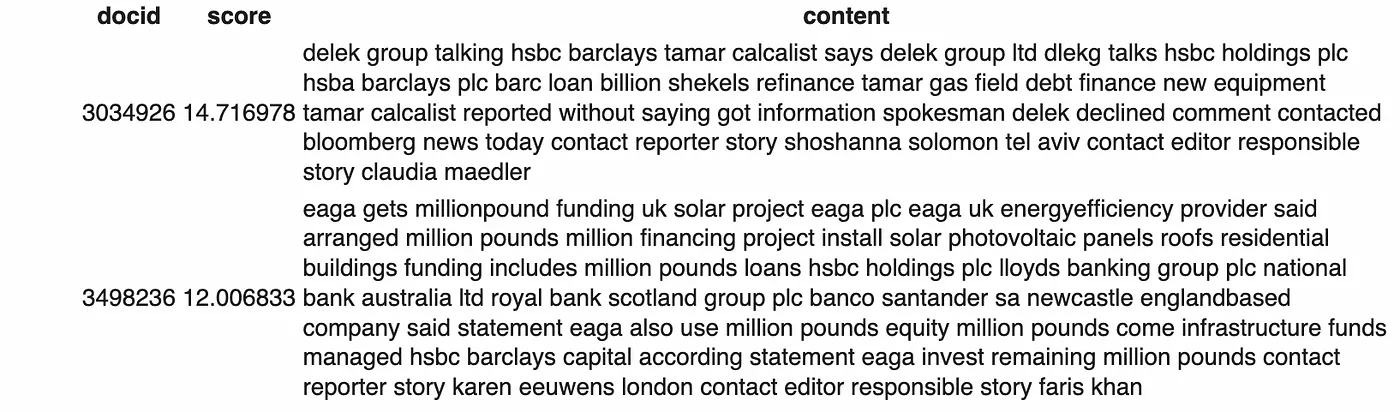
8. Поиск близких значений
Поисковые запросы близких значений находят документы, в которых искомые термины находятся на определенном расстоянии друг от друга. Это расстояние измеряется как количество перемещений терминов, необходимых для того, чтобы они стали соседними.
Следующий поисковый запрос находит новости с терминами hsbc и barclays в пределах пяти терминов, находящихся рядом друг с другом:
%%sql
SELECT t.docid, s.score, t.content FROM ds_demo.financial_news t,       gptext.search(         TABLE(SELECT 1 SCATTER BY 1)
        , 'warehouse.ds_demo.financial_news'
        , '"hsbc barclays"~5'
        , NULL, NULL       ) s WHERE s.id::int8 = t.docid
ORDER BY score DESC LIMIT 2;
9. Парсер запросов к окружению
Парсер запросов позволяет выполнять упорядоченный и неупорядоченный поиск близких значений. Оператор W задает упорядоченный поиск, а оператор N - неупорядоченный. Максимальное расстояние между терминами задается префиксом оператора W или N с целым числом, например, 2W.
Следующий поиск находит новости с терминами «market», «bearish» или «bullish» в пределах 2 терминов:
%%sql
SELECT a.content, q.score
FROM ds_demo.financial_news a,
      gptext.search(         TABLE(SELECT 1 SCATTER BY 1)
        , 'warehouse.ds_demo.financial_news'
        , '{!gptextqp} market* 2W (bearish OR bullish)'
        , NULL, NULL
      ) q WHERE a.docid = q.id::int8
LIMIT 1;
Распознавание сущностей с помощью GPText
Greenplum Text включает компоненты Apache OpenNLP, которые позволяют использовать распознавание именованных сущностей (NER). Примеры именованных сущностей включают имена людей, названия организаций и местоположений.
1. Запуск NER для GPText
Чтобы узнать, как добавить поддержку NER в индекс Tanzu Greenplum Text, обратитесь к официальной документации GPText.
2. Создайте и зафиксируйте индекс
После добавления поддержки NER в индекс GPText проиндексируем таблицу ds_demo.financial_news и зафиксируем только что созданный индекс.
%%sql
SELECT * FROM gptext.index(   TABLE(SELECT * FROM ds_demo.financial_news)   , 'warehouse.ds_demo.financial_news'
); SELECT * FROM gptext.commit_index('warehouse.ds_demo.financial_news');

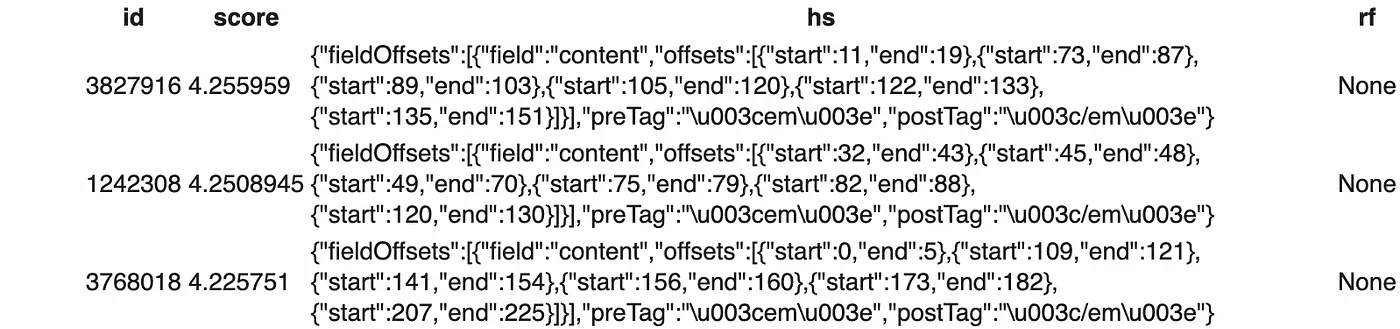
3. Поиск по запросам: NER «человек»
Этот запрос извлекает массив местоположений терминов NER «человек» в новостях.
%%sql
SELECT * FROM gptext.search(   TABLE(SELECT 1 SCATTER BY 1)
  , 'warehouse.ds_demo.financial_news'
  , '_ner_person', NULL
  , 'hl=true&hl.fl=content&rows=10&sort=score desc'
);
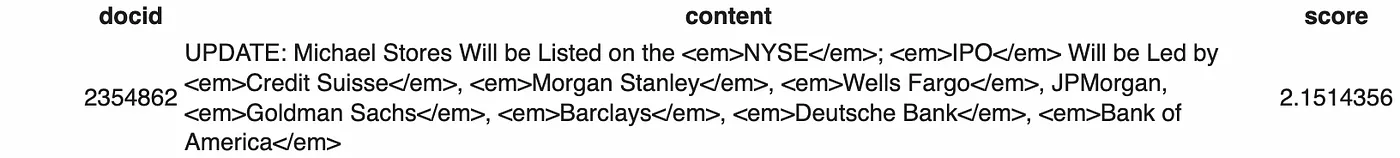
4. Поиск по запросам: NER «организация»
Этот запрос извлекает содержимое новостей в таблице ds_demo.financial_news с выделенными терминами, помеченными тегом _ner_organization
%%sql
SELECT news_demo.docid        , gptext.highlight(news_demo.content, 'content', hs) AS content
       , s.score  FROM ds_demo.financial_news news_demo      , gptext.search(           TABLE(SELECT 1 SCATTER BY 1)
          , 'warehouse.ds_demo.financial_news'
          , '{!gptextqp} _ner_organization', NULL
          , 'hl=true&hl.fl=content&rows=2&sort=score desc'
      ) s  WHERE news_demo.docid = s.id::bigint
ORDER BY s.score desc LIMIT 1;
5. Поиск по запросам: NER «человек» и «время»
Этот запрос извлекает новости, содержащие NER термины «человек» и «время» (прямой поиск близких значений).
Этот запрос выполняет поиск близких значений для того, чтобы найти новости с термином «человек», за которым следует термин «время» в пределах следующих семи терминов.
%%sql
SELECT news_demo.docid        , gptext.highlight(news_demo.content, 'content', hs) AS content
       , s.score  FROM ds_demo.financial_news news_demo      , gptext.search(         TABLE(SELECT 1 SCATTER BY 1)
        , 'warehouse.ds_demo.financial_news'
        , '{!gptextqp} (_ner_person 7W _ner_time)', NULL
        , 'hl=true&hl.fl=content&rows=10&sort=score desc'
      ) s  WHERE news_demo.docid = s.id::bigint
ORDER BY s.score desc LIMIT 1;

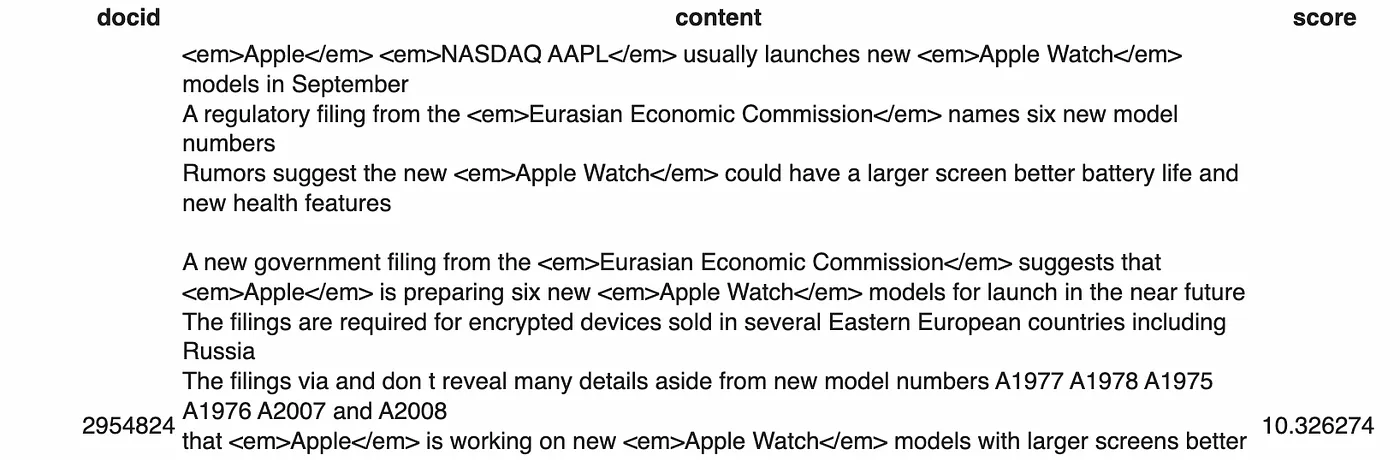
6. Поиск по запросам: специальный и любой NER «организация»
Этот запрос ищет новости со специальной NER «организацией» (AAPL) и любой NER «организацией» (неупорядоченный поиск по близости).
Как и в предыдущем примере, этот запрос выполняет поиск близких значений, но эти термины могут встречаться в документе в любом порядке и должны находиться в пределах десяти терминов друг от друга.
%%sql
SELECT news_demo.docid        , gptext.highlight(news_demo.content, 'content', hs) AS content
       , s.score  FROM ds_demo.financial_news news_demo      , gptext.search(           TABLE(SELECT 1 SCATTER BY 1)
          , 'warehouse.ds_demo.financial_news'
          , '{!gptextqp} (_ner_organization_Apple 10N _ner_organization)', NULL
          , 'hl=true&hl.fl=content&rows=10&sort=score desc'
      ) s  WHERE news_demo.docid = s.id::bigint
ORDER BY s.score desc LIMIT 1;
Заключение
В заключение следует отметить, что Greenplum Text включает в себя мощные функции для поиска, анализа текстов и распознавания именованных сущностей (NER). Все функции доступны через SQL и могут быть объединены со всеми другими возможностями движка Greenplum.
NB: GPText также поддерживает JSON-индекс, а в следующем выпуске появится поддержка более сложных документов (PDF и Word).


