
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс по Greenplum » Greenplum для Data Science: Развертывание моделей на Greenplum с помощью Python с помощью GreenplumPython

Greenplum для Data Science: Развертывание моделей на Greenplum с помощью Python с помощью GreenplumPython

Введение

GreenplumPython позволяет специалистам по исследованию данных писать код на привычном и хорошо знакомом им языке Pythonic, выполнять преобразования данных и обучать модели ML гораздо быстрее и безопаснее на единой платформе Greenplum. Вызовы функций на фреймах переводятся GreenplumPython в SQL-запросы и автоматически отправляются в Greenplum. В результате вычисления происходят параллельно в кластере Greenplum.


Обзор набора данных

Набор данных состоит из 1967 новостей фондового рынка из англоязычных финансовых новостей, классифицированных по тональности. Поля данных:

  • docid: идентификатор финансовых новостей
  • original_news: текст финансовых новостей
  • label: метка, соответствующая классу, в виде строки 'положительная' или 'отрицательная'.
  • cleaned_text: очищенный текст original_news


sentiment_news = db.create_dataframe(table_name="sentiment_news", schema="ds_demo")
sentiment_news[:5]


NLP — развертывание модели с помощью GreenplumPython

Импорт​ пакетов

Раньше для создания UDF в базе данных пользователю приходилось прописывать все зависимости в теле функции. Это часто приводило к использованию раздражающего кодового шаблона, особенно при импорте одних и тех же пакетов в разные функции.

GreenplumPython поддерживает ссылки на объекты вне UDF, включая функции и модули. Это позволяет преодолеть разрыв между UDF и обычной функцией Python.

Мы импортируем все пакеты, которые нужны нашим UDF:

import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
import pickle
from typing import List


Функция обучения модели

Мы хотим создать функцию для обучения NLP-модели и вернуть обученную модель логистической регрессии и модель вектора подсчета.


Создаем тип

Для этого нам нужно сначала создать специальный класс sentiment_nlp_type для хранения результатов работы функции в виде двоичных файлов:

class sentiment_nlp_type:
    model_logreg: bytes
    model_bow: bytes


Создаем функцию

Мы можем написать функцию train, используя расширение PL/Python3, как показано ниже, указав возвращаемый тип.

@gp.create_column_function преобразует функцию Python в функцию, определяемую пользователем (UDF) в базе данных, и автоматически агрегирует входные столбцы для применения к столбцам.


NB: Созданные функции лишь временно сохраняются в базе данных и будут удалены по окончании сеанса.

@gp.create_column_function
def save_nlp_models(cleaned_text: List[str], label: List[str]) -> sentiment_nlp_type:
    X_train = cleaned_text     y_train = label     vectorizer = CountVectorizer(min_df=4, stop_words="english")
    X_train = vectorizer.fit_transform(X_train)     # LOGISTIC REGRESSION
    logreg = LogisticRegression()     logreg.fit(X_train, y_train)     # Save Logistic Regression model
    model_logreg = pickle.dumps(logreg)     # Save CountVectorizer
    model_countvectorizer = pickle.dumps(vectorizer)     return {'model_logreg': model_logreg,
            'model_bow': model_countvectorizer}


Применяем функцию

Мы можем использовать эту функцию для обучения модели, которая обучается на основе датафрейма sentiment_news:

model_nlp = sentiment_news.apply(
                lambda t: save_nlp_models(t["cleaned_text"], t["label"]),
                expand=True
            )


Функция составления прогноза

Точно так же, как мы создали функцию обучения, теперь создадим функцию составления прогноза с помощью @gp.create_function:

@gp.create_function
def predict_sentiment(cleaned_text: str, model_logreg: bytes, model_bow: bytes) -> str:
    logreg = model_logreg     vectorizer = model_bow     texts = cleaned_text     # Extract Logistic Regression model
    model_logreg_bytes = pickle.loads(logreg)     # Extract CountVectorizer
    model_countvectorizer = pickle.loads(vectorizer)     return list(
              model_logreg_bytes.predict(                 model_countvectorizer.transform([texts])               )            )[0]


Развертывание модели

Процесс обучения завершен, теперь мы можем перейти к следующему шагу, а именно к развертыванию модели.

news = "Previously, the company anticipated its operating profit to improve over the same period."


Используем обученную выше model_nlp 

model_nlp.apply(
    lambda t: predict_sentiment(news, t["model_logreg"], t["model_bow"])
)



Используем модель ds_demo.saved_models

# Access to the model saved in the database
model_table = db.create_dataframe(table_name="saved_models", schema="ds_demo")
model_saved = model_table[lambda t: t["model_name"] == "nlp_sentiment_analysis_bow_logreg"]

# Call function predict
model_saved.apply(
    lambda t: predict_sentiment(news, t["model_logreg"], t["model_bow"])
)



Используем предопределенные UDF, сохраненные в Greenplum

Вы также можете получить доступ к предопределенному UDF predict_sentiment  в  Greenplum, который был создан с помощью gp.function():

# Get pre-defined UDF
predict_function = gp.function("predict_sentiment")
# Call predict UDF
model_saved.apply(     lambda t: predict_function(news, t["model_logreg"], t["model_bow"])
)



Прогнозирование нескольких записей из базы данных

Конечно, мы можем применить модель и к таблице новостей, хранящейся в базе данных со множеством записей!

Для этого нам нужно сначала объединить model_table и data_table воедино:

data_model_join = sentiment_news.cross_join(nlp_sentiment_analysis_bow_logreg)
data_model_join[:1]
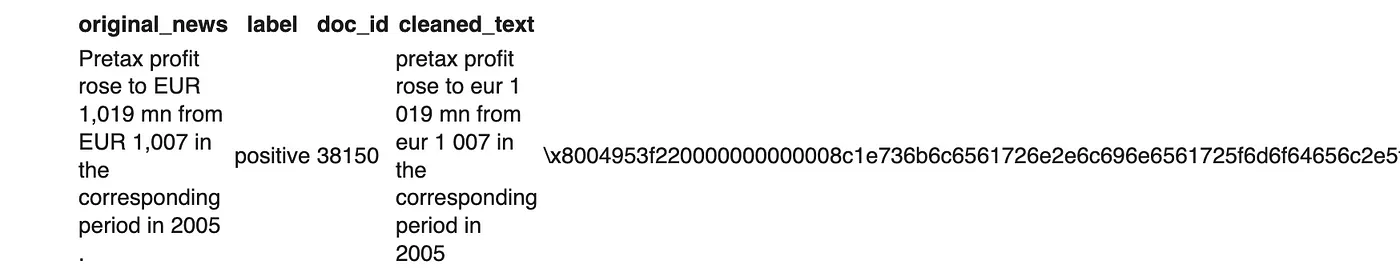


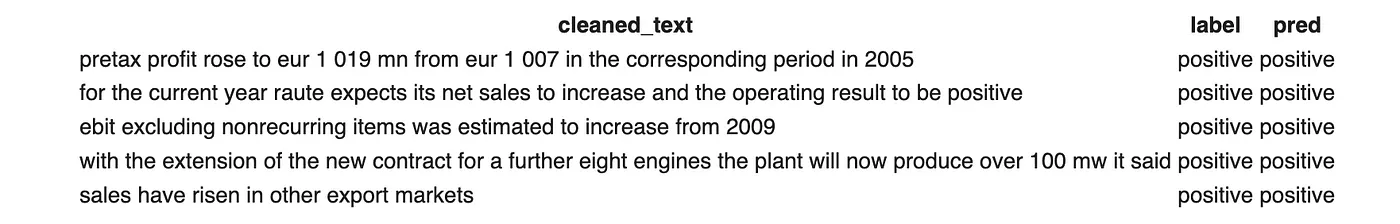
Теперь мы можем присвоить предсказанное значение нашему датафрейму:

data_model_join.assign(
    pred=lambda t: predict_function(t["cleaned_text"], t["model_logreg"], t["model_bow"])
)[["cleaned_text", "label", "pred"]][:5]


Заключение

В этой статье мы показали Вам, как GreenplumPython может быть использован специалистами по исследованию данных для выполнения параллельных вычислений на Greenplum непосредственно из Python в неявном виде. Это весьма выгодно для специалистов по обработке данных, которым удобнее кодировать на Python. Кроме того, это обеспечивает большую гибкость в управлении развертыванием и использованием моделей на Greenplum. Если Вы хотите узнать о GreenplumPython подробнее, мы приглашаем Вас ознакомиться с  официальной документацией.


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Greenplum для Data Science: Масштабируемое ML и NLP в базе данных с помощью PL/Python
Следующая статья →
Введение в архитектуру Greenplum
Запросить видео презентацию Запросить доступ к демо стенду online Узнать стоимость лицензий

Задать вопрос

loading...

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • С объединением компании Savencia Fromage & Dairy и молочного комбината в г.Белебей, одного из лидеров по производству твердых сычужных сыров в России, Savencia выходит на российский рынок не только как импортер, но и как производитель молочной продукции.

  • Ситилинк

    Электронный дискаунтер «Ситилинк» — один из крупнейших онлайн‑ритейлеров России (3‑е место по объему онлайн‑продаж в рейтинге Data Insight и Ruward 2016 года E‑commerce Index TOP‑100, 8 место в рейтинге Forbes «20 самых дорогих компаний Рунета — 2017»). На рынке работает 9 лет.

    В ассортименте дискаунтера более 50 000 наименований компьютерной цифровой, бытовой и садовой техники, офисной мебели и других товарных категорий. Более 700 мировых брендов в портфеле. Около 4 000 сотрудников по всей России

  • Нашей компанией был реализован проект автоматизации конвейера данных на базе СПО ETL-инструмента Apache NiFi для клиента ООО «Императорский Монетный Двор» в части актуализации данных, передаваемых из Системы Oracle в Anaplan.

  • "Уральский банк реконструкции и развития" входит в топ-25 крупнейших банков России и список значимых кредитных организаций на рынке платежных услуг по версии ЦБ РФ.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.