Введение в архитектуру Greenplum
Это первая статья из цикла «Ядро Greenplum». Всего в этом цикле десять статей, в которых будут подробно рассмотрены различные модули Greenplum. Сегодня я расскажу об архитектуре Greenplum. Прежде чем говорить об архитектуре Greenplum, давайте посмотрим на систему управления базами данных в целом.
СУБД
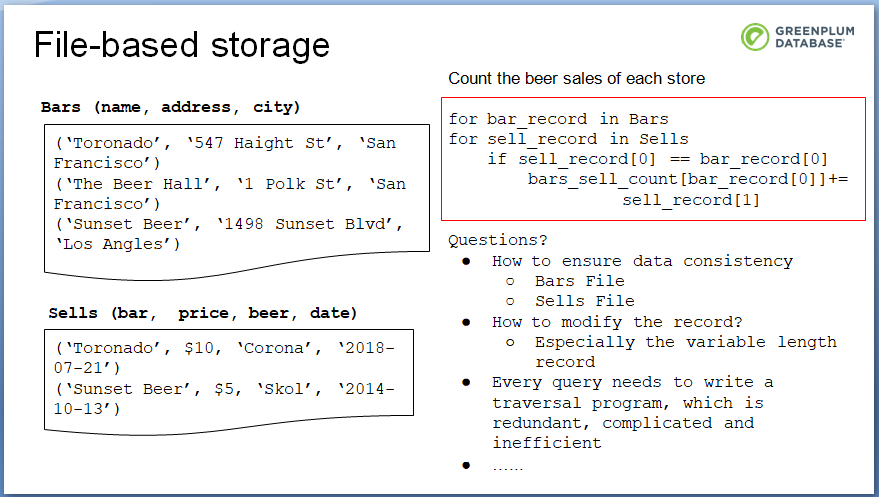
В основе изобретения системы управления базами данных лежит потребность в эффективном управлении данными и запросами. До появления системы управления базами данных использовалось файловое хранение. В следующем примере две таблицы представляют информацию о баре и информацию о продажах в разных барах. Если эти два вида информации хранятся в файлах, мы можем использовать два цикла for для расчета количества продаж пива в каждом магазине.

Хотя код этой операции очень короткий, сложность алгоритма высока. Помимо низкой эффективности алгоритма, существуют и другие проблемы, связанные с хранением файлов:
- Согласованность данных: например, полоса, соответствующая записи о продаже, не появляется в файле полос, что приводит к существованию недостоверных данных;
- Модификация записей: особенно трудно поддерживать модификацию атрибутов переменной длины строкового типа;
- Сложность, избыточность и неэффективность запроса: для каждого запроса необходимо написать программу обхода, а программа обхода очень ответственна за время выполнения и место;
- Высокие технические требования
- Множество других проблем.
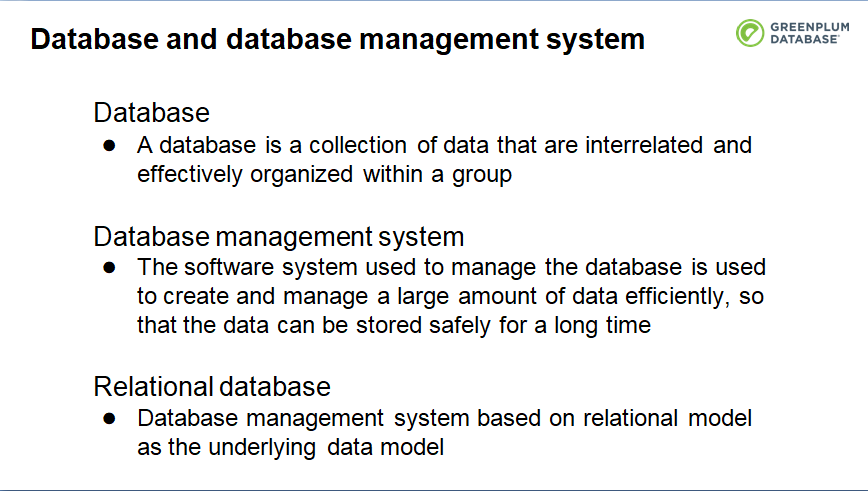
Так появилась СУБД. Многие люди используют базу данных для краткого обозначения системы управления базами данных. На самом деле, база данных и система управления базами данных - это два разных понятия. База данных - это совокупность эффективно организованных, связанных и удобных данных для эффективного хранения и запроса. Система управления базами данных - это вид программного обеспечения, которое используется для управления данными в базе данных. Она может не только предоставлять базовый интерфейс для добавления, удаления и изменения данных, но и обеспечивать эффективный язык запросов. Для моделирования данных существуют различные методы моделирования, в том числе на основе документа, объекта, КВ и т.д., а система управления базами данных, основанная на реляционной модели в качестве базовой модели данных, называется реляционной системой управления базами данных, Greenplum также является разновидностью реляционной системы управления базами данных, называемой реляционной базой данных.
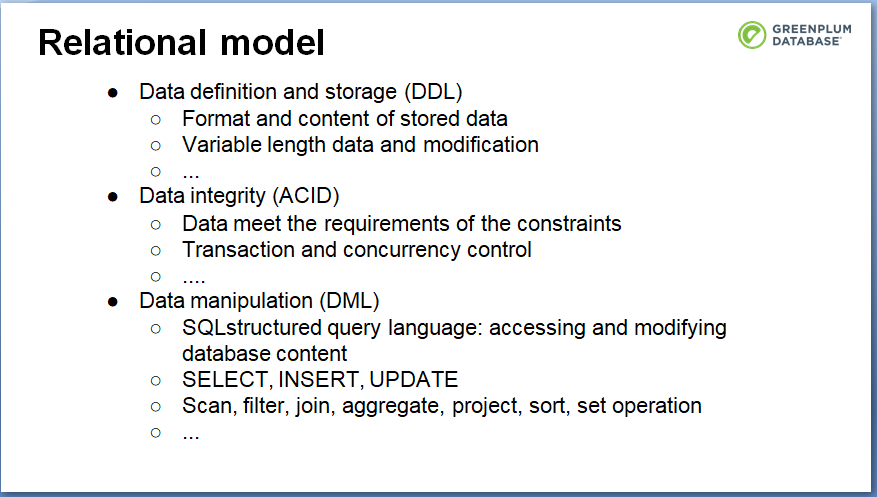
Реляционная база данных имеет несколько важных технических моментов, таких как определение и хранение данных, обеспечение целостности данных, включая их непротиворечивость, управление транзакциями и параллелизмом, а также поддержка удобного интерфейса запросов.
Общая архитектура Greenplum
Далее мы рассмотрим, как Greenplum решает все вышеперечисленные проблемы. Для начала давайте рассмотрим общую архитектуру Greenplum. Greenplum - это распределенная база данных с открытым исходным кодом на основе Postgres. Судя по топологической структуре, она представляет собой кластер баз данных, состоящий из отдельных Postgres. Но этим дело не ограничивается. Greenplum предоставляет унифицированный интерфейс базы данных, который позволяет пользователям чувствовать себя так, как будто они используют отдельную базу данных, а также Greenplum провела множество оптимизаций при обработке кластера.
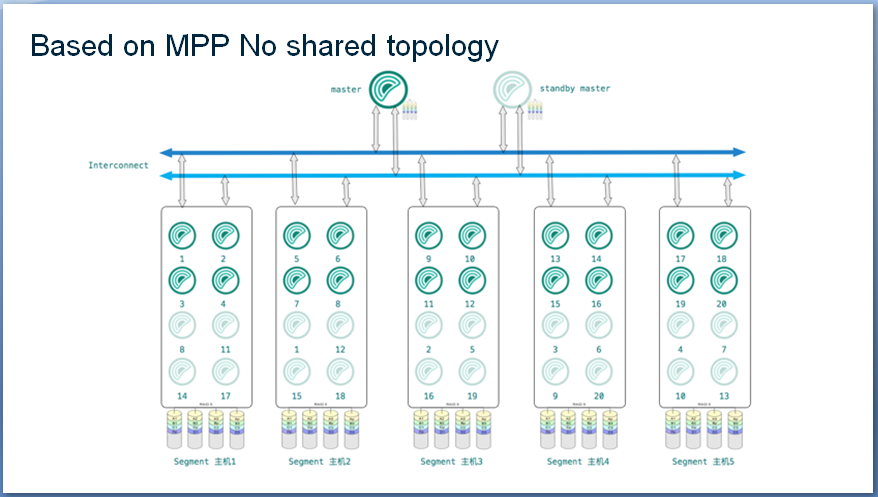
С точки зрения физической топологии база данных Greenplum представляет собой типичную структуру мастер-сегмента. Кластер Greenplum обычно состоит из мастер-узла, резервного узла и нескольких сегментных узлов, а узлы соединены между собой высокоскоростной сетью. Мастер является входом всей базы данных. Конечные пользователи подключаются к мастеру для выполнения запросов. Резервный узел обеспечивает поддержку высокой доступности для главного узла. Сегментный узел является рабочим узлом, и данные существуют на сегменте. Зеркальный сегмент будет обеспечивать высокую доступность сегмента.
Каждый блок на рисунке ниже - это физическая машина, чтобы получить наилучшую производительность физической машины, узел может гибко развернуть несколько сегментных процессов. В процессе запроса, когда ведущий узел получает запрос, инициированный пользователем, он выполняет компиляцию запроса, оптимизацию запроса и другие операции, генерирует параллельный план запроса и распределяет его по сегментным узлам для выполнения. После выполнения сегмента данные будут отправлены обратно на ведущий узел и, наконец, представлены пользователю.
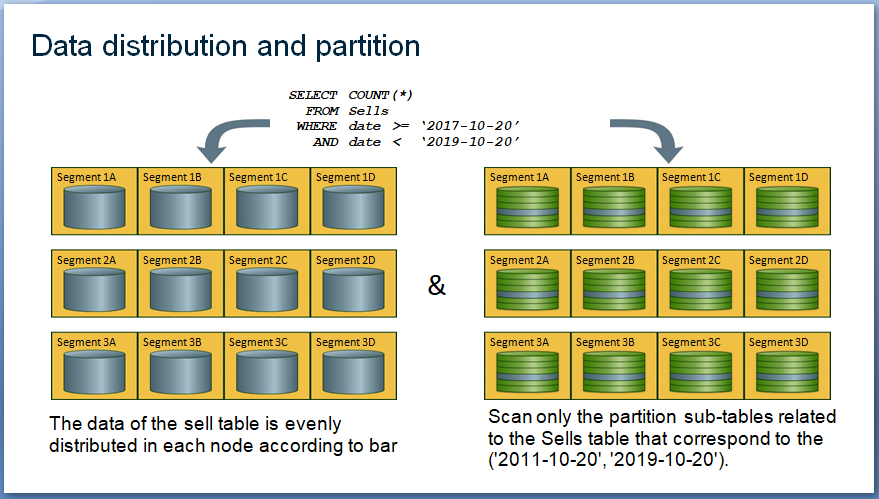
Разобравшись с архитектурой Greenplum, давайте рассмотрим, как хранятся данные в Greenplum. В Greenplum каждой физической машине будет соответствовать несколько дисков, к каждому диску будет прикреплен физический диск, и каждый диск будет иметь несколько разделов данных. При организации данных на Greenplum будут использоваться следующие стратегии:
- Прежде всего, данные будут равномерно распределены по каждому сегменту в соответствии с заданной стратегией распределения. Стратегии распределения, поддерживаемые Greenplum, включают хэш-распределение, случайное распределение и новое распределение репликации в Greenplum 6. Эта операция называется фрагментацией данных.
- Затем данные на каждом узле могут быть разделены на меньшие подмножества с помощью разбиения данных, чтобы цена была ниже в эпоху запросов. Эта операция называется разделением данных
Для пояснения воспользуемся примером «полосы», приведенным выше. Слева показана обработка фрагментации данных. Таблица sell разбивается по столбцу («полосе») и делится на различные узлы. Затем каждый узел разбивается по «дате» и делится на небольшие подтаблицы. С помощью оператора запроса на рисунке можно просканировать только синюю часть рисунка, чтобы выполнить задачу запроса, что значительно сокращает объем сканирования данных.
Далее рассмотрим процесс обслуживания Greenplum. В следующем примере слева находится главный узел, а справа - два сегментных узла. С точки зрения топологии Greenplum представляет собой кластер баз данных, состоящий из отдельных Postgres. В примере есть три процесса Postgres. Когда клиент получает запрос, он связывается с главным узлом Greenplum через протокол libpq Postgres. После того как процесс postmaster на главном узле прослушает запрос на соединение, он создает подпроцесс (QD) для обработки всех запросов клиента. QD и исходный мастер будут обмениваться данными через общую память.
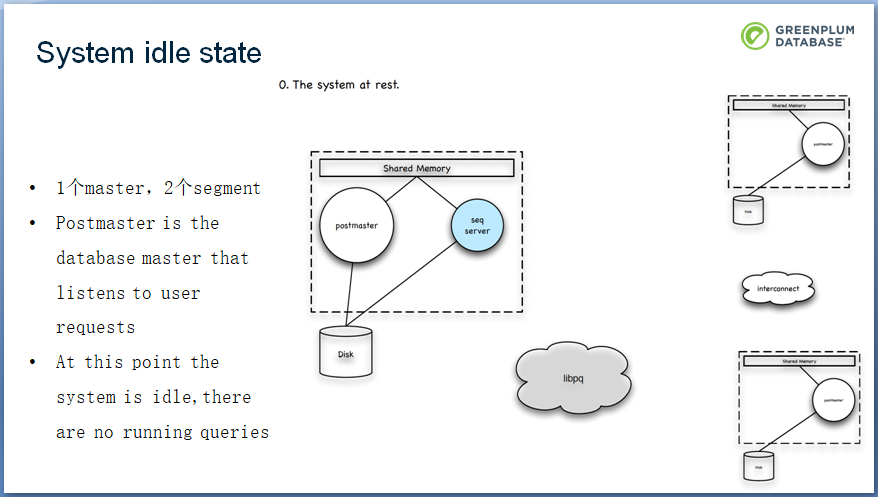
Между QD и отдельными Сегментами существует связь. QD можно рассматривать как клиента каждого Сегмента, процесс QD посылает запросы на соединение на все узлы Сегмента, устанавливает запросы на соединение через протокол libpq и каждый Сегмент, а процесс postmaster на Сегменте, когда он прослушивает запрос на соединение QD, также создает подпроцесс (QE) для обработки последующих запросов. Полное название QD - диспетчер запросов, который является распределителем, а QE - исполнитель запросов, который обрабатывает запросы. Все процессы QD и QE будут работать вместе для того, чтобы выполнить запрос, отправленный клиентом.
После того как подготовительная работа завершена, как выполняется сам запрос? После того как клиент отправляет запрос процессу QD на главном сервере, процесс QD обрабатывает полученный запрос, включая разбор исходного оператора запроса, генерацию распределенного плана запроса оптимизатором и отправку его процессу QE на каждом сегменте по протоколу libpq. QD и QES на каждом сегменте устанавливают межсегментное соединение. Следует отметить, что протокол Libpq используется в основном для управления возвратом команд и результатов, а интерконнект - для обмена внутренними данными.
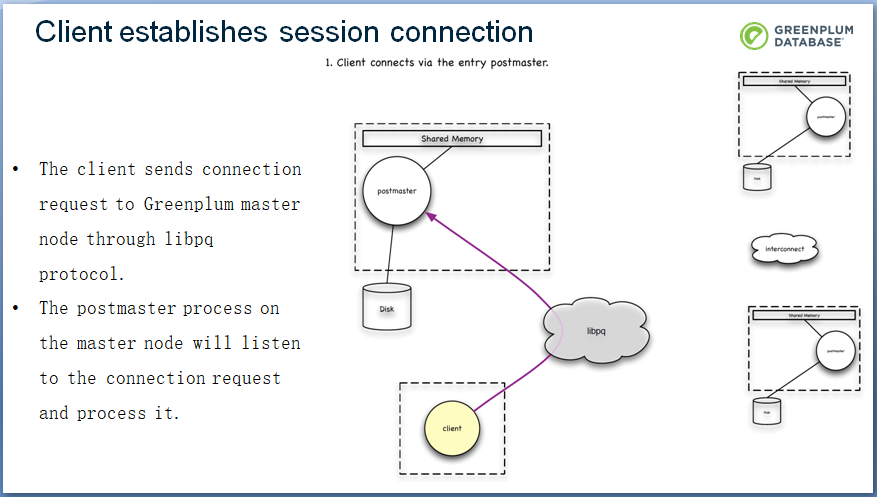
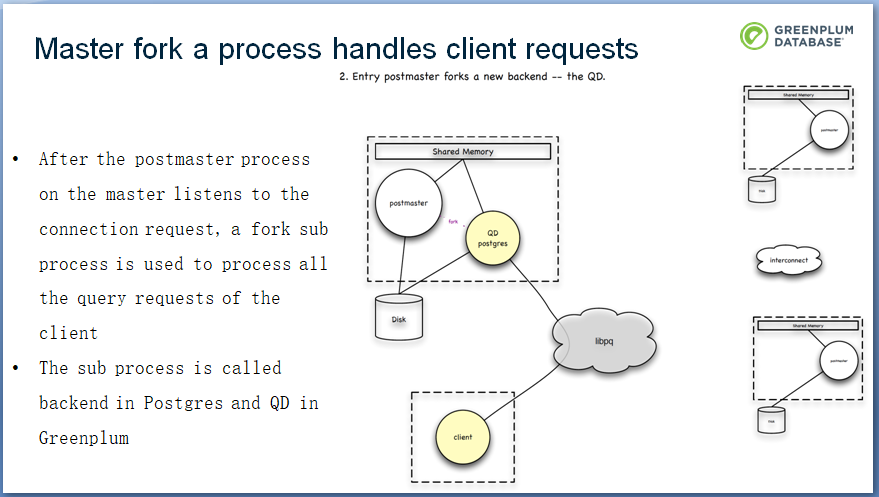
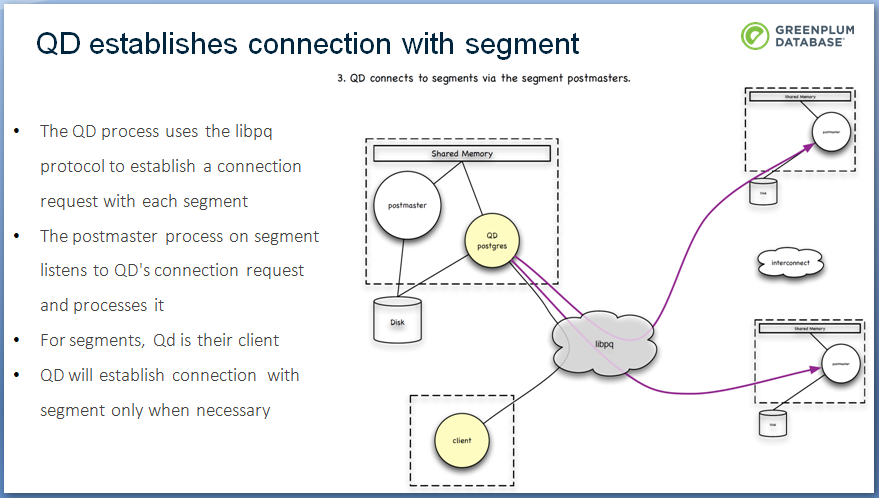

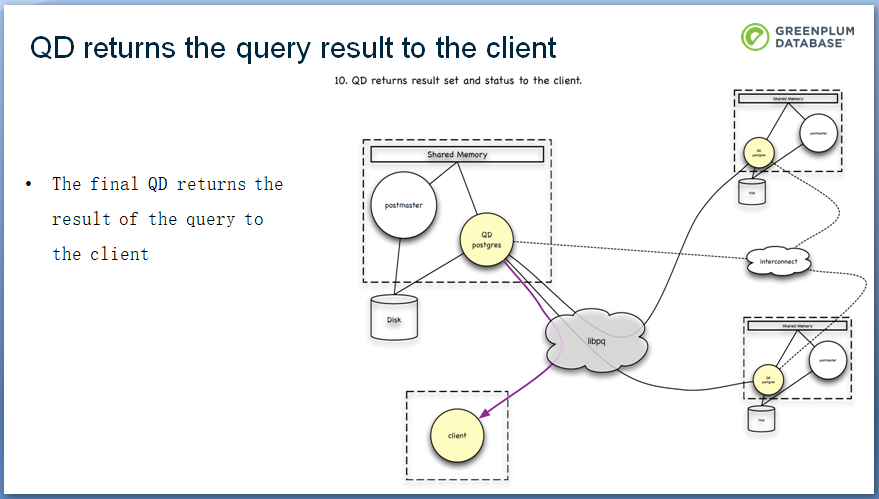
Каждый процесс QE выполняет назначенную ему подзадачу запроса и возвращает результаты в QD. QES также взаимодействуют друг с другом через соединение, при этом нет ссылки на libpq. Протокол libpq используется для обновления и управления состоянием между QE и QD, включая обработку ошибок. Окончательный QD суммирует собранные результаты запроса и возвращает их клиенту через libpq.
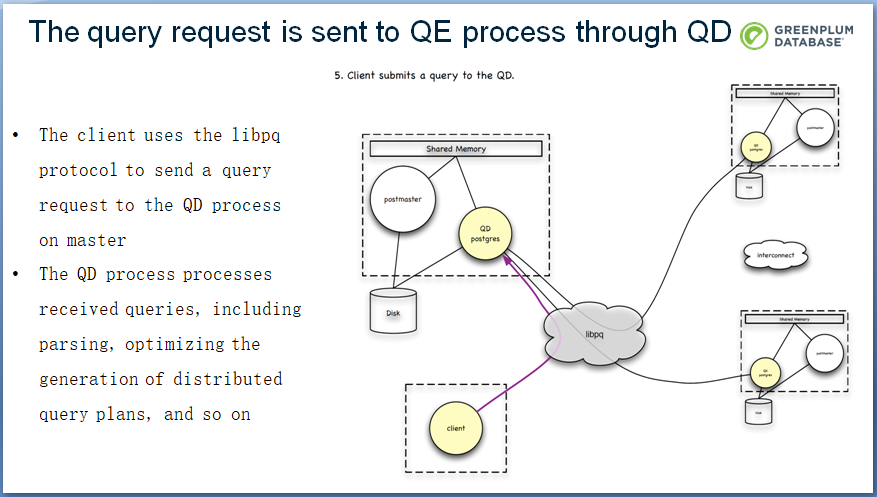
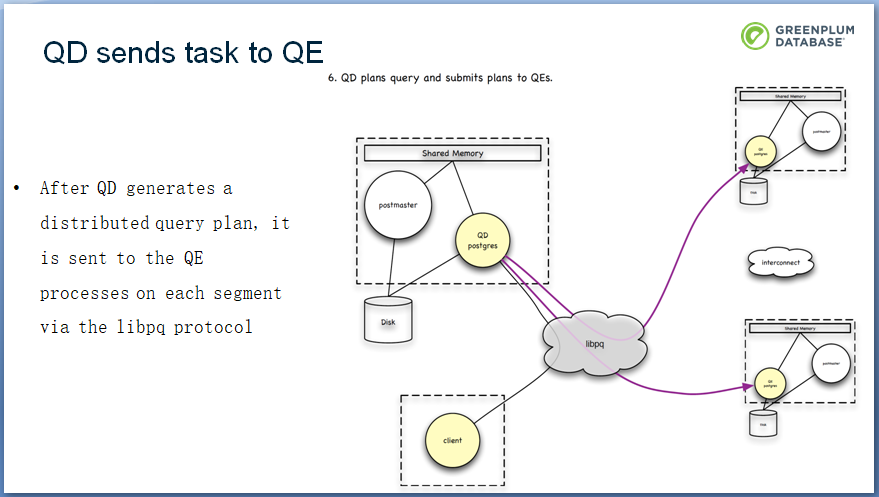
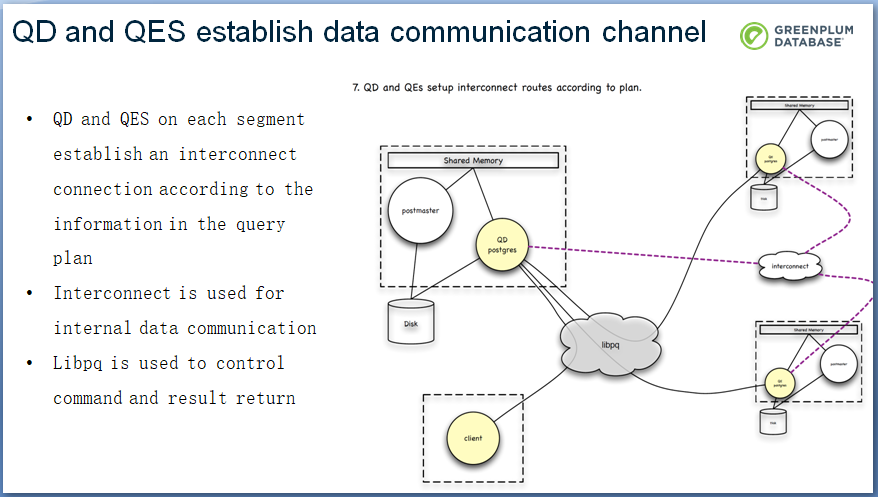
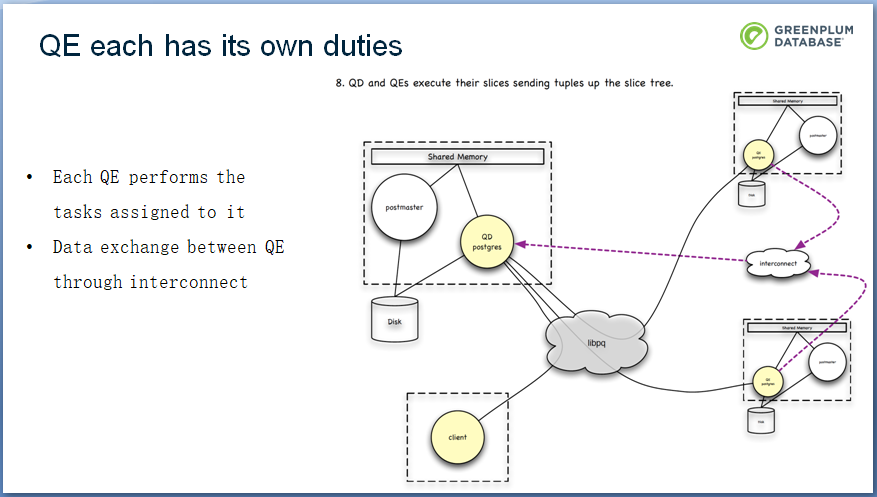
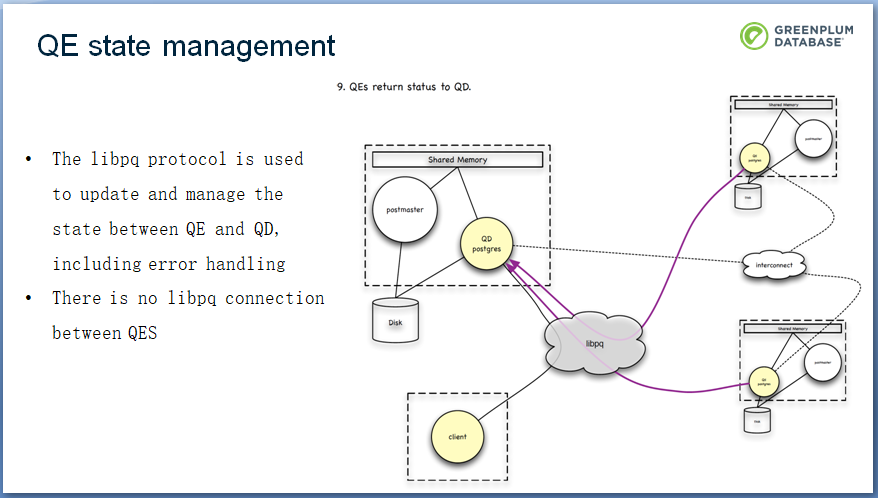
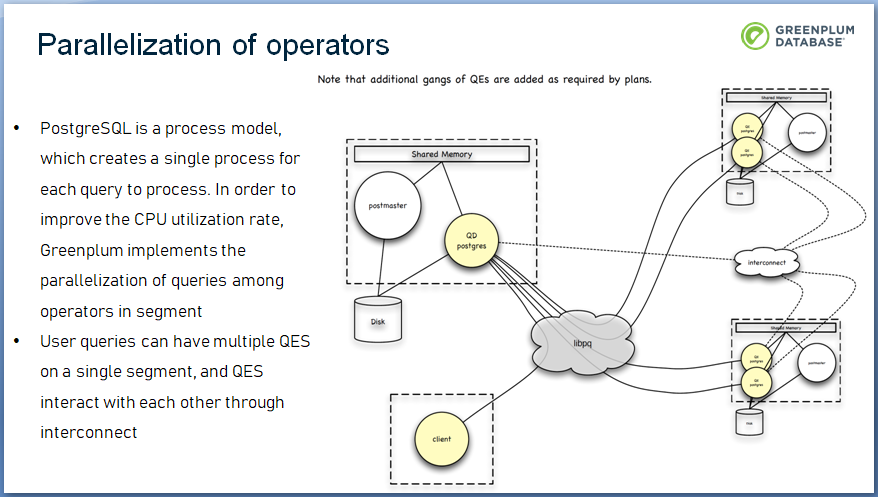
Например, при выполнении сложных запросов сначала выберите две таблицы, а затем соедините их. В это время весь запрос будет разделен на два слоя. Первый слой считывает данные, а затем обменивается данными между ними. Второй уровень объединяет значения одного и того же ключа связи и, наконец, возвращает результат соединения клиенту. PostgreSQL - это модель процесса, которая создает единый процесс для каждого обрабатываемого запроса. Для повышения эффективности использования ЦП Greenplum реализует распараллеливание запросов между операторами в сегменте. Пользовательские запросы могут иметь несколько QES на одном сегменте, которые взаимодействуют друг с другом посредством межсоединения.
Управление хранением
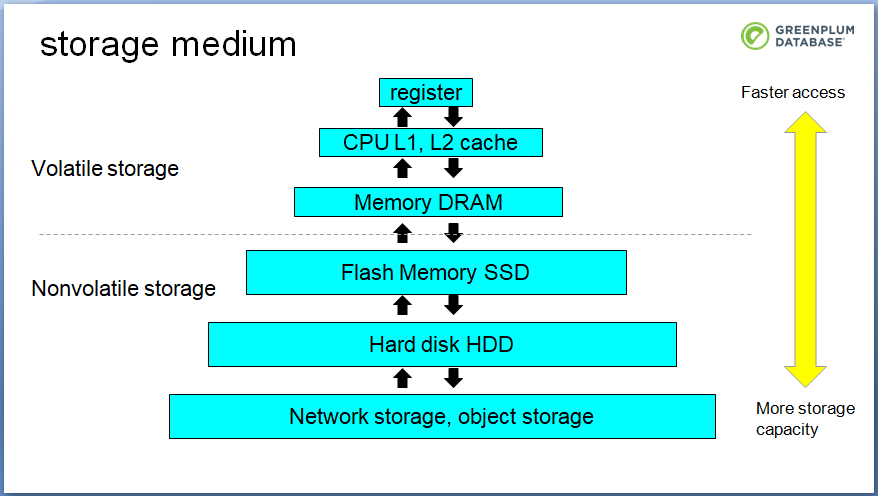
Поговорим об архитектуре Greenplum и рассмотрим ее основные функциональные модули. Сначала рассмотрим управление хранением данных Greenplum. Пирамида хранения часто упоминается в большинстве учебниках. В пирамидальном распределении, чем больше Вы идете вверх, тем меньше емкость и выше скорость. И наоброт, чем дальше Вы идете вниз, тем больше емкостьи меньше скорость. Это и есть так называемое энергозависимое хранилище, которое работает относительно медленно, но данные при этом потерять совсем непросто.
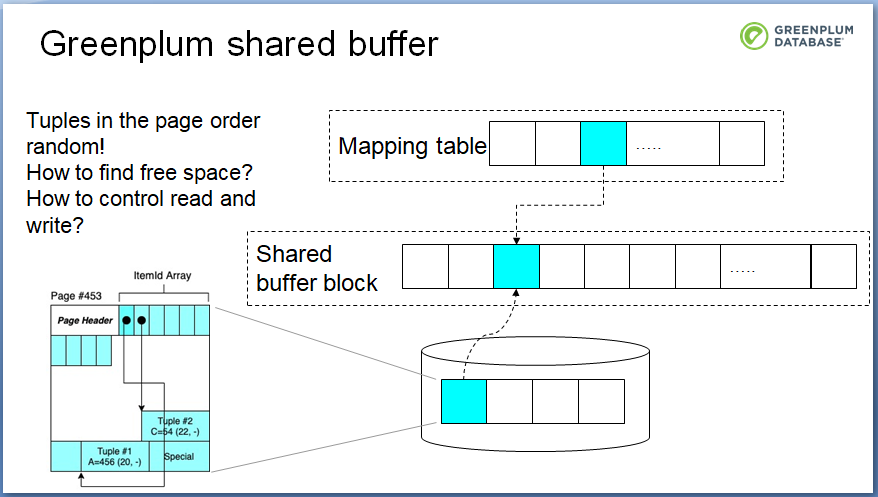
Из университетских курсов по операционной системе Вы знаете, что при написании программ мы получаем доступ к файлам через кэш или буфер. Процесс Greenplum использует общую область буфера в качестве промежуточного буфера памяти. Процесс Бекенда будет непосредственно касаться среднего слоя, при этом буфер в общей памяти будет заменен на дисковый файл.
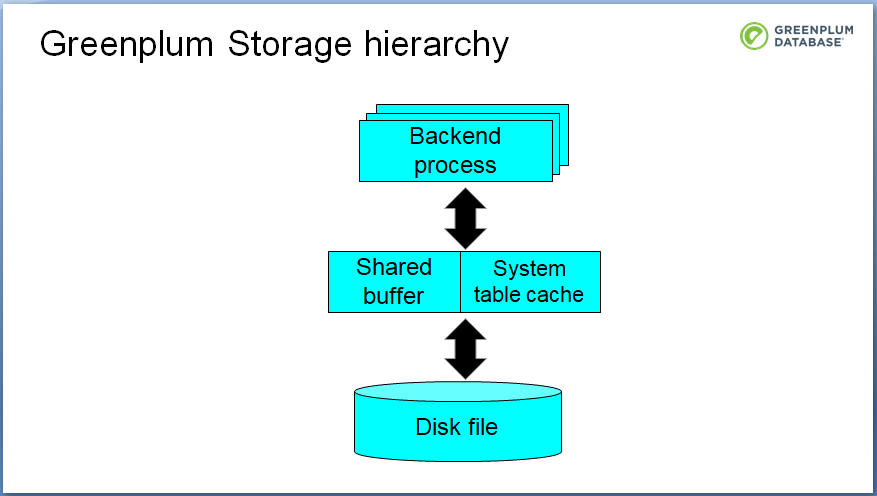
Так что же происходит в общем буфере? Greenplum организует данные в блоки. Пунктирный квадрат на рисунке является общей областью памяти. Таблица отображения найдет блок, соответствующий совместно используемому блоку буфера, через номер блока. Если обнаружено, что содержимое недействительно, данные будут загружены в совместно используемый буферный блок посредством операции нижнего файла. Если оно действительно, оно будет прочитано.
Greenplum будет хранить данные переменной длины в каждом файловом блоке сзади вперед. В заголовке страницы имеется указатель фиксированной длины, который указывает на смещение внутри блока реальных данных в конце блока. n-ые данные можно быстро найти с помощью указателя. Средняя область - это свободная область. Данные будут расти от задней к передней панели, а идентификатор элемента будет расти от передней к задней панели. Средняя область будет резервировать постоянное пространство для уменьшения фрагментации.
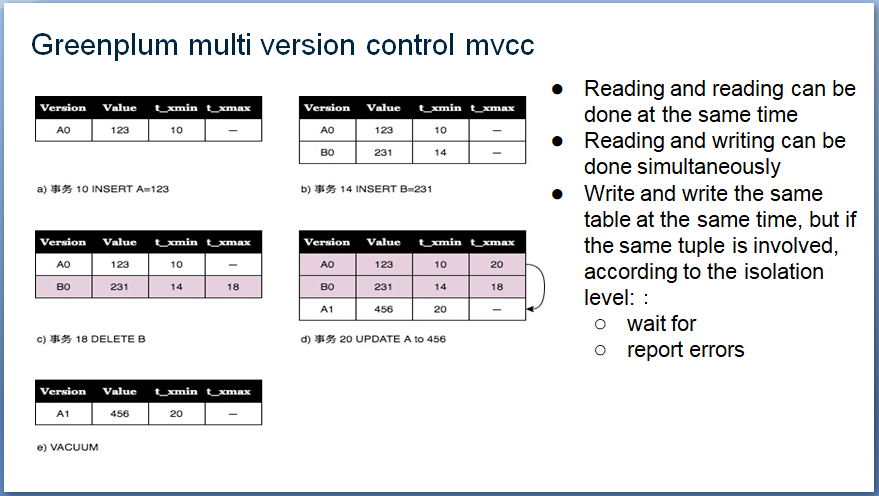
Для Greenplum чтение и запись могут выполняться одновременно. Для того, чтобы позволить одновременно читать и писать, Greenplum предоставляет механизм управления несколькими версиями MVCC для улучшения параллелизма. При вставке данных сохраняются два скрытых поля: xmin и xmax, которые представляют номера операции вставки и удаления соответственно.
В следующем примере, Рисунок (с) удаляет данные B0, таким образом, значение xmax 18 добавляется к данным. Если транзакция 17 выполняется, потому что транзакция 17 предшествует транзакции 18, она невидима для этой операции, так что значение B0 все еще видимо для транзакции 17, и транзакция 17 не будет считать, что данные были удалены. Для операции 19, B0 был удален. UPDATE будет разделена на две операции: DELETE и INSERT. Например, рисунок (e) в примере. Если запись и запись в одну таблицу одновременно, и в ту же самую фишку, она будет обрабатываться в соответствии с уровнем изоляции. Когда удаленная кортежа невидима для всех текущих транзакций, VACUUM будет восстанавливать пространство на диске.
Индекс
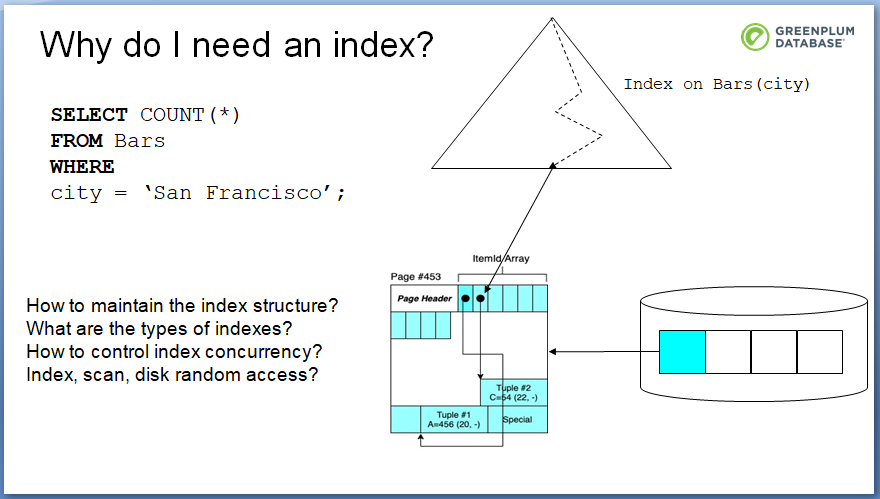
Индексирование может ускорить чтение и запись файлов. Индекс находит физическое местоположение хранения корзины по значению, и читает ее из этого места. По сравнению со сканированием, индексирование не всегда осуществляется быстрее. Например, не имеет смысла индексировать пол, потому что будет сканироваться почти половина данных. Итак, когда использовать последовательное сканирование и когда использовать индексы, это то, что нужно определить оптимизатору запросов. Кроме того, как поддерживать структуру индекса? Какие типы индексов существуют? Как контролировать параллелизм? Всегда ли индексирование лучше сканирования? Мы будем делиться этими материалами с Вами в статьях "Kernel Series Live", не пропустите.
Выполнение запросов
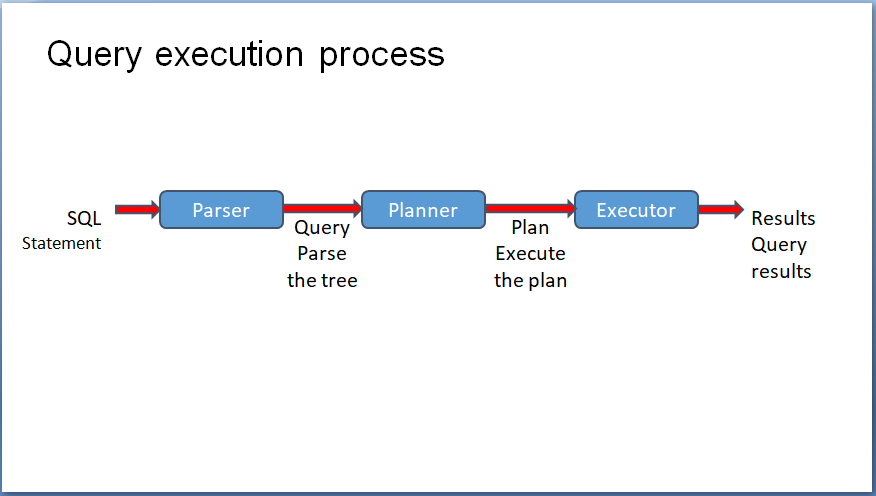
Добавление, удаление, проверка и модификация кортежей могут быть осуществлены, но этого не достаточно. Для того чтобы облегчить пользователям использование и обеспечить более мощные и полезные функции, Greenplum предоставляет механизм выполнения запросов. Когда запрос выполняется, SQL-инструкция проходит через анализатор, и строка SQL-инструкции разбирается в структурированном дереве, наиболее эффективный план выполнения осуществляется через оптимизатора, а исполнитель выполняет результат запроса.
Инструкция SQL в следующем примере соединяет две таблицы. В Greenplum исполнитель выполняет план запроса через итераторы, то есть от верхнего к нижнему. Каждый узел исполнителя предоставляет и получает следующую прямую. Может быть несколько планов запросов, таких как последовательное сканирование и индексное сканирование, упомянутое чуть выше. Оптимизатор запросов достаточно умен для того, чтобы выбрать наименее дорогой план выполнения. В примере, приведенном ниже, отражена операция сканирования двух таблиц.
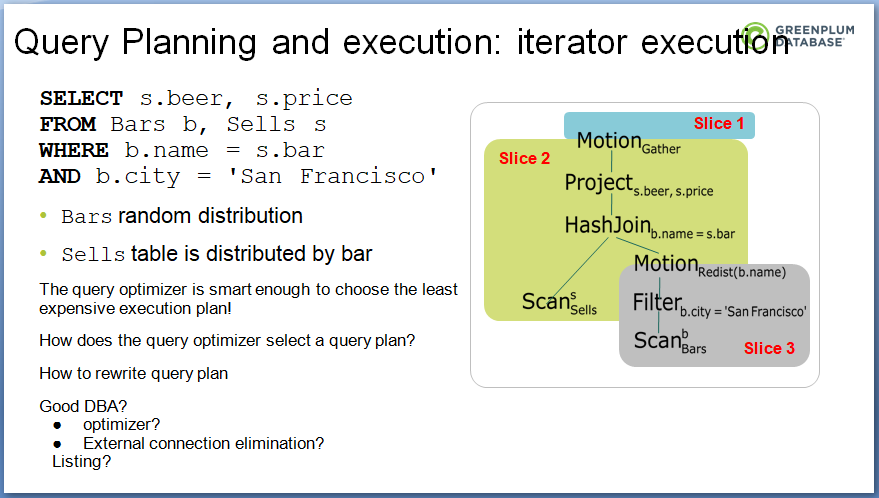
Если будет принят индекс сканирования, то одна из возможных проблем будет заключаться в том, что кортежи, выбранные индексом, будут находиться в файле, что приведет к несанкционированному доступу к диску.
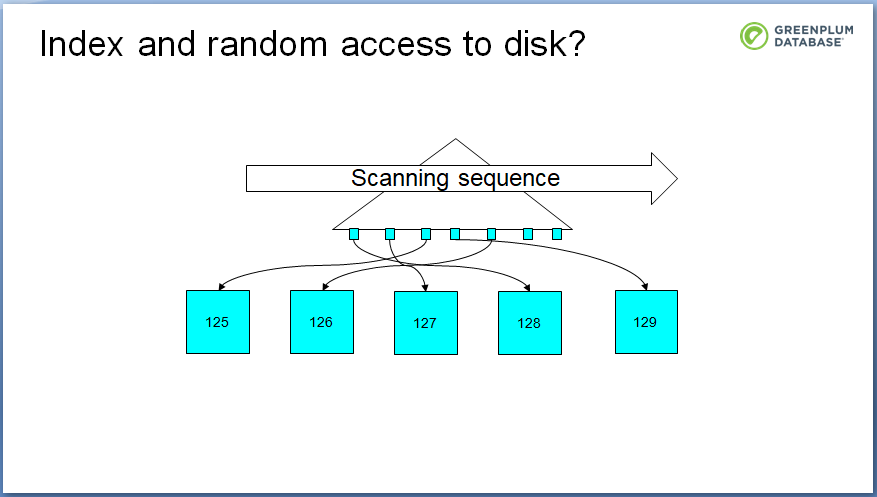
Одно из возможных решений данной проблемы – кластерная операция Greenplum, перераспределяющая кортежи в файле.

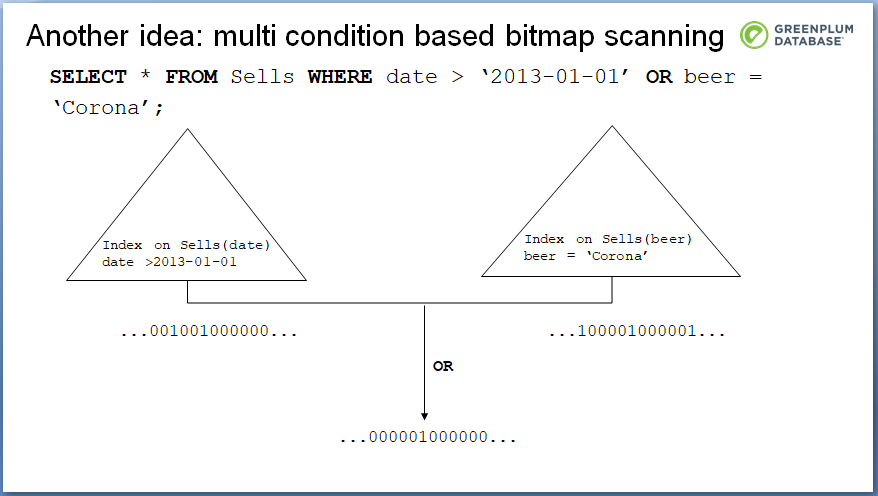
Другое решение, особенно если существует несколько условий, может заключаться в сканировании на основе битовых карт. В следующем примере есть индекс "date" и индекс "beer". Информация о каждом признаке может быть получена в соответствии с условиями запроса. На самом деле в растровой карте для них значится 1. Для получения конечной точечной карты, подлежащей сканированию с помощью операции AND, используется точечный рисунок, соответствующий двум условиям запроса. На основе сканирования по битовым картам файлы могут быть доступны в режиме последовательного доступа.
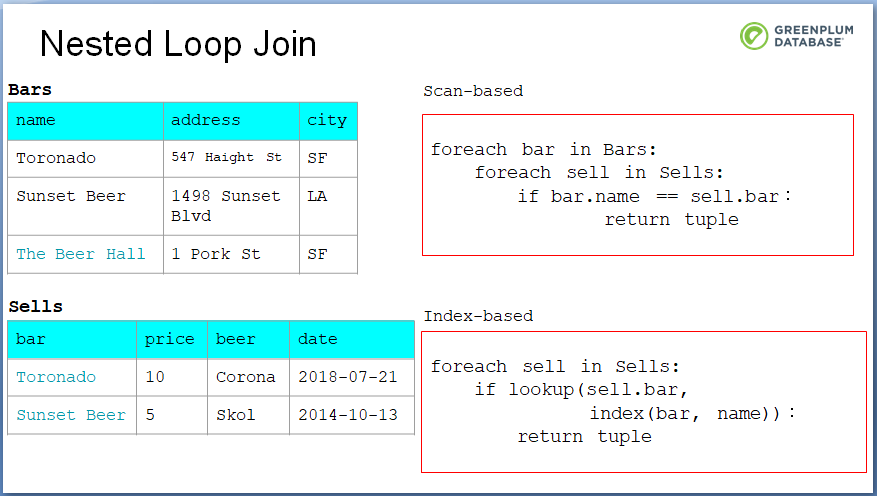
Существует три основных типа операций JOIN для кортежей в Greenplum. Первый - вложенные циклы, аналогичные ранее упомянутому хранилищу файлов, то есть два цикла накладываются для соответствия сканированию внутри и снаружи. Возможный вариант в данном случае заключается в следующем: вложенный цикл может использовать индексы вместо последовательных сканирований для того, чтобы сделать выполнение запроса более эффективным.
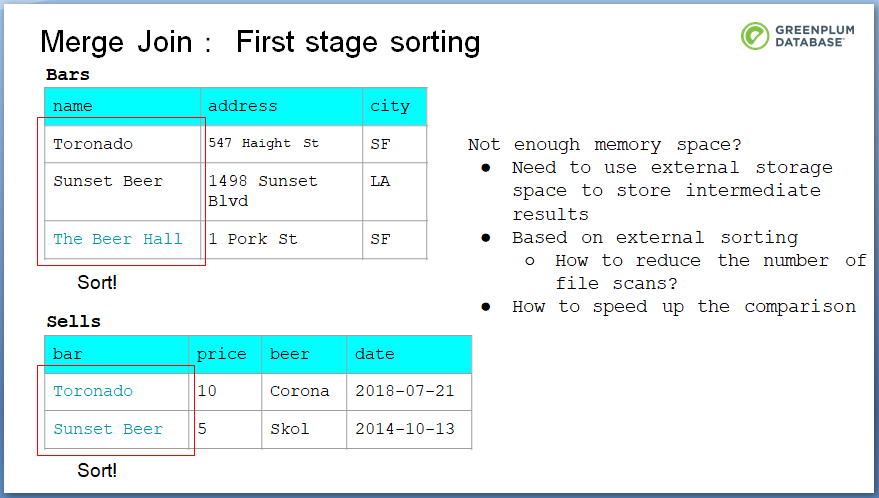
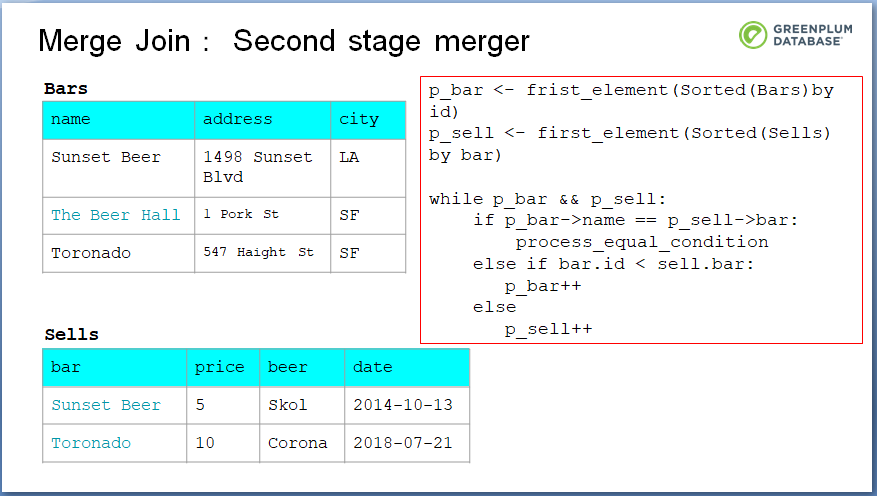
Второй возможный вариант - соединие слиянием, которое происходит в 2 стадии. Первый этап - сортировка кортежей в соответствии с условиями соединения. На втором этапе выполняется операция слияния, основанная на отсортированных кортежах.
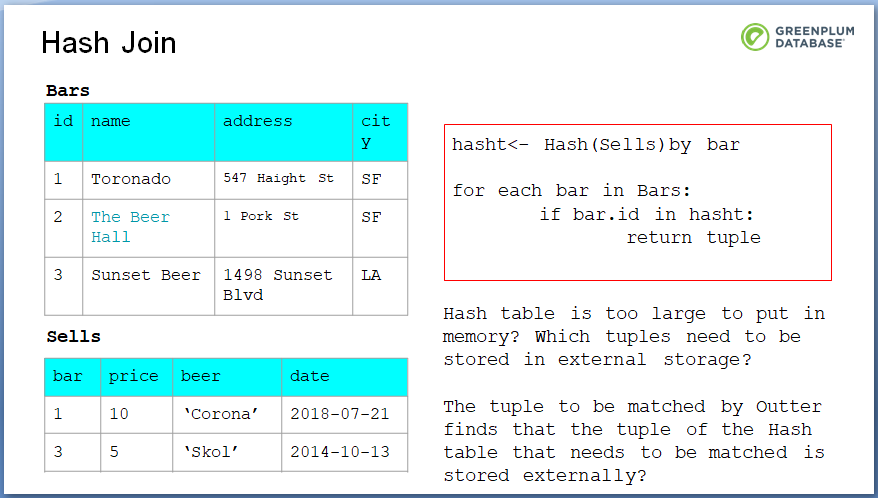
Третий вариант – хэш-соединение. При хеш-соединении одна таблица обычно используется в качестве таблицы ссылок, а другая (небольшая) - в качестве хэш-таблицы. Если хэш- таблица маленькая, она может быть сохранена в памяти. Во время каждого поиска таблица поиска сканируется, чтобы увидеть, есть ли совпадение в текущем кортеже в хэш-таблице. Если совпадение найдено, оно будет возвращено напрямую. Проблема в том, а что если хэш - таблица слишком велика? Какие узлы должны храниться во внешнем хранилище? Как работать с узлами хэш-таблиц, которые нужно сопоставить во внешней памяти? Мы узнаем ответы на все эти вопросы в прямом эфире 22 мая.
Транзакции и журналы
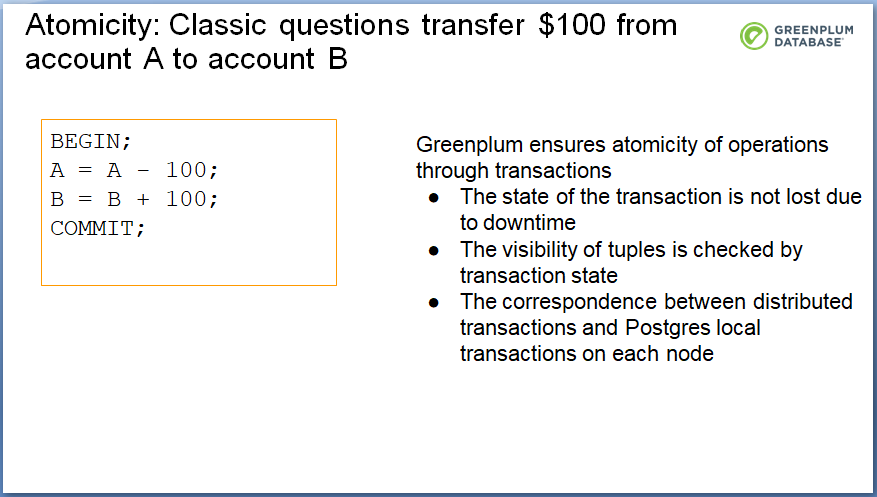
Если процесс Greenplum зависает в процессе изменения файлов, то как обеспечить согласованность данных? Классическая проблема, часто упоминаемая в курсах по базам данных: перевод 100 с счета А на счет В. Что будет, если после того, как счет А уменьшится на 100, система перезагрузится и заработает с ошибками, и счет В не увеличится на 100? В этом случае знайте, что Greenplum гарантирует атомарность операций.
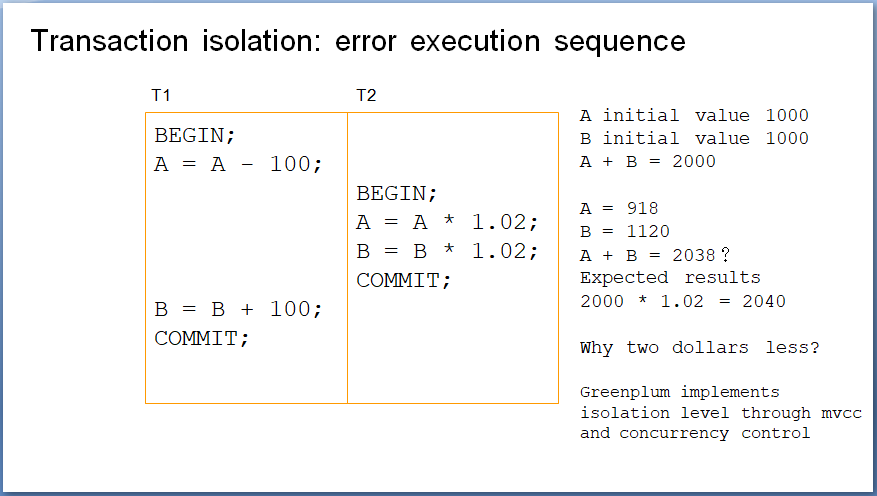
Другая проблема - это изоляция между транзакциями. Одна операция обрабатывает перевод, а другая операция поднимает процентную ставку на банковский счет (2%). Если трансферная операция и сделка с увеличением процентной ставки будут выполняться одновременно, то возникнут проблемы, и в конце концов Вы обнаружите, что у Вас не хватает 2 доллара! Использование изоляции транзакций может решить эту задачу. Эти и другие вопросы будут подробно рассмотрены в "Бизнес-темах" чуть позже.
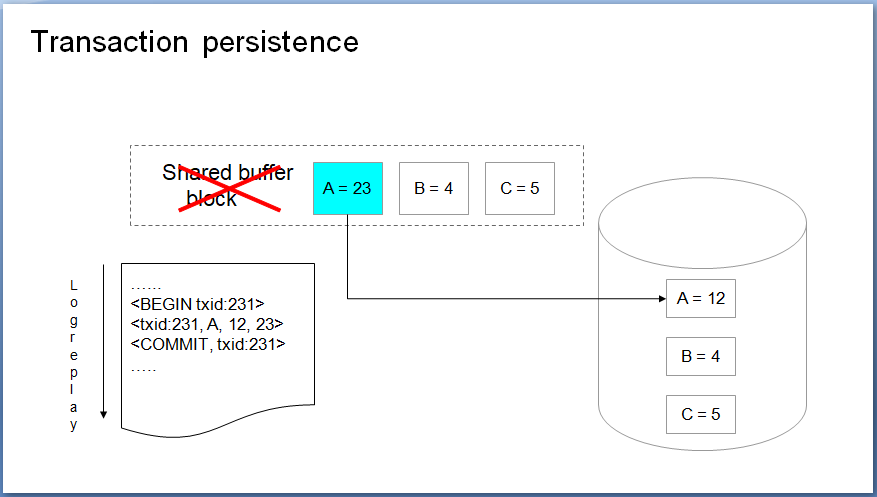
Каждый раз, когда записываются данные, сначала изменяется память, и только потом происходит запись на диск. В следующем примере А сначала изменяется на 23 в памяти. Если система зависнет, модификация А будет потеряна. При ее перезапуске Вы обнаружите, что А все еще равна 12, потому что модификация до сих пор не прошла. Функция журналов, предоставленная Greenplum может решить такие проблемы. Журнал подробно регистрирует весь процесс модификации базы данных. Доступ к регистрационным записям осуществляется последовательно и обеспечивает концепцию логической временной шкалы. В этом случае эффективность намного выше, чем случайный доступ к диску.
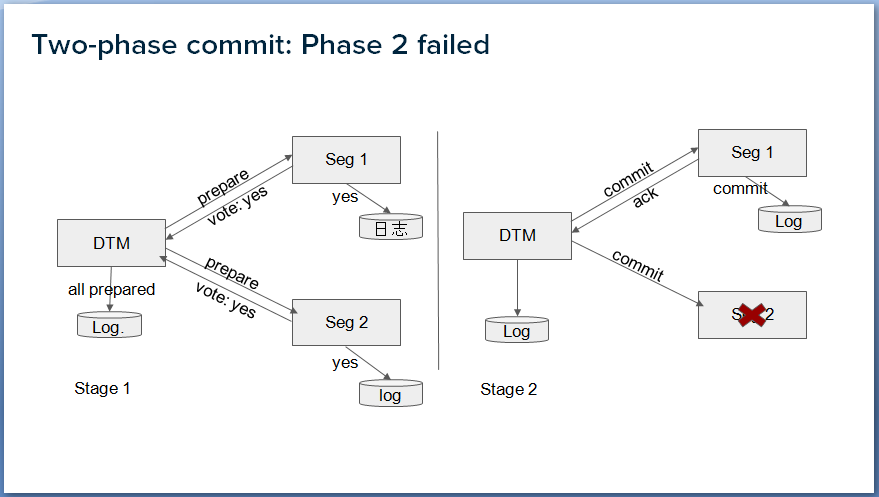
Как упоминалось ранее, в Greenplum данные существуют на нескольких сегментах, поэтому сначала убедитесь в том, что при записи данных все данные на сегментах должны быть записаны успешно. Неприемлемо то, что в случае частичного успеха возникает несогласованность данных. В данном случае крайне важен двухэтапный алгоритм представления данных.
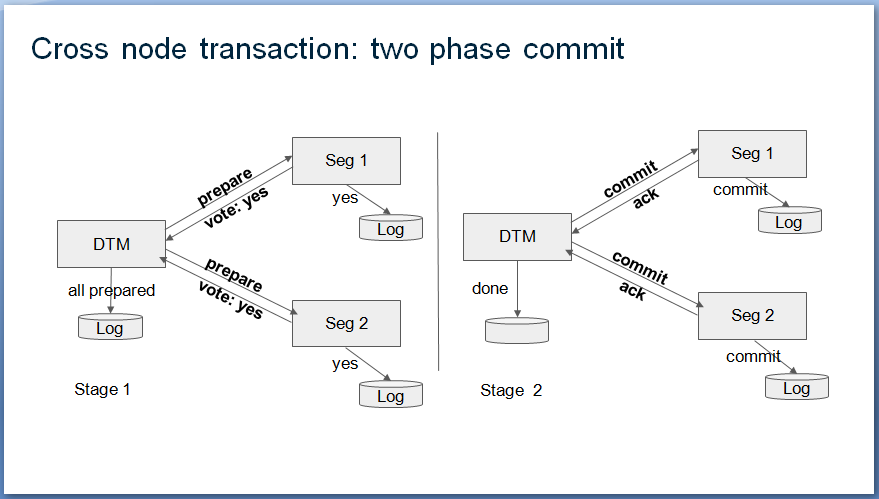
Разберемся в сложившейся ситуации:
- Первый случай - ошибка происходит на первом этапе, последующие операции должны быть откатаны назад только на втором этапе.
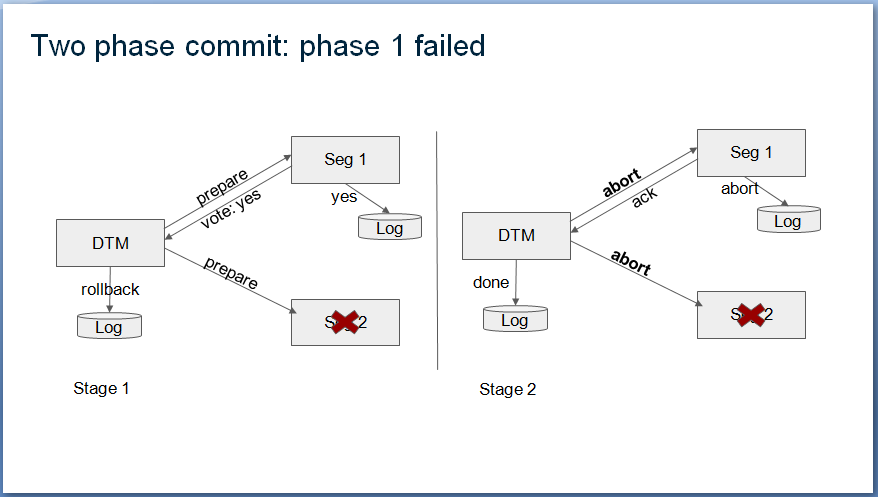
- Если все узлы ответили положительно на первом этапе, но во втором этапе возникла какая-либо проблема, менеджер DTM будет продолжать обращаться к неимпраному узлу до тех пор, пока он не ответит. Вся представленная информация будет сохранена в журнале DTM, информация о состоянии транзакции может быть восстановлена для выяснения того, что необходимо сделать дальше.
Если Вам нравится Greenplum и Вы хотите с ней работаит, рекомендуем начать с загрузки исходного кода Greenplum. Вы можете скачать Greenplum с Github. После загрузки компилируйте исходный код, включите информацию для отладки во время процесса компиляции и отключите оптимизацию.
После того, как исходный код будет загружен локально, Вы сможете выбрать свой любимый инструмент анализа и чтения исходного кода в соответствии со своими потребностями. Более важная структура каталогов в исходном коде показана на рисунке ниже, Вы можете проверить ее в соответствующей главе нашего live-курса.