

Таблицы Greenplum и компрессия
Greenplum создана для расширенных аналитических рабочих нагрузок. Независимо от того, составляет ли Ваш набор данных пять терабайт на горстке серверов или более чем петабайт на сотнях узлов, архитектура Greenplum позволяет легко масштабироваться для удовлетворения самых строгих требований касательно управления данными. Для работы с очень большими таблицами, измеряемыми миллиардами строк и организованными в логические разделы, Greenplum предоставляет ряд вариантов сжатия, которые необходимы для более эффективной организации хранения данных.

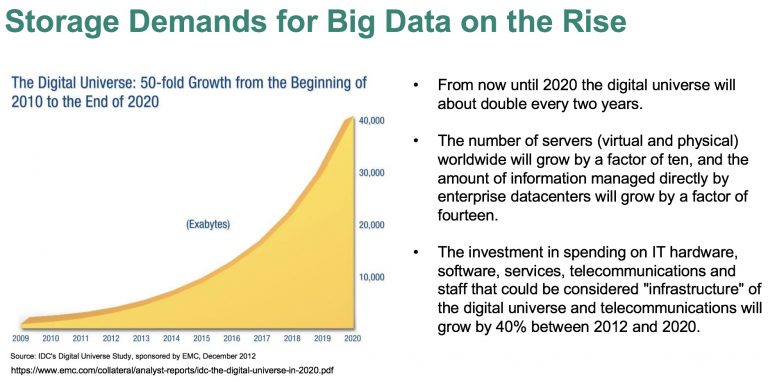
Эффективное использование имеющихся ресурсов хранения по-прежнему является одной из основных проблем для большинства администраторов баз данных, администраторов хранилищ и архитекторов данных. Количество данных неуклонно растет, вариантов их хранения много, и все же современные компании находятся в постоянном поиске оптимальных способов и инструментов эффективного управления и хранения этих огромных объемов информации.
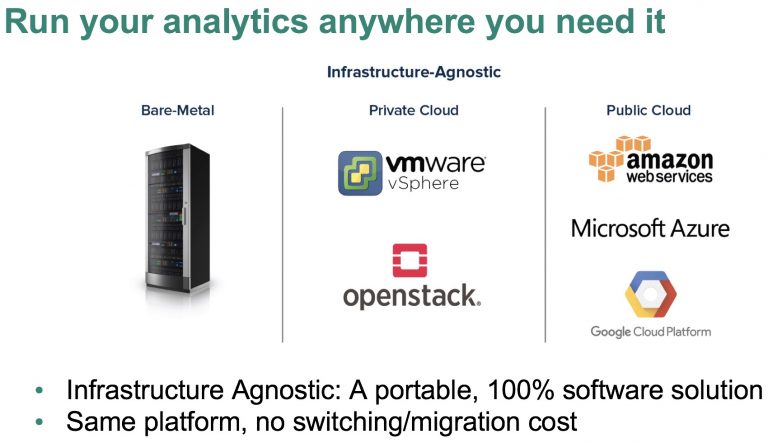
По сравнению с другими MPP базами данных, доступными сегодня, база данных Greenplum изначально была построена как программное обеспечение. Основные конструктивные особенности, которые включают в себя общую архитектуру shared nothing, высокоскоростную, программно-определенную сеть Interconnect и возможность загружать и выгружать данные непосредственно в отдельные сегменты базы данных и из них, достигая скорости загрузки в десятки терабайт в час, означает, что Greenplum действительно не зависит от инфраструктуры. Эта единая платформа с открытым исходным кодом работает как на серверах, развернутых на частных облаках, таких как VMware, и во всех трех основных провайдерах публичного облака: Amazon, Microsoft Azure и Google Cloud Platform (GCP).
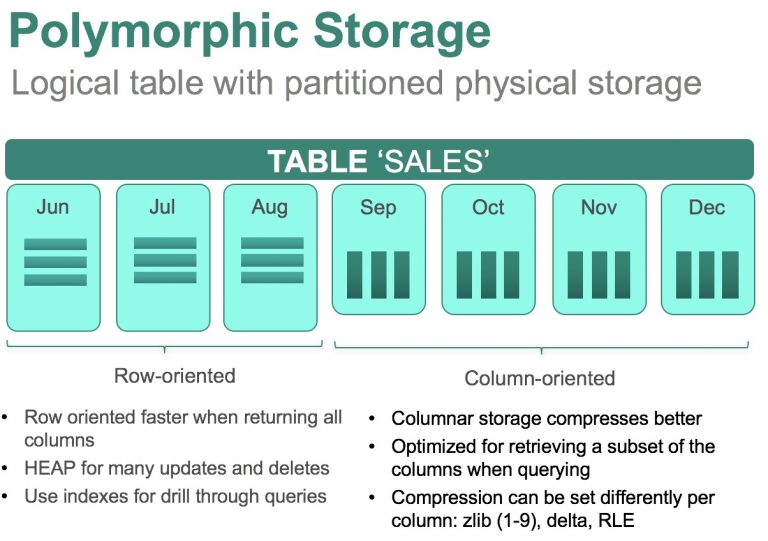
Традиционные реляционные базы данных ориентированы на строки, где все столбцы, составляющие отдельную запись, сгруппированы вместе на странице данных (или связанном наборе страниц) в одном файле данных. Поставщики баз данных обнаружили, что если отдельные значения для одного из столбцов были сохранены вместе в одном файле, где каждый столбец для таблицы имел свой собственный набор файла (файлов) для поиска операции запроса, база данных будет работать гораздо быстрее.
Некоторые новые базы данных, такие как Amazon Redshift предоставляют только колоночно-ориентированные варианты. Greenplum дает возможность работать как с колоночно-оринтированными системами, так и с решениями, ориентированными на строки, что означает, что архитектор данных может выбрать метод хранения таблиц, который лучше всего подходит именно для его случая. Кроме того, в отличие от таких продуктов как Redshift, Greenplum предлагает несколько способов логического разделения данных таблиц - либо по диапазону либо по списку значений, с возможностью создания многоуровневых разделов одной таблицы для оптимизации хранения данных и доступа к запросам.
Гибкость и мощность Greenplum буквально зашкаливает, каждый раздел одной таблицы может использовать свой собственный метод хранения и тип сжатия (zlib с различными уровнями, ориентированный столбец RLE и т.д.). Благодаря Greenplum у архитектора есть широкий спектр инструментов для создания платформы управления данными, которая хранит большие объемы данных, будь то локально, в облаке, или в сочетании обеих моделей развертывания.
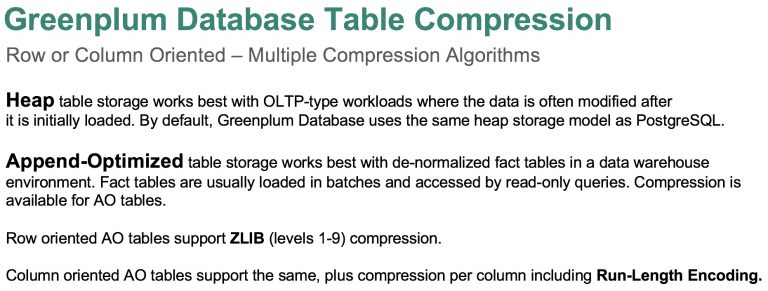
Внутренне информация может быть сохранена с использованием традиционной модели HEAP PostgreSQL, идеально подходящей для таблиц со стандартными изменениями данных (вставки, обновления, удаления). Эта модель работает очень хорошо для развертывания, когда исходные записи загружаются в Greenplum через метод ELT (extract-load-transform), уточняются и агрегируются в набор таблиц, которые затем хранятся в окончательной схеме базы данных, используемой для аналитических запросов.
Оптимизированная модель таблиц идеально подходит для данных, загружаемых в больших партиях и редко, если вообще, обновляемых или удаляемых после первоначальной фиксации в таблице. Эта модель также предлагает самый широкий спектр методов хранения: ориентированный на строки и колонки, с рядом вариантов сжатия, которые будут применяться на уровне строк, а также на отдельных столбцах в таблице. Для максимальной гибкости в хранении данных архитекторы данных могут сочетать оптимизированную конструкцию, ориентированную на столбики, с различными методами сжатия данных по каждому столбу в определении таблицы.
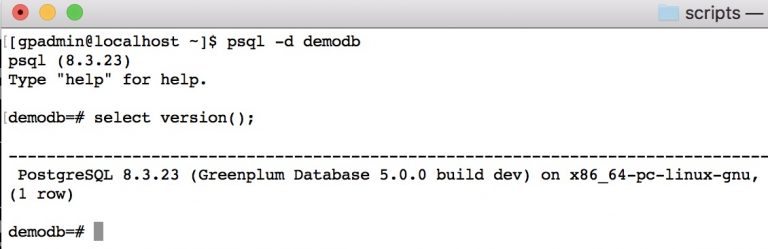
Чтобы наглядно продемонстрировать полезность и гибкость добавляемых таблиц, я создал демо-базу данных в Open Source Greenplum 5.2.0, работающую на виртуальной машине CentOS 7.
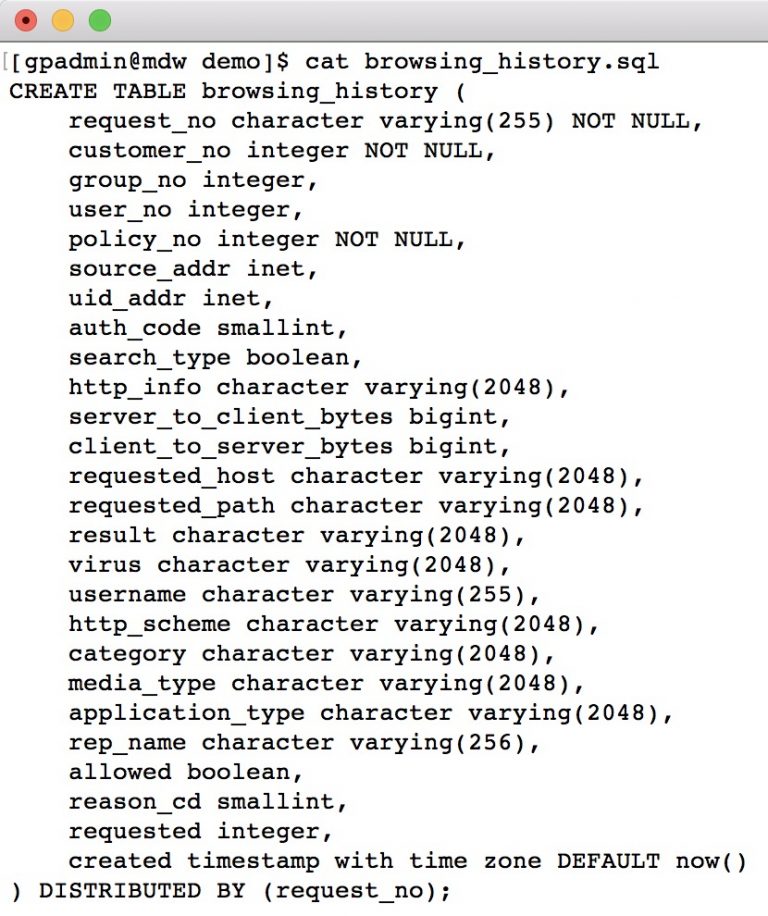
Тестовые данные были сгенерированы для таблицы под названием browsing_history, которая использует метод хранения HEAP по умолчанию, распределенный по колонке request_no. Данный тип таблиц ориентирован на строки. Таблица содержит ряд типов данных, включая целые числа, вариации символов, временные метки и inet.
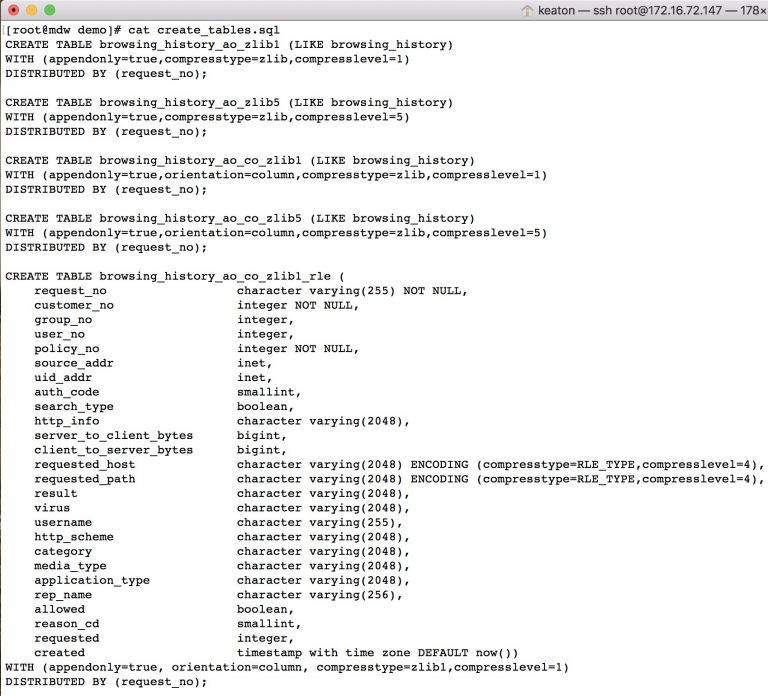
После создания таблицы в базе данных я запустил вышеуказанный сценарий для построения различных таблиц, оптимизированных для добавления, на основе таблицы browsing_history. Определения включают два уровня сжатия zlib (1 и 5), ориентированные на строки и столбы, а также таблицу, ориентированную на колонки, сжатую с помощью библиотеки zlib (уровень 1), с конкретными RLE и параметрами сжатия для столбцов requested_host и requested_path.

После создания таблиц данные из browsing_history были скопированы в каждую таблицу AO. Для оптимального использования кодовых значений длины выполнения (RLE) по колонке данные сортировались по запросу, когда они загружались.

Для просмотра результатов был запущен скрипт, призванный вернуть размер отношений каждой таблицы. Для хранения набора данных оригинальная таблица HEAP, browsing_history, требует 61 ГБ дискового пространства. Из-за повторения значений строк в моих тестовых данных сжатие, достигнутое в добавленной таблице zlib (1), требовало всего 3,2 ГБ места на диске.
Ещё более значительное снижение хранения наблюдается в случае, когда таблица ориентирована на столбец с сжатием zlib (1), требующим всего 706 Mб для хранения всех строк. Для того же набора данных, который находится в browsing_history, требования к хранению этой таблицы AO составляют всего 330 МБ.


