

Greenplum как ядро корпоративной платформы данных: опыт построения высоконагруженного хранилища в финансовом секторе
В этой статье мы хотим поделиться с вами кейсом реализации и эксплуатации хранилища данных на основе Greenplum в одной из крупнейших финансовых организаций России. Этот опыт уникален не только объемами обрабатываемой информации, но и глубокой проработкой архитектурных и эксплуатационных вопросов, которые критически важны для любого предприятия, работающего с большими данными.
История этого проекта началась несколько лет назад, когда стало очевидно, что существующее решение на базе SAS перестало справляться с растущими объемами информации и усложняющимися аналитическими задачами. Единый сервер обработки и система хранения данных СХД стали узким местом, ограничивающим развитие data-направления компании. Требовалось принципиально новое, горизонтально масштабируемое решение, способное стать надежным фундаментом для бизнес-аналитики, отчетности и машинного обучения.
После тщательного анализа рынка был выбран Greenplum — MPP (Massively Parallel Processing) база данных с открытым исходным кодом, основанная на PostgreSQL. Ключевыми факторами выбора стали высокая производительность, возможность линейного масштабирования и знакомость SQL-синтаксиса для команды. Как показало время, это решение оказалось стратегически верным, особенно с учетом последующего перехода продукта в категорию Open Source, что обеспечило независимость от вендора и долгосрочную стабильность платформы.
Принцип работы Greenplum заслуживает отдельного внимания, так как понимание его архитектуры критически важно для эффективного использования. Пользовательский запрос поступает на мастер-узел, который выступает в роли координатора. Мастер разбирает запрос, формирует план выполнения и распределяет задачи между сегментами — специализированными инстансами PostgreSQL, каждый из которых обрабатывает свою часть данных. Это классическая shared-nothing архитектура, где каждый узел независим и обладает своими вычислительными ресурсами и дисковым пространством. После обработки данные со всех сегментов возвращаются на мастер, где происходит финальная агрегация, сортировка и отправка результата клиенту. Такой подход позволяет эффективно распределять нагрузку и обрабатывать огромные объемы информации за счет параллелизма.
Однако сама по себе технология — лишь инструмент. Настоящая ценность заключается в том, как ее встроить в экосистему компании, адаптировать под конкретные бизнес-процессы и обеспечить надежную эксплуатацию. Именно об этом практическом опыте мы и хотим рассказать.
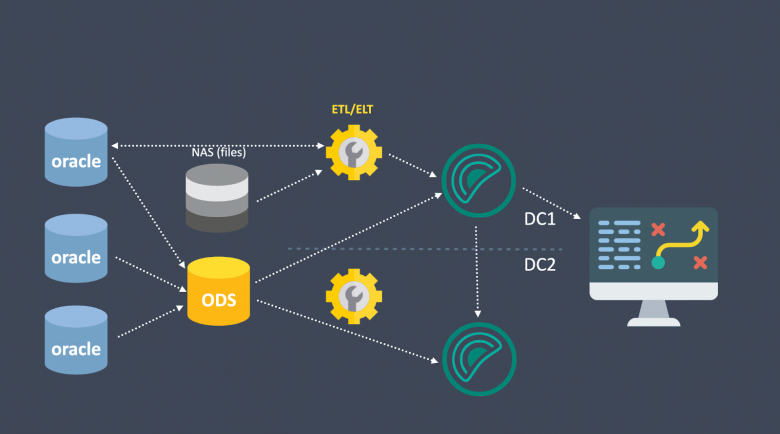
Эволюция репликации данных: от коммерческих инструментов к собственной CDC-системе
Одной из первых и самых сложных задач стала организация бесперебойного потока данных из операционных систем в хранилище. Изначально для репликации изменений использовался продукт Attunity Replicate.
Attunity Replicate (теперь часть Qlik Replicate) — это мощный инструмент для репликации данных в реальном времени, поддерживающий широкий спектр источников и целевых систем.
На начальном этапе он устраивал команду, но с ростом нагрузки проявились его системные недостатки, критичные для продуктивной среды.
Главной проблемой Attunity был построчный режим работы. В случае сбоя при применении обновления система переходила к построчной обработке, что абсолютно неприемлемо для Greenplum и приводило к катастрофическому падению производительности. Другими значимыми минусами были отставание репликации при пиковых нагрузках на источник, необходимость полной перезагрузки таблицы при любом изменении DDL, чрезмерная нагрузка на дисковую подсистему Greenplum и работа на платформе Windows, что не соответствовало общей Linux-ориентированной инфраструктуре компании.
Осознав эти ограничения, команда приняла решение о разработке собственной системы Capture Data Change. Ключевыми требованиями к новой системе стали:
- Снижение нагрузки на приемники за счет батчевой обработки с регулируемым размером и возможностью пауз, например, для проведения ETL-процедур.
- Автоматическое применение изменений схемы данных DDL, чтобы исключить ручное вмешательство и связанные с этим ночные инциденты.
- Легкость масштабирования без необходимости развертывания дополнительных серверов репликации.
- Полная интеграция в Linux-экосистему компании.
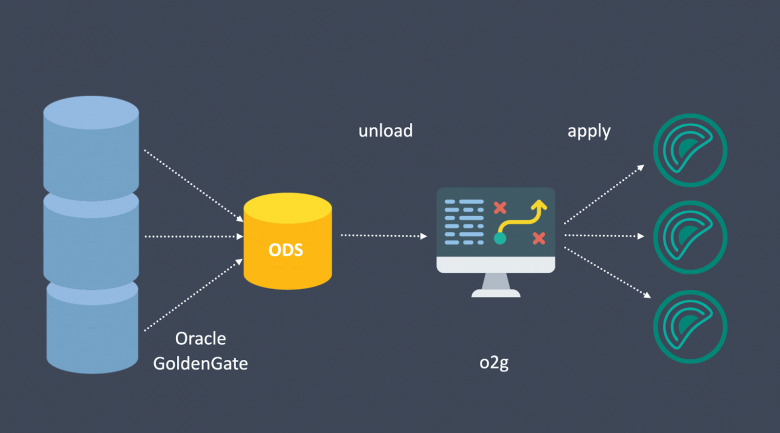
Реализованное решение представляет собой гибридную архитектуру. На начальном этапе для консолидации данных из десятков источников Oracle используется Oracle GoldenGate. Данные поступают в операционный слой данных ODS, откуда с помощью самописных библиотек выгружаются во временные файлы. Далее специальные процессы аккуратно применяют эти данные батчами во все кластеры Greenplum с оптимальными настройками размера и частоты. Это позволило добиться лага репликации не более двух часов для самых критичных данных при объеме хранимой информации свыше 150 ТБ.
Disaster Recovery: построение отказоустойчивой архитектуры для аналитического хранилища
Для бизнеса, критически зависимого от данных, недоступность аналитического хранилища сравнима с остановкой операционной деятельности. Штатные механизмы отказоустойчивости Greenplum, такие как зеркалирование сегментов, защищают от отказа отдельных серверов, но бессильны против катастрофы на уровне всего дата-центра. Требовалось решение для аварийного восстановления всего кластера в другом ЦОД.
Внутренняя система DUET стала ответом на этот вызов. Ее эволюция от первой до третьей версии — это наглядный пример адаптации инфраструктуры к взрывному росту данных и усложнению архитектуры.
Первая версия DUET столкнулась с проблемой производительности NFS-хранилищ, используемых для бэкапов. Команда перешла на схему с локальными SAS SSD-дисками на каждом сервере с последующей синхронизацией между кластерами через SCP. Резервные копии сохранялись в распределенной файловой системе LizardFS. Однако эта версия все еще имела недостатки: отсутствие инкрементальных копий, перенос целых таблиц вместо партиций и использование утилит, блокирующих фоновые операции VACUUM.
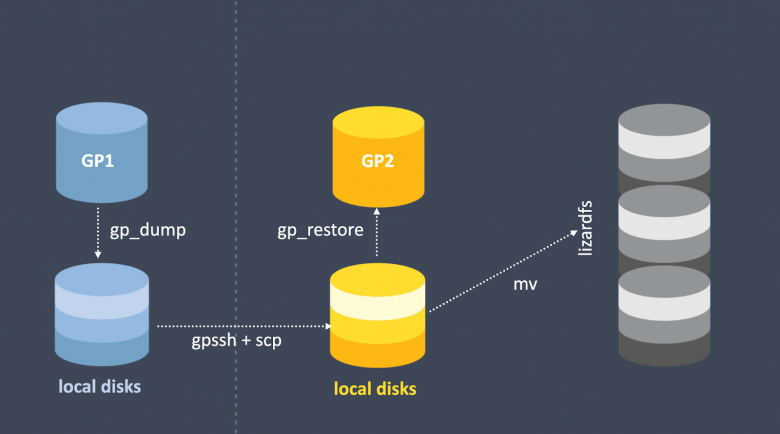
DUET2 принесла с собой полноценное REST API, запись бэкапов напрямую в LizardFS и переход на более эффективный механизм COPY ON SEGMENT. Это позволило увеличить объем переноса данных до 70 ТБ.
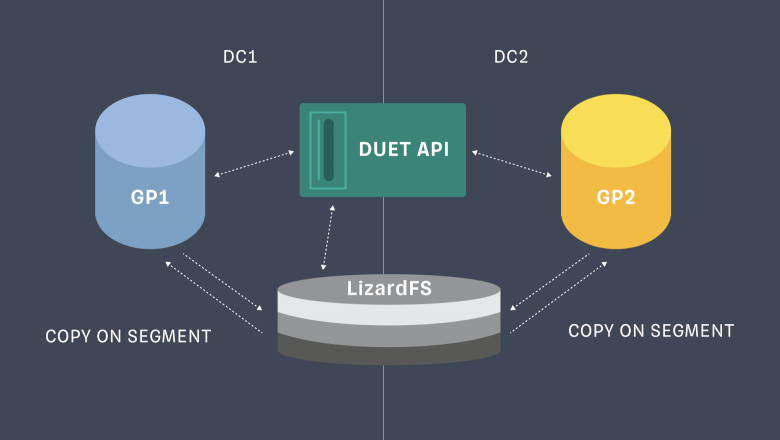
Современная версия, DUET3, была создана в условиях, когда количество кластеров Greenplum выросло до восьми, и полный перенос данных стал непозволительной роскошью. Ключевым нововведением стала поддержка инкрементальных обновлений. ETL-процессы были доработаны для записи изменений в специальные diff-таблицы, партицированные по дням. DUET отслеживает эти изменения и переносит только дельты данных, накатывая их на резервные кластеры. Система автоматически отслеживает целостность цепочек обновлений full + diff и при необходимости инициирует полный перенос таблицы. Сегодня DUET ежедневно обрабатывает около 200 ТБ данных, обеспечивая задержку между обновлением в основном ETL-кластере и его доступностью в резервных контурах не более 30 минут.
Практические уроки эксплуатации: как избежать типичных ошибок и рисков
Многолетняя эксплуатация Greenplum в высоконагруженной среде позволила сформулировать набор критически важных практик, несоблюдение которых ведет к серьезным проблемам с производительностью и стабильностью.
Во-первых, всегда помните о том, что равномерное распределение данных — основа производительности MPP-системы.
Архитектура shared-nothing означает, что общая скорость выполнения запроса определяется скоростью самого медленного сегмента. Неправильный выбор ключа распределения distribution key приводит к data skew — перекосу данных, когда один сегмент оказывается перегружен, а другие простаивают. Это не только замедляет выполнение запросов, но и создает риск исчерпания дискового пространства на отдельных узлах. Риск: Выбор неподходящего ключа распределения, например, поля с низкой кардинальностью пол, статус, который гарантированно создаст перекос. Решение: Использовать составные ключи из полей с высокой кардинальностью, таких как идентификаторы, и постоянно мониторить распределение данных по сегментам.
Во-вторых, будьте осторожны с NULL в ключах соединений.
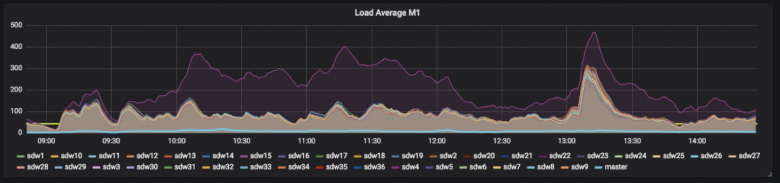
При JOIN-запросах все строки с NULL в ключе распределения попадают на один и тот же сегмент. Это создает точечную нагрузку, что мы наглядно видели на графиках мониторинга, где один сервер стабильно уходил в пик нагрузки. Риск: Массовое использование запросов, соединяющих таблицы по полям, содержащим NULL. Решение: Рекомендовать пользователям фильтровать NULL-значения перед соединением или использовать условия COALESCE для замены NULL на нейтральное значение, если логика приложения это позволяет.
В – третьих, контролируйте spill-файлы.
Spill-файлы — это временные данные, которые записываются на диск, когда операция не помещается в оперативную память. Изначально неконтролируемое образование этих файлов приводило к падению кластера. Проблема усугублялась несоответствием размера блоков файловой системы и типичного размера spill-файлов. Решение включало в себя тонкую настройку параметров базы, ограничивающих объем и количество spill-файлов на запрос и сегмент, а также использование файловой системы XFS с оптимизированным под нагрузку Greenplum размером блока. Риск: Разработчики и аналитики, не знакомые со спецификой MPP, пишут "тяжелые" запросы, которые, не умещаясь в память, лавинообразно создают spill-файлы, парализуя дисковую подсистему. Решение: Внедрение систем мониторинга и автоматического убивания запросов, превышающих лимиты по spill-файлам.
В – четвертых, минимизируйте частые операции с метаданными.
Клиентские инструменты, не предназначенные специально для Greenplum, часто настроены на частую синхронизацию метаданных. В большой системе с десятками тысяч объектов это генерировало сотни тысяч легких, но частых запросов к системным каталогам, создавая фоновый шум и бесполезную нагрузку. Риск: Использование стандартных коннекторов и BI-инструментов "из коробки" без отключения автообновления метаданных. Решение: Централизованно отключить эту функцию и организовать процесс обновления метаданных по расписанию или по требованию.
В-пятых, не забывайте, что постоянное обучение пользователей — инвестиция в стабильность.
Самая большая ошибка — считать, что пользователи понимают разницу между PostgreSQL и Greenplum. Классический пример: пользователь выгружал 60 ГБ данных в один поток через мастер-узел, занимая критичные ресурсы и замедляя работу всей системы. После консультации он перешел на использование утилиты gpfdist, которая позволяет проводить выгрузку параллельно через сегменты, сократив время операции с 4 часов до 40 минут и сняв нагрузку с кластера. Риск: Пользователи, работающие с Greenplum как с "большим Postgres", неосознанно создают неоптимальные нагрузки. Решение: Создание внутренней базы знаний, проведение регулярных дайджестов с разбором "плохих" запросов, разработка вводных курсов и создание выделенной команды Data Partners для консультирования коллег.
В заключении хотелось бы отметить, что Greenplum доказал свою эффективность в качестве ядра крупной корпоративной платформы данных, способной обрабатывать петабайтные объемы информации. Его сила — не только в производительности, но и в гибкости, предоставляемой open-source моделью, и в надежности, унаследованной от PostgreSQL.
Однако успешная реализация такого проекта определяется не столько выбором технологии, сколько грамотной интеграцией ее в IT-ландшафт компании. Ключ к успеху — это построение вокруг СУБД целого комплекса вспомогательных систем репликации, резервного копирования, мониторинга и, что не менее важно, формирование культуры работы с данными среди всех пользователей платформы. Только такой, комплексный подход позволяет превратить мощный инструмент в реальное конкурентное преимущество для бизнеса.


