

Greenplum от Vmware – это векторная база, отлично подходящая для аналитики Ваших данных
Введение
Greenplum 7 - важная веха в истории развития Greenplum, поддерживающая множество новых расширений для AI/ML, таких как pgvector и postgresML.
Модуль pgvector предоставляет возможности поиска векторного сходства, которые позволяют искать, хранить и запрашивать встраивания в больших масштабах. Этот модуль для Greenplum эквивалентен версии модуля pgvector 0.5.0, используемого с PostgreSQL. Модуль pgvector предоставляет тип данных vector и методы доступа к индексу ivfflat и hnsw.
Более подробную информацию Вы найдете здесь: https://docs.vmware.com/en/VMware-Greenplum/7/greenplum-database/relnotes-release-notes.html
Это усовершенствование органично дополняет существующие возможности Greenplum, обеспечивая поддержку неструктурированных данных в хранилище данных с помощью векторных вкраплений. Оно расширяет возможности data federation, обеспечивая беспрепятственный запрос к различным базам данных и хранилищам данных, возможности для получения данных в реальном времени из Kafka и RabbitMQ, а также геопространственную аналитику с помощью PostGIS и текстовую аналитику с помощью полнотекстового поиска и GPText (построенного на базе Apache SolR).
Этот и без того обширный функционал теперь дополнен широким спектром возможностей ML, включая поддержку Python, R, расширения MADlib и контейнеров.

В этой статье мы расскажем о революционном влиянии pgvector на Greenplum и изучим новые горизонты, которые он перед нами открывает.
Кроме того, мы докажем, что Greenplum от VMware – отличный вариант для компаний, которым нужно современное хранилище данных или платформа, оснащенная возможностями векторного поиска.
pgvector — расширение PostgreSQL, предоставляющее возможности векторного поиска
pgvector - это открытое расширение PostgreSQL, решающее задачу поиска схожих векторов. Оно подходит для работы с высокоразмерными данными, особенно в таких приложениях, как системы рекомендаций, поиск изображений и обработка естественного языка.
Многие AI-приложения требуют нахождения похожих элементов или рекомендаций на основе поведения пользователя или сходства контента.
pgvector может выполнять эффективные поиски сходства векторов, что делает его подходящим для систем рекомендаций, контент-ориентированной фильтрации и задач AI на основе сходства.
Расширение pgvector привносит новые возможности в PostgreSQL, превращая ее в векторную базу данных. Это особенно ценно для разработчиков, стремящихся создавать новые AI-приложения, оснащенные функцией поиска схожих векторов, сохраняя при этом соответствие ACID объектно-реляционной базы данных, такой как PostgreSQL.
Универсальность и эффективность векторных баз данных делают их незаменимыми для самых разных приложений:
- NLP: Слова или предложения преобразуются в векторы, улавливающие семантическое значение. При создании текста, похожего на человеческий, модели должны быстро сравнивать и извлекать соответствующие внедрения, гарантируя, что сгенерированный текст сохраняет контекстуальные значения. Аналогичным образом, при генерации изображений или звука встраивания играют решающую роль в кодировании шаблонов и функций. Чтобы эти модели функционировали оптимально, им требуется база данных, которая позволяет мгновенно находить похожие векторы, что делает базы данных векторов важным компонентом головоломки генеративного ИИ;
- Поиск и распознавание изображений: обратный поиск изображений, обнаружение объектов и распознавание лиц;
- Системы рекомендаций: Векторизация текста используется для анализа предпочтений пользователей и их интересов на основе их поисковых запросов, просмотренного контента и написанных отзывов. Это позволяет создавать персонализированные рекомендации, например, в онлайн-ритейле или на стриминговых сервисах.
VMware Greenplum + pgvector = векторная база для продвинутой аналитики данных
Благодаря возможностям векторных баз, реализованным в расширении pgvector, Greenplum делает гигантский скачок вперед, позиционируя себя как уникальное хранилище данных и отличную векторную базу данных для продвинутой аналитики данных.
Однако Вы можете совершенно обоснованно задать вопрос: "Действительно ли Greenplum соответствует всем критериям надежной и проверенной векторной базы данных?"
Векторная база данных — это база данных, предназначенная для хранения векторных внедрения и управления ими, которые являются математическими представлениями данных в высокомерном пространстве. В этом пространстве каждое измерение соответствует признаку данных, а для представления сложных данных можно использовать десятки тысяч измерений. Позиция вектора в этом пространстве представляет свои характеристики. Слова, фразы или целые документы, изображения, аудио и другие типы данных могут быть векторизированы. Эти векторные внедрения используются в поиске сходства, многомодальном поиске, подсистемах рекомендаций, моделях больших языков (LLM) и т. д.
Таким образом, продвинутая векторная база данных, в идеале должна включать в себя:
- Хранилище векторов;
- Поиск векторного сходства;
- Индексирование;
- Скорость;
- Надежность (отказоустойчивость и доступность);
- Распределенная архитектура;
- Масштабируемость и производительность

Учитывая эти требования, давайте посмотрим, как Greenplum соответствует каждому из них:
1. Хранилище векторов (хранение векторов и эмбеддингов):
Модуль pgvector устанавливается при установке базы данных Greenplum. Но, прежде чем использовать его типы данных и метод доступа к индексу, надо зарегистрировать расширение vector в каждой базе данных:
CREATE EXTENSION vector;
Создайте таблицу tblvector с столбцом embedding типа vector(3) , представляющего трехмерный вектор:
CREATE TABLE vectors_table (
      id BIGSERIAL PRIMARY KEY,
      embedding VECTOR(3)
);
После создания внедрения с помощью службы, такой как API OpenAI, можно сохранить полученный вектор в базе данных. Определение вектора в виде vector(3) обозначений [x,y,z] coordinates в трехмерной плоскости. Команда вставляет пять новых строк в tblvector таблицу с предоставленными внедрениями:
INSERT INTO vectors_table (embedding) VALUES ('[1,2,3]'), ('[4,5,6]');
Эта команда вставляет две новые строки в таблицу vectors_table с соответствующими эмбеддингами.
2. Поиск векторного сходства
Чтобы получить векторы и вычислить сходство, используйте SELECT и встроенные операторы векторов:
SELECT * FROM vectors_table ORDER BY embedding <-> '[3,1,2]' LIMIT 5;
Этот запрос вычисляет Евклидово расстояние (L2) между заданным вектором и векторами, хранящимися в tblvector таблице, сортирует результаты по вычисляемого расстояния и возвращает ближайшие пять наиболее похожих элементов.
pgvector представлен шестью операторами, которые можно использовать для векторов, в частности:
|
<#> |
внутренний продукт |
|
<=> |
косинус расстояние |
3. Индексирование
Индексирование является отличным средством повышения производительности запросов. Индексы упорядочивают данные таблиц, оптимизируя время поиска данных.
В расширении есть 2 индекса, в частности IVFFlat:
CREATE INDEX ON vectors_table USING ivfflat (embedding vector_l2_ops) WITH (lists = 100);
IVFFlat ищет подмножество этих списков, наиболее близкое к вектору запроса.
4. Скорость
Интеграция расширения pgvector расширяет возможности Greenplum по векторному семантическому поиску.
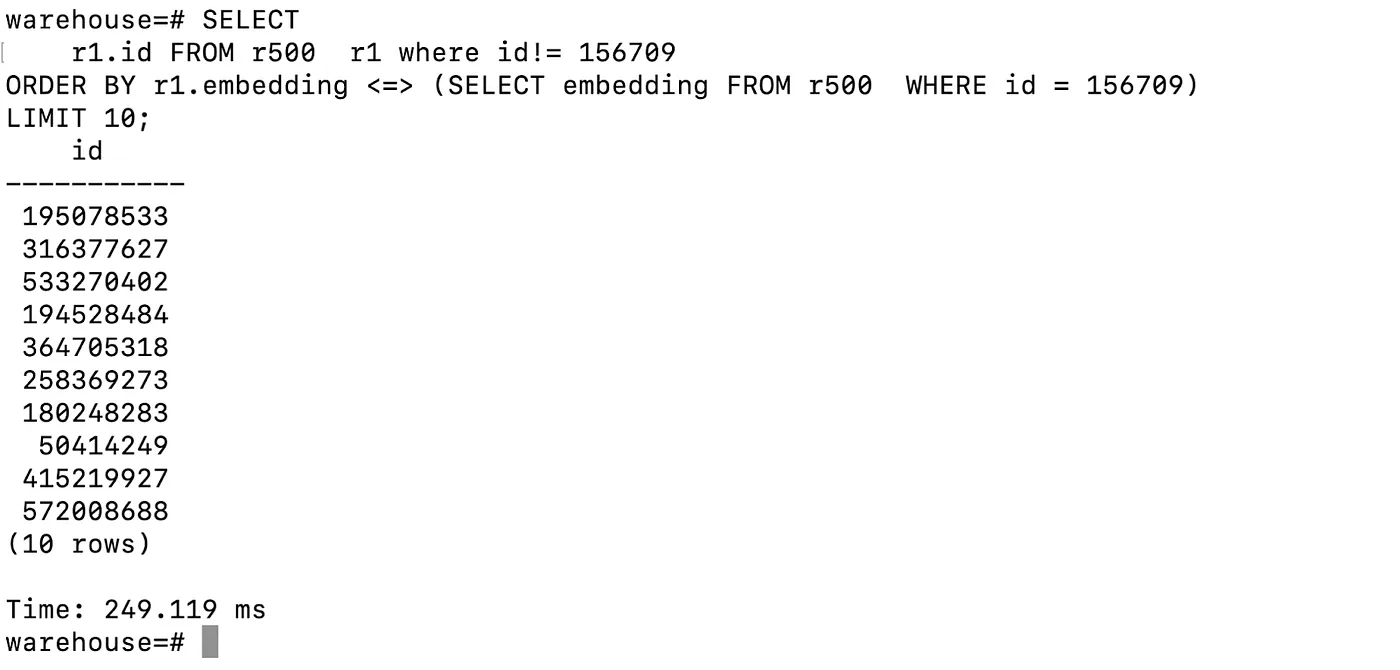
Многоэтапное тестирование производительности, проведенное в нашем кластере Greenplum, включающем три сегментных хоста на вычислительных движках GCP стандарта c2-standard-16c, дало ошеломляющие результаты.
Нам понадобилось 250 миллисекунд для косинусного поиска в Greenplum по векторной таблице, содержащей 500 миллионов строк, каждая из которых имеет 512 измерений!
5. Надежность (отказоустойчивость и доступность):
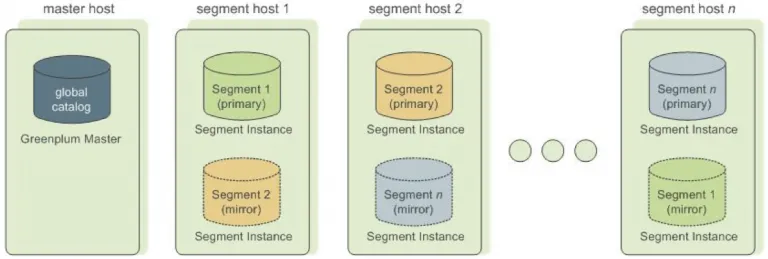
Хранилище данных Greenplum - это надежная система, в которой реализовано автоматическое обнаружение сбоев и возможность самовосстановления:
- Отказоустойчивость и балансировка нагрузки: зеркалирование обеспечивает автоматическое восстановление после сбоев, при котором, если основной сегмент становится недоступным, трафик может быть перенаправлен на зеркальный сегмент. Такая балансировка нагрузки гарантирует, что запросы и рабочие нагрузки продолжат обрабатываться даже во время сбоев;
- Улучшенная целостность данных: зеркалирование повышает целостность данных, предоставляя вторую копию данных. Это помогает выявить и устранить несоответствия или ошибки, которые могут возникнуть в основной копии. Даже если одна копия данных будет нарушена, зеркальная копия останется нетронутой.
6. Распределенная архитектура
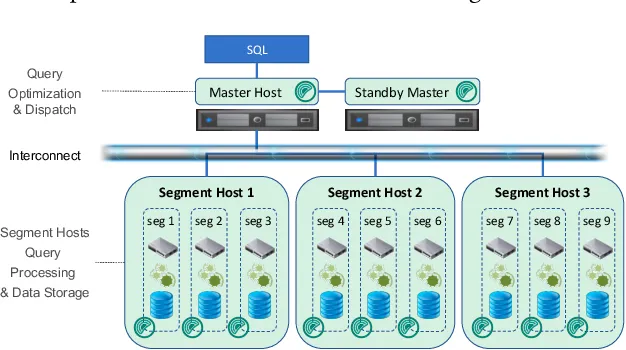
Greenplum – это типичный представитель распределенной массивно-параллельной архитектуры (MPP, Massive Parallel Processing) на основе PostreSQL для управления крупномасштабными аналитическими хранилищами данных. Greenplum реализует концепцию «Shared Nothing», когда узлы кластера, которые взаимодействуют для выполнения вычислительных операций, не разделяют ресурсы: каждый из них имеет собственную память, операционную систему и жесткие диски. Благодаря этому MPP-базы эффективно распараллеливают нагрузку на выполнение аналитических запросов к многотерабайтным хранилищам данных.
7. Масштабируемость и производительность
Greenplum предлагает высокую масштабируемость, позволяя расширяться с добавлением дополнительных узлов или серверов. Это обеспечивает линейное масштабирование производительности. Система спроектирована для эффективной работы с большими объемами данных, поддерживая как горизонтальное (добавление узлов), так и вертикальное (увеличение ресурсов на одном узле) масштабирование. Высокая производительность достигается за счет параллельной обработки запросов и эффективной работы с кэшем и памятью.
Заключение
В этой статье мы не только поговорили о впечатляющих технологических возможностях Greenplum, но и подробно рассмотрели расширение pgvector. Все это в совокупности делает данную СУБД отличным вариантом для компаний, стремящихся усовершенствовать свои платформы данных.
Являясь современным хранилищем данных и векторной базой данных, Greenplum предлагает своим пользователям непревзойденный набор функций, включающий в себя векторное хранилище, молниеносную производительность запросов, отказоустойчивость, масштабируемость и многое другое.
В условиях постоянно развивающегося ландшафта аналитики данных Greenplum не только отвечает, но и во многом превосходит требования современных компаний, стремящихся к расширенным аналитическим возможностям. Интеграция с расширением pgvector выводит ее на совершенно новый уровень.


