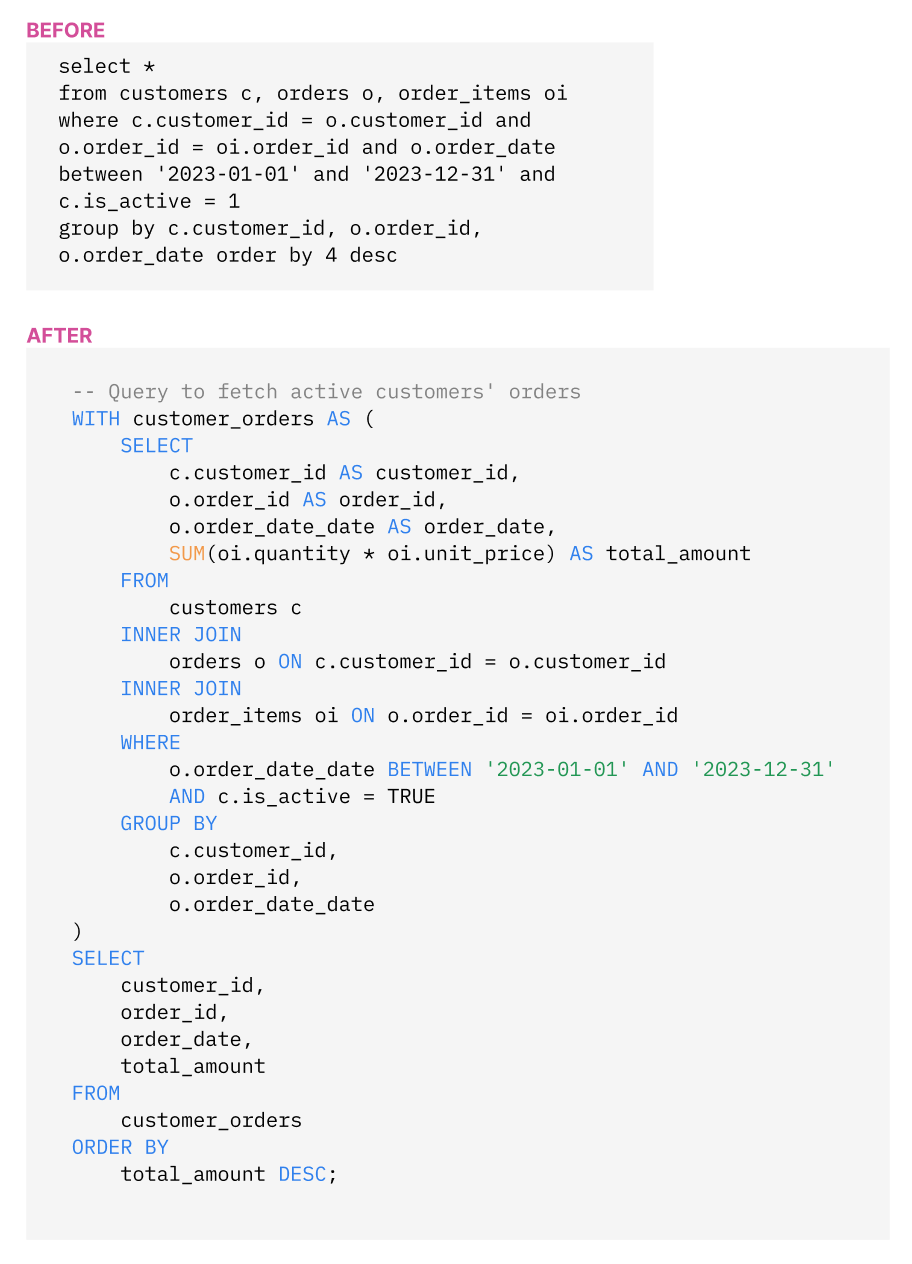
Хотите работать с запросами SQL как профи? - часть 2
Авторство - совместная коллаборация Анастасии Кузнецовой и Дмитрия Аношина.
Представляем Вашему вниманию 2 часть большой статьи, посвященной тонкостям эффективной работы с SQL, которую мы написали совместно с Дмитрием Аношиным, опытным дата-инженером и создателем сообщества Surfalytics.
Часть 1: Хотите работать с SQL как профи?
Документация и введение в курс дела
В настоящее время каждой команде нужен онбординг. Представьте, что у Вас появился новый ноутбук и Вам нужно подключить все сервисы, которыми Вы пользовались ранее.
Существует множество способов внедрения новых сотрудников, такие как приветственные письма, списки TO DO и так далее. Но когда мы говорим о коде и о приложениях, которые требуют использования IDE, лучше держать все рядом с самим кодом. В случае с GitHub следует обратиться к файлам readme.md и попытаться описать процесс внедрения. Кроме того, в случае обновления кода в репозитории мы можем обновить и само руководство по онбордингу.

Давайте рассмотрим пример документа в формате Markdown:
# Welcome to the Data Analyst Team!Welcome to our team! This guide will help you get started with your role as a Data Analyst. Below you'll find essential information, resources, and tools to ensure a smooth onboarding process.## Table of Contents1. [Introduction](#introduction)2. [Tools and Software](#tools-and-software)3. [Data Sources](#data-sources)4. [Best Practices](#best-practices)5. [Useful Commands](#useful-commands)6. [Contacts](#contacts)---## IntroductionAs a Data Analyst, your role involves interpreting data, analyzing results, and providing insights to help make informed business decisions. You'll work closely with various departments to understand their data needs and deliver actionable reports.## Tools and SoftwareHere are the primary tools and software you'll be using:| Tool | Purpose | License ||---------------|----------------------------------------|-------------|| **Python** | Data analysis and scripting | Open Source || **SQL Server**| Database management and querying | Commercial || **Tableau** | Data visualization and dashboarding | Commercial || **GitHub** | Version control and collaboration | Free/Paid |
Полная версия доступна на GitHub
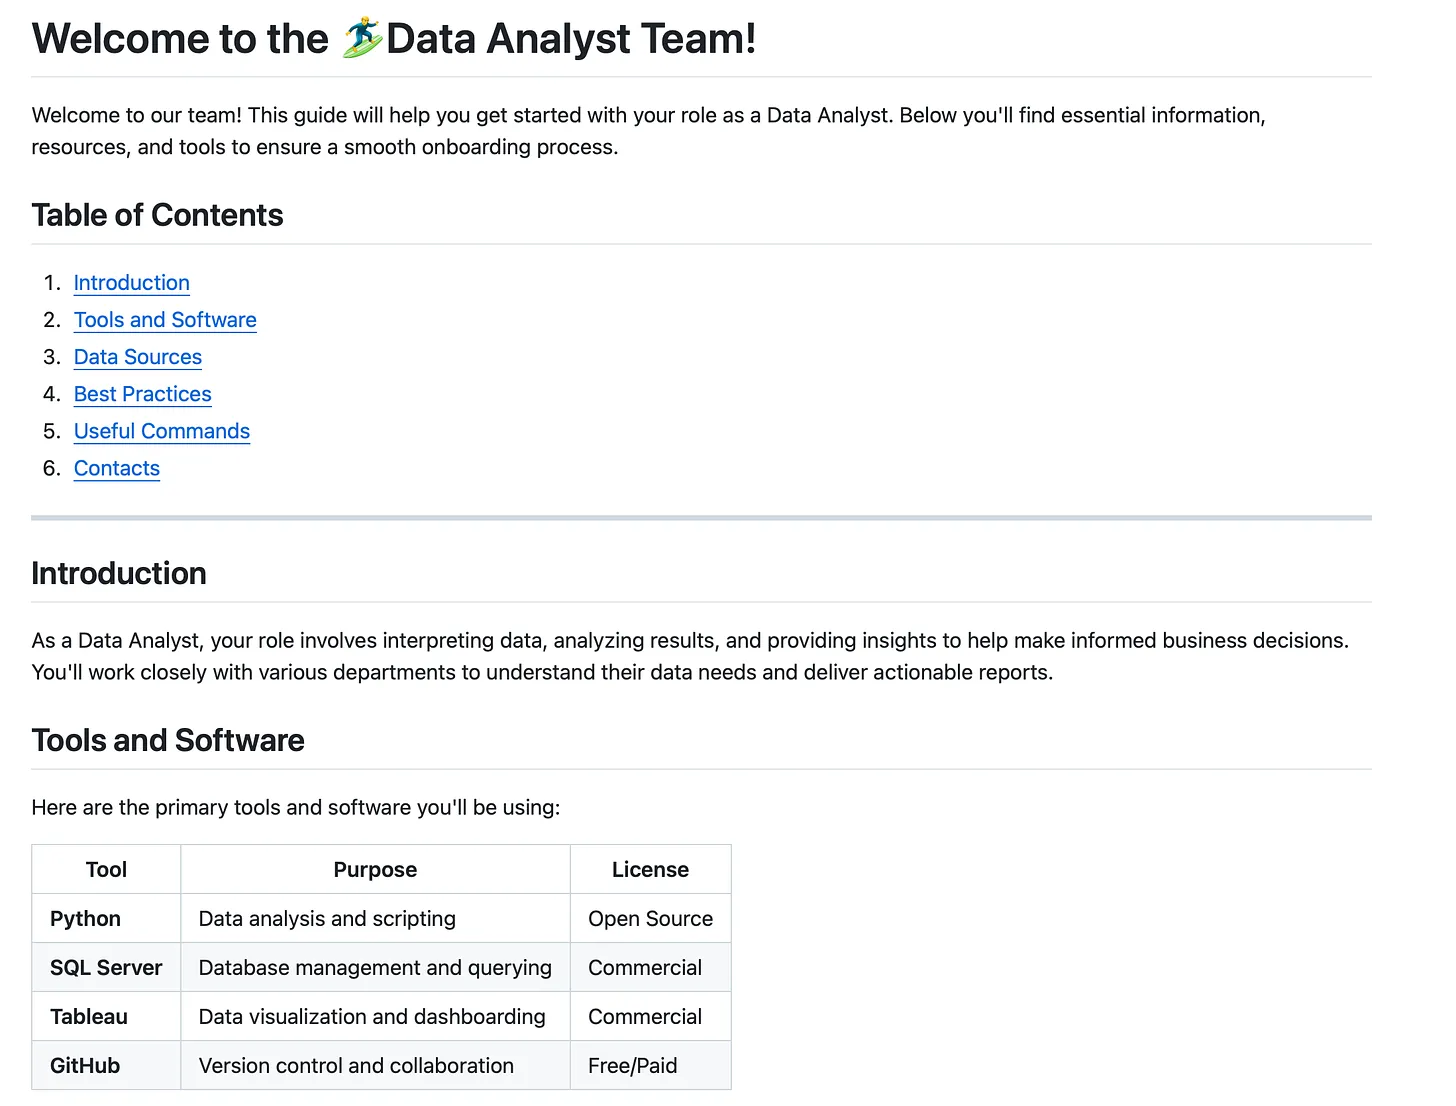
Это всего лишь пример руководства по введению в должность, но он наглядно показывает то, насколько эффективен readme.md, и почему его стоит внедрить в культуру по работе с данными.
История изменений
Благодаря системе git, чьей основной обязанностью является контроль версий, Вы всегда сможете найти подробную информацию об изменениях в Вашем SQL/Python-коде, документации и так далее.
Вы всегда сможете получить историю изменений и по желанию вернуться к любым изменениям, сделанным в прошлом.
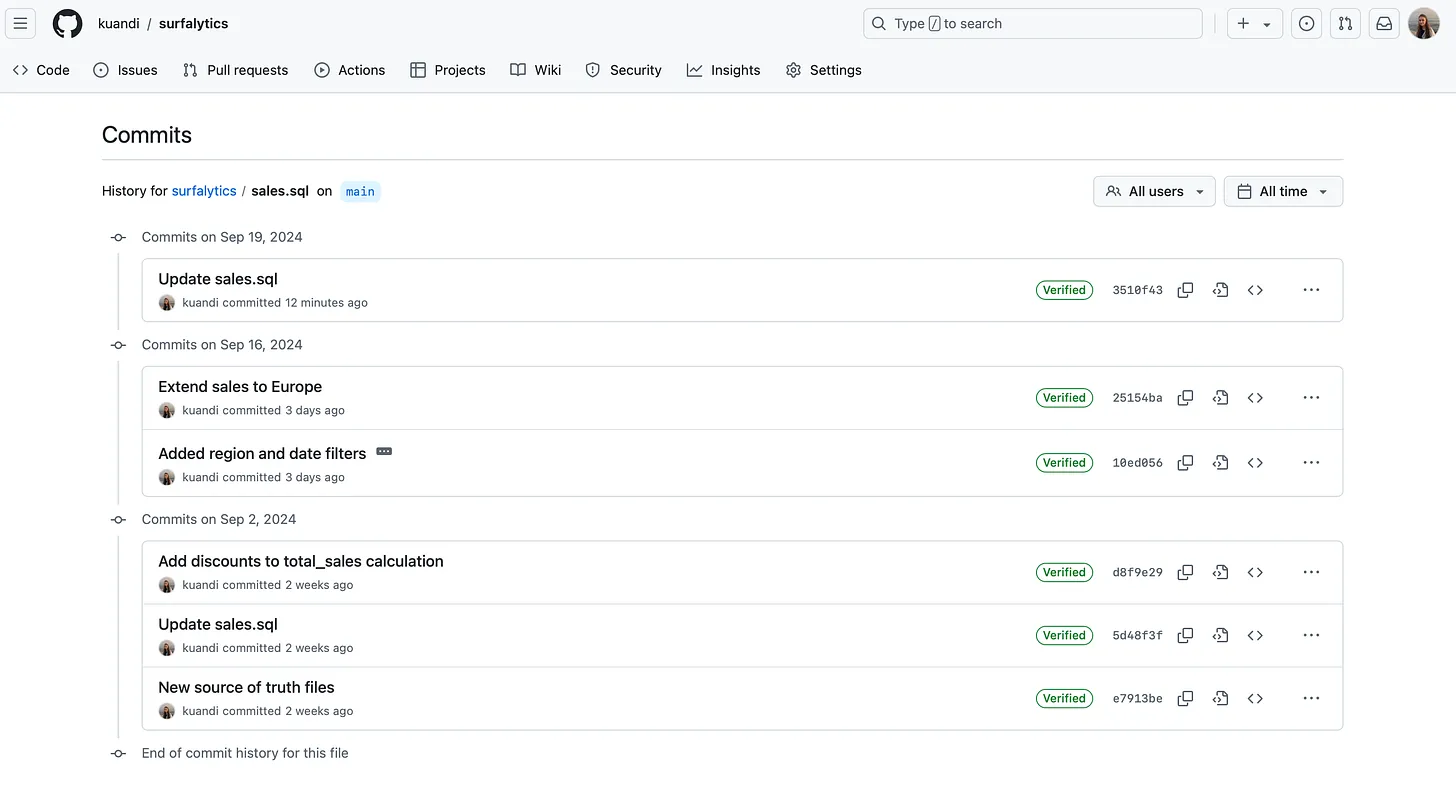
Представьте, что аналитик отправил Вам код и случайно пропустил условия фильтрации в предложении WHERE. Благодаря git Вы сможете легко найти этот недочет и исправить его:
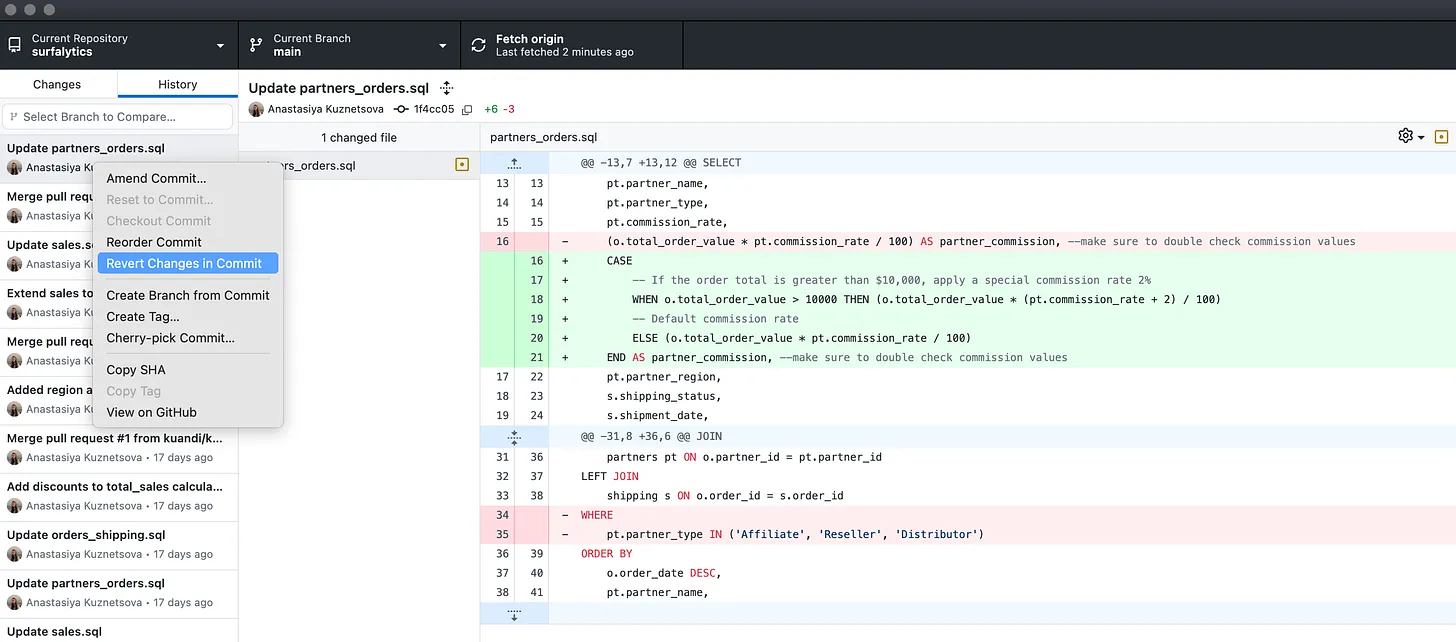
Пересмотр кода
Ранее мы упоминали случай, когда аналитик отправил (слил) код в продакшн (основную ветку) с неправильным условием. Чтобы впредь не допустить подобного мы должны использовать пересмотр кода.
Прежде всего, мы должны настроить репозиторий так, чтобы он не позволял сливать код в основную ветку (иногда master).
Переход от “Master” к “Main” в репозиториях Git
Переход от «master» к «main» в качестве названия ветки в репозиториях Git обусловлен стремлением технологического сообщества к инклюзивному языку. Термин «master» исторически ассоциируется с рабством и угнетением, поэтому для формирования дружелюбной атмосферы лучше использовать «main».
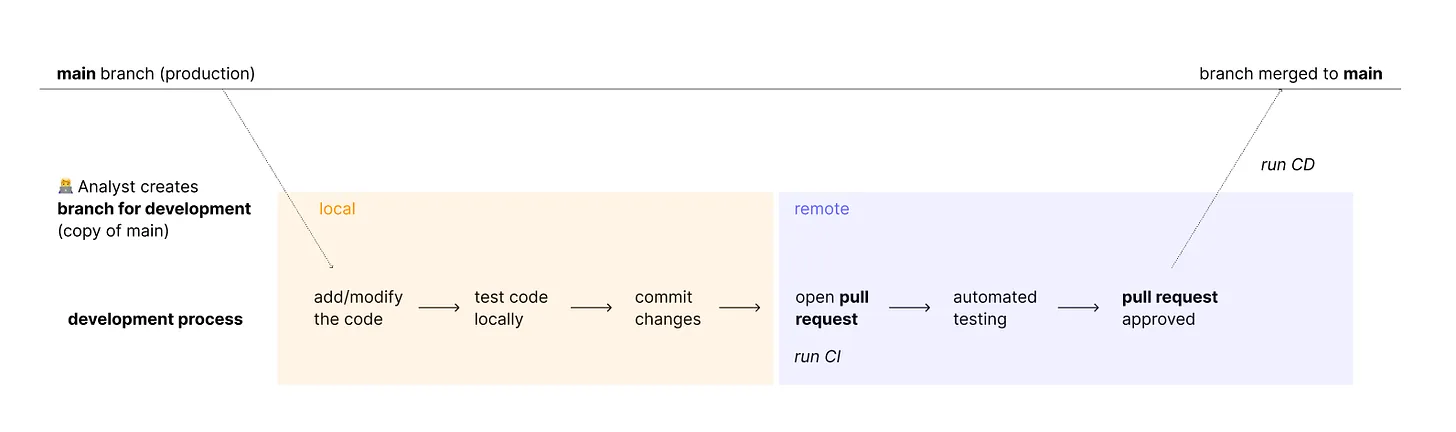
Также стоит упомянуть и об общей идее жизненного цикла разработки с помощью git-систем.
Предположим, у Вас есть репозиторий GitHub с кодом, и Вы хотите внести изменения в существующий код SQL.
1. Локальное клонирование репозитория
Начните с клонирования удаленного репозитория на локальную машину, в результате чего Вы получите локальную копию, в которой сможете свободно работать над проектом.
git clone <https://github.com/username/repository.git>
2. Создание новой ветки
Создание новой ветки позволяет работать над изменениями, не затрагивая основную или производственную ветку. Это очень важно для организованной и параллельной разработки проекта.
gitcheckout -bfeature/your-feature-name
3. Внесение изменений и локальное тестирование
При необходимости отредактируйте кодовую базу. После внесения изменений тщательно протестируйте ее, чтобы убедиться в том, что все работает именно так, как Вы запланировали.
4. Коммит и перенесение изменений на удаленное устройство
После тестирования зафиксируйте внесенные изменения с помощью специального сообщения и отправьте получившуюся ветку в удаленный репозиторий.
git add .git commit -m "Add feature: describe your feature"git push origin feature/your-feature-name
Разница между локальным и удаленным репозиториями
- Локальный репозиторий - это версия репозитория, хранящаяся на Вашем персональном компьютере. Вы можете вносить изменения, создавать ветви и фиксировать код локально.
- Удаленный репозиторий - это версия репозитория, размещенная на таких платформах, как GitHub. Она служит центральным репозиторием, над которым работают сразу несколько членов команды.
5. Создание Pull Request (PR)
Pull Request - это способ предложения о внесении изменений в основную кодовую базу, позволяющий членам команды просмотреть, обсудить и одобрить изменения до их применения.
Pull Requests (иногда Merge Request) - это ключевой элемент обеспечения качества кода и обмена знаниями, который позволяет членам команды просматривать код, задавать вопросы и предлагать возможные улучшения.
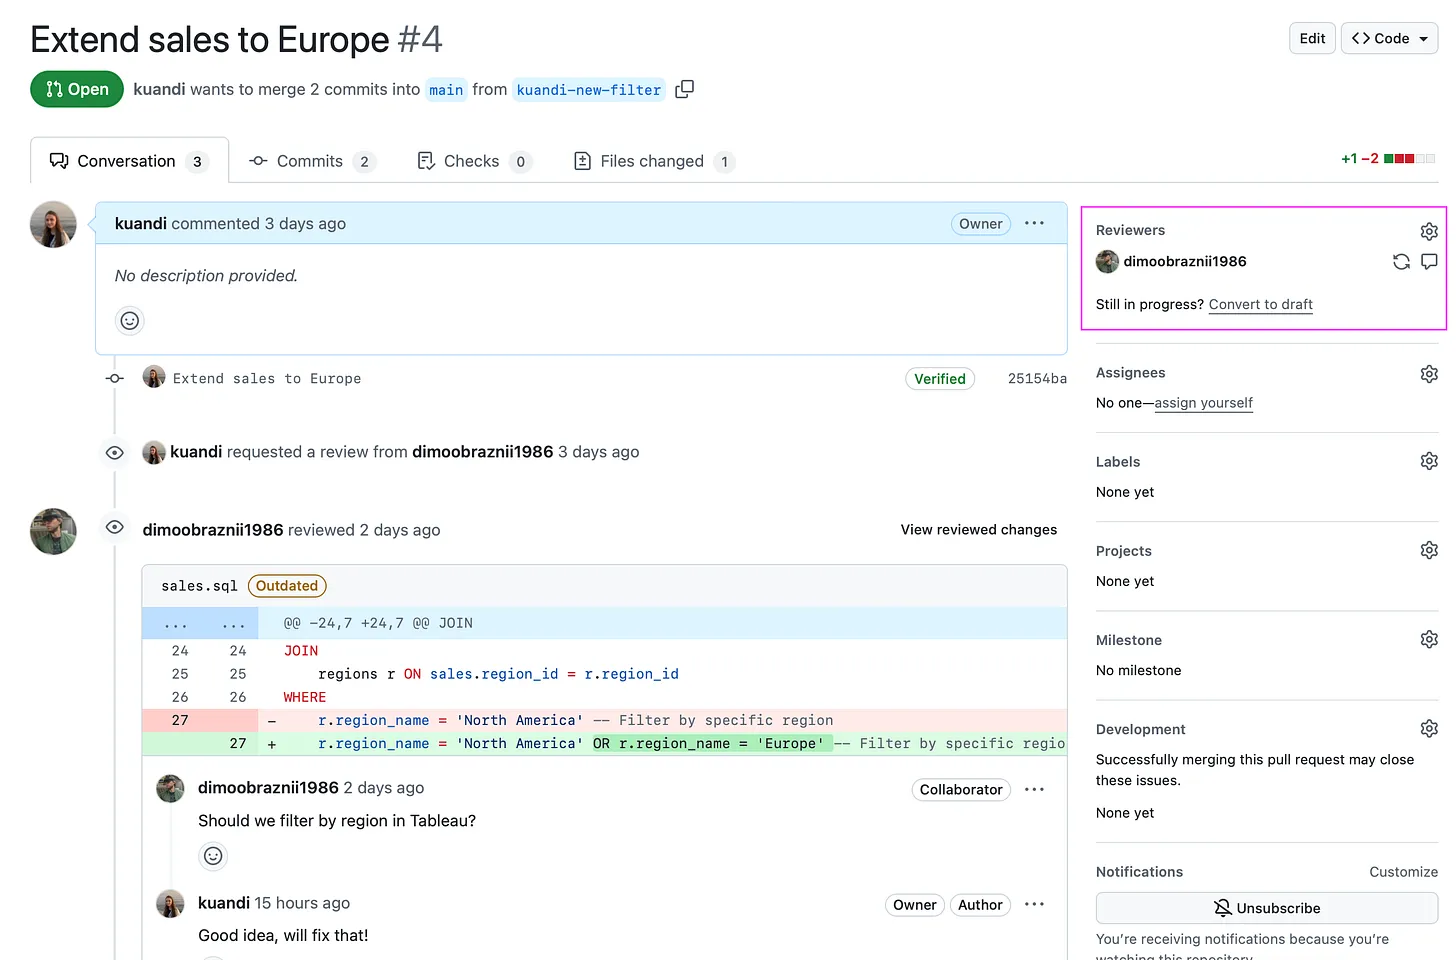
Как установить владельцев кода на GitHub
Качество кода
В аналитике данных качество кода = качество выводов и решений. Качество кода включает в себя множество аспектов, таких как стандарты присвоения имени, документация, тесты и так далее. Пересмотр кода - это последний шаг перед его передачей в продакшн, подразумевающий вмешательство человека.
Очевидно, что воздействие человека ненадежно, обычно более 50 % проблем с данными связаны именно с человеческим фактором. Поэтому есть смысл добавить процедуры, которые будут автоматически осуществлять различные виды проверок кода, включая линтинг, юнит-тесты и так далее.
pre-commit - это отличная возможность использовать различные виды проверок (хуки) для просмотра кода, который мы хотим зафиксировать. Его довольно просто добавить в репозиторий. Например, Вы можете установить pre-commit:
pip install pre-commit
и сохранить файл .pre-commit-config.yaml в корневом каталоге:
# .pre-commit-config.yamlrepos:- repo: <https://github.com/pre-commit/pre-commit-hooks>rev: v4.4.0 # Use the latest stable versionhooks:- id: trailing-whitespace- id: end-of-file-fixer- id: check-yaml- repo: <https://github.com/adrienverge/yamllint>rev: v1.26.3hooks:- id: yamllintargs: [--config-file=.yamllint.yaml]- repo: <https://github.com/sqlfluff/sqlfluff>rev: 0.24.0hooks:- id: sqlfluffargs: [--dialect, ansi] # Adjust dialect as neededfiles: \\.(sql)$- repo: <https://github.com/pycqa/flake8>rev: 6.0.0hooks:- id: flake8additional_dependencies: [flake8-docstrings, flake8-bugbear]- repo: <https://github.com/psf/black>rev: 23.9.1hooks:- id: blacklanguage_version: python3.11 # Adjust to your Python version- repo: <https://github.com/pre-commit/mirrors-mypy>rev: v1.4.1hooks:- id: mypyadditional_dependencies: [types-requests] # Add any additional type stubs as needed- repo: <https://github.com/pre-commit/mirrors-eslint>rev: v8.48.0hooks:- id: eslintfiles: \\.(js|jsx|ts|tsx)$
а также локально установить хуки:
pre-commitrun --all-files
У такого алгоритма действий очень много плюсов:
- Автоматизированные проверки качества кода обеспечивают строгое соответствие кода установленным стандартам.
- Согласованная кодовая база поддерживает единообразие всей кодовой базы, облегчая ее чтение и сопровождение.
- Предварительное обнаружение ошибок, а том числе синтаксических ошибок и потенциальных багов, на самых ранних этапах процесса разработки кода.
- Тесное взаимодействие членов команды, способствующее строгому соблюдению стандартов кодирования.
Пример коммита:
git commit -m "Adding Net Suite Sales"trim trailing whitespace..........................................Passedfix end of files..................................................Passedcheck yaml........................................................Passedcheck json....................................(no files to check)Skippedcheck for added large files.......................................Passedprettier..........................................................Passed
Приятная особенность предварительного коммита состоит в том, что он пытается исправить код за Вас.
CI/CD
Последняя часть процесса разработки идеального кода – это автоматизация.
Давайте разберемся в том, что такое CI и CD и как они могут нам помочь.
Непрерывная интеграция (CI) - это практика автоматической сборки, тестирования и проверки изменений кода по мере их интеграции в основную кодовую базу. Для задач, связанных с SQL-кодом, CI обычно включает в себя:
- Линтинг SQL - скриптов: Обеспечение соответствия SQL-кода стандартам кодирования и отсутствие синтаксических ошибок.
- Выполнение SQL- тестов: Выполнение модульных или интеграционных тестов с целью проверки работоспособности внесенных изменений.
- Проверка изменений схемы: Проверка того, что миграция схемы не приводит к нежелательным конфликтам системы.
Непрерывное развертывание (CD) автоматизирует процесс развертывания подтвержденных изменений кода в производственных или других средах. Для задач, связанных с SQL-кодом, CD включает в себя следующее:
- Применение миграции базы данных: Автоматическое выполнение SQL-скриптов с целью обновления схемы баз данных или самих данных.
- Версионирование изменений базы данных: Отслеживание различных версий скриптов базы данных для управления откатом (при необходимости).
- Создание релизов: Упаковка и распространение изменений базы данных как часть процесса выпуска ПО.
Используя GitHub, мы можем создавать GitHub Actions для CI/CD.
Начнем с примера CI. Каждый раз, когда выкладывается новый код, происходит следующее:
- Проверка репозитория.
- Установка Python (требуется для инструментов предварительного коммита и линтинга).
- Устанавка зависимостей.
- Запуск хуков предварительного коммита для проверки и подтверждения кода.
- Проверка и тестирование кода, специфичного для SQL.
# .github/workflows/ci.ymlname: CI Pipelineon:push:branches:- main- 'feature/**'pull_request:branches:- mainjobs:build:runs-on: ubuntu-lateststeps:# 1. Check out the repository- name: Checkout Repositoryuses: actions/checkout@v3# 2. Set up Python- name: Set up Pythonuses: actions/setup-python@v4with:python-version: '3.11' # Adjust as needed# 3. Install dependencies- name: Install Dependenciesrun: |python -m pip install --upgrade pippip install pre-commitpip install sqlfluff flake8 black mypy # Add other dependencies as needed# 4. Run pre-commit hooks- name: Run Pre-commit Hooksrun: pre-commit run --all-files# 5. Run SQL Linting with SQLFluff- name: Lint SQL Filesrun: sqlfluff lint ./sql # Adjust the path to your SQL files# 6. Run SQL Tests (Optional)- name: Run SQL Testsrun: |# Example: Execute SQL test scripts# Replace with your actual test commandsbash ./scripts/run-sql-tests.sh
Описание этапов рабочего процесса CI:
- Проверка репозитория: Использует действие actions/checkout для клонирования Вашего репозитория в рабочий процесс.
- Настройка Python: Устанавливает указанную версию Python, необходимую для работы инструментов линтинга и хуков предкоммита.
- Установление зависимостей: Устанавливает pre-commit и другие необходимые зависимости, такие как sqlfluff, flake8, black и mypy.
- Запуск предварительного коммита: Выполняет все хуки pre-commit над всей кодовой базой для обеспечения высокого качества кода.
- Линтинг файлов SQL: специальный линтинг SQL-файлов с помощью sqlfluff для обеспечения соблюдения стандартов кодирования SQL.
- Выполнение тестов SQL: (необязательно) Выполнение сценариев тестирования SQL для проверки изменений в базе данных.
Проще говоря, CI - это процесс, который мы хотим запустить после создания коммита или Pull Request, перед тем как пригласить коллег на просмотр кода.
В нашем примере мы добавляем те же проверки перед коммитом, что и на локальном уровне. Это поможет избежать случаев, когда разработчики не следовали руководству по онбордингу и пропустили шаг по локальной настройке pre-commit.
Давайте проверим пример с CD. Этот рабочий процесс развертывает изменения SQL в производственной базе данных каждый раз, когда коммит сливается в основную ветку или создается новый релиз.
#.github/workflows/cd.ymlname: CD Pipelineon:push:branches:- mainrelease:types: [published]jobs:deploy:runs-on: ubuntu-lateststeps:# 1. Check out the repository- name: Checkout Repositoryuses: actions/checkout@v3# 2. Set up Python- name: Set up Pythonuses: actions/setup-python@v4with:python-version: '3.11' # Adjust as needed# 3. Install dependencies- name: Install Dependenciesrun: |python -m pip install --upgrade pippip install sqlfluff # Add other deployment tools as needed# 4. Apply SQL Migrations- name: Apply SQL Migrationsenv:DB_CONNECTION_STRING: ${{ secrets.DB_CONNECTION_STRING }}run: |# Example: Using SQLFluff to fix and then apply migrationssqlfluff fix ./sqlsqlfluff lint ./sql# Replace with your actual deployment commandsbash ./scripts/deploy-sql.sh# 5. Create a GitHub Release (Optional)- name: Create GitHub Releaseif: github.event_name == 'release'uses: actions/create-release@v1with:tag_name: ${{ github.ref }}release_name: Release ${{ github.ref }}body: |Changes in this release:- Feature A- Bug Fix Benv:GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
Объяснение этапов рабочего процесса:
- Проверка репозитория: Клонирует репозиторий в среду рабочего процесса.
- Настройка Python: Устанавливает необходимое окружение Python.
- Установка зависимости: Устанавливает необходимые инструменты для развертывания, такие как sqlfluff.
- Применение SQL-миграции: Выполняет SQL-скрипты для обновления производственной базы данных. Замените команды примера Вашими реальными сценариями развертывания.
- Создание релиза GitHub (необязательно): Автоматически создает релиз GitHub при публикации нового релиза. Это можно использовать для маркировки развертываний и предоставления примечаний к выпуску.
Проще говоря, CD - это процесс, который мы хотим запустить после завершения проверки кода и его слияния. Мы хотим развернуть код в продакшене, так пусть GitHub Actions сделает это за нас автоматически.
С помощью этих практик и инструментов Вы сможете создать надежный и эффективный конвейер разработки данных, обеспечивающий высокое качество SQL-кода и надежность развертывания.
Действительно ли мне нужно знать все это, если я работаю простым аналитиком данных???
Возможно, Вы немного напуганы сложностью этой темы. Но все не так плохо, как кажется на первый взгляд. В нашем бесплатном курсе по аналитике данных есть специальный Модуль 0, содержащий полезные советы для специалистов по работе с данными:
- установка GitHub
- установка VSCode IDE
- установка IDE
- информация о контейнерах Docker
Мы считаем, что каждая организация должна использовать git-системы и стремиться к качественной документации и коду. Я называю это инженерным мастерством. Для специалистов по работе с данными это серьезное конкурентное преимущество. Как только Вы начнете использовать эти знания на практике, Вы станете настоящим мастером своего дела.
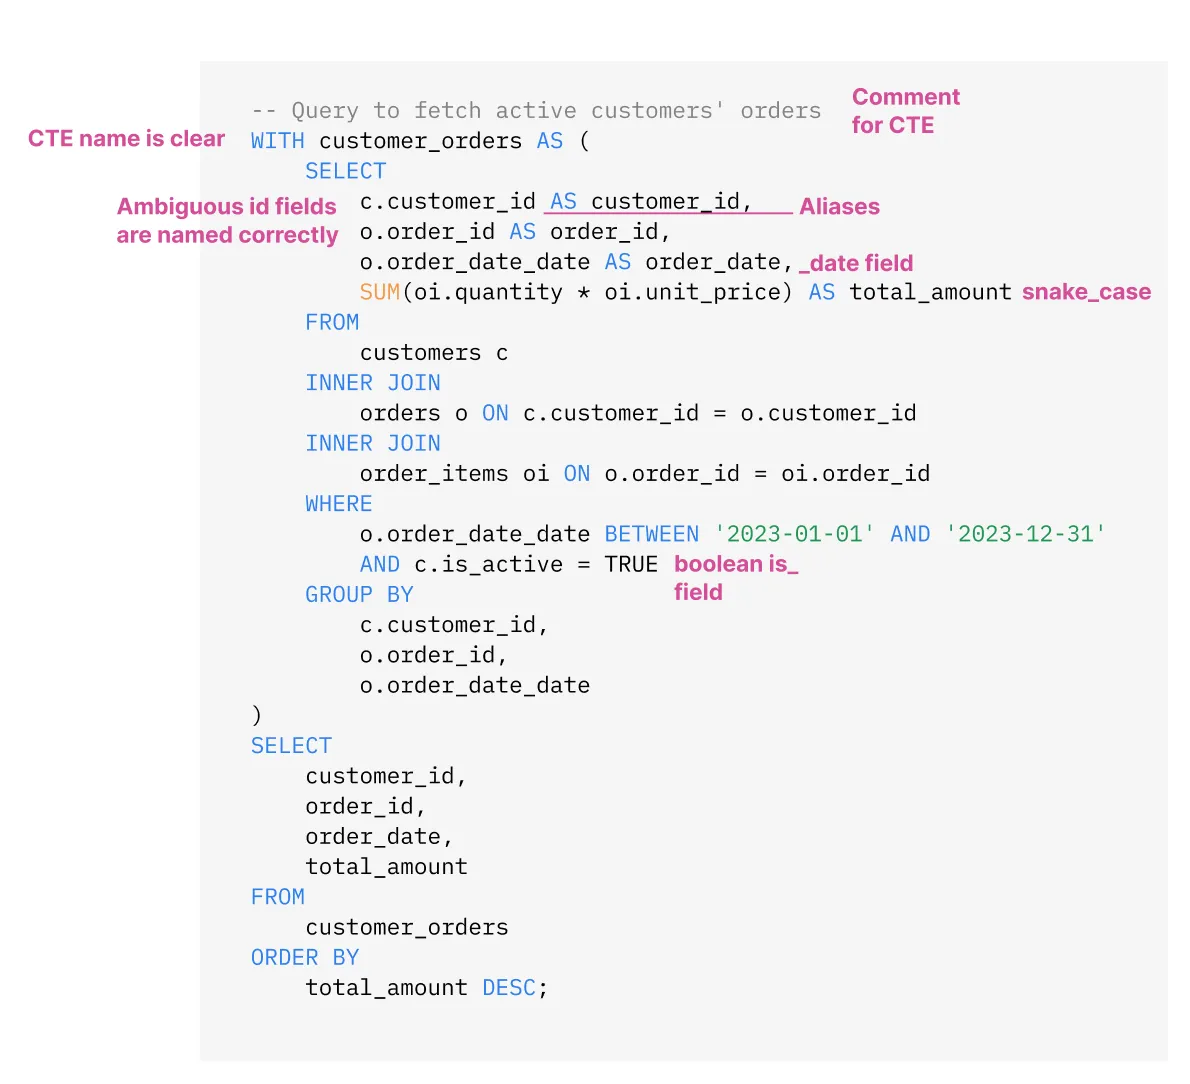
SQL стайлгайд
Но как писать SQL-запросы, которые без труда смогут прочитать владельцы кода и рецензенты, и при этом соответствовать наиболее распространенным стандартам README?
Поскольку наша ключевая аудитория использует SQL в своей работе каждый день, важно обеспечить чистоту, последовательность и удобство сопровождения нашего кода. В этом руководстве мы подробно рассмотрим лучшие практики стиля SQL, охватывающие все аспекты - от форматирования до соглашений о наименовании. Благодаря ему Вы сможете создавать качественный и читабельный код, соответствующий всем основным отраслевым стандартам.
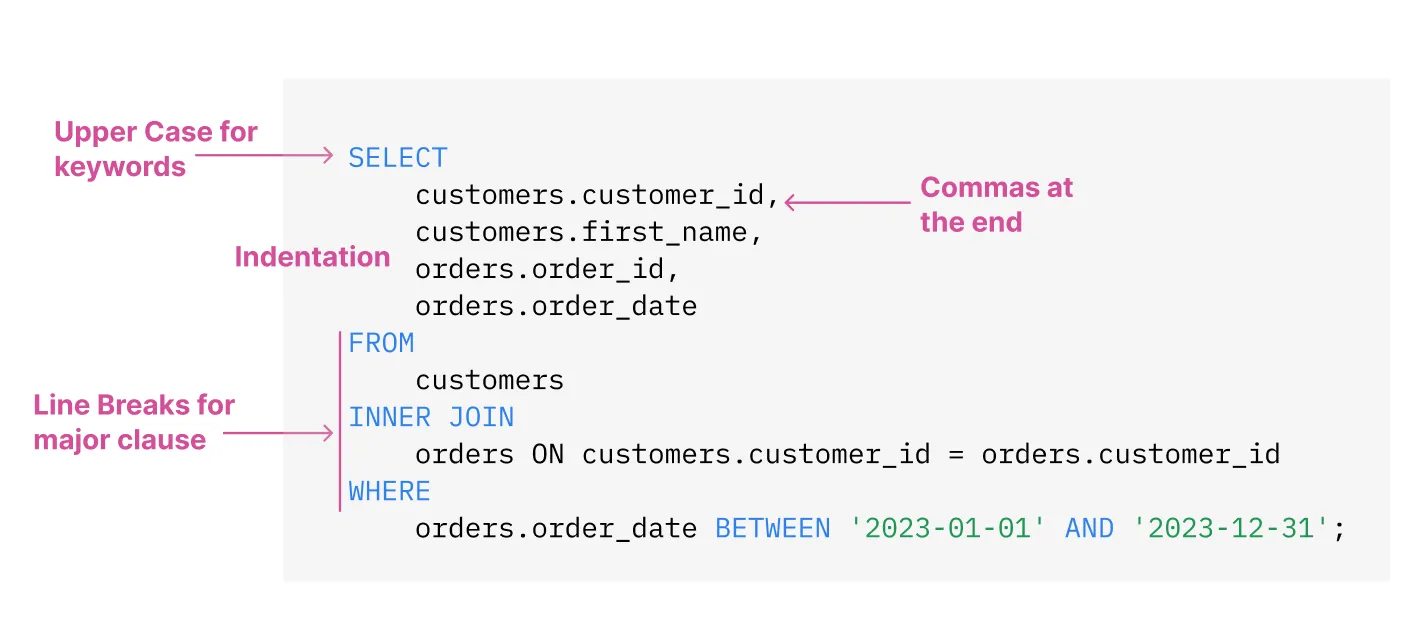
Форматирование
- Верхний регистр: Используйте верхний регистр для ключевых слов SQL SELECT, а не SeLeCt :)
- Разрывы строк: Размещайте каждое основное предложение (SELECT, FROM, WHERE и т.д.) на новой строке.
- Запятые: Ставьте запятые в конце строк, а не в начале.
- Пробелы и отступы: используйте пробелы и отступы.
Линтеры
Как правило, никто не пишет код с учетом всех этих правил, потому что за нас это делают линтеры! У кого есть время писать все ключевые слова в верхнем регистре?
Линтер - это инструмент, который анализирует Ваш SQL-код на предмет наличия ошибок, соблюдения стандартов кодирования и лучших практик. Линтеры могут выявлять синтаксические и стилистические ошибки, а также потенциальные проблемы с производительностью. Обычно они включаются в процесс CI/CD, о котором мы говорили ранее.
Наиболее популярные линтеры:
Структура
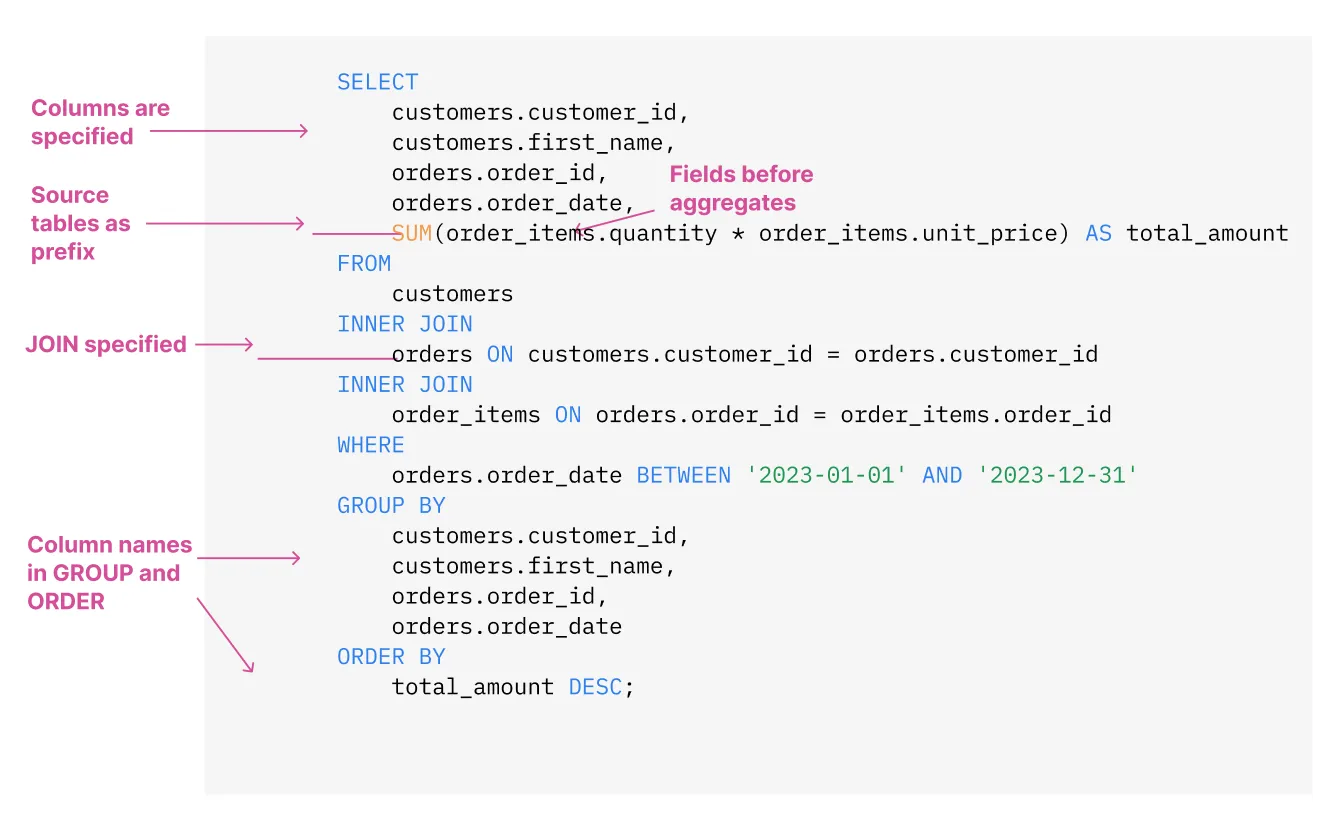
- Избегайте SELECT *, всегда указывайте в запросе только нужные столбцы.
- Поля следует указывать перед агрегатами и оконными функциями.
- Для сложных запросов отдавайте предпочтение CTE (Common Table Expressions), а не подзапросам. Их гораздо легче читать и декомпозировать.
- Избегайте использования номеров столбцов в выражениях GROUP BY и ORDER BY; вместо этого используйте имена столбцов. Может возникнуть соблазн просто написать GROUP BY 1,2,3, но оставьте это для ad-hoc, а не для производственного кода.
- Всегда используйте явный синтаксис объединения. Отдавайте предпочтение ключевому слову JOIN вместе с предложением ON. Также указывайте тип JOIN (например, INNER JOIN) вместо просто JOIN.
- При использовании множественных объединений всегда указывайте в префиксе столбцов имена их исходных таблиц.
Присвоение имени
- Используйте единый регистр для идентификаторов (имена таблиц и столбцов, части CTE). Лучше использовать нижний регистр.
- Используйте snake_case в качестве соглашения об наименовании. Это то, о чем Вы должны договориться внутри Вашей команды. В большинстве случаев snake_case легче, чем camelCase или kebab-case.
- Псевдонимы: Используйте короткие, осмысленные псевдонимы и всегда используйте ключевое слово AS. Всегда добавляйте псевдонимы к двусмысленным именам полей, таким как id, type, date.
- Имена булевых полей должны содержать is_, has_ для того, чтобы четко показать, что они представляют собой истинное/ложное значение. Они также должны отражать положительное состояние условия: is_active вместо is_not_active.
- Поля временных меток и дат должны заканчиваться символами _ts и _date соответственно.
Комментарии
Всегда комментируйте части запроса со сложной логикой. Особенно неочевидную фильтрацию, логические случаи и CTE. Примеры: сложные выражения CASE/IF, расчеты метрик, CROSS/FULL JOINS.
- - для однострочных комментариев
-
... */для многострочных комметариев
Другие SQL стайлгайды:
- dbt
- GitLab
- Kickstarter
- Brooklyn Data Co. SQL стайлгайд
- стайлгад Саймона Холивелла
- стайлгайд Мэта Мэйзура