

Хотите работать с запросами SQL как профи? - часть 1
Авторство - совместная коллаборация Анастасии Кузнецовой и Дмитрия Аношина.
оригинал статьи на английском - https://nastengraph.substack.com/p/part-1-how-to-work-with-sql-queries
И аналитики данных, и разработчики BI решений часто пользуются SQL, мощным инструментом работы с данными и по совместительству самостоятельным языком программирования. Эффективность использования SQL, как и любого другого языка программирования, зависит от того, насколько хорошо развито Ваше собственное инженерное мышление. Этой теме мы посвятили целых 2 статьи.
Вы когда-нибудь смотрели на код и думали: «Нда, что это вообще такое?». Если да, то, скорее всего, его написали не Вы. Но вполне возможно, что это Ваш собственный код, просто написанный пару лет назад. Беспрекословное соблюдение высоких стандартов качества кода крайне важно для любой организации. Это особенно актуально и для SQL, так как всего лишь один плохо написанный запрос может привести к критическим сбоям всей системы в целом.
Для того, чтобы глубже разобраться в этом вопросе, я попросила Дмитрия Аношина, одного из самых известных дата-инженеров и создателя сообщества Surfalytics, поделиться своим опытом и лучшими практиками организации эффективной работы с SQL.
В этой статье мы поговорим о таких ключевых понятиях, как пересмотр кода, pull request и CI/CD, покажем реальные примеры применения этих практик, а также подробно рассмотрим правила форматирования SQL-кода.
Кроме того, мы обсудим, почему одной из лучших практик поддержания высокого качества SQL-кода является линтинг перед коммитом. Таким образом, цель этой статьи состоит в том, чтобы вооружить Вас знаниями, позволяющими повысить эффективность работы с SQL.

Без CI/CD
Давайте посмотрим, как типичная организация работает с данными.
Представим, что есть некий стартап, занимающийся созданием и продажей ошейников для собак, оснащенных GPS.
Предположим, что в качестве своих торговых площадок он используют WooCommerce и Wordpress, все данные о продажах доступны в OLTP-базе данных, которая служит бэкендом для нашего Интернет-магазина.
В определенный момент основатели компании решают разобраться в схемах продаж и запрашивают соответствующие данные с помощью бесплатного Dbeaver или $ DataGrip (мне лично очень нравится работать именно с ним). Через некоторое время команда проекта выдает SQL-запросы, которые возвращают информацию о продажах, заказах, доставке и отвечают на некоторые другие важные бизнес-вопросы.
Допустим, команда проекта оперирует всего 3 SQL-запросами, которые аккуратно сохранены в Google Drive:
- sales.sql
- orders_shipping.sql
- partners_orders.sql
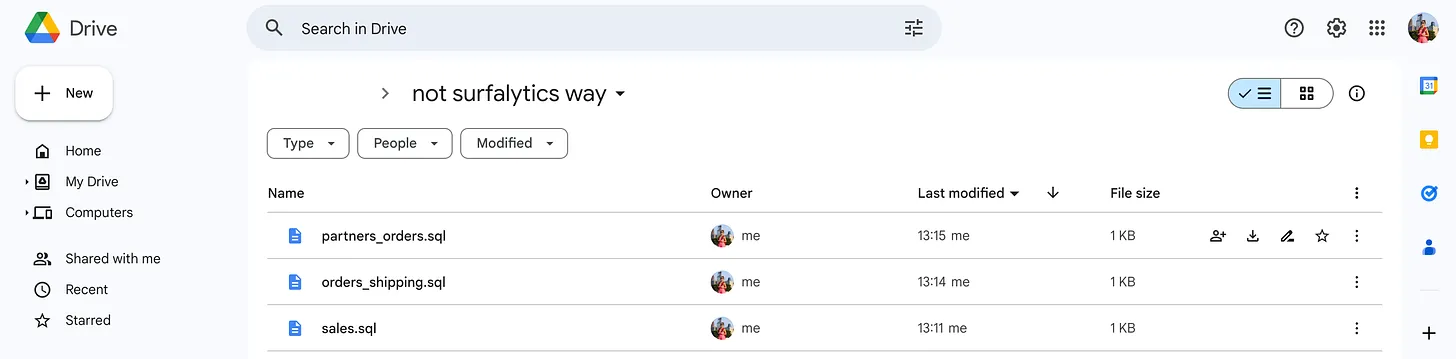
Вероятно, это единый источник истины. Команда проекта небольшая, и все знают, как скопировать эти запросы и получить нужные им цифры. Сам продукт, то есть ошейник, - это настоящее произведение искусства, который так же, как и часы для собак от Apple, собирает данные о самочувствии собак. Команда бэкенда создала специальную базу данных с данными об ошейнике, пользователе, собаке и т. д. Если кто-то захочет узнать более подробную информацию о версии прошивки, мобильного приложения, модели использования и т.д., то он может воспользоваться запросами, подготовленными командой бэкенда:
- active_pets.sql
- collars_firmware_activity_breakdown.sql
- users_pets_collars_stat.sql
Компания развивается и интегрирует новые системы, например, решения по доставке и возврату товаров, поддержке клиентов и т.д. Как Вы уже могли догадаться, количество запросов растет...
В какой-то момент компания решает найти специалистов, которые будут заниматься аналитикой данных и предоставлять руководству компании необходимые сведения, поэтому она нанимает двух аналитиков данных, которые умеют правильно задавать бизнес-вопросы, давать ценные рекомендации и подкреплять их ДАННЫМИ, ура!
Теперь начинается самое интересное.
Аналитики начинают копировать SQL-запросы из Google Drive и вносить в них небольшие изменения. Иногда они сохраняют их обратно, иногда нет. Иногда они изменяют один и тот же файл одновременно. Кому-то нравится CamelCase, кому-то snake_case, кому- то - TAB, а кому-то - 4 пробела. Ну и, конечно, бесконечные споры о UPPER CASE vs LOWER CASE...
Через некоторое время Google Drive становится чем-то вроде этого:
- sales_v1.sql
- sales_v2.sql
- sales_v2_latest.sql
- sales_v3_by_analyst_1.sql
- sales_v5.1.sql
- и т.д.
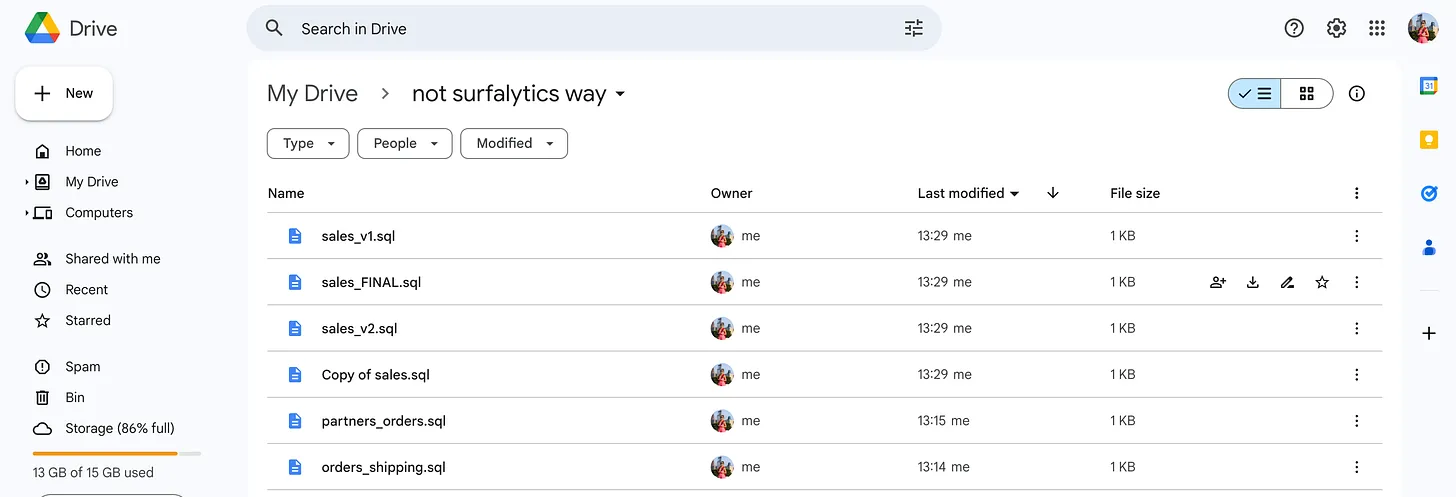
Это выглядит забавно, но на самом деле это треш. В первую очередь это проблема для основателей и владельцев бизнеса. Все эти эксперименты с форматами увеличивают сложность запросов и рабочую нагрузку в целом. Кроме того, такая ситуация увеличивает риски, поскольку теперь единственный источник истины - это голова(ы) аналитика(ов).
Я не стал упоминать о хранилищах данных, BI, ETL и других современных практиках, чтобы не запутывать Вас. Но все те же самые проблемы относятся и к DWH/Data Lake/Data Lakehouse.
Контроль версий
Простым решением, которое поможет решить проблему версий файлов SQL, является использование системы контроля версий (VCS), такой как git. На рынке представлено множество поставщиков, предлагающих свои решения:
- GitHub
- GitLab
- Azure DevOps
- и другие.
Если Вы не знаете, с чего начать, воспользуйтесь GitHub.
Первым шагом для нашей команды по работе с данными станет консолидация SQL-запросов и их размещение в репозитории.
Система, подобная Git, даст команде данных множество преимуществ:
- Хранение всего кода в одном месте, доступном для просмотра всем желающим;
- Ориентирование по содержимому папки с помощью файлов readme.md;
- Отслеживание всех изменений и контроль версий;
- Проведение обзоров кода в команде и между командами;
- Обеспечение качества и высоких стандартов данных с помощью .pre-commit, Continuous Integrations (CI) и Continuous Deployments (CD).
На первый взгляд может показаться, что все это слишком сложно. Но это не так, и, как обычно, начинать нужно с малого. Давайте внимательно разберем каждый пункт.

Как открыть pull request
Пример с веб-версией GitHub
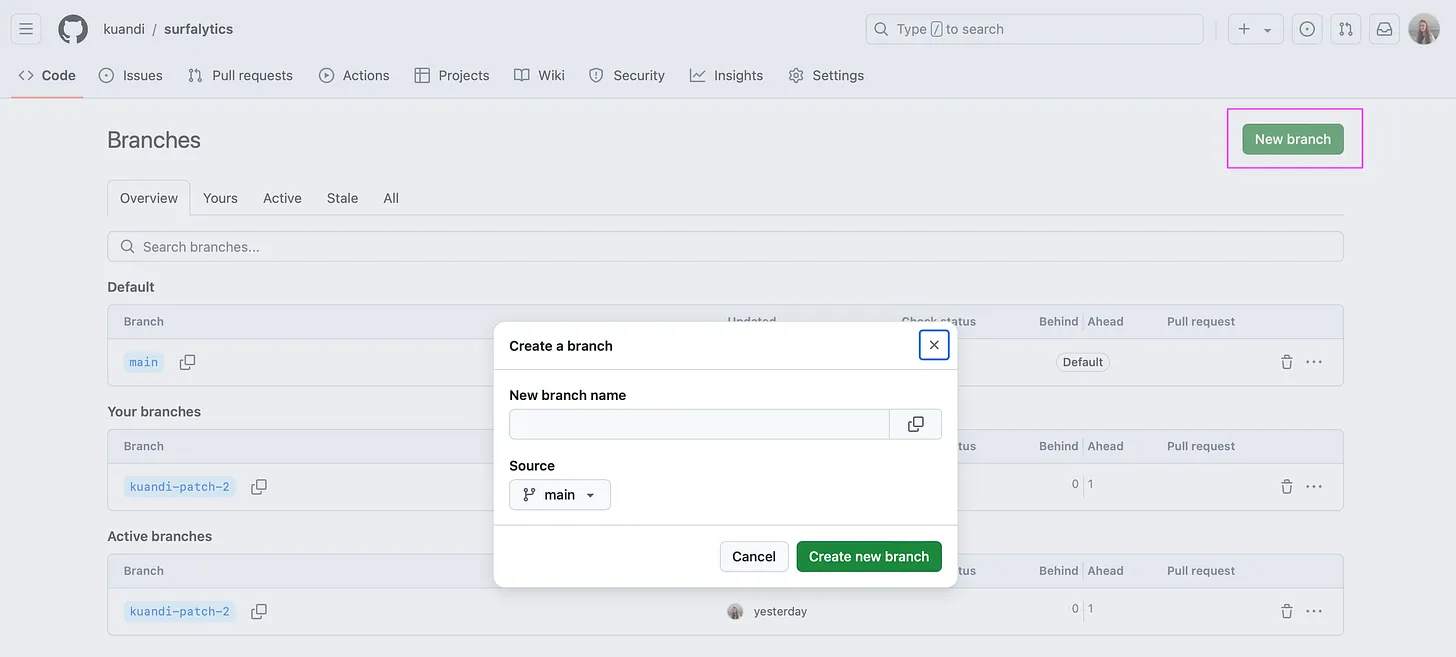
- Создайте новую ветку (копию кода)
Ветка в Git - это отдельная рабочая область, в которую Вы можете вносить изменения, не затрагивая основную версию. Думайте о ней как о копии проекта, где Вы можете спокойно экспериментировать, добавлять новые функции или исправлять допущенные ошибки.
- Переключитесь на новую ветку и найдите файл, который Вы хотите отредактировать.
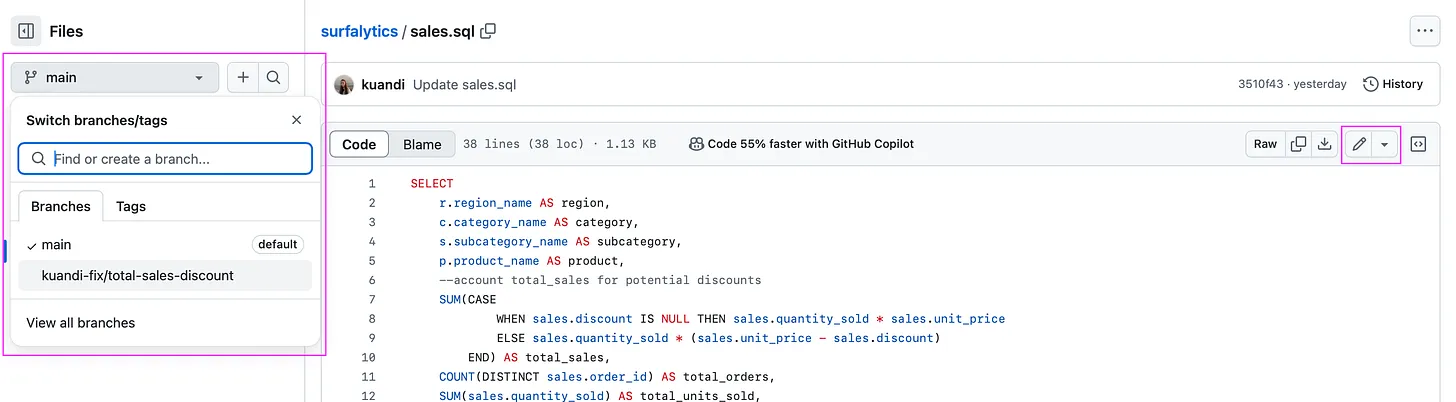
- Внесите необходимые изменения и зафиксируйте их
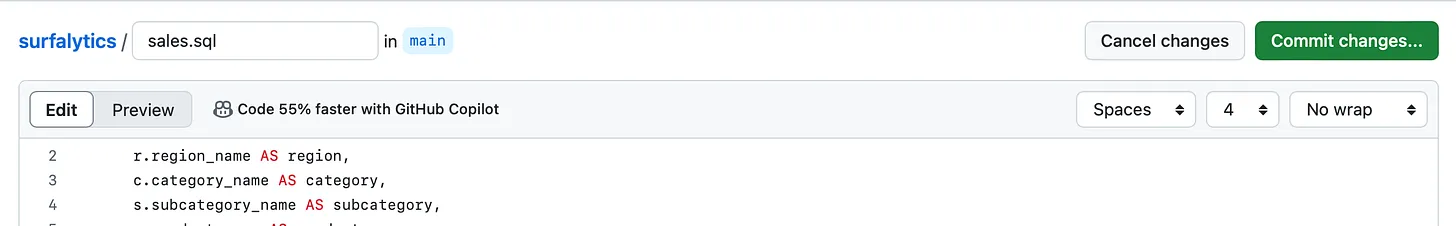
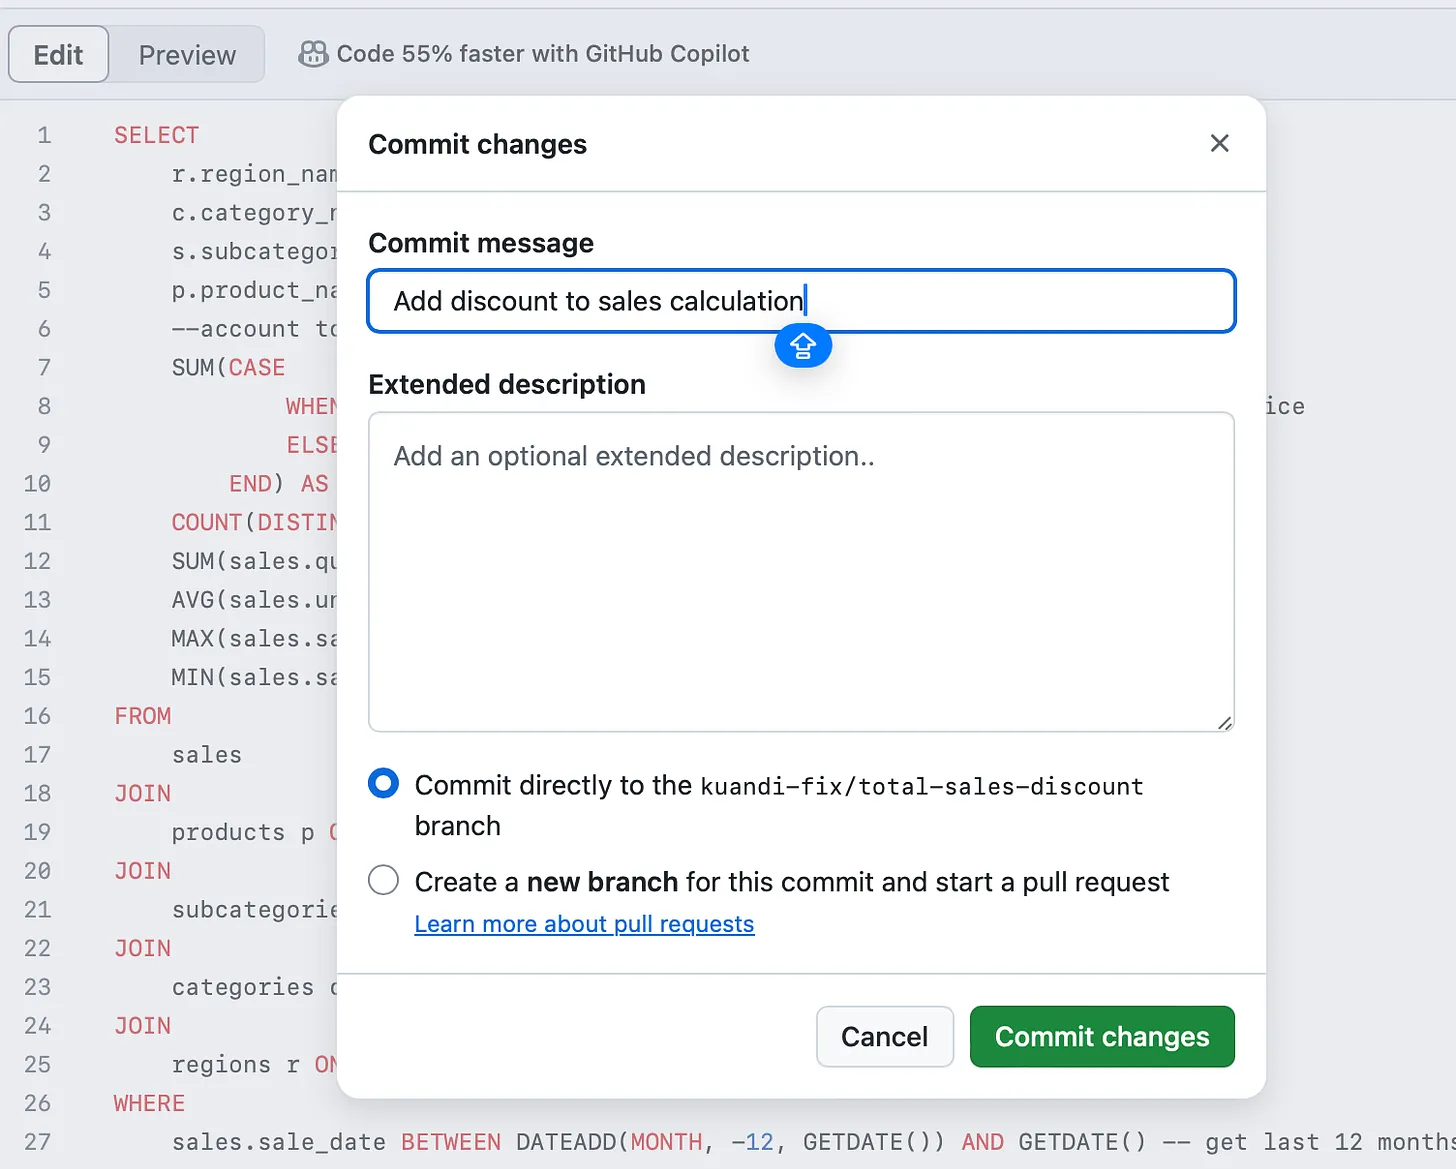
- Добавьте сообщение о коммите и его описание (у каждой организации - свои правила касательно сообщений о коммите. Зафиксируйте новую ветку.
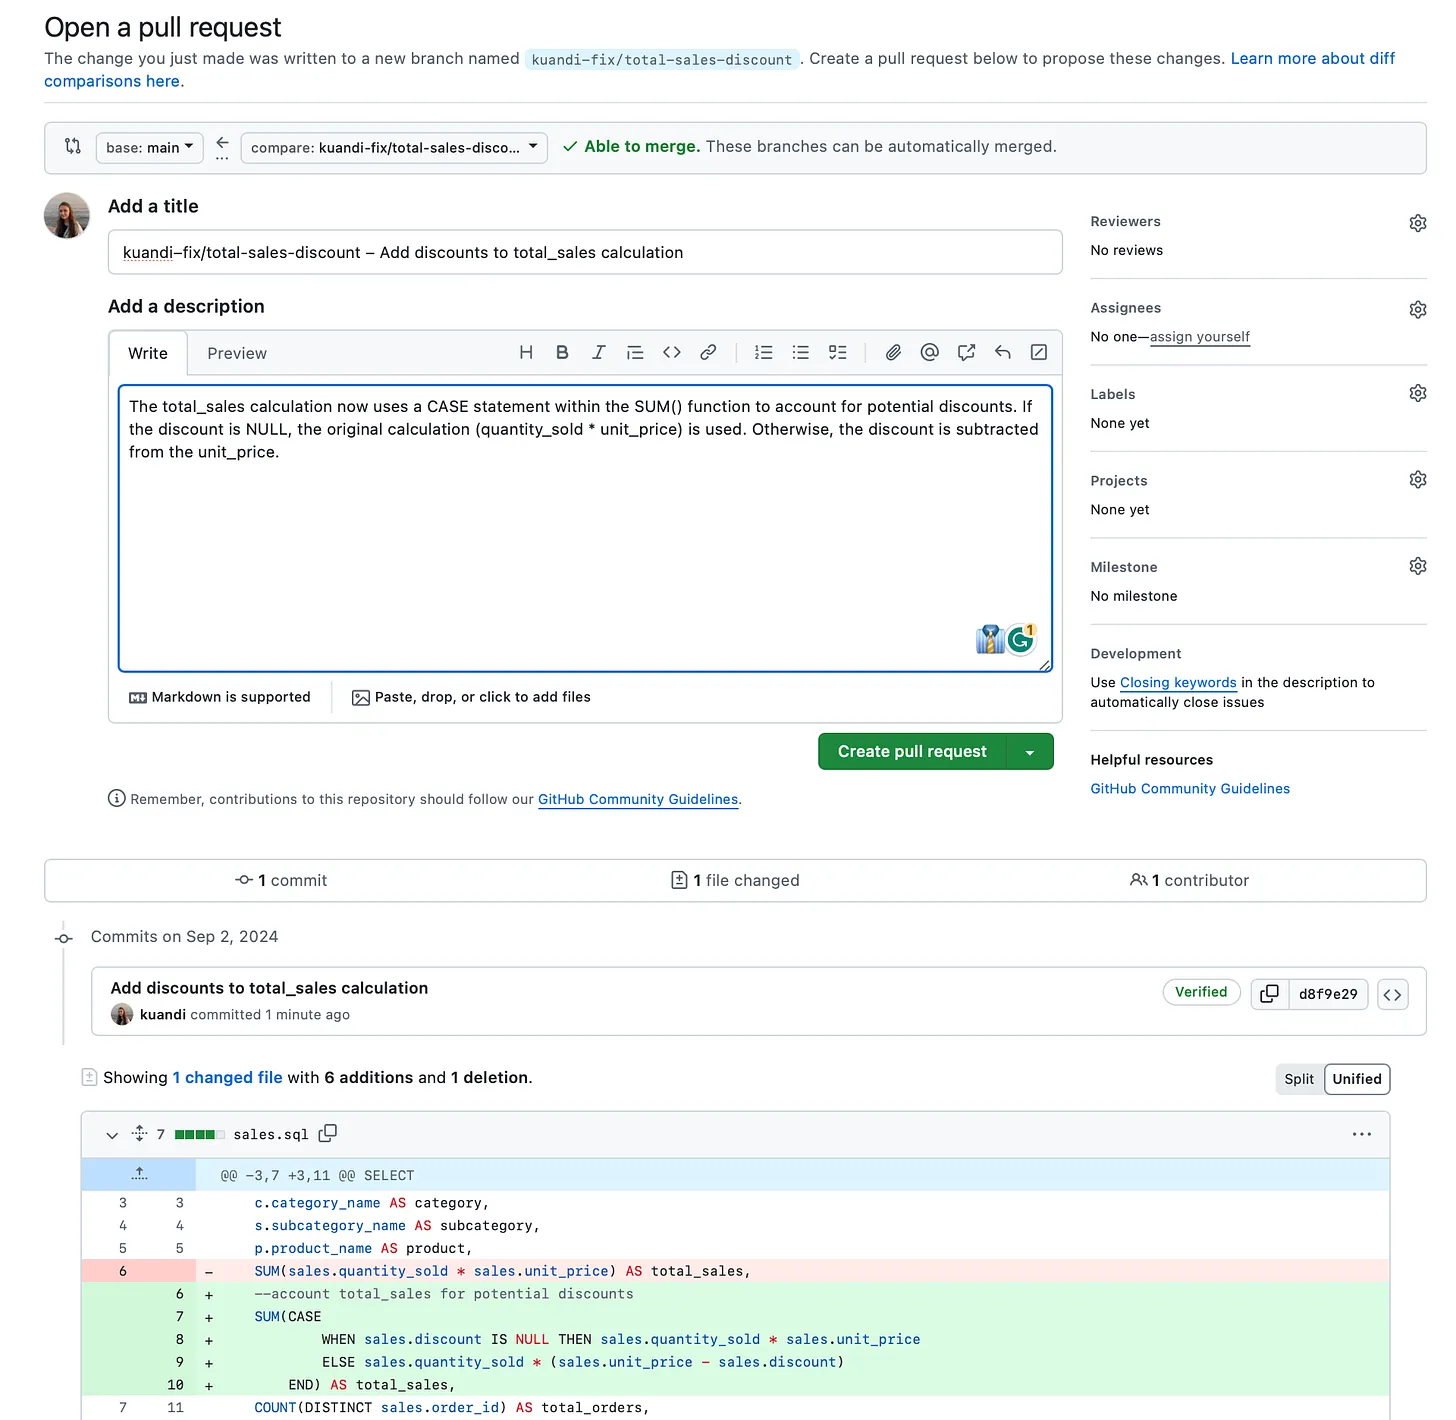
- Откройте pull request
- Объедините pull request после пересмотра кода (почему так - обсудим позже).
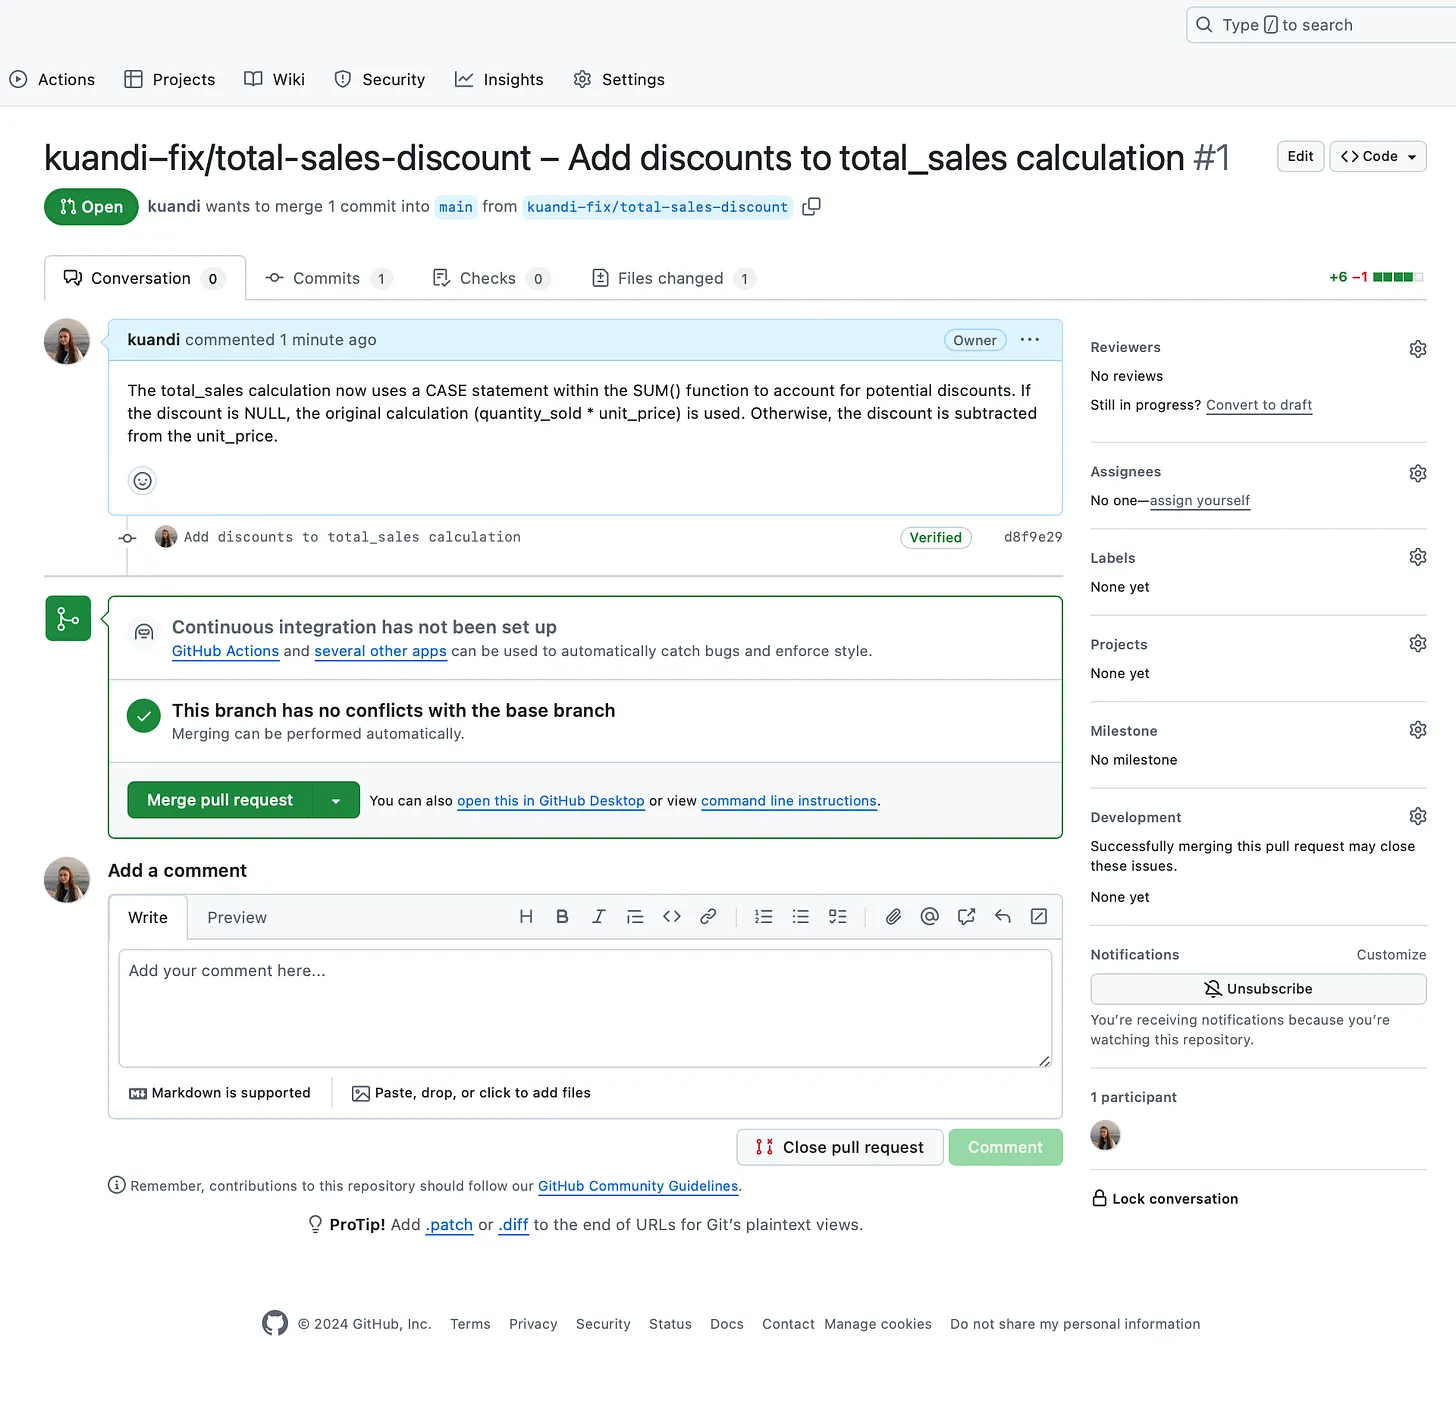
Обычно это происходит в локальной IDE, такой как VSCode. Подробнее об этом Вы можете узнать из следующих уроков:
Кроме того, прочитайте нашу статью, посвященную лучшим практикам по присвоению имен новым веткам и составлению сообщений о коммите.


