

Кластеры высокой доступности Trino в Goldman Sachs
Рамеш Бханан, вице-президент; Сиддхант Чадха, юрист; Сумит Халдер, вице-президент и Суман Балиганахалли Нараян Мурти, вице-президент по разработке бизнес-платформ
17 февраля 2022 года мы в прямом эфире поделились своим опытом построения кластеров высокой доступности Trino. Посмотреть запись можно здесь.
Задача
Являясь одной из команд, обслуживающих платформы данных в Goldman Sachs (GS), мы отвечаем за своевременную передачу точных и проверенных данных корпоративным аналитикам и прикладным программам. В GS мы работаем с различными типами данных, такими как данные о сделках, оценках, продуктах от внешних поставщиков и т.д. Эти наборы данных могут храниться в различных гетерогенных источниках данных, таких как HDFS, S3, Oracle, Snowflake, Sybase, Elasticsearch и MongoDB. Каждый из этих вариантов представляет наборы данных по-разному, с каждым из них нужно работать индивидуально. Проблема, с которой мы столкнулись, заключалась в том, чтобы централизовать доступ к этим данным, сделать так, чтобы нашим аналитикам данных было удобно работать с ними.
Наши основные задачи заключались в следующем:
- Сокращение «последней мили» ETL (Extract, Transform, Load). Обслуживание конвейеров ETL сопряжено с большим количеством трудностей (устранение различных сбоев в работе конвейера, проведение сверки и т.д.).
- Унифицированный доступ к данным - общий язык (SQL) для доступа к различным типам источников данных.
- Федеративные объединения - способ объединения наборов данных, находящихся в различных источниках данных.

Решение
Trino, распределенный движок запросов SQL с открытым исходным кодом, предоставляет пользователям возможность запрашивать различные наборы данных через единую унифицированную платформу. Пользователи могут подключаться сразу к нескольким источникам данных и выполнять федеративные объединения с помощью архитектуры, основанной на коннекторах, что позволяет избежать излишних затрат на разработку и обслуживание ETL.
Интеграция Trino во внутреннюю экосистему Goldman Sachs
Первым нашим шагом была интеграция Trino в локальную экосистему Goldman Sachs. Это означало следующее:
- Интеграция с внутренними системами аутентификации и авторизации.
- Интеграция с внутренними системами отслеживания, мониторинга и аудита.
- Интеграция с внутренними хранилищами учетных данных.
- Интеграция со службами обнаружения и каталогизации данных.
- Поддержка новых коннекторов для источников данных, таких как SingleStore, Sybase и др.
- Обновление различных существующих коннекторов, таких как Elasticsearch, Mongo DB и т. д.
Мы смогли расширить плагины Trino для поддержки всех вышеперечисленных интеграций. Например, для сбора статистики на уровне запросов мы реализовали интерфейс EventListen erFactory . Кроме того, в рамках этого процесса мы обеспечили возврат всех соответствующих патчей в сообщество разработчиков Trino - например, коннектора SingleStore, коннектора MongoDB и коннектора Trino.
Достижение масштабирования и высокой доступности
Типичный кластер Trino состоит из координатора и нескольких рабочих узлов. Мы можем масштабировать кластеры, добавляя больше рабочих узлов, но координатор по-прежнему остается единственной точкой отказа. Затем мы пересмотрели наши требования, чтобы определить наилучший путь развития.
Мы хотели добиться следующего:
- Масштабирование
- Высокая доступность
- Многопользовательский доступ
- Изоляция ресурсов
- Возможность выполнения «сине-зеленых» развертываний
Мы достаточно быстро поняли, что для выполнения всех вышеперечисленных требований нам потребуется многокластерная система. Чтобы обойти ограничения, связанные с наличием одного координатора, мы решили использовать прокси-уровень на базе Envoy с группой кластеров за ним.
Экосистема Trino в компании Goldman Sachs
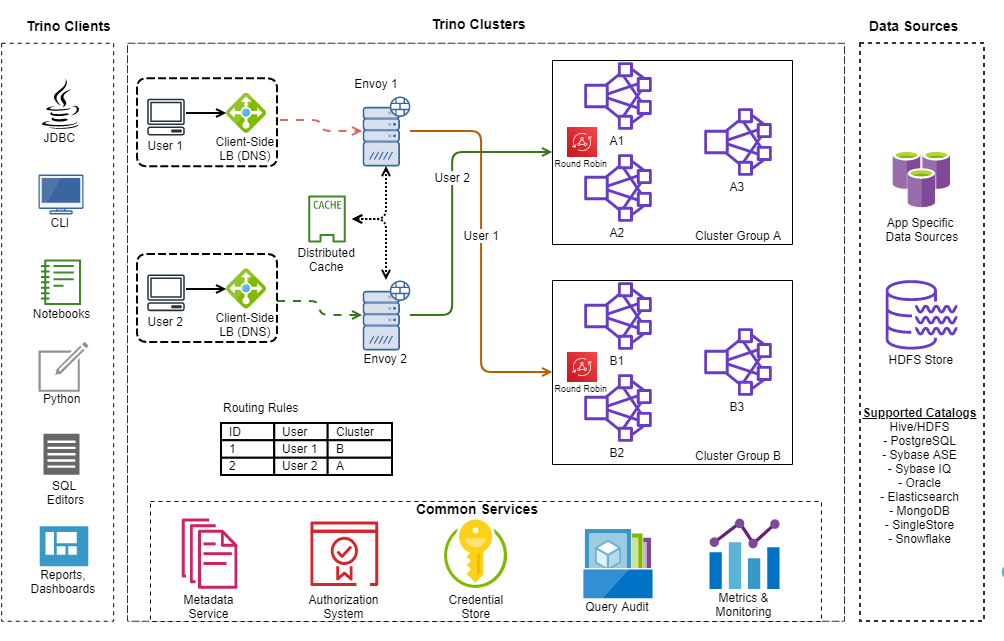
На схеме показано, как именно мы интегрировали кластеры с нашими собственными системами аутентификации, авторизации, каталогизации данных и мониторинга. Все эти системы составляют операционную основу нашего Trino. Мы поддерживаем как облачные, так и локальные источники данных. Мы также установили связь с хранилищем Hadoop Distributed File System (HDFS) через коннектор Hive.
Для подключения к Trino пользователи используют различные клиенты, такие как CLI, JupyterHub, SQL-редакторы, пользовательские инструменты отчетности и другие приложения на основе JDBC. Когда пользователь отправляет запрос, он сначала попадает на балансировщик нагрузки на стороне клиента (LB на основе DNS). LB направляет запрос на нижележащий маршрутизатор envoy. Маршрутизатор анализирует заголовок запроса, чтобы определить пользователя для этого запроса, и на основе пользователя определяет, в какую кластерную группу следует направить запрос. Как только запрос попадает в кластерную группу, он назначается на один из ее дочерних кластеров. В приведенном выше примере, когда пользователь (User 1) отправляет запрос, он направляется в кластерную группу B в соответствии с определенными правилами маршрутизации. Он может быть направлен в дочерние кластеры B1, B2 или B3.
В следующем разделе логика маршрутизации рассматривается более подробно.
Динамическая маршрутизация запросов
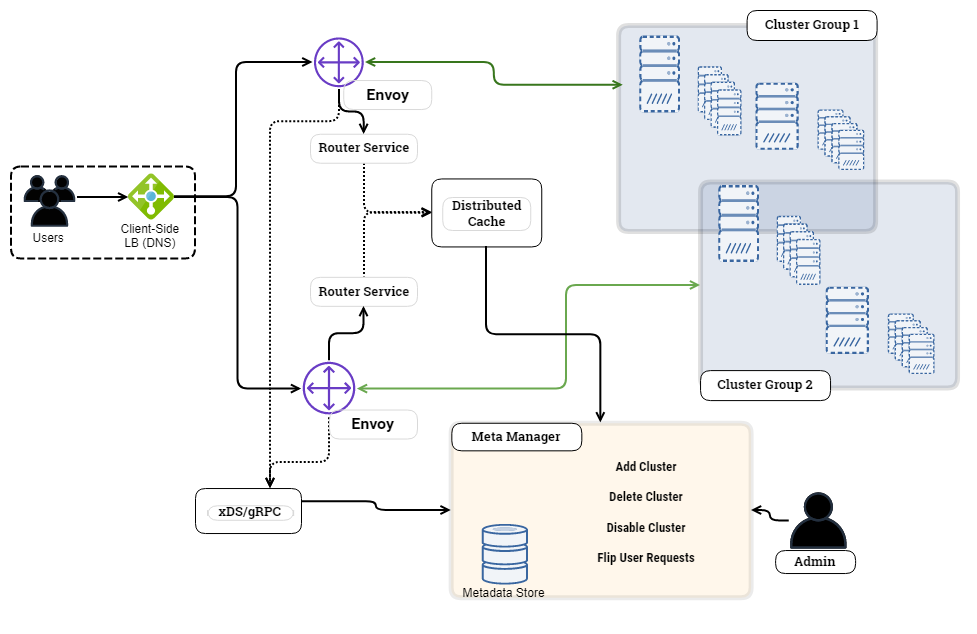
Основные компоненты
Envoy
Envoy - прокси-сервер с открытым исходным кодом, предназначенный для облачных приложений. Envoy предоставляет такие функции, как маршрутизация, управление трафиком, балансировка нагрузки, внешняя авторизация, ограничение скорости и многое другое. Мы используем Envoy в качестве шлюза Trino. Он помогает нам добиться динамической маршрутизации извне без изменения работы Trino по умолчанию.

На рисунке выше изображен сервер xDSLDS
- Listener Discovery Service - с помощью этого API Envoy может динамически добавлять/удалять/обновлять весь Listener, включая фильтры L4/L7.
- CDS - Cluster Discovery Service - с помощью этого API Envoy может динамически добавлять/обновлять/удалять кластеры восходящего потока.
- RDS - Route Discovery Service - с помощью этого API Envoy может добавлять/обновлять таблицы маршрутов HTTP.
- EDS - Endpoint Discovery Service - с помощью этого API Envoy может добавлять/обновлять членов кластера
Группы кластера
В нашем случае группа кластеров - это логическое пространство имен, которое сопоставляется с несколькими кластерами Trino. Например, кластерная группа A может быть сопоставлена с дочерними кластерами A1 и A2. Любой запрос, приземляющийся на кластерную группу, балансируется между дочерними кластерами. Уровень маршрутизации обладает интеллектуальными возможностями для балансировки нагрузки между дочерними кластерами по принципу «круговой поруки». Мы также интегрировали наши кластерные группы с API для проверки состояния кластеров, чтобы вовремя удалять нездоровые дочерние кластеры.
В целом существует три различных типа кластерных групп:
- Кластерная группа по умолчанию: это наша основная кластерная группа. Если пользователь не назначен в кластерную группу явно, его запросы направляются в группу по умолчанию. Одновременно может существовать только одна кластерная группа.
- Назначенная кластерная группа: назначенных кластерных групп может быть несколько. Если пользователь определен в одну из назначенных кластерных групп, его запросы направляются в соответствующую группу. Это помогает нам сегментировать входящую рабочую нагрузку.
- Резервная кластерная группа: Трафик будет направляться в резервную кластерную группу, если не работает кластерная группа по умолчанию или назначенная кластерная группа. Это помогает обеспечить отказоустойчивость в случае внезапного отключения кластера.
Когда пользователь хочет провести специальный анализ и не уверен в своих требованиях, мы направляем его трафик в кластерную группу по умолчанию. Когда пользователь определился со своими требованиями и хочет изолировать свою рабочую нагрузку от других трафиков, мы направляем их в выделенную кластерную группу.
Служба метаданных кластера
Служба метаданных - это служба, которая предоставляет маршрутизаторам Envoy все конфигурации, связанные с кластером. Она содержит сопоставления для групп кластеров, групп кластеров с дочерними кластерами, пользователей с группами кластеров и т. д. DevOps или администраторы кластеров используют этот сервис для управления кластерами. Служба метаданных предоставляет API для следующих операций:
- Группа кластеров:Добавить/Обновить/Удалить
- Кластер: Добавить/Обновить/Удалить
- Кластер: Назначить/снять назначение кластера кластерной группе
- Кластер: Активировать/Деактивировать
- Пользователь: Добавить/Удалить
Служба маршруизации
Плоскость управления Envoy - Служба xDs на основе gRPC, отвечающая за предоставление динамических конфигураций Envoy. При запуске Envoy запрашивает API xDs для того, чтобы динамически получить конфигурации кластера, расположенного выше. Он периодически опрашивает службу метаданных для того, чтобы вовремя обнаружить изменения в конфигурации кластера. Мы можем добавлять, обновлять или удалять кластеры, расположенные выше, без перезапуска плоскости управления Envoy.
Выбор кластера, расположенного выше
Для разбора и изменения заголовков запроса и ответа Envoy предоставляет HTTP-фильтры. Мы используем свой собственный фильтр Lua. Затем мы вызываем службу маршрутиации, которая возвращает адрес кластера, расположенного выше. При выборе кластеров также выполняется проверка их работоспособности.
Проблемы, связанные с привязкой узлов
В отличие от простых HTTP-запросов, которые являются независимыми, Trino следует следующему протоколу JDBC:
- POST по адресу /v1/statement выполняет строку запроса в теле POST и возвращает JSON-документ, содержащий результаты запроса. Если результатов слишком много, JSON-документ содержит URL-атрибут nextUri.
- GET возвращает следующую порцию результатов запроса по атрибуту nextUri.
- DELETE завершает обработку запроса.
Это означает, что на этапе маршрутизации, если запрос направляется в кластер, все последующие вызовы nextUri также должны направляться в тот же самый кластер. Мы решаем эту проблему, сохраняя карту запросов к кластерам в слое распределенного кэша. Поток процессов выглядит следующим образом:
- Клиент Trino инициирует POST на /v1/statement, который попадает на шлюз Envoy.
- on_request()
- Envoy анализирует заголовок, извлекает x-trino-user и вызывает службу маршрутизатора, чтобы получить кластер восходящего потока.
- Затем он устанавливает заголовок cluster_header с именем кластера, находящегося выше. Envoy направляет запрос, считывая этот заголовок.
- on_response()
- Мы получаем ответ от вышестоящего кластера, затем разбираем ответ, чтобы извлечь идентификатор запроса и адрес кластера.
- Затем мы сохраняем query_id для сопоставления адреса кластера с распределенным кэшем.
С этого момента все вызовы nextUri сверяются с этой картой в целях маршрутизации.
Заключение
Мы используем Trino для множества приложений - от аналитики до качества данных, отчетности и т. д. В Goldman Sachs мы попытались создать экосистему, которая поможет управлять нашей инфраструктурой Trino наиболее эффективным образом. С помощью вышеописанной архитектуры мы достигли этой цели и будем продолжать работать над дальнейшими оптимизациями и усовершенствованиями.


