

Инструменты и технология архитектура DG
Глава посвящена инструментам и технологическим аспектам архитектуры Data Governance (DG). Здесь мы разобрали, какие технологии обычно входят в DG-стек, как они взаимодействуют между собой, и как их применяют на практике для построения эффективной operating model DG: от метаданных и каталога данных до контроля доступа и обеспечения качества. В реальных проектах DG — это не просто набор инструментов; это связка дисциплин, процессов и ролей, которые должны работать в единой архитектуре и под управлением бизнес-целей компании.
Ключевые идеи, которые мы охватим в этой главе:
- Архитектурные слои DG: от источников данных до политики доступа и аудита.
- Технические концепции: метаданные, линейность данных, бизнес-словарь, контроль качества, управление данными по доменам.
- Встраивание DG в бизнес-процессы: как оформить RACI, как связать DG-активности с процессами и правилами.
- Практические примеры: как развернуть open-source решения (Atlas, Ranger, OpenMetadata, DataHub и пр.), как реализовать локальные/российские решения внутри корпоративной экосистемы.
- Технические детали развертывания: примеры конфигураций, API и скриптов.
- Риски и ограничения: юридические, организационные, технологические проблемы и пути их минимизации.
В DG мы говорим об управлении данными как о системном наборе активов, которые нуждаются в описании, защите, контроле качества и доступности. Технологии здесь поддерживают процессы: каталогизация, каталогирование метаданных, линейка данных (data lineage), политика доступа, качество данных и мониторинг.
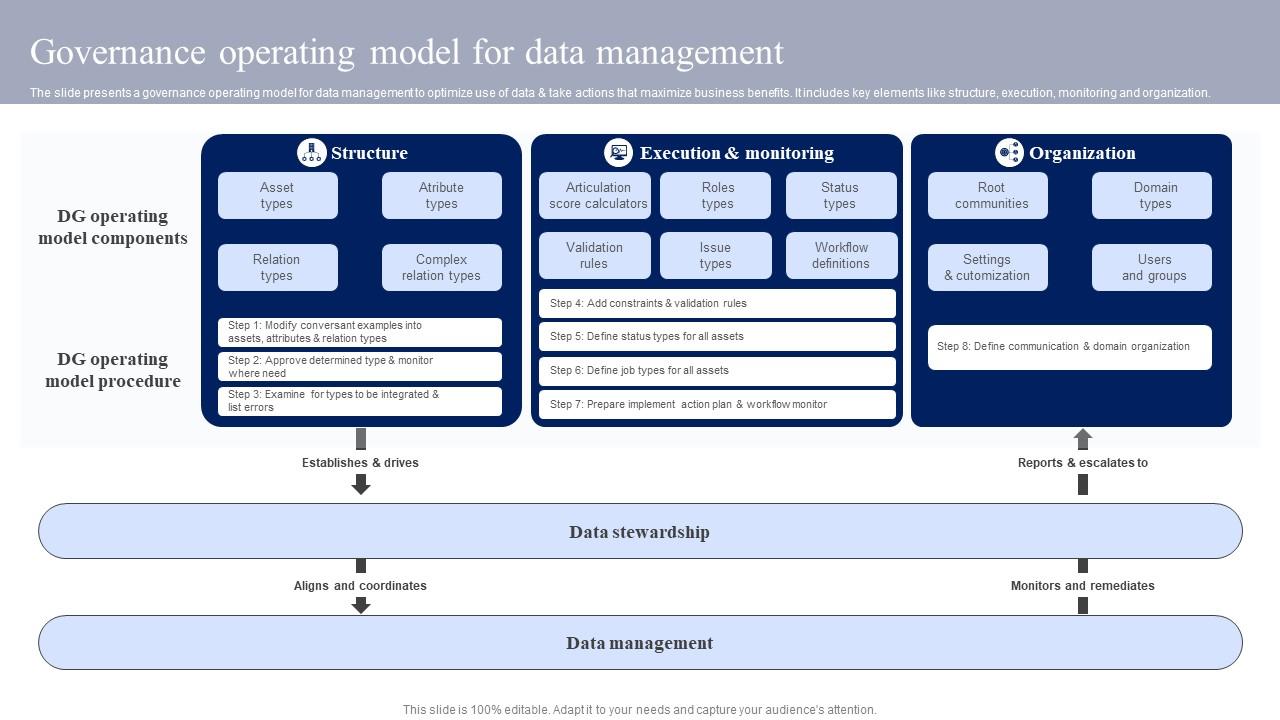
Ключевые понятия и термины
- Метаданные (metadata): данные о данных. В DG это не только технические поля (тип, размер), но и бизнес-описания, ответственность, происхождение, качество и контекст.
- Каталог данных (data catalog): централизованный реестр активов данных с описанием, владением, контекстом и связями.
- Линейка данных (data lineage): путь данных от источника к потребителю, включая преобразования и зависимые системы.
- Бизнес-словарь (business glossary): общепринятые определения бизнес-терминов и их связь с техническими объектами.
- Политики и правила доступа (policy engine): механизм определения, кто имеет доступ к каким данным и при каких условиях.
- Управление качеством данных (data quality): набор проверок, метрик и правил для оценки корректности данных.
- Доменная модель (domain model): разделение данных по предметным областям (например, клиент, продукт, транзакция) и согласование терминологии между бизнесом и IT.
- RACI: распределение ролей и ответственности (Responsible, Accountable, Consulted, Informed) в DG-процессах.
- Управление жизненным циклом данных: создание, хранение, использование, архивирование и удаление данных с учётом требований регуляторов.

Архитектура DG как концептуальная модель обычно включает следующие слои
- Источники данных и сервисы: базы данных, хранилища, потоковые системы, файлы и внешние источники.
- Ингест/метаданные (Ingestion/Metadata): сбор и нормализация метаданных из источников.
- Каталог и репозитории метаданных: центральный реестр объектов данных, их характеристик, владельцев и зависимостей.
- Линейка данных и происхождение: трассируемость данных и преобразований.
- Контроль качества: правила, проверки и дью-дилиджи качества.
- Политики доступа и безопасность: доступ к данным, шифрование, аудит и соответствие требованиям.
- Управление процессами и уведомления: workflow, согласования, эскалации.
- Интеграция с бизнес-процессами: правила внедрения DG в оперативные процессы.
Методологии и рамки, которые полезно учитывать
- DAMA-DMBOK: базовый справочник по управлению данными и DG-процессам.
- TOGAF/ArchiMate: архитектурные методологии для проектирования и моделирования архитектуры DG в контексте всей корпоративной архитектуры.
- ITIL/COBIT: управление услугами и контроль качества процессов.
- Model-Driven Governance: моделирование доменных областей и правил взаимодействия с данными на уровне бизнес-логики.
- RACI-аналитика: четкое распределение ролей и ответственности в DG-процессах.
Термины, которые стоит постоянно держать под рукой
- Активы данных (data assets): наборы данных, таблицы, файлы, потоки и т.д.
- Метаданные бизнес-термины: понятия, термины и определения, которые используются бизнес-пользователями.
- Модель владения: кто несет ответственность за набор данных, его качество и доступность.
- Политика соответствия: правила, которые описывают, как данные должны обрабатываться в рамках регуляторных требований.
- Метрические показатели качества: точность, полнота, консистентность, актуальность, доступность.
Практическая мысль: DG — это не только инструменты, но и процессы, которые должны быть встроены в повседневные бизнес-процессы. Модели владения, проверки качества и политики доступа должны быть тесно интегрированы с процессами согласования, разработки и эксплуатации данных.
Практические примеры
Ниже приведены конкретные сценарии использования инструментов DG в реальной среде. Мы рассмотрим как работать с open-source решениями и как ориентироваться в российских реалиях.
Пример 1: Архитектура на базе Apache Atlas, Apache Ranger и OpenMetadata
Цель: создать единый каталог метаданных, обеспечить контроль доступа, линейку данных и базовую политику качества.
Архитектура
- Apache Atlas: метаданные, линейка, связь между объектами.
- Apache Ranger: управление политиками доступа (ACL, IAM, политику).
- OpenMetadata (open-source): современный каталог, UI, интеграции, управление качеством, бизнес-словарь, графовые связи между активами.
- Источники данных: Hive, BigQuery (примерно), Postgres, S3, Kafka.
- Контроль качества: Great Expectations или встроенные проверки Atlas/Ranger.
Развертывание (упрощённый сценарий)
- Развернуть Docker Compose стек Atlas + Ranger + OpenMetadata.
- Подключить источники данных и настроить метаданные.
- Настроить линейку: Atlas может восстанавливать lineage через трансформации (например, Spark SQL).
- Настроить политики доступа в Ranger для конкретных баз данных/таблиц.
- Заполнить бизнес-словарь и доменные термины в OpenMetadata.
Пример конфигурации (OpenMetadata)
# openmetadata/docker-compose.yaml (упрощённый пример)
version: "3.8"
services:
  openmetadata:
    image: openmetadata/metadata
    ports:
      - "8585:8585"
    environment:
      - OM_DB_HOST=db
      - OM_DB_PORT=5432
      - OM_DASHBOARD_ENABLED=true
    depends_on:
      - db

  atlas:
    image: apache/atlas:2.1.0
    ports:
      - "21000:21000"

  ranger:
    image: apache/ranger:2.2.0
    ports:
      - "6080:6080"

  db:
    image: postgres:13
    environment:
      - POSTGRES_PASSWORD=changeit
Пример REST-операции (создание термина в бизнес-глоссарии через OpenMetadata)
POST /v1GlossaryTerms
{
  "term": "Клиент",
  "description": "Лицо или организация, которая взаимодействует с продуктами/услугами",
  "domain": "Маркетинг"
}
Пример RACI-сопоставления (псевдокод)
- asset: customer_dataset
  domain: customer
  owner: "Геннадий Петров"
  responsible: ["БД-инженеры", "Data Stewards"]
  accountable: "Руководитель DG"
  consulted: ["Бизнес-аналитики", "Юристы"]
  informed: ["Служба безопасности", "IT-менеджер"]
Пример линейки данных
- Источник: OLTP база клиентов (PostgreSQL)
- Преобразование: Spark трансформация
- Целевой актив: отчётный набор клиентов (S3)
- Потребитель: аналитический дашборд (Looker/Power BI)
Преимущества и ограничения
- Плюсы: единый каталог, прозрачность происхождения данных, возможности аудита, гибкая политика доступа.
- Минусы: необходимость синхронизации между системами, требования к администрированию, сложность настройки для больших парков источников.
Пример 2: Архитектура на базе Apache Atlas + Data Stewardship
Цель: обеспечить трассируемость данных и расширенную линейку, при этом политика доступа реализуется через внешнюю систему.
Архитектура
- Atlas: основная платформа для метаданных и линейки.
- Встроенный бизнес-глоссарий и модели доменов в Atlas.
- Внешний механизм политики доступа: интеграция через REST API (например, к внутреннему IDM/SSO).
- Источники: Oracle, PostgreSQL, Hadoop/HDFS, Kafka.
Пример конфигурации
- Конфигурация Atlas: настройка типовых сущностей (dataset, process), связи "uses" и "produces".
- Настройка интеграции с SSO через SAML/OAuth.
Пример использования
- В Atlas можно отследить, какие процессы потребляют какие наборы данных и какие преобразования выполняются.
- Включение политики аудит: ведение журнала изменений объектов и доступа.
Пример 3: Great Expectations для качества данных в DG
Цель: обеспечить автоматическую проверку качества на ETL-пайплайнах и в конвейерах потоков данных.
Архитектура
- Great Expectations выполняются как часть пайплайна (на этапе валидации данных).
- Результаты сохраняются в DG-каталог или дашборд ошибок.
- Связь с данными через OpenMetadata/Grafana для визуализации.
Пример кода (Python)
import great_expectations as ge
from ruamel.yaml import YAML

# загрузка пайплайна
context = ge.get_context()

# определение ожиданий для датасета
suite = context.create_expectation_suite(
    expectation_suite_name="customer_dataset_quality"
)

# пример: ожидание уникальности customer_id
suite.add_expectation({
    "expectation_type": "expect_column_values_to_be_unique",
    "kwargs": {"column": "customer_id"},
})

# сохранение и запуск
context.add_suites_to_store_results(suite)
Визуализация с OpenMetadata
- Связать результаты проверок с соответствующим элементом каталога, чтобы бизнес-словарь и владельцы видели качество данных.
Пример 4: Российские решения и локализация DG
Важно помнить, что в российских реалиях вопросы локализации, соответствия требованиям и регуляторной среде являются критичными. Практики включают:
- Использование локальных серверов и дата-центров для хранения чувствительных данных, чтобы соответствовать требованиям локализации и регуляторным нормам.
- Привязка DG-активов к бизнес-локальным процессам: совместимость с российскими системами учёта, документированием и аудитом.
- Аудит и регуляторные отчёты могут быть интегрированы в DG через модуль политики и аудита, чтобы автоматически готовить рапорты для контролирующих органов.
Технически, российские решения часто реализуют:
- Локальные модули регистрации и управления терминами, доменными словарями, а также интеграцию с локальной IDM/SSO.
- Поддержку локализованных форматов времени, кодировок и стандартов документов.
- Контроль доступа в рамках корпоративной сети и через VPN/zero-trust подходы.
Примечание: выбор конкретного российского решения следует проводить через тщательный анализ предложений поставщиков, проверку совместимости с регуляторными требованиями и планом миграции. В реальном проекте рекомендуется запросить демонстрации, тестовые стенды и пути миграции из существующих систем Metadatа/ETL в DG-окружение.
Пример 5: Облачные сервисы и концепции Data Governance
Крупные облачные провайдеры предлагают сервисы для DG, которые упрощают развёртывание и позволят быстро запустить базовую функциональность:
- Управление метаданными в облаке, интеграции с IAM и политиками безопасности.
- Поддержка дата-каталога, линейки, контроля качества и бизнес-словаря.
- API для автоматизации и интеграции с пайплайнами данных.
- Возможности аудита и соответствия.
Практические рекомендации:
- Начинайте с минимально жизнеспособной архитектуры: каталог + линейка + базовая политика доступа.
- Постепенно добавляйте контроль качества, расширенные политики и интеграцию с бизнес-процессами.
- Уделяйте внимание локализации и регуляторным требованиям для российских данных.
Архитектура и слои (картинка в виде текста)
- Источники данных → Ингест/Метаданные → Каталог данных → Линейка данных → Контроль качества → Политики доступа → Workflow/координация → Мониторинг и аудит
- Взаимодействие через API и события (webhook) между слоями.
- Встраивание DG в бизнес-процессы через RACI и политики.
Технические требования
- Сервисы: каталог метаданных, линейка, политику доступа, инструмент качества данных.
- Базы данных: PostgreSQL/MySQL для каталога, графовая база для линейки (например, Neo4j) или встроенная в выбранный инструмент.
- Безопасность: интеграция с IAM, SSO, RBAC, аудит и журналирование.
- Мониторинг и наблюдаемость: Prometheus/Grafana или аналог для мониторинга DG-слоев.
- Контейнеризация: Docker/Kubernetes для развёртывания и масштабирования.
- Регуляторика и локализация: настройка хранения данных внутри территории, соответствие локальным требованиям.
Пример конфигурации OpenMetadata (ключевые элементы)
- Настройка источников данных (data sources) и сущностей метаданных.
- Определение доменных терминов в бизнес-глоссарии.
- Установка связей между данными и их потребителями.
Пример YAML (часть конфигурации OpenMetadata)
apiVersion: v1
kind: ConfigMap
metadata:
  name: om-config
data:
  metadata_service_config.yaml: |
    server:
      host: 0.0.0.0
      port: 8080
    authentication:
      provider: "oauth2"
      clientId: "example-client"
      clientSecret: "secret"
    metadata:
      enabled: true
      bootstrap:
        - dataset: "sales.transactions"
          owner: "data-team@example.com"
Пример политики доступа (усиление RBAC)
Правила: кто может читать таблицу клиентов, кто может писать в словарь терминов, кто может запускать пайплайн. Описание политики в формате YAML или JSON и внедрение через систему управления политиками (policy engine).
Пример (OpenPolicyAgent)
package data.*

default allow = false

allow {
  input.method = "GET"
  input.path = ["datasets", dataset]
  dataset.owner == input.user
}
Пример интеграции с бизнес-процессами
- Встраивание DG в процессы согласования данных, разработки норм и политик, аудита.
- Связь DG-активов с бизнес-подразделениями и рольами.
Модель доменных областей и RACI
- Доменные области: Клиент, Продукт, Финансы, Операции и т.д.
- Для каждой области устанавливаются термины, владение, правила доступа и ответственные лица.
Пример RACI в DG (таблица)
| Актив | Доменная область | Owner | Responsible | Accountable | Consulted | Informed |
|---|---|---|---|---|---|---|
| Клиентские данные | Клиент | Отдел данных | Data Stewards | CPO | Бизнес-аналитики, Юристы | IT-директор, СБ |
Практические советы по внедрению
- Начинайте с малого: выберите 1–2 доменные области и 1–2 источника данных для пилота.
- Определите бизнес-термины и глоссарий: обеспечьте единое понимание терминов.
- Настройте аудит и базовую линейку: чтобы иметь возможность отслеживать изменения и происхождение данных.
- Привлекайте бизнес: вовлеките владельцев данных и стейкхолдеров в процесс согласования и политики.
Риски и ограничения внедрения
- Сложность интеграции: разные источники данных, разные форматы и схемы.
- Риск несогласованности терминов: бизнес-глоссарий и технические термины должны быть синхронизированы.
- Обновления и миграции: как поддерживать актуальность каталога и линейки при частых изменениях в источниках.
- Вопросы конфиденциальности и соответствия: локализация данных, требования ФЗ и регуляторные нормы.
- Уровень зрелости организации: нехватка квалифицированных специалистов, сложность внедрения и поддержки DG.
- Вендорная зависимость и риск задержек: если выбирается конкретная платформа, необходимо планировать эволюцию и миграции.
- Масштабирование: при росте числа источников и активов усложняется поддержка и мониторинг.
- Безопасность: управление доступом, аудиты и требования к шифрованию.
- Стоимость: лицензии, инфраструктура, сопровождение и обучение.
Меры снижения рисков:
- Постепенная реализация пилотных проектов с чётко определённой целью и KPI.
- Использование гибкого стека и открытых стандартов (open-source, API-first).
- Переход к совместному владению данными с бизнес-подразделениями и создание команды DG (Data Governance Office).
- Стандарты документации и регламенты процедур DG.
- План миграции и быть готовым к замещению компонентов.
Выводы
Инструменты DG и их технологическая архитектура — это не только набор инструментов, но и устойчивый, управляемый процесс. Эффективная DG-архитектура требует:
- Четкой доменной модели и единых бизнес-терминов.
- Прозрачной линейки и прослеживаемости данных.
- Надежной политики доступа и аудита.
- Встроенной в бизнес-процессы модель RACI.
- Сбалансированной комбинации open-source решений и локальных российских реализаций, учитывающих требования локального регуляторного контекста.
- Постепенной эволюции инфраструктуры с учётом рисков и возможностей роста.
Эта глава даёт практические ориентиры по выбору инструментов, настройке инфраструктуры и проектированию архитектуры DG для поддержки управляемого и соответствующего бизнес-операционного процесса.
Таблица: обзор инструментов DG (open-source vs. российские реалии)
| Инструмент/Подход | Тип | Основные функции | Преимущества | Ограничения | Применение в DG |
|---|---|---|---|---|---|
| Apache Atlas | Open-source | Метаданные, линейка, связь объектов | Глубокая интеграция с Hadoop-экосистемой, активное сообщество | Могучая настройка, иногда сложна в эксплуатации | Каталог, линейка, доменные модели |
| Apache Ranger | Open-source | Управление политиками доступа, RBAC | Гибкость политик, аудит | Усложнение интеграции с внешними источниками | Защита данных, управление доступом |
| OpenMetadata | Open-source | Каталог, глоссарий, интеграции | Современный UI, бизнес-словарь, поддержка множества источников | Требуется настройка инфраструктуры | Каталог, бизнес-словарь, качество |
| DataHub | Open-source | Каталог, линейка, интеграции | Быстрое развёртывание, гибкость | Ограниченная функциональность в некоторых областях | Каталог, линейка |
| Great Expectations | Open-source | Контроль качества, проверки данных | Простота использования, интеграция с пайплайнами | Отдельное решение для качества, требует связки | Качество данных, пайплайны |
| Российские решения (локальные платформы DG) | Российские решения | Локализация, совместимость с локальными системами, аудит | Соответствие регуляторной среде, локальная поддержка | Могут быть ограничены в функциональности по сравнению с глобальными аналогами | Соответствие локальным регуляторам, локальная инфраструктура |
Примечание: в российской практике выбор инструментов часто осуществляется через локальных интеграторов и партнеров. Важно проверить совместимость, дорожную карту и регуляторные требования, а также план миграции из существующих систем в DG-окружение.
FAQ (Вопрос–Ответ)
1) Что такое DG-инструменты и зачем они нужны?
- DG-инструменты предоставляют функциональность для управления метаданными, линейкой данных, бизнес-глоссарием, качеством данных и политикой доступа. Они помогают обеспечить прозрачность данных, соответствие регулятивным требованиям и поддержку бизнес-процессов.
2) Как выбрать между open-source и российскими решениями?
- Выбор зависит от регуляторного контекста, бюджета, инфраструктуры и готовности команды поддерживать сложную систему. Open-source решения подходят для гибкости, масштабирования и снижения зависимости от вендора. Российские решения часто обеспечивают лучшую локализацию, соответствие требованиям локального рынка и поддержку. В реальной практике часто выбирают гибридный подход: базовую DG-архитектуру строят на open-source, а западная и локальная функциональность дополняются локальными решениями и интеграциями.
3) Как связаны DG и бизнес-процессы?
- DG встраивается в бизнес-процессы через понятия доменной модели, бизнес-глоссарий и RACI. Владелец данных несет ответственность за активы; бизнес-аналитики участвуют в определении терминов и требований к качеству; политики доступа и аудита позволяют соответствовать требованиям регуляторов и внутренним политикам. DG-процессы должны быть встроены в пайплайны разработки, эксплуатации и анализа.
4) Какие основные риски внедрения DG?
- Неактуальный глоссарий и доменные термины, сложности интеграции с множеством источников, недостаточный профиль квалифицированных специалистов, риск злоупотребления политиками доступа, регуляторные риски и затраты на инфраструктуру.
5) Какой путь внедрения DG наиболее эффективен?
- Начать с пилота на 1–2 доменных областях и ограниченного набора источников данных. Постепенно расширять функциональность: каталог, линейку, качество и политику доступа. Включать бизнес-пользователей и владельцев данных в процесс согласования и обучения.
6) Что такое линейка данных и зачем она нужна?
- Линейка данных отслеживает путь данных от источника до потребителя, фиксируя трансформации и зависимости. Это обеспечивает прозрачность, объяснимость моделей и аудити, что особенно важно в регуляторных сценариях.
7) Какую роль играет бизнес-глоссарий в DG?
- Бизнес-глоссарий обеспечивает единое понимание терминов и определений между бизнесом и IT. Это снижает риск недопониманий, повышает качество data lineage и упрощает коммуникацию в проектах DG.
8) Как реализовать качество данных в DG?
- Реализуйте набор проверок качества через инструменты вроде Great Expectations или аналогов в рамках DG. Свяжите результаты проверок с активами в каталоге, чтобы владельцы видели проблемы и могли принимать исправления.
9) Какие примеры технологий стоит рассматривать для старта?
- Open-source: Apache Atlas, Apache Ranger, OpenMetadata, DataHub, Great Expectations. Российские решения — рассмотреть локальные варианты, ориентированные на регуляторные требования и локальную инфраструктуру, в рамках диалога с поставщиками и интеграторами.
10) Что важно учесть при локализации данных в DG?
- Необходимо обеспечить хранение на территории, соответствие локальным требованиям к персональным данным, аудит и безопасность. Важно иметь договоренности с поставщиками и партнерами, а также планы для миграций и обновлений.


