
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Российские платформы современного стека хранения, обработки и анализа данных » Системы ETL и ELT » Airflow + NiFi » Интеграция Apache Kafka и Spark

Интеграция Apache Kafka и Spark

Пару слов о Spark

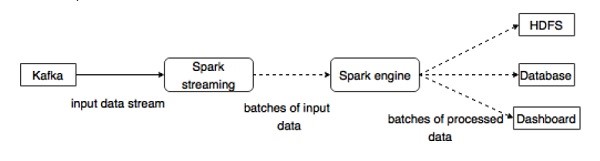
Spark Streaming API обеспечивает масштабируемую, высокопроизводительную и отказоустойчивую обработку потоков данных в режиме реального времени. Данные могут поступать из различных источников, таких как Kafka, Flume, Twitter и т. д.. Их обработка происоходит с помощью сложных алгоритмов, таких как высокоуровневые функции map, reduce, join и window. Обработанные данные могут быть переданы в файловые системы, базы данных и дашборды. Устойчивые распределенные наборы данных (Resilient Distributed Datasets, RDD) - это основах Spark, представляющая собой неизменяемую распределенную коллекцию объектов. Каждый набор данных в RDD делится на логические разделы, каждый из которых может вычисляться на разных узлах кластера.


Интеграция с Spark

Kafka - это платформа обмена сообщениями, которая может быть интегрирована со = Spark. Kafka выступает в качестве центрального узла для потоков данных в режиме реального времени, которые обрабатываются с помощью сложных алгоритмов в Spark Streaming. После обработки данных Spark Streaming может публиковать результаты в топик Kafka или хранить их в HDFS, базах данных или дашбордах.

На диаграмме, представленной ниже, показан схематический поток данных.
 

Теперь давайте подробно рассмотрим интеграцию API Kafka-Spark.


SparkConf API

Представляет собой конфигурацию для приложения Spark, которая применяется для определения его ключевых параметров.

Параметры:

  • set(string key, string value) – устанавливает переменную конфигурации;
  • remove(string key) – удаляет ключ из конфигурации;
  • setAppName(string name) − задает имя приложения;
  • get(string key) – получает ключ


StreamingContext API

Это основная точка входа в систему Spark и доступа к ее функционалу. SparkContext представляет собой соединение с кластером Spark и может использоваться для создания RDD и широковещательных переменных на кластере.

public StreamingContext(String master, String appName, Duration batchDuration,
   String sparkHome, scala.collection.Seq<String> jars,
   scala.collection.Map<String,String> environment)


  • master − URL-адрес кластера, к которому необходимо подключиться (e.g. mesos://host:port, spark://host:port, local[4]).
  • appName – название Вашего задания для отображения в веб-интерфейсе кластера
  • batchDuration − интервал времени, через который потоковые данные будут делиться на партии


Создайте StreamingContext, предоставив конфигурацию, необходимую для новой SparkContext.

  • conf – параметры Spark
  • batchDuration − интервал времени, через который потоковые данные будут делиться на партии


KafkaUtils API

API KafkaUtils используется для подключения кластера Kafka к потоковой передаче данных Spark. В этом API есть важная метод createStream:

public static ReceiverInputDStream<scala.Tuple2<String,String>> createStream(
   StreamingContext ssc, String zkQuorum, String groupId,
   scala.collection.immutable.Map<String,Object> topics, StorageLevel storageLevel)


Метод, описанный выше, используется для создания входного потока, извлекающего сообщения из брокеров Kafka.

  • ssc – объект StreamingContext
  • zkQuorum – кворумZookeeper
  • groupId − группа id для консьюмера.
  • topics – возвращает список топиков для консьюмера.
  • storageLevel − Уровень хранения, используемый для хранения полученных объектов.


В API KafkaUtils есть еще один метод под названием  createDirectStream, который используется для создания входного потока, напрямую извлекающего сообщения из брокеров Kafka без использования приемника. Этот метод гарантирует то, что каждое сообщение из Kafka будет обработано лишь один раз.

Пример приложения, приведенный ниже, выполнен на языке Scala. Для компиляции приложения загрузите и установите sbt и инструмент сборки Scala (аналогичный maven). Основной код приложения представлен ниже.

import java.util.HashMap
import org.apache.kafka.clients.producer.{KafkaProducer, ProducerConfig, Produc-erRecord}
import org.apache.spark.SparkConf
import org.apache.spark.streaming._
import org.apache.spark.streaming.kafka._
object KafkaWordCount {
   def main(args: Array[String]) {
      if (args.length < 4) {
         System.err.println("Usage: KafkaWordCount <zkQuorum><group> <topics> <numThreads>")
         System.exit(1)
      }
      val Array(zkQuorum, group, topics, numThreads) = args
      val sparkConf = new SparkConf().setAppName("KafkaWordCount")
      val ssc = new StreamingContext(sparkConf, Seconds(2))
      ssc.checkpoint("checkpoint")
      val topicMap = topics.split(",").map((_, numThreads.toInt)).toMap
      val lines = KafkaUtils.createStream(ssc, zkQuorum, group, topicMap).map(_._2)
      val words = lines.flatMap(_.split(" "))
      val wordCounts = words.map(x => (x, 1L))
         .reduceByKeyAndWindow(_ + _, _ - _, Minutes(10), Seconds(2), 2)
      wordCounts.print()
      ssc.start()
      ssc.awaitTermination()
   }
}


Составление скрипта

Интеграция spark-kafka зависит от jar интеграции spark, spark streaming и spark Kafka. Создайте новый файл build.sbt и укажите в нем данные о приложении и его зависимости. В процессе компиляции и упаковки приложения sbt загрузит необходимый jar-файл.

name := "Spark Kafka Project"
version := "1.0"
scalaVersion := "2.10.5"
libraryDependencies += "org.apache.spark" %% "spark-core" % "1.6.0"
libraryDependencies += "org.apache.spark" %% "spark-streaming" % "1.6.0"
libraryDependencies += "org.apache.spark" %% "spark-streaming-kafka" % "1.6.0"


Компиляция / Упаковка

Для компиляции и упаковки jar-файла приложения выполните следующую команду. Для запуска приложения отправьте jar-файл в консоль spark

 sbt package


Отправка приложения в Spark

Запустите Kafka Producer CLI (смотрите предыдущую статью), создайте новый топик под названием my-first-topic и предоставьте несколько сообщений:

Another spark test message


Для отправки приложения в консоль Spark используйте следующую команду:

/usr/local/spark/bin/spark-submit --packages org.apache.spark:spark-streaming
-kafka_2.10:1.6.0 --class "KafkaWordCount" --master local[4] target/scala-2.10/spark
-kafka-project_2.10-1.0.jar localhost:2181 <group name> <topic name> <number of threads>


Пример вывода приложения:

spark console messages ..
(Test,1)
(spark,1)
(another,1)
(message,1)
spark console message ..


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Apache Kafka: алгоритм установки
Следующая статья →
Apache Kafka: Введение
Запросить видео презентацию Запросить доступ к демо стенду online Узнать стоимость лицензий

Задать вопрос

loading...

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • Торгово-производственному холдингу ТБМ, специализирующемуся на поставке комплектующих и фурнитуры для производства окон, дверей, стеклопакетов и мебели, был необходим аналитический инструмент для выявления узким мест и поиска зон роста бизнеса и, как результат, оптимизации процессов. Добиться этого можно было, только внедрив data-driven подход.

  • Группа компаний «Галакс» ведет свою деятельность с 2005 года, являясь в те годы дистрибьютором известных международных марок в ряде крупнейших торговых сетей России в сегменте аудио и видео аксессуаров. Активно работая в этом направлении и приобретая ценный опыт, начали создавать собственные торговые марки «GAL» и «VIXTER»

  • Компания «Бизон-Трейд» является официальным дилером ведущих мировых производителей сельскохозяйственной техники (Fendt, Valtra, Lemken и др.) на Юге России. Входит в состав агрохолдинга «Бизон», основанного в 1994 году. Имеет 8 филиалов в Краснодарском и Ставропольском краях, Ростовской области.

  • В 2003 году Мерсико и пятью микрокредитными агентствами Мерсико было принято историческое решение о консолидации активов по всей территории Кыргызстана в целях образования национального финансового института по развитию сообществ - Компаньона. В октябре 2004 года Компаньон был зарегистрирован Национальным банком Кыргызской Республики.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.