

Итог проекта: настройка каталога под Lakehouse
Цель этой главы — закрепить знания и дать конкретную дорожную карту по настройке и эксплуатации каталога Iceberg в рамках Lakehouse. Мы рассмотрим, зачем нужен каталог, какие типы каталогов существуют, как выбор архитектуры влияет на управляемость данными, безопасность и устойчивость к изменениям, а также приведем практические примеры внедрения на open-source решениях и в рамках российских реалий. В конце главы вы найдете FAQ, где ответим на наиболее распространенные вопросы, которые возникают в процессе реализации проекта.
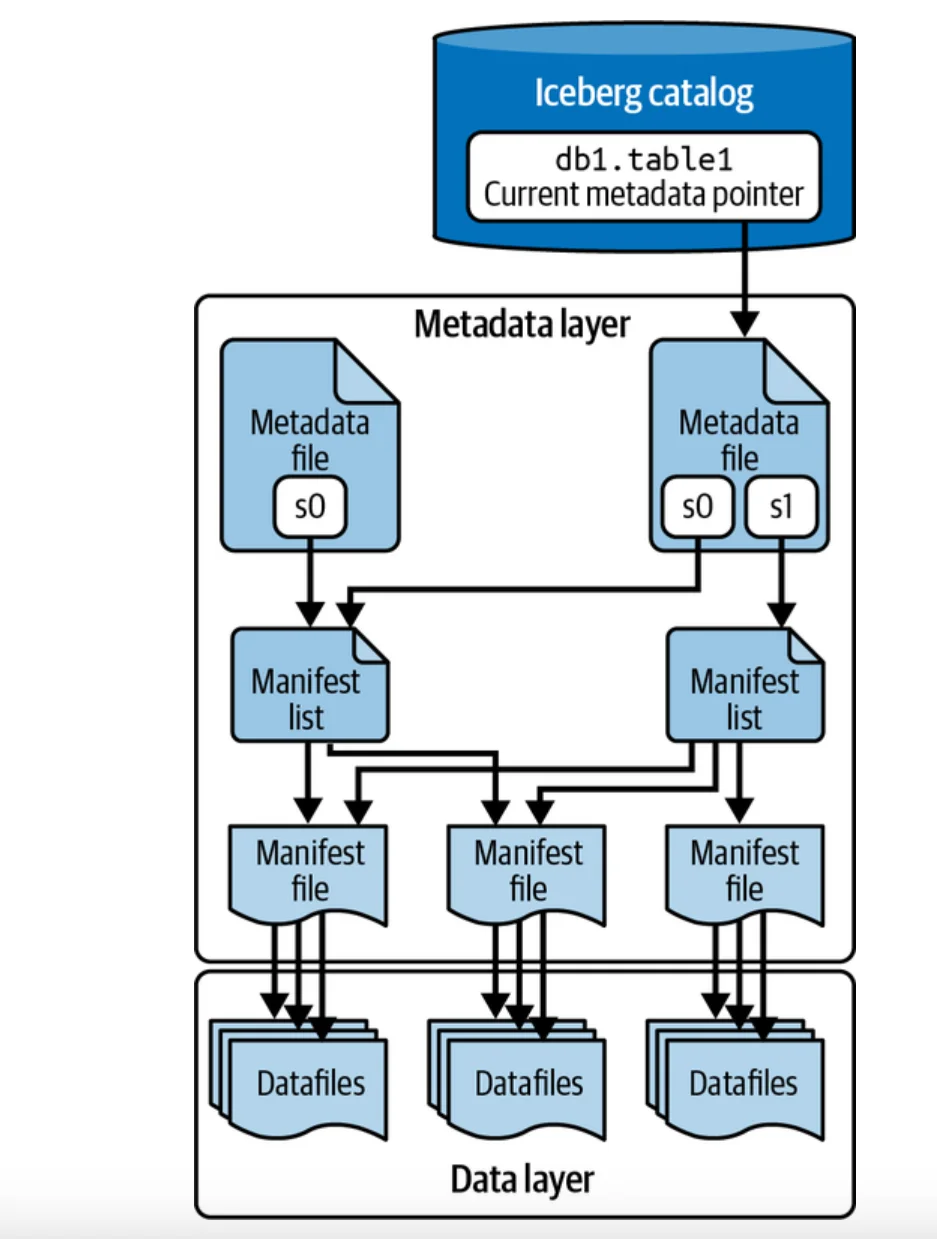
Что такое каталог в Iceberg и почему он важен
Iceberg — это таблица-менеджер для хранения больших наборов данных в формате открытого Lakehouse. Он решает проблемы традиционных data lakes: управление схемами, безопасное обновление схем в гибком виде, детальная версия данных и эффективное чтение больших объемов. Центральным элементом этой архитектуры является каталог — слой метаданных, который хранит информацию об пространствах имен (namespace), таблицах, их версиях и пути к физическому хранилищу.
Каталог выступает фасадом над метаданными Iceberg и обеспечивает единый интерфейс для разных компонентов стека: вычислительные движки (Spark, Trino/Presto, Flink), инструменты бизнес-аналитики и сервисы управления данными. В зависимости от выбранного типа каталога вы можете разместить метаданные в Hive Metastore, в облачном хранилище (локальный файл-фрейм), через Nessie (Git-подобный каталог) или через REST API. Важно помнить: каталог не хранит сами данные таблиц, он хранит только сведения о структуре, версиях и местоположении файлов таблицы на объектном хранилище.
Ключевые понятия и принципы
- Lakehouse: объединение возможностей хранения данных в дата-лагере (data lake) и аналитической обработки данных в warehouse. Основные задачи — единый уровень управления метаданными, поддержка схематических изменений, транзакционность и ускорение аналитики.
- Каталог Iceberg: слой метаданных, который управляет пространствами имен, таблицами, версиями и местами хранения файлов. Каталог обеспечивает единый путь к данным независимо от используемой вычислительной платформы.
- Пространство имен (namespace) и таблица (table): в Iceberg пространство имен группирует таблицы по проекту/функции и поддерживает иерархическую структуру. Таблица содержит метаданные о схемах, файлах данных и манифестах.
- Метаданные и версия: Iceberg хранит версионность данных на уровне таблиц, что позволяет откатываться к предыдущим состояниям без копирования больших массивов данных.
- Типы каталогов: HiveCatalog, HadoopCatalog, NessieCatalog, RestCatalog и т. д. Каждый тип имеет свои плюсы и ограничения в зависимости от среды выполнения, требований к консистентности и управления доступами.
- Несколько важных понятий: Snapshot (моментальная копия таблицы в конкретный момент времени), Manifest File (метаданные о файлах данных), Metadata File (при каждом изменении таблицы создается новый набор файлов метаданных), Namespace и Namespace mapping.
Архитектурные решения: как выбрать тип каталога
- Hive Metastore (HiveCatalog): хорошо подходит для сценариев, где уже есть инфраструктура Hadoop/Hive в кластере и требуется тесная интеграция с существующими метаданными. Преимущества — зрелость, широкая поддержка, простота. Риск — зависимость от стабильности Hive Metastore и возможная сложность масштабирования в больших конфигурациях.
- HadoopCatalog: применим для локальных файловых систем, без отдельного сервиса метаданных. Хорош для локальных тестовых сред, но ограничен масштабируемостью и не поддерживает централизованный доступ к метаданным по сети.
- NessieCatalog: использует Nessie — Git-подобный каталог, который обеспечивает версионирование и ветвление метаданных. Преимущества — удобная история изменений, возможность параллельной работы над несколькими версиями каталога, легкая интеграция с CI/CD и прозрачность изменений. Риск — дополнительная инфраструктура Nessie и изменение модели эксплуатации.
- RestCatalog: централизованный REST API для каталога. Удобен для распределенных сред и для тех, кто хочет минимизировать зависимость от конкретного хранилища метаданных; требует наличия стабильного REST сервиса.
Методологии внедрения
- Права и контроль доступа: организация должна определить, кто может создавать/изменять таблицы, кто имеет доступ к метаданным и кто может выполнять операции DDL/DML. Рекомендовано внедрять интеграцию с существующими системами контроля доступа (Ranger, IAM, Kerberos), а также учитывать аудит изменений в метаданных.
- Безопасность и соответствие требованиям: шифрование на уровне хранения метаданных, а также контроль доступа к объектному хранилищу. В случае Nessie следует обеспечить защиту доступа к Nessie-серверу и корректную политику ветвления.
- Управление версиями и миграциями: особенность Iceberg — поддержка гибкой эволюции схем. В Nessie можно вести версиями каталога как в Git, что упрощает миграции между окружениями (dev/stage/prod) и откаты.
- Многофазная архитектура: разделение каталога и вычислительных ресурсов. В крупных компаниях особенно полезна изоляция каталогов по проектам или отделам, с общим метаданным в центральном каталоге.
- Мониторинг и операционное обслуживание: сбор метрик, журналирование изменений, уведомления в случае ошибок синхронизации каталога с данными. Важно предусмотреть хранение ошибок и механизм автоматического повторного выполнения операций.
Практические примеры
open-source решения
1) Классический сценарий с Hive Metastore и Iceberg
Архитектура: кластеры Spark/Trino читают таблицы Iceberg, метаданные хранятся в Hive Metastore, данные — на объектном хранилище (S3-compatible или HDFS).
Конфигурация Iceberg:
В файле настроек или через код задаются параметры каталога:
    icebergs.catalog.hadoop.warehouse=/data/iceberg/warehouse
    iceberg.catalog.hadoop=org.apache.iceberg.hive.HiveCatalog
    hive.metastore.uris=thrift://metastore-host:9083
Преимущества: простота разворачивания, совместимость с существующими инфраструктурами, хорошо документировано.
Как начать: запустить Hive Metastore, подготовить каталоги, создать таблицу Iceberg через Spark или Trino, проверить чтение и запись.
2) Nessie как версия каталога
Архитектура: Nessie хранит ветви/коммиты каталога, Iceberg таблицы подключаются через NessieCatalog.
Конфигурация:
  iceberg.catalog.nessie.type= nessie
  iceberg.catalog.nessie.uri=http://nessie-server:19120/api/v1
  nessie.url=http://nessie-server:19120
Преимущества: версионирование каталога упрощает параллельную работу команд, безопасные миграции, возможность отката.
Что потребуется: Nessie сервер, аутентификация; инструментальные клиенты для CI/CD.
Как начать: запустить Nessie (в Docker/контейнерах или на своих серверах), создать базовую схему каталога, мигрировать существующие таблицы в NessieCatalog и проверить совместимость с Spark/Trino.
3) RESTCatalog — упрощенная интеграция и кросс-компонентная совместимость
Архитектура: Iceberg использует RESTCatalog через единый REST endpoint; вычислительные движки обращаются к каталогу по HTTP.
Конфигурация:
  iceberg.catalog.rest.uri=http://catalog-service/api/v1
  iceberg.catalog.rest.type=rest
Преимущества: уменьшение сложности на стороне клиентов, единый интерфейс доступа к каталогу.
Применение: полезно в организациях с централизованной службой каталогов и ограничением на прямые обращения к Hive Metastore.
Российские решения и практики внедрения
1) Локальная инфраструктура Hive Metastore в российских дата-центрах
- Архитектура: верифицированная инфраструктура данных с локальным Hive Metastore, что обычно соответствует требованиям регуляторов и локализации данных.
- Как применяется: Iceberg с HiveCatalog размещается поверх локального метаданных-узла Hive Metastore, данные хранятся в отечественном объектном хранилище или локальных файловых системах.
- Преимущества: полная совместимость с открытыми технологиями, возможность использования знакомых инструментов и политик безопасности.
- Ограничения: масштабирование может потребовать дополнительной настройки, репликации и балансировки нагрузки на Metastore и хранилище.
2) Российские облачные платформы и интеграции
- Яндекс.Облако, СберКлауд и другие провайдеры российского рынка постепенно расширяют сервисы для организации озер данных и интеграцию с системами каталогов. В рамках реальных проектов они обычно предлагают возможности хранения и управления данным набором, а также интеграцию с традиционными каталогами через API и коннекторы.
- Практика внедрения: использование облачных хранилищ (объектное хранилище в рамках облака) в связке с локальными метаданными через Nessie или Hive Metastore в рамках гибридной архитектуры. В рамках проектов на отечественных платформах часто применяются гибридные решения, где часть данных хранится в отечественных хранилищах, метаданные — в локальном Hive Metastore, а вычисления — в облаке или в локальном кластере.
3) Российские примеры использования
- Реализация на базе открытых технологий в российских компаниях с упором на локализацию данных, аудит и контроль доступа. Часто встречается сценарий, когда данными управляют через локальный Hive Metastore, а CPU-ресурсы выделены в рамках отечественной инфраструктуры. Такой подход обеспечивает соответствие требованиям регламентов и повышает контроль над данными.
- В рамках проектов могут использоваться MinIO или аналогичные S3-совместимые хранилища, которые существуют и в российских реалиях, что позволяет строить приватные Lakehouse решения с Iceberg и локальным каталожным слоем.
Настройки и параметры
Общий подход: каталог Iceberg на стадии проектирования должен быть отделен от вычислительных сред и данных. Выбор типа каталога зависит от текущей архитектуры, требований к консистентности, масштабируемости и доступности.
Примеры конфигураций:
HiveCatalog (через Hive Metastore):
    iceberg.catalog.HIVE.warehouse=/data/iceberg/warehouse
    iceberg.catalog.hadoop=org.apache.iceberg.hive.HiveCatalog
    hive.metastore.uris=thrift://metastore-host:9083
NessieCatalog:
    iceberg.catalog.nessie.type= nessie
    iceberg.catalog.nessie.uri=http://nessie-server:19120/api/v1
    nessie.url=http://nessie-server:19120
RestCatalog:
    iceberg.catalog.rest.uri=http://catalog-service/api/v1
    iceberg.catalog.rest.type=rest
- Безопасность и доступ: Kerberos, TLS, аутентификация на уровне сервиса каталога, интеграция с существующими системами управления доступом. В Nessie можно задать политики доступа к веткам каталога; в Hive Metastore — настроить роли и права на базы и таблицы.
- Хранилище данных: Iceberg хранит данные в объектном хранилище (S3-совместимое), MinIO или аналогичные сервисы. В российских реалиях часто используют отечественные объекты или локальные HDFS-пути. Важно: конфигурация доступа к хранилищу должна быть надежной и соответствовать требованиям безопасности.
- Эволюция схем и ветвление: при использовании Nessie у каталога есть возможность ветвления и параллельной разработки схем, что упрощает управление изменениями. При HiveMetastore следует планировать миграции схем через миграции DDL и хранение миграций отдельно.
- Мониторинг: сбор метрик по состоянию каталога, задержкам в обновлении метаданных, времени отклика и частоте ошибок. Рекомендуется интегрировать мониторинг с Prometheus/Grafana, централизованной логинг и алертинг.
Практические принципы реализации
- Разделение ролей: администратор каталога отвечает за конфигурацию, управление ветками в Nessie (или HiveMetastore), мониторинг и обновления. Пользователи вычислительных движков — за обращения к каталогам и чтение/запись таблиц Iceberg.
- Разграничение окружений: dev/stage/prod. Nessie особенно полезен здесь, поскольку позволяет создавать отдельные ветви каталога для каждого окружения и безопасно продвигать изменения.
- Миграции и совместимость: при переходе между типами каталогов необходимо протестировать миграцию каталога и совместимость с существующими таблицами. В большинстве случаев миграцию лучше выполнять через verifiable тесты на небольшом наборе таблиц.
Риски и ограничения
- Сложность эксплуатации: внедрение каталога требует координации между командами разработки, операциями и security. Ошибки в конфигурациях могут привести к потере доступа к метаданным или к неконсистентности данных.
- Зависимость от инфраструктуры: Hive Metastore и Nessie требуют устойчивого сетевого доступа и надёжного хранилища метаданных. Прерывания работы метаданных приводят к невозможности чтения/записи таблиц.
- Масштабируемость: Hive Metastore может стать узким местом при очень больших таблицах и частых DDL-операциях. Nessie снижает риск, но требует управляемой инфраструктуры Nessie и сетевых ресурсов.
- Совместимость инструментов: некоторые версии Spark/Trino/Flink могут иметь специфические требования к версиям Iceberg и каталогов. Необходимо тестировать окружение совместимости before разворачивания в продакшене.
- Безопасность и регуляторика: хранение и управление метаданными должны соответствовать требованиям регуляторов, включая аудит и контроль доступа. Необходимо соответствие политики RBAC/ABAC и защищенные каналы передачи.
- Миграции между каталогами: перенос существующих таблиц между HiveCatalog, NessieCatalog и RestCatalog может потребовать дополнительной работы по миграции метаданных и проверке целостности.
- Локализация и российские условия: в рамках российских реалий существуют дополнительные требования к локализации данных и сетевых конфигураций, что может усложнить внедрение в гибридной среде.
Настройка каталога под Lakehouse — это не только выбор конкретного типа каталога. Это стратегическая задача, которая влияет на управляемость данными, гибкость в эволюции схем, безопасность и стоимость эксплуатации. Выбор между Hive Metastore, NessieCatalog и RestCatalog зависит от вашей инфраструктуры, регуляторных требований и целей проекта. Важно заранее продумать архитектуру: как будут житьNamespaces и таблицы, как будет происходить миграция версий, какие механизмы аудита и мониторинга будут внедрены. Open-source решения предлагают проверенные конвейеры и гибкие подходы к управлению метаданными. Российские реалии требуют внимания к локализации данных, интеграции с отечественными хранилищами и планированию инфраструктуры под устойчивые режимы эксплуатации. В ходе проекта можно начать с Hive Metastore и затем переходить к Nessie для версионирования каталога, если требуется более гибкое управление версиями и параллельная работа над изменениями. В любом случае, ключ к успешной настройке каталога — четко описанная архитектура, регламентированные политики доступа, тестирование миграций и постоянный мониторинг состояния каталога.
Вопрос–Ответ (FAQ)
1) Что такое каталог Iceberg и зачем он нужен в Lakehouse?
Каталог Iceberg — это слой метаданных, который хранит информацию о пространствах имен, таблицах, версиях, местоположении файлов и взаимосвязях между элементами данных. Он нужен для централизованного управления метаданными, поддержки безопасной эволюции схем, эффективного чтения и масштабируемого управления большими наборами данных. Без каталога управление метаданными становилось бы сложнее, медленнее и рискованнее в плане потери согласованности.
2) Какие типы каталогов доступны в Iceberg и как выбрать подходящий?
Наиболее распространенные типы каталогов: HiveCatalog (через Hive Metastore), HadoopCatalog (локальная файловая система), NessieCatalog (Git-подобный каталог с версиями), RestCatalog (REST API). Выбор зависит от инфраструктуры:
- HiveMetastore подходит для зрелой добычи данных в Hadoop-окружении и интегрированности с существующими сервисами.
- NessieCatalog полезен, когда нужна версияция каталога, возможность параллельной разработки и безопасное управление изменениями через ветвление.
- RestCatalog удобен, если есть единая централизованная служба каталога и требуется унифицированный HTTP-интерфейс.
- HadoopCatalog удобен для локальных сценариев без отдельного сервиса метаданных, но ограничен масштабируемостью.
3) Какие практические шаги необходимы для внедрения Nessie в существующую архитектуру?
- Развернуть Nessie-сервер (локально или в контейнере) и убедиться в доступности по сети.
- Настроить Iceberg на использование NessieCatalog: задать тип каталога и URI Nessie.
- Создать базовый каталог и ветви в Nessie для dev/stage/prod, затем мигрировать или создать таблицы Iceberg через Spark/Trino.
- Внедрить процесс CI/CD для изменений каталога (ветвление, коммиты, тестирование).
- Настроить мониторинг и аудит изменений в каталоге.
4) Какие риски связаны с миграцией каталога?
Основные риски — потеря доступа к метаданным, несогласованность между каталогом и физическими данными, сломы при миграции DDL. Чтобы снизить риски, рекомендуется:
- Тестировать миграцию на небольшом наборе таблиц.
- Проводить миграции в отдельных окружениях (dev/stage) перед продом.
- Резервное копирование ключевых конфигураций и метаданных.
5) Как обеспечить безопасность каталога и доступа к метаданным?
Реализуйте централизованный контроль доступа: Kerberos/TLS, RBAC и ABAC, аудит изменений, интеграцию с существующими системами управления доступом. Для Nessie можно применять политики доступа к веткам каталога, а для Hive Metastore — контроль на уровне баз и таблиц. Шифрование данных в хранилище и безопасные политики доступа к сетям — обязательны.
6) Какие практические рекомендации по эксплуатации в российских условиях?
- Рассмотрите локальный Hive Metastore для регуляторной локализации и контроля доступа.
- Учитывайте требования к локализации данных и аудитам; используйте локальное хранилище и отечественные решения, где это возможно.
- Рассмотрите гибридные схемы: часть данных в отечественном хранилище, часть — в облаке, управляемые через Nessie или Hive Metastore.
- Включите MinIO или аналогичные S3-совместимые решения для тестирования и разработки, а затем перенесите в продакшн на соответствующее отечественное хранилище.
7) Как мониторить каталоги и обнаруживать проблемы?
Собирайте метрики времени ответа запросов к каталогу, задержки при обновлениях метаданных, частоту ошибок, состояние узлов Nessie/Hive Metastore. Интегрируйте мониторинг с Prometheus/Grafana, ведите централизованный логинг (ELK/EFK), устанавливайте алерты на аномалии в задержках и ошибках.
8) Как обеспечивать совместимость между различными средами?
Планируйте архитектуру так, чтобы один и тот же каталог мог быть доступен из разных окружений (dev/stage/prod) через ветвление каталога (Nessie) или через согласованные версии Hive Metastore. Регулярно проводите тесты совместимости версий Iceberg, проводите регрессионные тесты при изменении версии каталога.
9) Какие ограничения у RestCatalog и когда его целесообразно использовать?
RestCatalog удобен, если у вас есть единая служба каталога и ограничение на прямые обращения к Hive Metastore. Он уменьшает зависимость клиентов от конкретной реализации каталога и упрощает централизованную политику доступа. Однако вам нужно обеспечить устойчивое REST API и высокий уровень его доступности.
10) Какие индикаторы успешного завершения проекта по настройке каталога?
- Устойчивое чтение и запись таблиц Iceberg через несколько вычислительных движков (Spark, Trino) в рамках тестового набора данных.
- Одна или несколько работающих каталогов (HiveMetastore и Nessie) с корректной версией и миграцией.
- Наличие процессов миграций версий и резервирования метаданных.
- Инструменты мониторинга и алертинга, покрывающие все узлы каталога и его доступ к хранилищу данных.
- Соответствие требованиям регуляторов и политики безопасности, включая аудит изменений в каталоге.
Этот материал призван помочь новому сотруднику быстро включиться в проект по настройке и эксплуатации каталога под Lakehouse. Важно помнить: адаптация теории к практической инфраструктуре требует тестирования в контролируемой среде и тесной координации между командами разработки, эксплуатации и информационной безопасности.


