

Как CDC из MySQL применить в ClickHouse
Предположим, у Вас есть база данных, обрабатывающая множество OLTP -запросов. Для создания аналитических отчетов Вам нужна БД, поддерживающая OLAP -процессы, например, ClickHouse. Как синхронизировать эти БД? К чему нужно быть готовым?
Синхронизация двух или более баз данных - одна из стандартных процедур, с которыми Вы, возможно, уже сталкивались. Благодаря Change Data Capture (CDC) и таким технологиям, как Kafka, этот процесс больше не является чем-то из ряда фантастики. Однако используемые Вами базы данных могут существенно усложнить его, особенно в том случае, если исходная база данных работает в парадигме OLTP, а целевая - в OLAP. В этой статье мы проследим за всеми этапами данная процесса, начиная с MySQL (источник) и заканчивая ClickHouse (цель).
Обзор системы проекта
На самом деле, все довольно просто. Изменения в базе данных перехватываются с помощью Debezium и публикуются на Apache Kafka в виде событий. ClickHouse забирает эти изменения с помощью движка Kafka . В режиме реального времени.
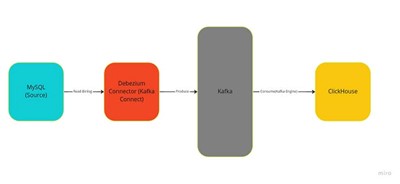
Пример
Представьте, что в Mysql у нас есть таблица заказов, содержащая следующие DDL:
CREATE TABLE `orders` (
  `id` int(11) NOT NULL,
  `status` varchar(50) NOT NULL,
  `price` varchar(50) NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=latin1
Пользователи могут создавать, удалять и обновлять любой столбец или даже запись целиком. Мы хотим фиксировать все эти изменения и передавать их в ClickHouse в целях синхронизации.
Для этого будем использовать Debezium v2.1 и движок ReplacingMergeTree в ClickHouse.

Последовательность действий
Шаг 1: CDC с помощью Debezium
Большинство БД содержат журнал, в который перед непосредственным применением к данным записывается каждая планируемая операция (Write Ahead Log или WAL). В Mysql этот файл называется Binlog. Если Вы читаете этот файл, разбираете его и применяете к целевой базе данных, значит, Вы следуете манифесту Change Data Capture (CDC).
CDC - один из лучших способов синхронизации двух или нескольких разнородных баз данных. Он работает в режиме реального времени, в конечном итоге согласован и позволяет избежать применения других методов, предполагающих больших затрат, например пакетного заполнения с помощью Airflow. Независимо от того, что происходит на источнике, Вы можете зафиксировать весь порядок действий и в конечном итоге добиться полной согласованности с оригиналом.
Debezium – довольно известный инструмент для чтения и парсинга Binlog. Он легко интегрируется с Kafka Connect в качестве коннектора и выдает каждое изменение в теме Kafka.
Для работы с данным решением Вам в базе данных MySQL нужно включить log-bin и настроить Kafka Connect, Kafka и Debezium соответствующим образом. Поскольку все эти процессы достаточно подробно описаны описано в других статьях, я остановлюсь только на конфигурации Debezium, адаптированной для достижения нашей цели: фиксации любых изменений и их передачи в ClickHouse.
Прежде чем показать Вам общую конфигурацию, остановлюсь на трех основных конфигурациях, необходимых для успешной работы:
Извлечение состояния новой записи
По умолчанию Debezium выдает каждую запись, состоящую из состояний «до» и «после» для каждой операции, что очень трудно разобрать в таблице ClickHouse Kafka. Кроме того, в случае операции удаления он создает записи со значением NULL (опять же, не разбираемые Clickhouse):
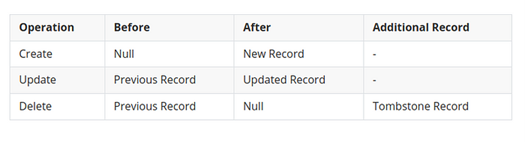
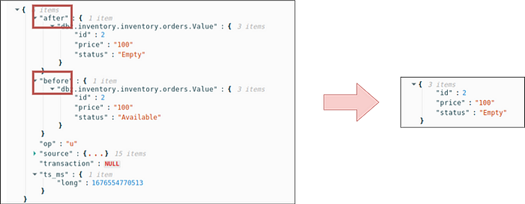
Для решения этой проблемы в конфигурации Debezium мы используем опцию ExtractNewRecod, благодаря которой сохраняется только состояние «после» для операций создания/обновления (состояние «до» игнорируется). Но, к сожалению, опция отбрасывает и запись Delete, содержащую предыдущее состояние, а также запись со значением NULL, о которой говорилось ранее. Другими словами, Вы больше не сможете перехватить операцию удаления. Спокойно, без паники! Мы разберемся с этой ситуацией в следующем разделе.
"transforms": "unwrap",
"transforms.unwrap.type": "io.debezium.transforms.ExtractNewRecordState"
На рисунке ниже показано, как с помощью конфигурации ExtractNewRecord выравнивается состояние «после» и отбрасывается состояние «до».
Повторная запись событий удаления
Для перехвата операций удаления мы должны добавить конфигурацию повторной записи, как показано ниже:
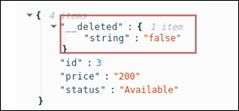
"transforms.unwrap.delete.handling.mode":"rewrite"
Debezium добавляет в этот конфигурацию поле __deleted, которое является истинным для операции удаления и ложным для всех остальных операций. Таким образом, удаление будет содержать предыдущее состояние, а также поле __deleted:true.
Обновление непервичных ключей
При указанных конфигурациях обновление записи (каждого столбца, кроме первичного ключа) приводит к созданию простой записи с новым состоянием. Наличие другой реляционной базы данных с тем же DDL - это нормально, поскольку в месте назначения обновленная запись заменяет предыдущую. Но в случае с ClickHouse все по-другому!
В нашем примере источник использует id в качестве первичного ключа, а ClickHouse использует id и status в качестве ключей заказа. Замены и уникальность гарантированы только для записей с одинаковыми id и статусом! Что же произойдет, если источник обновит колонку статуса? В ClikHouse мы получим дубликаты записей, подразумевающие одинаковые id, но имеющие совершенно разные статусы!
К счастью, выход есть. По умолчанию Debezium создает запись delete и запись create для обновления по первичным ключам. Поэтому, если источник обновляет id, то он создает запись delete с прежним id и запись create с новым id. Предыдущая запись с полем __deleted=ture заменяет нашу запись stall в CH. Затем записи, подразумевающие удаление, можно отфильтровать в представлении. Мы можем распространить этот алгоритм и на другие колонки с помощью следующей опции:
"message.key.columns": "inventory.orders:id;inventory.orders:status"
Теперь, собрав все воедино, мы получим полнофункциональную конфигурацию Debezium, способную справиться с любыми изменениями:
{
    "name": "mysql-connector",
    "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "database.hostname": "mysql",
    "database.include.list": "inventory",
    "database.password": "mypassword",
    "database.port": "3306",
    "database.server.id": "2",
    "database.server.name": "dbz.inventory.v2",
    "database.user": "root",
    "message.key.columns": "inventory.orders:id;inventory.orders:status",
    "name": "mysql-connector-v2",
    "schema.history.internal.kafka.bootstrap.servers": "broker:9092",
    "schema.history.internal.kafka.topic": "dbz.inventory.history.v2",
    "snapshot.mode": "schema_only",
    "table.include.list": "inventory.orders",
    "topic.prefix": "dbz.inventory.v2",
    "transforms": "unwrap",
    "transforms.unwrap.delete.handling.mode": "rewrite",
    "transforms.unwrap.type": "io.debezium.transforms.ExtractNewRecordState"
  }
}
NB: Как выбрать ключевые столбцы Debezium?
Изменяя ключевые столбцы коннектора, Debezium использует их в качестве тематических ключей вместо первичного ключа таблицы-источника, используемого по умолчанию. Таким образом, различные операции, связанные с одной записью в базе данных, могут оказаться в других разделах Kafka. Поскольку записи в разных разделах теряют свой порядок, это может привести к несогласованности записей в Clikchouse (если Вы не убедитесь в том, что ключи порядка ClickHouse и ключи сообщений Debezium совпадают).
Проверенный способ решения данной проблемы:
- Определите ключ партиционирования и ключ порядка исходя из желаемой схемы таблицы.
- Определите источник происхождения ключей партиционирования и сортировки, предположив, что они вычисляются во время материализации.
- Объедините все эти столбцы.
- В конфигурации коннектора Debezium определите результат предыдущего шага как message.column.keys.
- Проверьте, содержит ли ключ сортировки Clickhouse все эти столбцы. Если нет, добавьте их.
Шаг 2: Таблицы ClickHouse
ClickHouse может сбрасывать записи Kafka в таблицу с помощью движка Kafka. Нам нужно определить три таблицы: таблицу Kafka, таблицу Consumer Materializer и главную таблицу.
Таблица Kafka
Таблица Kafka определяет структуру записи и тему Kafka, предназначенную для чтения.
CREATE TABLE default.kafka_orders
(     `id` Int32,     `status` String,     `price` String,     `__deleted` Nullable(String) ) ENGINE = Kafka('broker:9092', 'inventory.orders', 'clickhouse', 'AvroConfluent')
SETTINGS format_avro_schema_registry_url = 'http://schema-registry:8081'
Consumer Materializer
Каждая запись таблицы Kafka читается только один раз - поскольку ее потребительская группа изменяет смещение, мы не можем прочитать ее дважды. Поэтому нам нужно определить главную таблицу и материализовать в нее каждую запись таблицы Kafka:
CREATE MATERIALIZED VIEW default.consumer__orders TO default.stream_orders
(     `id` Int32,     `status` String,     `price` String,     `__deleted` Nullable(String) ) AS
SELECT
    id AS id,
    status AS status,
    price AS price,
    __deleted AS __deleted
FROM default.kafka_orders
Главная таблица
Таблица Main содержит исходную структуру и поле __deleted. Поскольку нам нужно заменить удаленные или обновленные записи, я буду испольовать Replacing Merge Tree:
CREATE TABLE default.stream_orders
(     `id` Int32,     `status` String,     `price` String,     `__deleted`String ) ENGINE = ReplacingMergeTree ORDER BY (id, price)
SETTINGS index_granularity = 8192
Таблица представления
Наконец, нам нужно отфильтровать все удаленные записи (поскольку мы не хотим их видеть) и получить самую последнюю в случае наличия разных записей с одинаковым ключом сортировки. С этим можно справиться с помощью модификатора Final. Но чтобы в каждом запросе не использовать filter и final, определим простое представление, который будет выполнять эту работу неявно:
CREATE VIEW default.orders
(     `id` Int32,     `status` String,     `price` String,     `__deleted` String ) AS
SELECT *
FROM default.stream_orders
FINAL
WHERE __deleted = 'false'
NB: использовать Final для каждого запроса неэффективно, особенно в производстве. Для просмотра последних записей можно использовать агрегаты или просто подождать, пока ClickHouse объединит их в фоновом режиме.
Заключение
В этой статье мы рассмотрели способ синхронизации базы данных ClickHouse с MySQL с помощью CDC, позволяющий избежать дублирования записей.


