

Как работает расширение POSTGRES_FDW в PostgreSQL
Модуль postgres_fdw предоставляет собой обёртку сторонних данных postgres_fdw, используя которую можно обращаться к данным, находящимся на внешних серверах PostgreSQL.
Функциональность этого модуля во многом пересекается с функциональностью старого модуля dblink. Однако postgres_fdw предоставляет более прозрачный и стандартизированный синтаксис для обращения к удалённым таблицам и во многих случаях даёт лучшую производительность.
postgres_fdw постоянно совершенствуется. Таблица, представленная ниже, описывает историю развития postgres_fdw, взятую из официального документа.
|
Table 4.1 История развития postgres_fdw |
|
|
Версия |
Описание |
|
9.3 |
|
|
9.6 |
|
|
10 |
|
|
11 |
|
|
12 |
|
|
14 |
|
Поскольку в предыдущем разделе описывается, как postgres_fdw обрабатывает однотабличный запрос, в следующем подразделе мы даем описание того, как он обрабатывает многотабличный запрос, операцию сортировки и агрегатные функции.
В этом подразделе основное внимание уделяется оператору SELECT. Однако postgres_fdw может обрабатывать и другие операторы DML (INSERT, UPDATE и DELETE).
Примечание: FDW Postegresql не обнаруживает deadlock
Расширение postgres_fdw и функция FDW не поддерживают функцию обнаружения deadlock, поэтому вероятность возникновения взаимной блокировки достаточно высока.
Например, если Client_A обновляет локальную таблицу 'tbl_local' и внешнюю таблицу 'tbl_remote', а Client_B обновляет 'tbl_remote' и 'tbl_local', то происходит deadlock, однако PostgreSQL не может обнаружить эту проблему.
localdb=# -- Client A
localdb=# BEGIN;
BEGIN
localdb=# UPDATE tbl_local SET data = 0 WHERE id = 1;
UPDATE 1
localdb=# UPDATE tbl_remote SET data = 0 WHERE id = 1;
UPDATE 1
localdb=# -- Client B
localdb=# BEGIN;
BEGIN
localdb=# UPDATE tbl_remote SET data = 0 WHERE id = 1;
UPDATE 1
localdb=# UPDATE tbl_local SET data = 0 WHERE id = 1;
UPDATE 1
Многотабличный запрос
Чтобы выполнения многотабличного запроса postgres_fdw извлекает каждую стороннюю таблицу с помощью оператора SELECT, а затем объединяет эти таблицы на локальном сервере.
В версии 9.5 и более ранних версиях, даже если сторонние таблицы хранятся на одном удаленном сервере, postgres_fdw все равно извлекает их по отдельности, а затем объединяет их.
В версиях 9.6 и новее обертка postgres_fdw более мощная, она может выполнять операцию удаленного соединения на удаленном сервере, когда сторонние таблицы находятся на одном сервере, кроме того доступна опция use_remote_estimate.
Подробное описание процесса выполнения дано ниже.
Версия 9.5 и более ранние версии
Давайте изучим процесс обработки запроса, объединяющего две сторонние таблицы: 'tbl_a' и 'tbl_b'.
localdb=#SELECT*FROMtbl_aASa, tbl_bASbWHEREa.id=b.idANDa.id<200;
Результат выполнения команды EXPLAIN:
localdb=# EXPLAIN SELECT * FROM tbl_a AS a, tbl_b AS b WHERE a.id = b.id AND a.id < 200;
                                  QUERY PLAN
------------------------------------------------------------------------------
 Merge Join  (cost=532.31..700.34 rows=10918 width=16)
   Merge Cond: (a.id = b.id)
   ->  Sort  (cost=200.59..202.72 rows=853 width=8)
         Sort Key: a.id
         ->  Foreign Scan on tbl_a a  (cost=100.00..159.06 rows=853 width=8)
   ->  Sort  (cost=331.72..338.12 rows=2560 width=8)
         Sort Key: b.id
         ->  Foreign Scan on tbl_b b  (cost=100.00..186.80 rows=2560 width=8)
(8 rows)
Результат показывает, что исполнитель выбирает соединение слиянием (merge join) и обрабатывает его следующим образом:
- Строка 8: Исполнитель извлекает таблицу 'tbl_a' с помощью сканирования сторонней таблицы;
- Строка 6: Исполнитель сортирует полученные строки 'tbl_a' на локальном сервере;
- Строка 11: Исполнитель извлекает таблицу ’tbl_b’ с помощью сканирования сторонней таблицы;
- Строка 9: Исполнитель сортирует полученные строки 'tbl_b' на локальном сервере;
- Строка 4: Исполнитель выполняет cоединение слиянием на локальном сервере.
Ниже описан процесс того, как исполнитель извлекает строки (рис. 46).
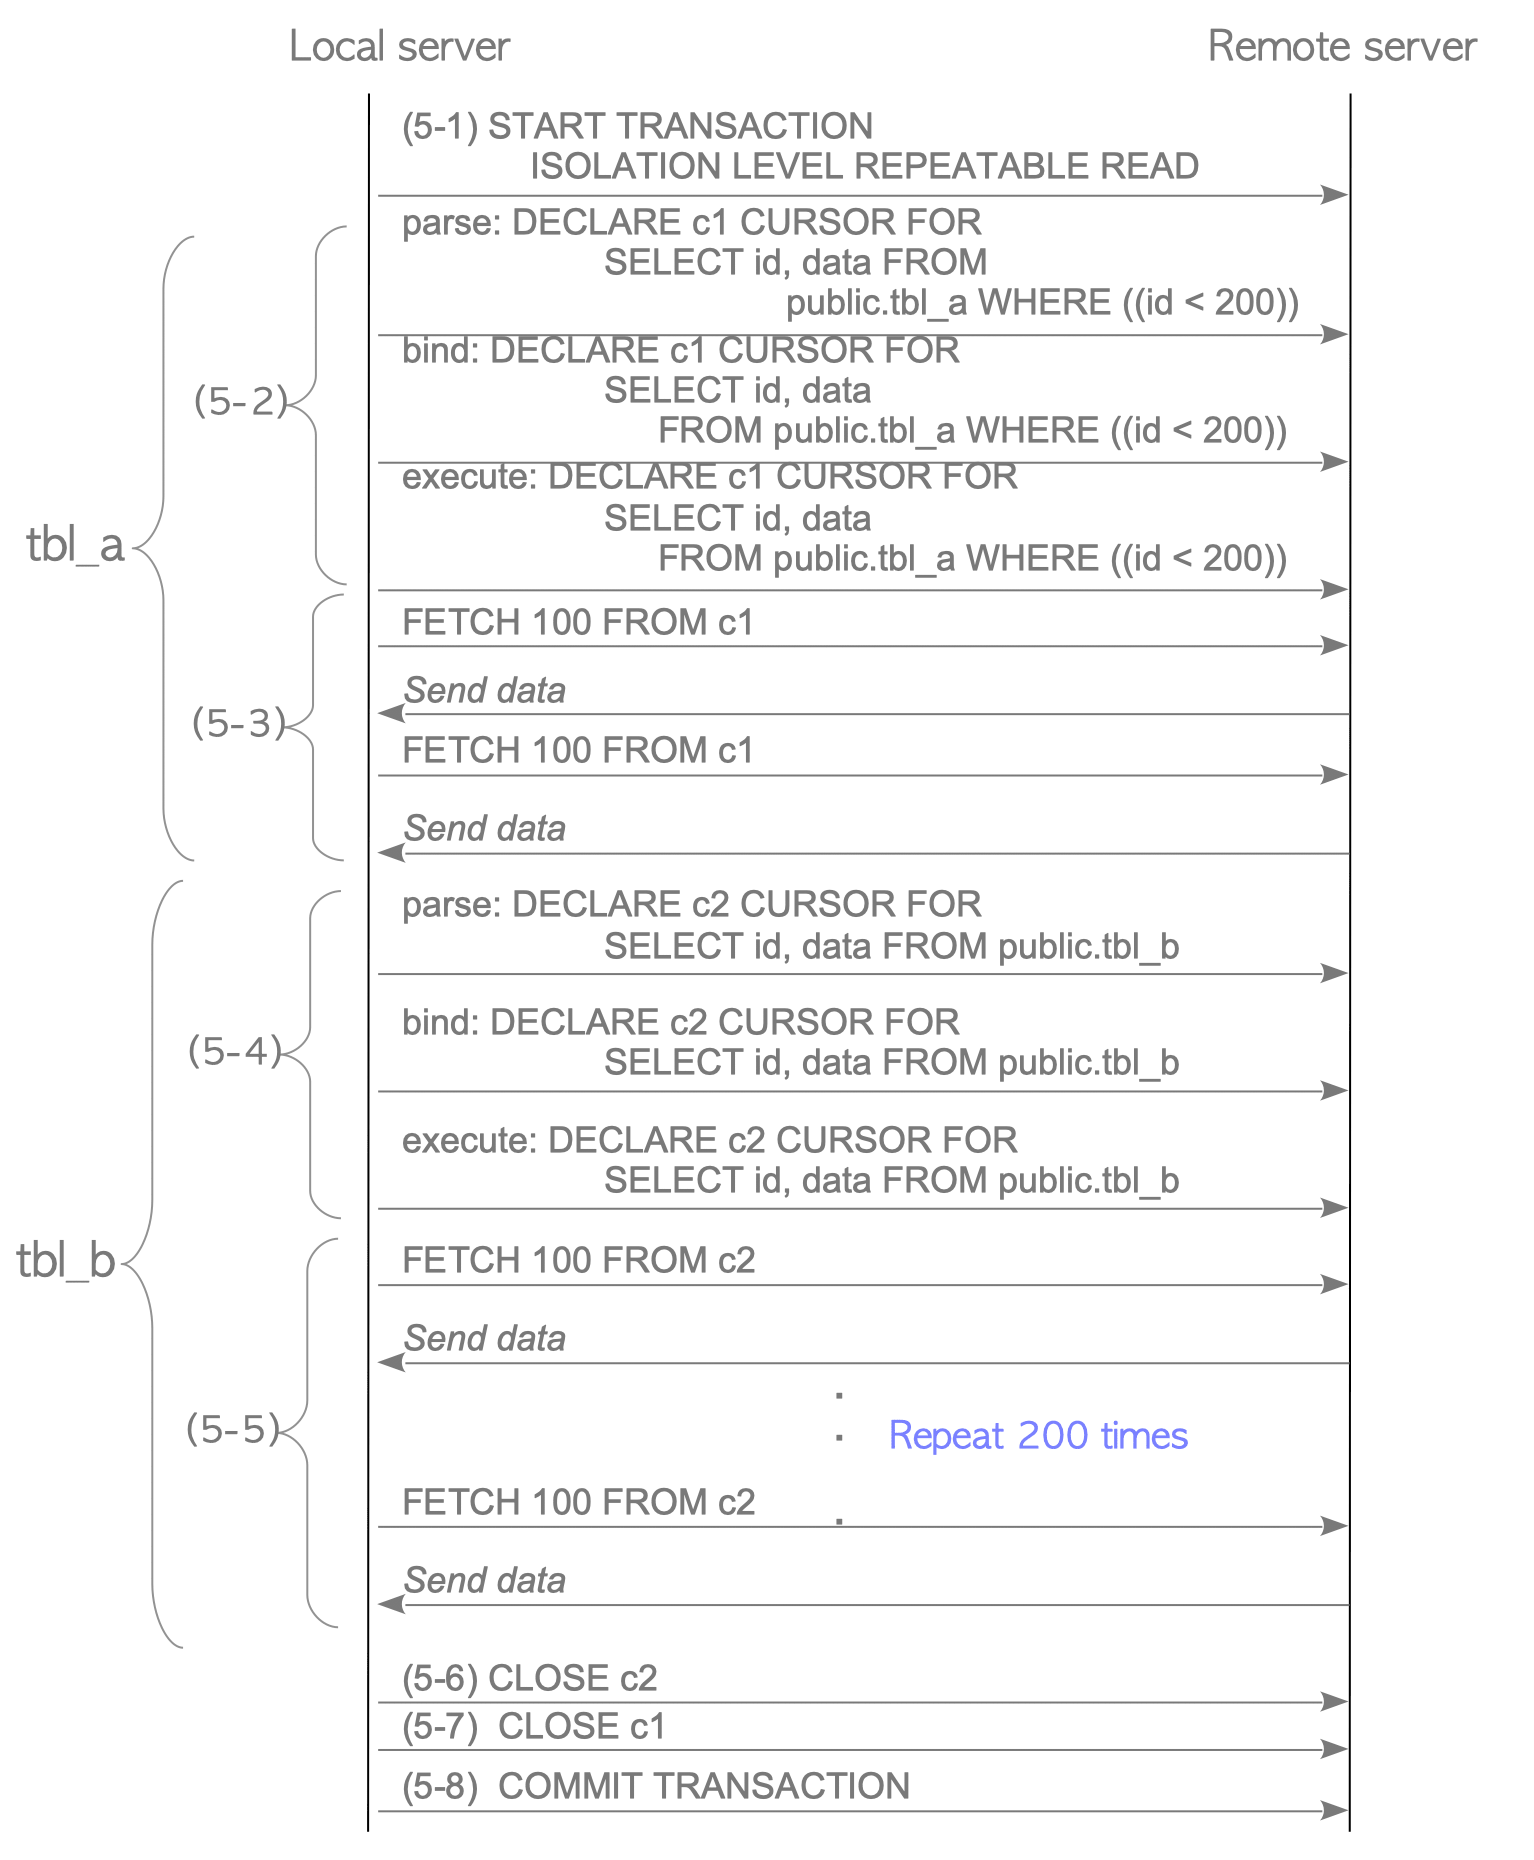
- (5-1) Запуск удаленной транзакции.
- (5-2) Объявление курсора c1, оператор SELECT которого показан ниже:
SELECT id,data FROM public.tbl_a WHERE (id < 200)
- (5-3) Выполнение команд FETCH для получения результата курсора 1.
- (5-4) Объявление курсора c2, оператор SELECT которого показан ниже:
SELECT id,data FROM public.tbl_b
Обратите внимание на то, что в исходном запросе с двумя таблицами в строке WHERE указано "tbl_a.id = tbl_b.id AND tbl_a.id < 200". Поэтому предложение WHERE "tbl_b.id < 200" можно добавить к оператору SELECT, как показано выше. Однако postgres_fdw не может выполнить эту процедуру, поэтому исполнитель должен выполнить оператор SELECT без каких-либо предложений WHERE и получить все строки внешней таблицы 'tbl_b'.
Этот процесс неэффективен, поскольку с удаленного сервера приходится считывать ненужные строки. Кроме того, полученные строки необходимо отсортировать, чтобы выполнить соединение.
- (5-5) Выполнение команд FETCH для получения результата курсора 2.
- (5-6) Закрыте курсора c1.
- (5-7) Закрытие курсора c2.
- (5-8) Выполнение транзакции.
Журнал удаленного сервера
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  parse <unnamed>: DECLARE c2 CURSOR FOR
      SELECT id, data FROM public.tbl_b
LOG:  bind <unnamed>: DECLARE c2 CURSOR FOR
      SELECT id, data FROM public.tbl_b
LOG:  execute <unnamed>: DECLARE c2 CURSOR FOR
      SELECT id, data FROM public.tbl_b
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2

... snip

LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: CLOSE c2
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
После получения строк исполнитель сортирует полученные строки обеих таблиц 'tbl_a' и 'tbl_b', а затем выполняет соединение слиянием (merge join) отсортированных строкам.
Версия 9.6 и новее
Если влена опция use_remote_estimate (котрая по умолчанию выключена), postgres_fdw отправляет несколько команд EXPLAIN для получения стоимости всех планов, относящихся к сторонним таблицам.
Чтобы отправить команды EXPLAIN, postgres_fdw отправляет как команду EXPLAIN для каждого запроса с одной таблицей, так и команды EXPLAIN операторов SELECT для выполнения операций, связанных с удаленными операциями join. В примере, приведеннм ниже, семь команд EXPLAIN отправляются на удаленный сервер для получения оценочной стоимости каждого оператора SELECT. Затем планировщик выбирает самый оптимальный план.
(1) EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((id < 200))
(2) EXPLAIN SELECT id, data FROM public.tbl_b
(3) EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
(4) EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((((SELECT null::integer)::integer) = id)) AND ((id < 200))
(5) EXPLAIN SELECT id, data FROM public.tbl_b ORDER BY id ASC NULLS LAST
(6) EXPLAIN SELECT id, data FROM public.tbl_b WHERE ((((SELECT null::integer)::integer) = id))
(7) EXPLAIN SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
Выполним команду EXPLAIN на локальном сервере и посмотрим, какой именно план выберет планировщик:
localdb=# EXPLAIN SELECT * FROM tbl_a AS a, tbl_b AS b WHERE a.id = b.id AND a.id < 200;
                        QUERY PLAN
-----------------------------------------------------------
Foreign Scan (cost=134.35..244.45 rows=80 width=16) Relations: (public.tbl_a a) INNER JOIN (public.tbl_b b) (2 rows)
Итак, планировщик выбирает запрос с внутренним соединением, который обрабатывается на удаленном сервере, что очень эффективно.
Далее описывается последовательность операторов SQL для выполнения операции remote-join в версиях 9.6 и новее (рис. 47)
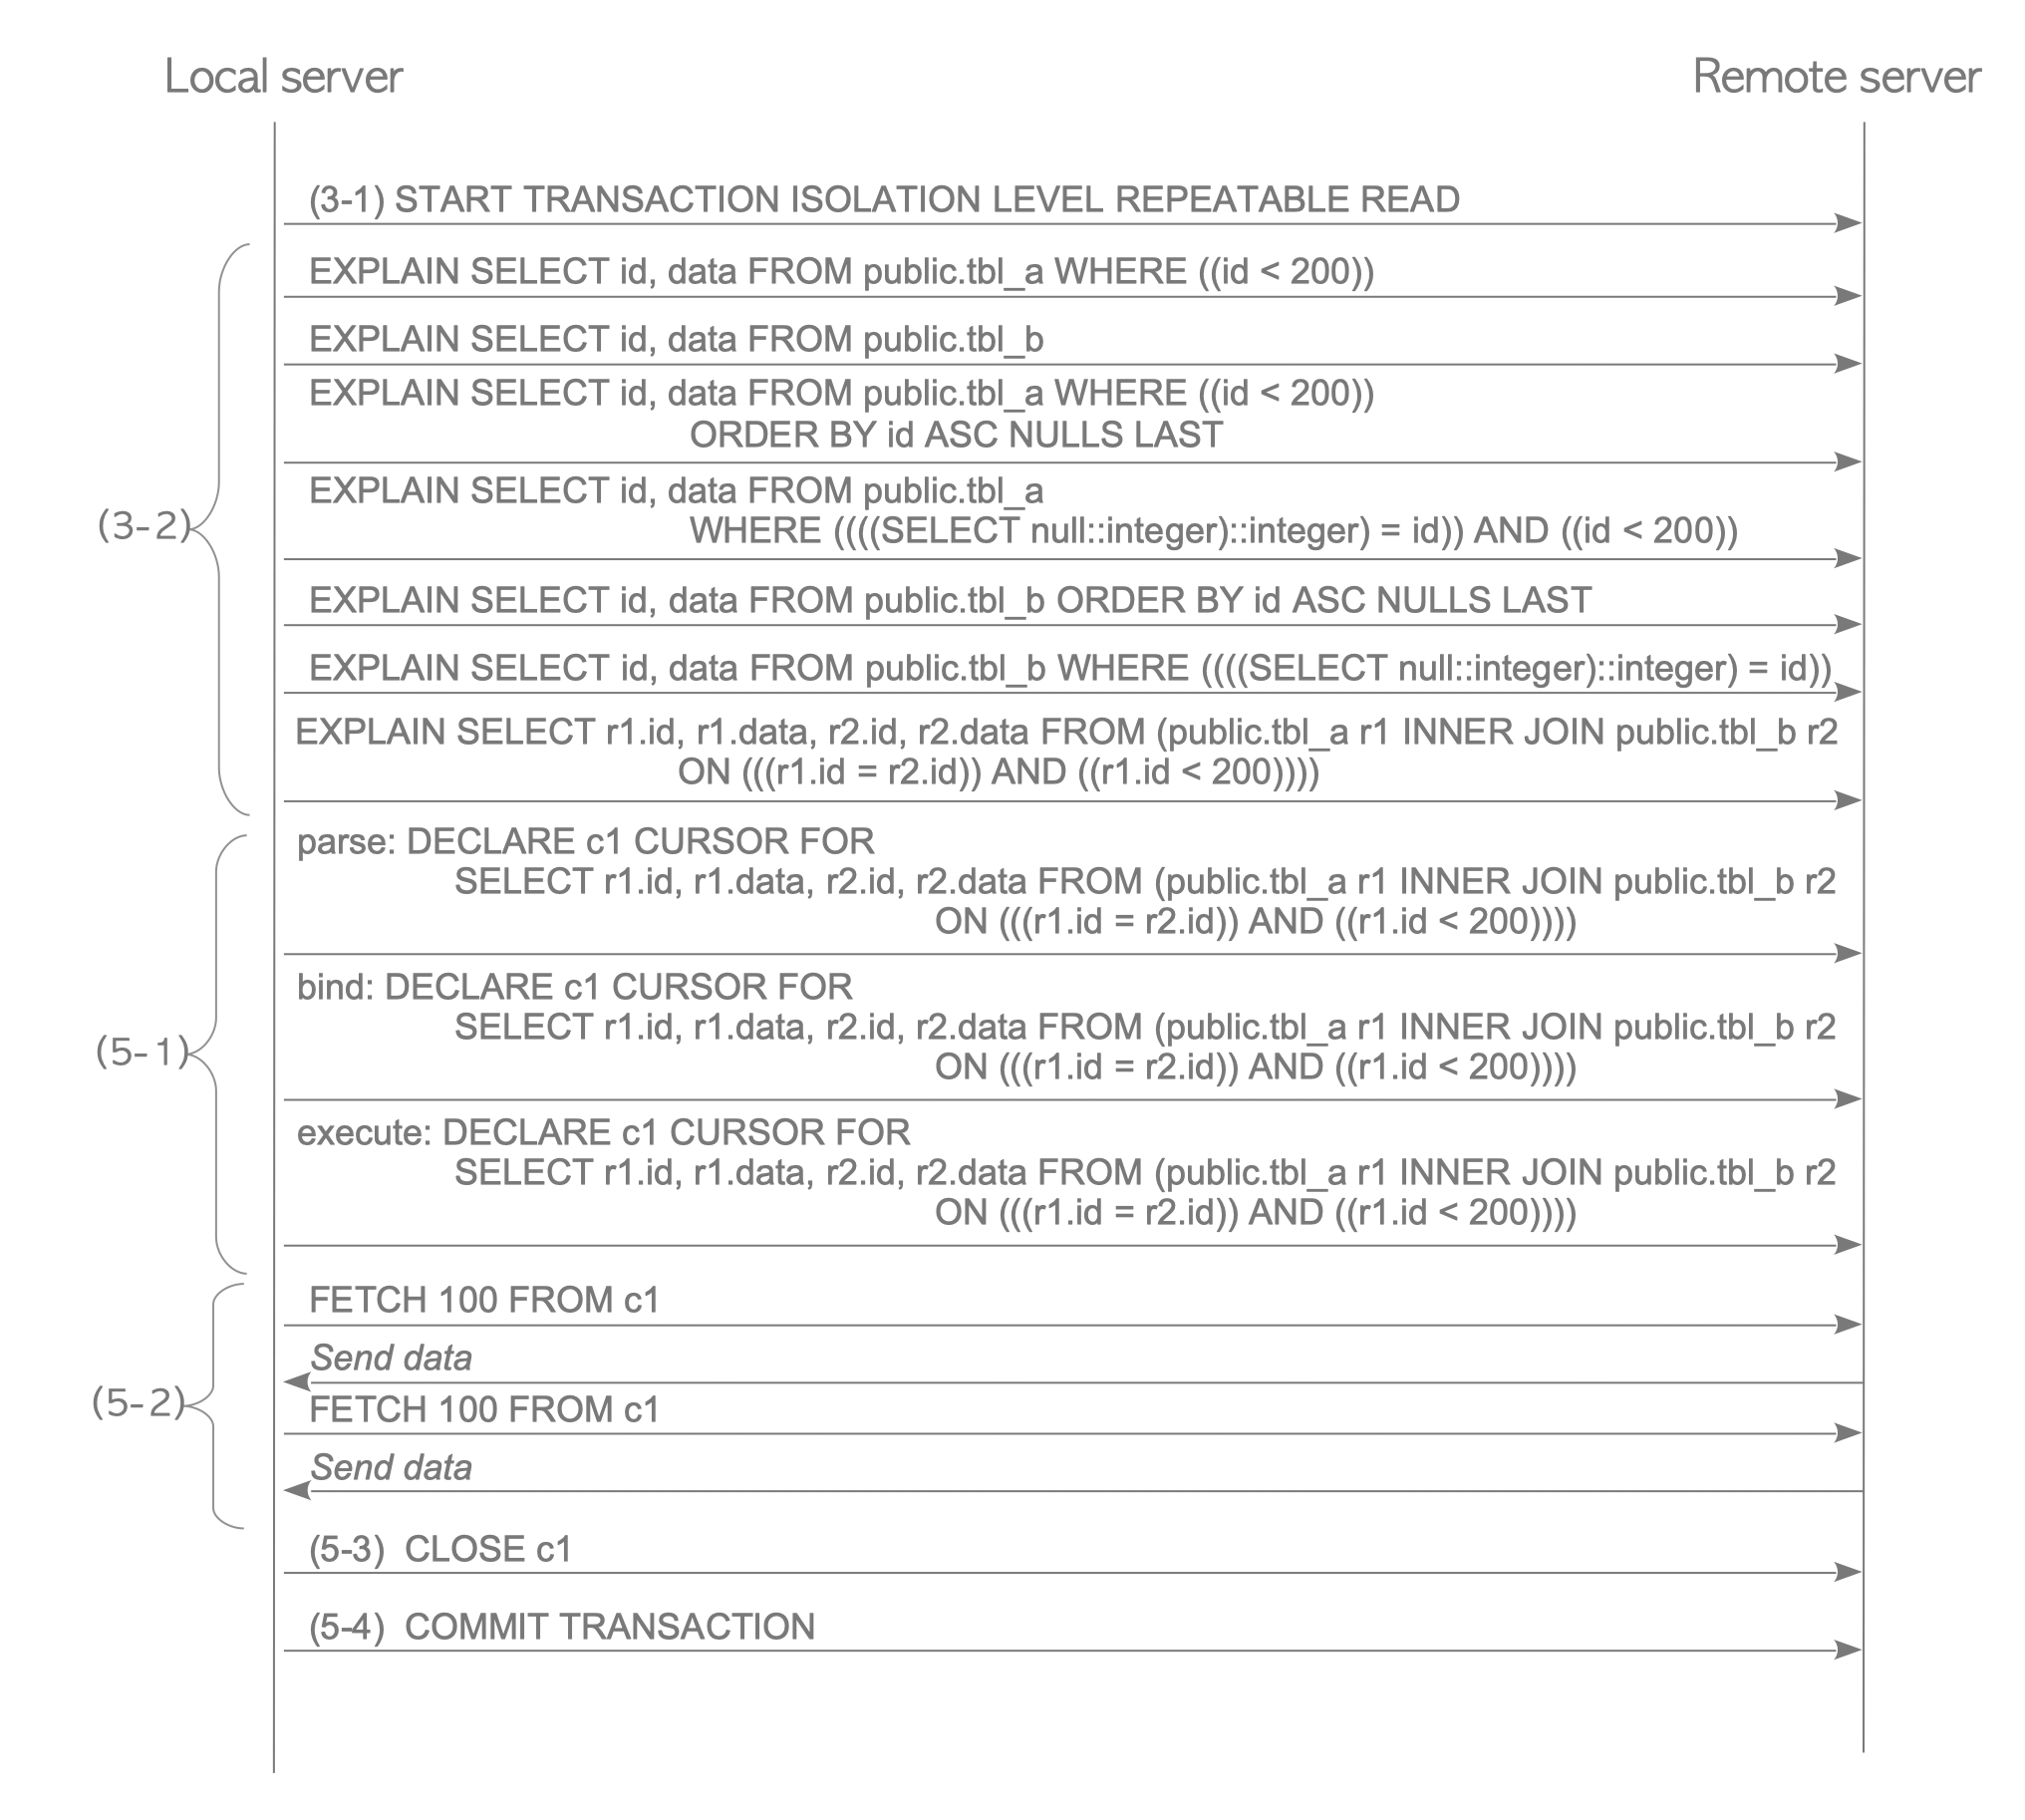
- (3-1) Запуск удаленной транзакции.
- (3-2) Выполнение команд EXPLAIN для оценки стоимости каждого пути.
В данном случае выполняется 7 команд EXPLAIN. Затем планировщик выбирает оптимальную стоимость запросов SELECT, используя результаты выполненных команд EXPLAIN.
- (5-1) Объявление курсора c1, выражение SELECT которого приведено ниже:
SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2
  ON (((r1.id = r2.id)) AND ((r1.id < 200))))
- (5-2) Получение результата от удаленного сервера;
- (5-3) Закрытие курсора с1;.
- (5-4) Выполнение транзакции.
Журнал удаленного сервера
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_b
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((((SELECT null::integer)::integer) = id)) AND ((id < 200))
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_b ORDER BY id ASC NULLS LAST
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_b WHERE ((((SELECT null::integer)::integer) = id))
LOG:  statement: EXPLAIN SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
LOG:  parse: DECLARE c1 CURSOR FOR
                       SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
LOG:  bind: DECLARE c1 CURSOR FOR
                       SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
LOG:  execute: DECLARE c1 CURSOR FOR
                       SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
Обратите внимание на то, что если опция use_remote_estimate выключена (по умолчанию), запрос с удаленным соединением выбирается достаточно редко.
Сортировка
Версия 9.5 и более ранние версии
Операция сортировки, например ORDER BY, обрабатывается на локальном сервере. Это означает, что перед операцией сортировки локальный сервер получает все целевые строки с удаленного сервера. Давайте рассмотрим, как обрабатывается простой запрос, содержащий предложение ORDER BY, с помощью команды EXPLAIN.
localdb=# EXPLAIN SELECT * FROM tbl_a AS a WHERE a.id < 200 ORDER BY a.id;
                              QUERY PLAN
-----------------------------------------------------------------------
 Sort  (cost=200.59..202.72 rows=853 width=8)
   Sort Key: id
   ->  Foreign Scan on tbl_a a  (cost=100.00..159.06 rows=853 width=8)
(3 rows)
- Строка 6: Исполнитель отправляет следующий запрос на удаленный сервер, а затем получает результат запроса.
SELECT id, data FROM public.tbl_a WHERE ((id < 200))
- Строка 4: Исполнитель сортирует строки, извлеченные из 'tbl_a', на локальном сервере.
Журнал удаленного сервера
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
Версия 9.6 и новее
Postgres_fdw может выполнять операторы SELECT с предложением ORDER BY на удаленном сервере, если это возможно.
localdb=# EXPLAIN SELECT * FROM tbl_a AS a WHERE a.id < 200 ORDER BY a.id;
                           QUERY PLAN
-----------------------------------------------------------------
Foreign Scan on tbl_a a (cost=100.00..167.46 rows=853 width=8) (1 row)
- Строка 4: Исполнитель отправляет следующий запрос с предложением ORDER BY на удаленный сервер, а затем получает результат запроса, который уже отсортирован.
SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
Журнал удаленного сервера
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
                       SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
                       SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
                       SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
Это позволило снизить нагрузку на локальный сервер.
Агрегатные функции
Версия 9.6 и более ранние версии
По аналогии с операциями сортировки, упомянутыми в предыдущем подразделе, агрегатные функции, такие как AVG() и COUNT(), обрабатываются на локальном сервере следующим образом:
localdb=# EXPLAIN SELECT AVG(data) FROM tbl_a AS a WHERE a.id < 200;
                              QUERY PLAN
-----------------------------------------------------------------------
Aggregate (cost=168.50..168.51 rows=1 width=4) -> Foreign Scan on tbl_a a (cost=100.00..166.06 rows=975 width=4) (2 rows)
- Строка 5: Исполнитель отправляет на удаленный сервер следующий запрос, а затем извлекает полученный результат.
SELECT id, data FROM public.tbl_a WHERE ((id < 200))
- Строка 4: Исполнитель вычисляет среднее значение строк, извлеченных из 'tbl_a', на локальном сервере.
Журнал удаленного сервера
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
      SELECT data FROM public.tbl_a WHERE ((id < 200))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
      SELECT data FROM public.tbl_a WHERE ((id < 200))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
      SELECT data FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
Этот процесс является дорогостоящим, поскольку отправка большого количества строк потребляет много сетевого трафика и занимает много времени.
Версия 10 и новее
Если это возможно, Postgres_fdw выполняет оператор SELECT с агрегатной функцией на удаленном сервере.
localdb=# EXPLAIN SELECT AVG(data) FROM tbl_a AS a WHERE a.id < 200;
                     QUERY PLAN
-----------------------------------------------------
Foreign Scan (cost=102.44..149.03 rows=1 width=32) Relations: Aggregate on (public.tbl_a a) (2 rows)
- Строка 4: Исполнитель отправляет на удаленный сервер следующий запрос, содержащий функцию AVG(), а затем получает результат запроса.
SELECT avg(data) FROM public.tbl_a WHERE ((id < 200))
Журнал удаленного сервера
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
                       SELECT avg(data) FROM public.tbl_a WHERE ((id < 200))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
                       SELECT avg(data) FROM public.tbl_a WHERE ((id < 200))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
                       SELECT avg(data) FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
Этот процесс, очевидно, эффективен, поскольку удаленный сервер вычисляет среднее значение и в качестве результата выдает всего лишь одну строку.
Примечание: Push-Down
Push-down - это операция, при которой локальный сервер разрешает удаленному серверу обрабатывать некоторые операции, например, агрегатные процедуры.


