

Как я создал целую платформу данных всего за одну неделю
Это, безусловно, мой самый длинный проект (поэтому, пожалуйста, ставьте лайки и оставляйте комментарии), а также моя самая длинная статья. Но как бы то ни было... он действительно замечательный, и мне просто нужно было поделиться им с Вами!
Не будем лить воду и сразу перейду к делу, чтобы этот пост не превратился в 100-минутное чтение :).
Я постараюсь все упростить так, чтобы даже люди, не владеющие какими-либо технологиями, могли понять меня.
Конечная цель
Конечной целью этого проекта является создание полнофункциональной платформы/конвейера обработки данных, которая будет ежедневно обновлять наши аналитические таблицы/дашборды.
Инфраструктура
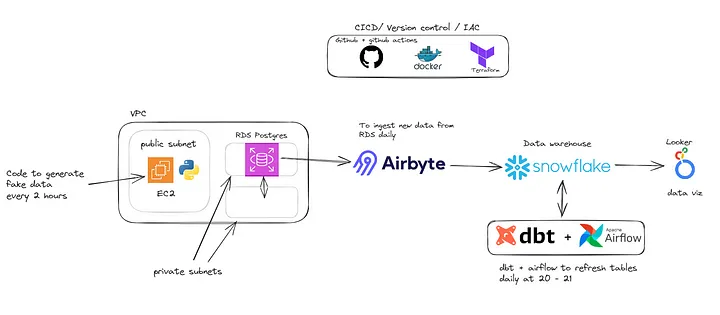
Как видно на изображении, для запуска этого проекта нам нужно настроить несколько параметров.
- Первое: Откуда будут браться данные? RDS PostgreSQL + скрипт на Python в экземпляре EC2 для генерации новых данных каждые 2 часа.
- Второе: где будут храниться данные для аналитики? Snowflake
- Третье: как мы будем связывать эти два компонента? Airbyte (облако)
- Четвертое: как мы сделаем данные пригодными для аналитики и создания дашбордов? DBT + Airflow
Пройдемся по каждому из пунктов.

Откуда данные поступают к нам?
Я устал от плоских файлов, смертельно устал!!!
Поэтому я подумал, что было бы неплохо создать скрипт, который будет генерировать фиктивные данные по расписанию (каждые 2 часа) и хранить их в базе данных Postgres (RDS).
Я не буду углубляться в эту часть, поскольку она не является нашей основной целью.
Итак, вот краткий обзор модели данных нашей исходной системы:
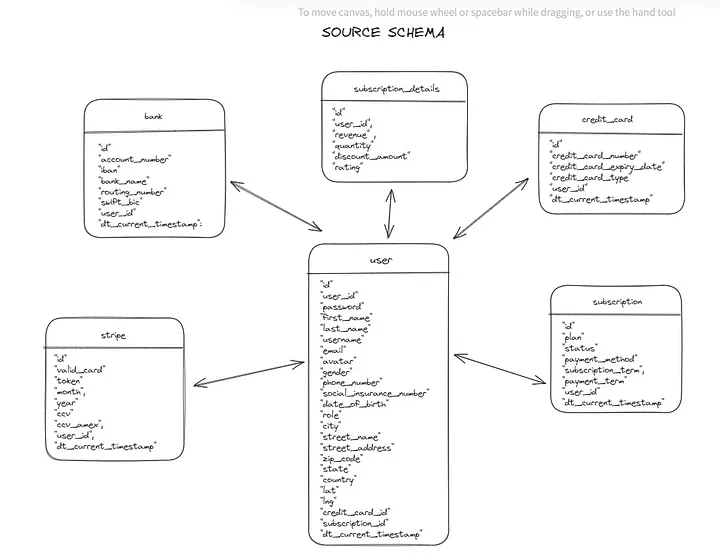
Данная модель данных является базовой и «грязнй». Я хотел получить что-то подобное для того, чтобы было над чем поработать на этапе трансформации.
Теперь, когда у нас есть модель данных и сценарий Python, нам нужно создать базу данных RDS PostgreSQL, в которой будут храниться необработанные таблицы.
Для этого предлагаю использовать Terraform и выполнить следующие шаги:
Создать VPC.
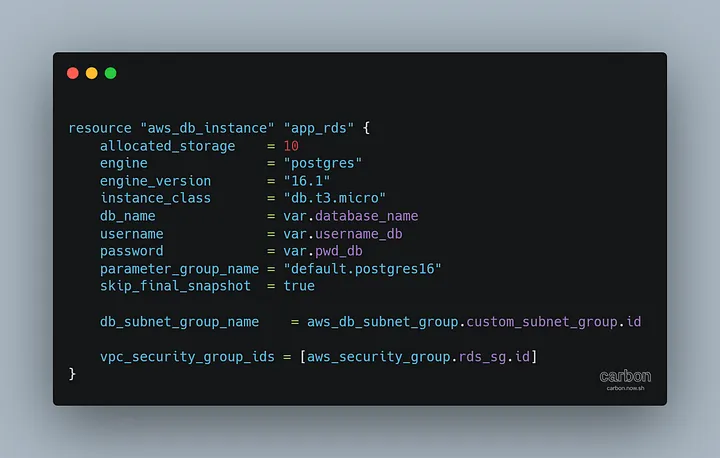
Создать две частные подсети, в которых будет размещен RDS, а также группу безопасности для разрешения трафика на порт 5432.
Создать один экземпляр EC2 в публичной подсети, где будет выполняться наш скрипт Python (он также будет служить SSH-туннелем для подключения к базе данных с помощью Airbyte, поскольку база данных не является общедоступной по соображениям безопасности), а также группу безопасности для разрешения SSH.
Вот как будет выглядеть RDS в конечном итоге:
Что касается EC2, на котором будет размещен скрипт python, вот как это выглядит:
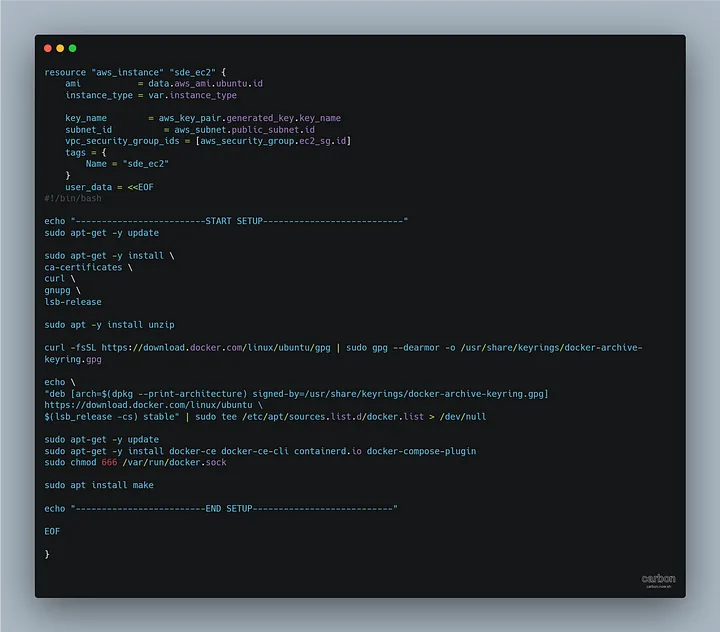
Вы, наверное, спрашиваете себя, что делает этот длинный кусок кода:
- Просто создайте экземпляр EC2, указав AMI, группу безопасности, подсеть и данные user_data для установки docker
Итак, мы создали ресурсы на AWS, теперь поговорим о том, как развернуть наш код на этом экземпляре EC2.
Просто, с помощью конвейера CICD с Github:
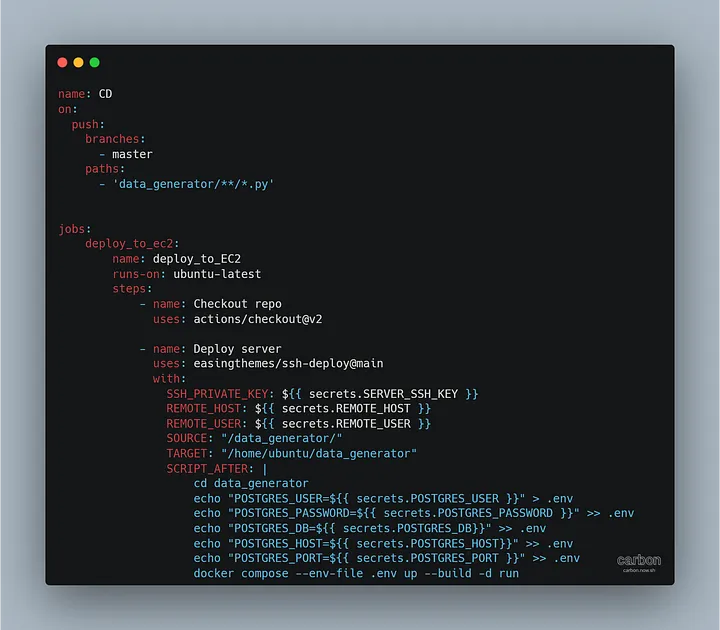
- Подключитесь к экземпляру EC2 с помощью SSH
- Скопируйте содержимое каталога, содержащего скрипт python, на этот EC2
- Запустите контейнер
Вот и все!
Где будут храниться данные?
Теперь у нас есть данные, которые обновляются каждые два часа на RDS. А что насчет целевой системы?
Ответ очевиден: SNOWFLAKE
Я выбираю его , потому что …
Потому что это Snowflake :)
В этом разделе не так много интересного - это часть того, как я структурирую базу данных:
- RAW: база данных для хранения сырых данных, поступающих из Airbyte (схема: postgres_airbyte).
- ANALYTICS : производственная база данных (схемы: staging, intermediate, marts(finance))
- DBT_DEV: база данных dev (имеет те же схемы, что и производственная база данных)
- DATA_ENGINEER : роль, позволяющая использовать базу данных RAW и владеть базами данных ANALYTICS и DBT_DEV
- AIRBYTE_ROLE : используется airbyte для записи в базу данных RAW (схема postgres_airbyte)
Если Вы спросите меня, как создать все это в Snowflake, то Вы совсем не в теме. (придется погуглить)
Как связать две системы / Как получить данные?
Изначально я предполагал написать для этой задачи собственный Python-скрипт на AWS Lambda. Однако его реализация заняла бы значительное количество времени, особенно учитывая необходимость включения Change Data Capture (CDC) для захвата только новых данных из исходной системы.
Поэтому я решил обойтись без кода/современных инструментов, в основе которых лежит «MODERN DATA STACK».
Я выбрал Airbyte, в частности Airbyte Cloud. Хотя я мог бы выбрать версию с открытым исходным кодом и установить ее с помощью Docker на экземпляр EC2, облачная версия предлагала 14-дневную бесплатную пробную версию, от которой я не мог отказаться.
Синхронизация данных из исходной системы в целевую с помощью Airbyte очень проста. Мне даже не нужно объяснять, как это делается.
В качестве режима синхронизации я выбрал «Инкрементный», при котором Airbyte извлекает только новые данные из исходной системы, и «Append + Deduped», который не требует пояснений: Airbyte обеспечивает уникальность каждой строки на основе указанного столбца (обычно первичного ключа).
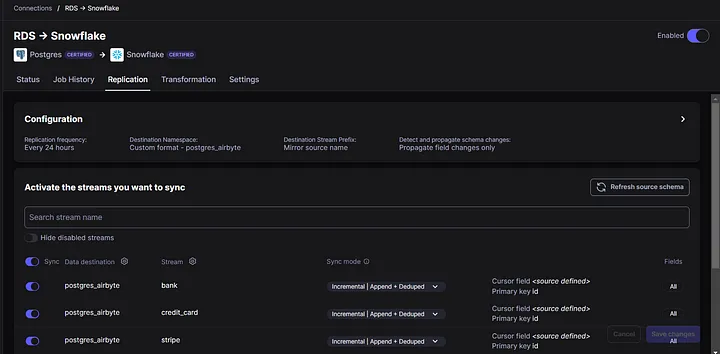
Менее чем за 10 минут мы запустили наш конвейер загрузки данных, спасибо современному стеку данных!
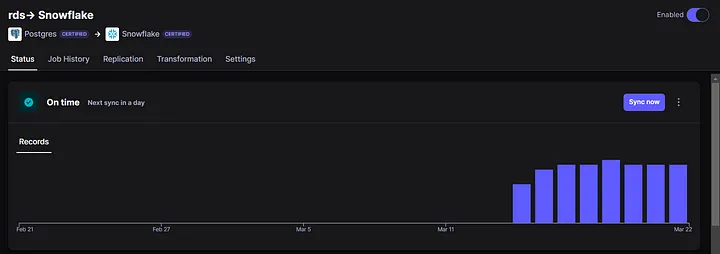
P.S.: Airbyte синхронизирует наши данные каждый день в 5 часов вечера (запомните это, пригодится позже).
Как сделать данные пригодными для аналитики/ составления дашборда?
Как Вы видели на модели данных исходной системы, мы не можем использовать эти таблицы для аналитики и создания дашбордов. Вот тут-то и пригодился подход Кимбалла.
Взгляните на эту красивую и простую схему:
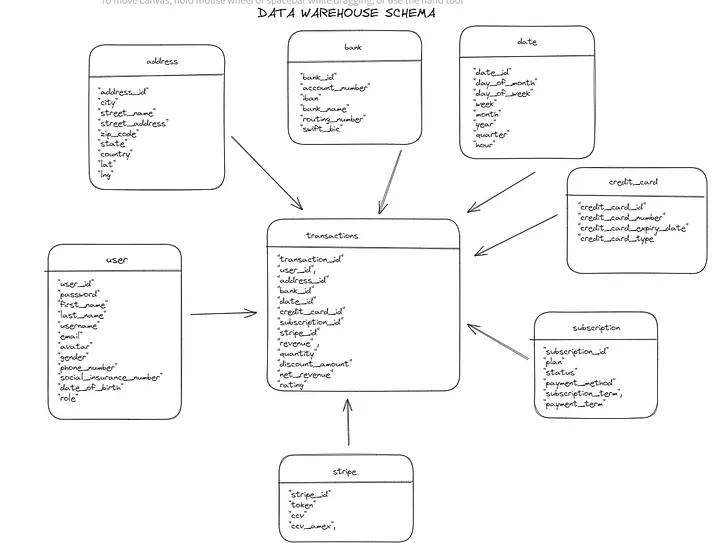
P.S.: наша конечная цель - анализ метрик плана подписки.
Теперь у нас есть желаемая модель данных, но как мы создадим эти таблицы?
Именно здесь на помощь приходит DBT.
Вот как мы структурировали наш dbt проект:
- models/staging: Это модели, хранящиеся в схеме staging. Они подвергаются простому приведению типов и быстрым преобразованиям.
Вот пример модели, которую мы создали (stg_bank):
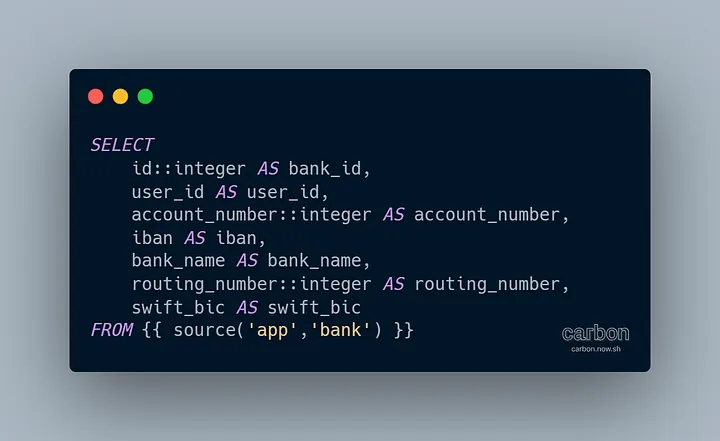
Ничего сложного, так ведь?
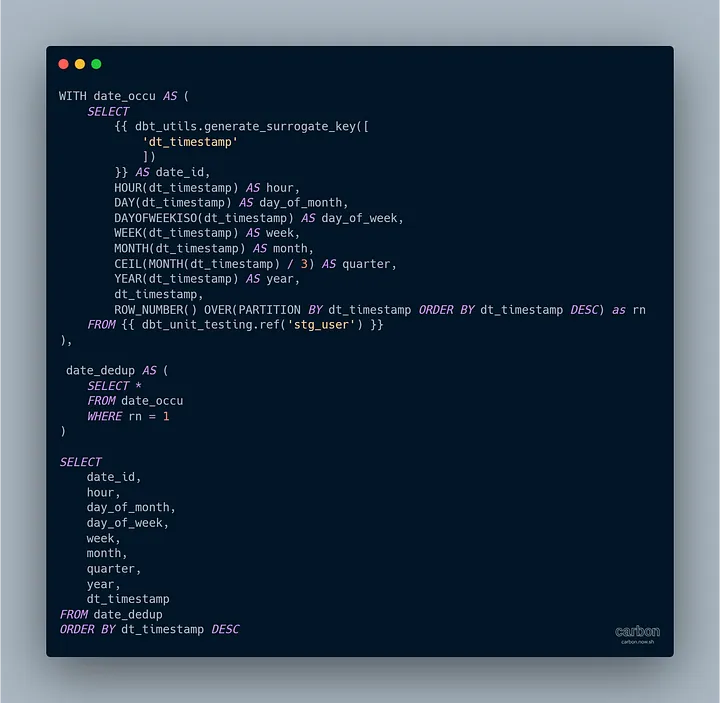
- модели/промежуточные: Здесь мы создаем таблицы фактов и измерений.
Вот пример (int_date)
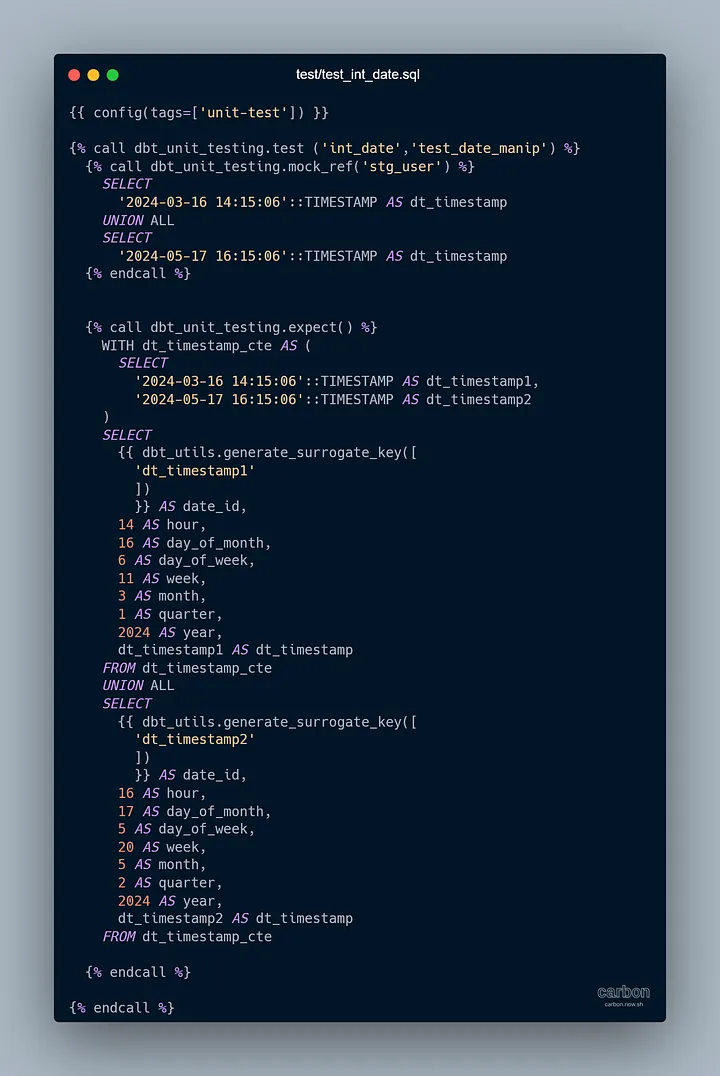
Я также создал несколько юнит-тестов, просто чтобы .... протестировать свое произведение:)
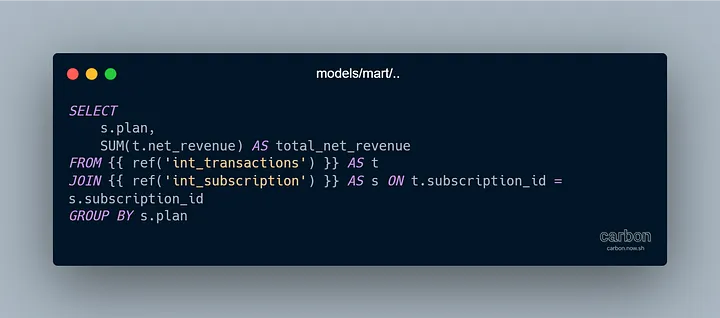
- models/marts: Здесь мы рассчитываем различные показатели, такие как общий чистый доход по планам подписки.
Мы закончили с dbt - пока что.
Перейдем к Airflow.
Airflow + Cosmos + DBT: настоящая love story
С частью DBT пока все, нужно переходить к следующему шагу. А именно запланировать ежедневный запуск этих dbt-моделей и обновлять таблицы, чтобы аналитики данных/ученые могли проводить анализ.
Именно здесь на помощь пришел Airflow, особенно библиотека COSMOS, которая позволила нам запускать модели DBT с помощью Airflow.
Как я уже говорил ранее, Airbyte получал данные каждый день в 5 часов вечера, поэтому нам нужно было запланировать запуск Airflow DAG после 5 часов вечера (каждое утро нам нужны свежие таблицы!!).
Вот как мы определили нашу DAG с помощью cosmos:
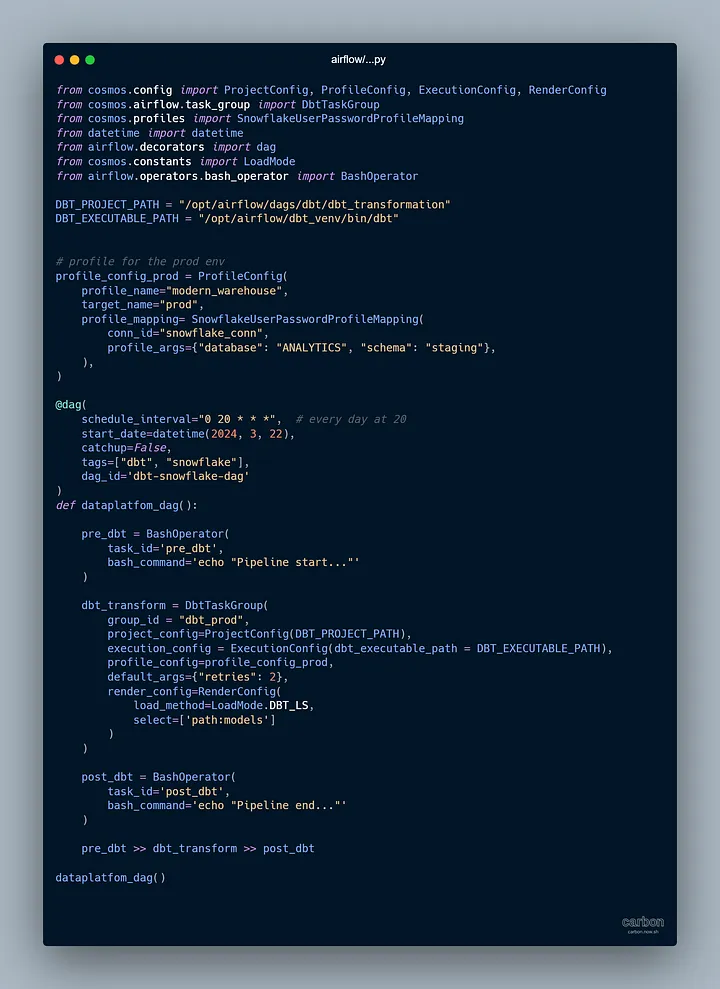
Не волнуйтесь, я размещу ссылку на репозиторий GitHub в конце статьи.
Следующим шагом будет развертывание нашего кода Airflow на EC2 (который мы создали с помощью TERRAFORM ALSO)
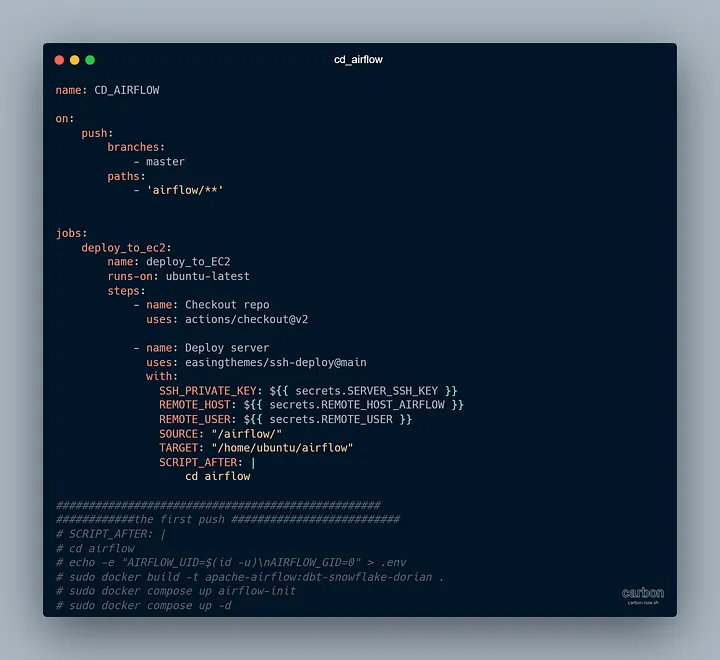
P.S.: часть SCRIPT_AFTER бесполезна.
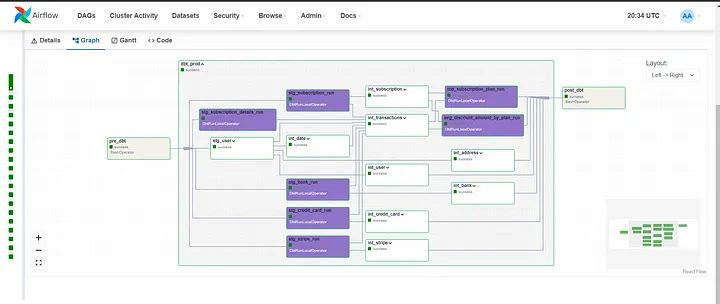
ПОЗДРАВЛЯЕМ: Наша DAG удалась и работает успешно (проверьте этот красивый UI Airflow со всеми Вашими моделями), таблицы будут обновляться ежедневно.
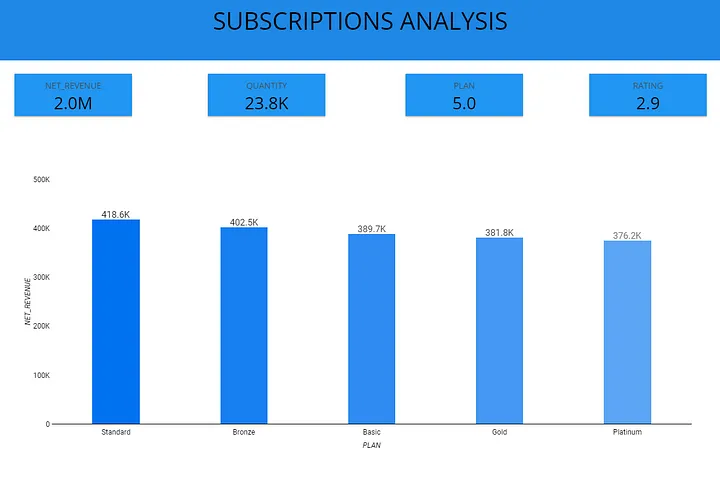
Дашборд
«Будьте проще и глупее» («Keep It Simple and Stupid») - именно так я поступил с этим дашбордом.
Четко по делу. Никаких причудливых визуальных эффектов или графиков.
Заключение
Я намеренно сделал эту статью максимально простой и понятной.
Я избегал слишком глубокого погружения в технические детали, чтобы Вы могли получить общее представление о типичном рабочем процессе инженера данных.
Благодарю за внимание!!!
GITHUB: https://github.com/Dorianteffo/modern-data-platform


