
Конец эпохи корпоративных хранилищ данных
Хранилища данных и бизнес-аналитика играют важную роль во многих, если не во всех, крупных организациях, работающих над трансформацией имеющихся данных в осмысленную информацию, представляющую собой ценность для бизнеса. Хранилище данных - это процесс сбора и управления данными из самых различных источников. Бизнес-аналитика включает в себя стратегии и технологии, используемые для получения этих самых данных. Эти направления тесно переплетаются с другими областями управления данными.
Краткий экскурс в прошлое
Хранилища данных стали популярны в девяностых годах прошлого века и начали использоваться как один из способов сбора и интеграции данных в согласованную форму с целью создания единой версии истины для всей организации, ставшей основой для принятия верных бизнес-решений.
Распространению подобного подхода способствовала еще одна модная тенденция, а именно бизнес-аналитика. BI, согласно Gartner - это “зонтичный термин, охватывающий раличные приложения, инфраструктуру и инструменты, а также лучшие практики, обеспечивающие доступ к информации и ее анализ для улучшения и оптимизации бизнес- решений и повышения производительности". Бизнес-аналитика начиналась с создания простых отчетов в красивом презентабельном виде, чуть позже появилось самообслуживание с более продвинутыми возможностями, такими как прогнозируемые функции.
Многие корпоративные организации в значительной степени до сих полагаются на хранилища данных. За последнее десятилетие их было создано огромное количество. Их принято считать критически важными активами, используемыми во многих повседневных процессах и выполняющими важную роль в потреблении и распределении данных внутри компаний. В этой статье я расскажу Вам о некоторых популярных подходах и общих характеристиках, а также раскрою концепцию корпоративных хранилищ данных.
ВНИМАНИЕ: Прежде чем мы продолжим, я должен предупредить Вас. По моему глубокому убеждению, корпоративное хранилище данных (EDW) скоро перестанет существовать. Не сама концепции хранилищ данных, а их использование в целях интеграции, потребления и распространения данных в масштабах предприятия. Далее я объясню Вам, почему я так считаю.
Хранилища данных
Многие компании по-прежнему вкладывают значительные средства в хранилища данных. Однако размеры и масштабы используемых архитектур хранилищ данных существенно различаются. Прежде чем я расскажу Вам о своей точке зрения подробнее, предлагаю немного отступить назад и начать с самого начала.
Что такое хранилище данных?
Что такое хранилище данных? Основная концепция хранилища данных была представлена в 1988 году исследователями компании IBM Барри Девлином и Полом Мерфи. По мере усложнения компьютерных систем и увеличения объемов данных потребовалась архитектурная модель для передачи данных из операционных систем в среду поддержки принятия бизнес-решений. Через несколько лет Билл Инмон опубликовал книгу и дал более конкретное определение того, для чего предназначены хранилища данных: "хранилище данных - это предметно-ориентированная, интегрированная, изменяющаяся во времени и энергонезависимая коллекция данных для поддержки процесса принятия решений руководством компании".
По мере роста популярности хранилищ данных и появления вариаций с различными определениями, я предпочитаю определять хранилище данных как "систему, которая согласовывает (исторические) данные из различных источников в центральном хранилище и управляет ими с целью поддержки процесса принятия бизнес-решений". Из этого предложения можно выделить ряд важных характеристик. Из слова "центральное" можно сделать вывод, что в хранилище данных данные собираются вместе и хранятся централизованно. Во многих случаях это действительно так, но некоторые технологические тенденции позволяют развивать хранилище данных и другими способами, например, виртуализацией данных. Из слова «согласовывает» можно сделать вывод, что данные интегрируются, унифицируются и становятся согласованными. Это означает, что для сбора, очистки, фиксации, преобразования и хранения данных необходимы дополнительные компоненты. Говоря о различных источниках, мы явно указываем на их многочисленность, поэтому хранилище данных не используется и никогда не будет использоваться для сбора данных из одного источника.
Однажды Билл Имон сказал, что "одна из главных привлекательных сторон концепции хранилища данных заключается в том, что существует единая версия истины". Единая версия истины означает, что используется единый словарь, и все пользователи должны быть согласны с его определениями, используемыми в хранилище данных. Более подробно аспект, связанный с единым словарем, мы рассмотрим чуть ниже.
Это звучит довольно исчерпывающе, но зачем вообще нужно хранилище данных? В чем его преимущества? Для того чтобы лучше понять, почему хранилища данных полезны, нам необходимо сделать шаг назад и рассмотреть некоторые ключевые факторы. Для рассмотрим, как работают транзакционные и аналитические системы.
OLTP (обработка транзакций в режиме реального времени)
Сфера приложений и баз данных традиционно делится на два мира. Многие из приложений начинались как транзакционные или операционные, поскольку мир компьютеров начинался с предъявления требований к обработке транзакций и хранению записей. Эти системы значительно повышали эффективность процессов, поскольку были способны заменить традиционные каталоги и многие ручные процессы. Банковские системы, системы бронирования авиабилетов, системы управления заказами, телекоммуникационные системы, системы здравоохранения, торговые системы и т.д. Эти приложения называются системами обработки транзакций в режиме реального времени (OLTP).
Для OLTP-систем важно то, что должны быть гарантированы и согласованность, и стабильность данных. Представьте себе, что Вы руководите крупной региональной телекоммуникационной компанией и ее телекоммуникационная система неожиданно выходит из строя. Последствия могут быть чудовищными. Клиенты не могут никому позвонить, ответить на звонки, получить текстовые сообщения и т.д. Если это , то клиенты потеряют всяческое терпение, доверие к Вашей компании и в конечном счете уйдут. Поэтому OLTP-системы проектируются с учетом обеспечения целостности данных, стабильности и доступности системы. Большинство из них соответствуют стандарту ACID.
На примере OLTP-систем можно сделать вывод, что рабочие нагрузки (операционные) обычно вполне предсказуемы. Запросы относительно просты, а получаемые данные относительно невелики по объему. Таблицы в OLTP-системах обычно нормализованы.
Нормализованность имеет ряд недостатков: операционные системы не предназначены для обеспечения репрезентативного комплексного представления о том, что происходит в домене или бизнесе. Извлечение данных из нормализованных моделей данных для решения сложных вопросов зачастую затруднено. Сложные вопросы требуют большего количества данных и их комбинаций. Для написания такого запроса потребуется объединить или сгруппировать множество таблиц. Подобные запросы, как правило, достаточно требовательны к производительности, поэтому при выполнении слишком большого их количества возникает риск достижения предельных значений производительности. В этом случае система становится непредсказуемой, а это последнее, что мы хотели бы видеть в OLTP-системах, учитывая доверие, которое мы должны обеспечить.
Следствием высокой производительности является то, что системы OLTP являются дорогостоящими. Они, как правило, не рассчитаны на хранение больших объемов данных, поэтому для поддержания их работоспособности и пригодности к использованию важно управление жизненным циклом данных. Как правило, неиспользуемые данные либо удаляются, либо перемещаются во вторичное хранилище. Из этого вторичного хранилища данные всегда можно поместить обратно, если они снова станут актуальными.
Системы OLTP - это только одна часть традиционного деления баз данных. Другая часть - это OLAP-системы.
OLAP (оперативная аналитическая обработка )
Бизнес-пользователи хотят анализировать данные для принятия эффективных бизнес-решений. Поскольку OLTP-системы дороги и выполняют самые различные задачи, общепринятой практикой всегда стал вынос данных в другую среду. Эта другая среда (другие системы и базы данных) будет использоваться для оперативной аналитической обработки (OLAP). Поскольку автономная аналитика обычно менее критична для бизнеса, требования к целостности и доступности могут быть менее жесткими. Поэтому можно сказать, что OLAP-системы обычно менее дорогостоящие по сравнению с OLTP-системами.
В системах OLTP данные хранятся и оптимизируются с точки зрения целостности, а в OLAP мы оптимизируем их с точки зрения аналитической производительности. Поскольку в основном мы выполняем многократное чтение и почти не записываем данные, то обычно оптимизируем их для интенсивного чтения. Таблицы в OLAP-базе данных обычно не сильно нормализованы, но предварительно обработаны и имеют денормализованную структуру: уплощены, разрежены и содержат больше копий. Когда данные логически сгруппированы и физически хранятся вместе, их гораздо легче обрабатывать.
Примечание: Некоторые системы сочетают в себе OLTP и OLAP. Такие системы называются HTAP (Hybrid Transaction / Analytical Processing или гибридная транзакционно-аналитическая обработка) - термин, созданный компанией Gartner. Внутри этих систем, как правило, существует две базы данных. Одна база данных рассчитана на множество мелких транзакций с высокой долей обновлений. Другая (in-memory) обрабатывает сложные запросы для аналитических нагрузок. Такой подход к разделению команд и запросов напоминает CQRS.
OLAP-системы обычно используются для облегчения управления жизненным циклом данных путем хранения неиспользуемых или редко используемых данных из OLTP-систем. Это делается по двум причинам. Первая причина заключается в том, что исторические данные представляют ценность, поскольку для анализа мы зачастую обращаемся к прошлому. Вторая причина – это производительность. После того как OLTP-системы скопировали данные в OLAP-системы, они производят очистку, удаляя избыточные копии. Это делает OLTP-системы более эффективными, поскольку если таблицы содержат меньше данных, то поиск и запросы выполняются быстрее.
В OLAP-системах часто объединяются данные из нескольких OLTP-систем, поскольку бизнес-пользователи или аналитики данных часто создают комбинации данных. Это требует определенной гармонизации или унификации, поскольку системы используют различные контексты и имеют различные структуры данных.
Что такое операционные склады данных? Операционные склады данных (ODS), как правило, используются для оперативного анализа данных и составления отчетности. ODS несут в себе некоторые черты как OLTP, так и OLAP-систем. Слово "операционные" сближает ODS с OLTP-системами, поскольку их назначение - получение информации об операционных показателях и деятельности.
От OLAP-систем ОDS отличаются тем, что в целом они хранят больше исторических данных, чем OLTP-системы. Еще одна особенность заключается в том, что ODS могут интегрировать небольшие объемы данных из других систем
В целом ODS ближе к OLTP-системам, с которыми им предстоит работать. Структуры таблиц часто похожи. В результате ODS отличаются от хранилищ данных тем, что в них обычно используются данные только из одной OLTP-системы, в отличие от хранилищ данных, в которых хранятся данные из множества источников.
Согласование нескольких источников является хорошим мостиком к хранилищам данных, поскольку они также сводят данные в согласованную форму и облегчают аналитическую деятельность. Поэтому хранилища данных можно отнести и к OLAP.
Как работают хранилища данных?
Теперь, когда мы знаем, что хранилища данных объединяют данные из различных источников в интегрированную модель данных (единую версию истины), настало время углубиться в эту тему. В следующих разделах я хочу обсудить некоторые общие характеристики и стили построения и хранилищ данных. Наиболее популярные стили были разработаны лидерами отрасли Биллом Инмоном и Ральфом Кимбаллом.
Стиль Инмана
По мнению Билла Инмона, любая часть данных, которая может оказаться полезной, должна храниться в единой универсальной модели данных, которая будет являться "единым источником истины" для всего предприятия. Этот источник истины использует для хранения целочисленную и модель, как правило, 3NF-структуру. Из этого единого источника истины делаются выборки (подмножества) для конкретных проектов, сценариев использования или отделов. Выбранное подмножество, оптимизированное для каждого конкретного случая использования, называется хранилищем данных.
Стиль Кимбалла
По мнению Ральфа Кимбалла, хранилище данных должно представлять собой конгломерат или коллекцию размерных данных, которые являются копиями транзакционных данных из исходных систем. Поскольку хранилище данных используется для различных целей, Кимболл ввел понятие "согласованных размерностей", которые представляют собой ключевые размерности, разделяемые и используемые различными потребителями.
В следующих разделах мы подробнее рассмотрим эти два стиля, а также некоторые общие компоненты, необходимые при проектировании и создании хранилищ данных. Начнем с уровня хранения и затем перейдем к рассмотрению остальных частей хранилища данных.
Область стейджа (staging area)
Для создания хранилища данных требуется ряд компонентов. В рамках вышеупомянутых подходов данные сначала должны быть извлечены и сохранены (сгруппированы) в промежуточной области хранения. Такая зона, позволяющая данным сначала "приземлиться", называется областью стейджа (Staging Area).
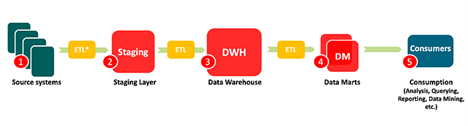
Области стейджа всегда находятся между источниками данных и объектами данных, которыми зачастую являются хранилища данных. Они используются для разделения систем и играют важную роль в процессах извлечения, преобразования и загрузки данных (ETL). Области стейджа могут быть реализованы различными способами, начиная от реляционных баз данных и заканчивая файловыми хранилищами.
Данные области также используются для сохранения исторических копий. Это полезно для сценариев повторной обработки, когда хранилище данных повреждено и его необходимо восстановить. Количество исторических копий в разных областях хранения может разниться. Мне приходилось сталкиваться с ситуациями, когда все поставки данных, включая исправления, должны были храниться для аудита в течение нескольких лет. С другой стороны, были в моей практике и такие случаи, когда после успешной обработки или по истечении определенного периода времени область хранения очищалась - очистка позволяет экономить на хранении данных.
Области стейджа играют важную роль и в области качества данных. Перед началом ввода данных в хранилище данных рекомендуется сначала провести их проверку. Если в каком-либо из источников отсутствуют данные (или они недостоверны), обработку можно приостановить до тех пор, пока необходимые данные не будут предоставлены или исправлены. Как только все критерии приемки данных будут выполнены, можно приступать к их обработке и вводу в интеграционный слой хранилища данных.
Интеграционный слой
После успешной проверки всех данных и выполнения всех критериев их приемки данные готовы к интеграции. Именно здесь все очищенные, исправленные, обогащенные и преобразованные данные хранятся вместе в общей модели. Данная модель гармонизирована, что означает унификацию форматов, типов, структур и отношений. Предполагается, что на этом уровне будут находиться и исторические данные.
Интеграционный слой и то, как данные здесь хранятся и структурируются – это именно тот пункт, в котором стили Инмана и Кимбалла отличаются друг от друга.
Стиль Инмана
В стиле Инмана все данные сначала попадают на интеграционный слой, который имеет нормализованную реляционную модель. Можно заметить, что этот слой похож на модели данных, которые мы обсуждали в OLTP, и в данном случае Вы будете правы. Он представляет собой транзакционные системы, но в гармонизированном виде. Такая реализация требует проведения большой предварительной работы по моделированию данных для согласования всех различных структур исходных систем и преобразования их в гармонизированную и унифицированную модель данных. На этапе перехода из области стейджа на интеграционный слой обычно применяется специфическая и сложная логика ETL.
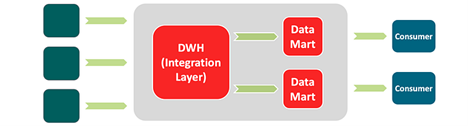
Стиль Инмона также подразумевает витрины данных. После хранения данных в интеграционном слое создаются дополнительные слои для потребителей. Эти (презентационные) слои называются витринами данных. Как правило, они содержат лишь часть данных интеграционного слоя. Кроме того, они специфичны для каждого конкретного случая использования или группы пользователей.
Витрины данных часто реализуются с помощью кубов, хотя могут быть реализованы и с использованием реляционных баз данных (по схемам "звезда" и "снежинка"). Дополнительный слой витрины данных имеет преимущество: витрины данных отделены от интеграционного слоя. Изменения на интеграционном уровне, если они сделаны аккуратно, не должны влиять на витрины данных и, соответственно, на потребителей данных.
Стиль Инмана имеет ряд недостатков. Во-первых, время разработки обычно достаточно велико. Во-вторых, при необходимости добавления новых данных в витрину данных всегда приходится сначала добавлять данные в интеграционный слой. Поскольку разработка занимает время, а изменения в интеграционном слое должны вноситься аккуратно, пользователям, которым нужны новые данные, приходится ждать (причем долго). В приведенном ниже списке приведены все плюсы и минусы стиля Инмана.
Плюсы
- Низкая избыточность данных благодаря (сильно) нормализованной модели интеграционного уровня;
- Витрины данных отделены от интеграционного слоя;
- Последовательная компоновка, хорошо подходит для исторических данных;
- Большинство инженеров знакомы с принципами нормализации 3NF.
Минусы
- Более длительное время разработки;
- Потребность в одновременном ввода данных из всех источников - это значительно снижает параллелизм и гибкость при загрузке данных;
- Ссылочная целостность становится проблемой, если источники данных исчезают или сильно изменяются.
Стиль Кимбалла
В данном случае способ хранения данных в интеграционном слое отличается от способа хранения данных в транзакционных системах. Когда происходит копирование данных в интеграционный слой, они уже оптимизированы для чтения. В каком-то смысле данные схожи с витринами данных в стиле Инмана. Отличие от стиля Инмана заключается в том, что интеграционный слой представляет собой конгломерат размерных таблиц, являющихся составными частями витрин данных. В рамках этого подхода хранилище данных представляет собой комбинацию всех индивидуальных витрин данных.
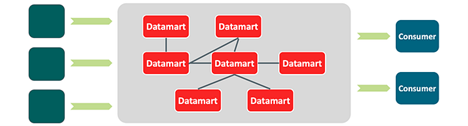
Важным аспектом стиля Кимбалла является то, что данные сгруппированы в факты и размеры. Факты – это количественные числа: данные о продажах, суммы и так далее. Размеры – это бизнес-сущности, такие как покупатели, продукция, работники, контракты и так далее. Концептуально эти группы – это тоже самое, что и витрины данных, разница заключается в том, что они находятся в одном и том же интеграционном слое и используют одни и те же технологии, связанные с базами данных. Основным преимуществом модели Кимбалла является то, что она более производительная – как правило, пользователям не нужно ждать начала потребления данных месяцами или даже годами.
Однако у этой модели есть и свои недостатки. Поскольку витрина данных содается для определенной группы пользователей, как правило, для создания специфичной схемы требуется больше дополнительных таблиц. Поскольку у пользователей будет больше противоречивых требований, потребуется больше дополнительных таблиц – «помощников».
В рамках модели Кимбалла возрастает вероятность того, что пользователи начнут повторно использовать интеграционную логику или таблицы – «помощники», относящиеся к другим случаям использования или пользователям. Таким образом, по мере увеличения количества пользователей возрастает сложность модели, соответственно, даже незначительные изменения в структуре могут заметно сказаться на всех пользователях.
Наконец, обновления и удаления могут заметно отразиться на производительности ввиду высокого уровня денормализации, применной по отношению к таблицам. Ниже я привел все основные преимущества и недостатки модели Кимбалла.
Плюсы
- Больше подходит для многомерного анализа;
- На разработку модели требуется меньше времени;
- Более высокий уровень гибкости.
Минусы
- Обмен таблицами – «помощниками» приводит к возникновению более тесных связей между пользователями;
- Обновление и удаление данных обходится дороже;
- Объемы данных больше (по сравнению со стилем Инмана).
Основываясь на преимуществах и недостатках двух стилей, дата-инженеры начали экспериментировать и комбинировать эти два подхода. Так появился Data Vault.
Data Vault
Система Data Vault была создана Дэном Линстедтом и получила особую популярность в Северной Европе. Линстедт определил хранилище данных как ориентированный на детали, историческое отслеживание и уникальную связь набор нормализованных таблиц, поддерживающих одну или несколько функциональных областей бизнеса.
Data vault решает проблемы стилей Инмона и Кимбалла с помощью концентраторов, сателлитов и связующих таблиц. Благодаря разделенным таблицам хранилище данных становится более разобщенным, что позволяет параллельно загружать данные и более гибко вносить изменения. Взаимосвязи могут быть легко удалены и воссозданы "на лету", а новые системы могут быть интегрированы в существующую модель без каких-либо сбоев.
Однако у этих преимуществ есть и обратная сторона: хранилище данных само по себе не приспособлено для специальных запросов и анализа, поскольку запрос ко всем узлам, спутникам и связям требует значительных затрат производительности. В большинстве случаев для этого требуется дополнительный слой представления или витрина данных.
Количество таблиц в Data Vault значительно превышает 3NF-моделирование. Это требует большего числа заданий ETL для обеспечения ссылочной целостности между различными таблицами, что значительно повышает сложность проектирования хранилища данных. Такие компании, как Wherescape, могут оказать содействие в решении этих проблемы, генерируя задания ETL с помощью метаданных.
Последний важный аспект, который стоит отметить – это отсутствие строгого или формального стандарта. Концептуально хранилище данных описано хорошо, но люди используют различные вариации его реализации. Дэн Линстедт, Кент Грациано и Ханс Хультгрен, все эксперты в этой области, выступают за разнородность хранилищ данных, что создает риск применения противоречивых стилей в рамках крупных проектов.
Перечислим плюсы и минусы Data vault.
Плюсы
- Более высокая адаптивность к изменениям;
- Подходит для использования в режиме реального времени;
- Можно использовать более гибкие подходы к разработке
Минусы
- При использовании метода Data Vault требуется большое количество объединений. Это может привести к снижению производительности. Необходим дополнительный "презентационный слой";
- Требуются более опытные дата-инженеры, поскольку применяемые лучшие практики и подходы различны;
- Требуется большее количество заданий ETL и таблиц. Это может увеличить сложность проектирования. Гибридный подход также требует от дата-инженеров более творческого подхода, что создает дополнительные сложности и несогласованность в долгосрочной перспективе.
Хранилища данных отличаются от других приложений наличием интеграционных слоев и сложных моделей данных. Они потребляют, объединяют, гармонизируют и интегрируют данные. Такие методы интеграции требуют специальных знаний в области моделирования данных, что, как правило, отличается от проектирования и разработки обычных приложений.
Сбор данных
Хранилища данных не могут быть созданы без возможности сбора данных из различных источников. Ранее мы познакомились с ролью областей хранения данных, облегчающих сбор данных в различных форматах. Но мы не обсудили форматы или структуры, в которых поступают эти источники данных.
Распространенный формат доставки данных - это использование сырого формата исходных систем. Как правило, в хранилища данных поставляются полные коллекции данных. Недостатком такого способа доставки является высокая связь с внутренними структурами данных исходной системы (систем), поскольку они имеют одинаковые представления. Если система-источник изменит свою структуру, то обработка данных может быть прекращена.
Альтернативным методом предоставления данных в хранилища данных является согласование некоторой формы абстракции. Структуры могут быть согласованы как более простые, они могут иметь фиксированный формат. Подобные изменения избавляют от необходимости прекращать процессы при изменении структуры исходных систем.
Более экстремальной формой абстракции является просьба к исходным системам привести свои данные в соответствие с форматом интеграционного слоя. В этом случае файлы из исходных систем должны поставляться в точно таком же формате, как и в хранилище данных.
Примечание: Большинство компаний (Oracle, SAP, Siebel и др.) используют для своих операционных систем узкоспециализированные и нормализованные модели данных, которые меняются с каждым циклом выпуска. Эти модели данных крайне трудно интерпретировать. Люди зарабатывают на жизнь как раз тем, что умеют интерпретировать и отображать эти модели данных в хранилища данных.
Для облегчения интеграции данных обычно выбирается стандартизованный формат. Наиболее популярными являются форматы Comma-separated values (CSV) и Parquet, поскольку большинство баз данных и ETL-инструментов могут работать с этими форматами. Можно также использовать XML и JSON, но эти форматы в целом подразумевают больше накладных расходов, поскольку в них включается большое количество метаданных.
Альтернативой является запрос или извлечение данных на основе их изменений. При таком подходе поставляются только измененные данные. Популярным шаблоном проектирования является использование Change Data Capture (CDC), который поддерживается большинством производителей и может работать с различными механизмами: на основе временных меток, версий, индикаторов и т.д.
Возможности ETL
Следующим шагом после сбора всех данных является их интеграция в интеграционный слой. Данные должны быть очищены и преобразованы в единую модель хранилища данных. Для этого требуются инструменты ETL, которые могут быть реализованы несколькими способами.
Наиболее распространенным способом является забор данных из областей хранения, их преобразование и загрузка в интеграционный слой с помощью коммерческих ETL-инструментов. Среди них особенно популярны Informatica, SQL Server Integrated Services, Ab Initio, Infosphere Information Server, Talend, Pentaho и Oracle Data Integrator. Все эти инструменты обладают широким набором функций и богатыми возможностями отладки и тестирования, а также зачастую интуитивно понятным интерфейсом. Они могут извлекать данные в собственную локальную среду или делегировать работу целевой базе данных. Общим их недостатком является жесткая привязка к поставщику - выбрав поставщика ETL для своего хранилища данных, Вы навсегда связываете себя с ним «узами брака».
Альтернативой ETL-инструментам является самостоятельное создание ETL-фреймворка. Я видел ряд компаний, которые генерируют ETL-код (Java, PL/SQL от Oracle, SQL от Teradata и т.д.) из репозиториев метаданных. Также распространены случаи кодирования и хранения всей интеграционной логики в репозитории исходного кода, например git. Преимуществом самостоятельного создания ETL-инструмента является меньшая привязка к какому-либо поставщику. Если Вы придерживаетесь общепринятого открытого стандарта ANSI SQL, то в любой момент можете заменить технологию базы данных в хранилище данных. Однако, сценарий "сделай сам" требует привлечения высококвалифицированных инженеров для обслуживания и разработки. Существует потенциальный риск того, что со временем инженеры уйдут.
Обработка ETL в экосистеме хранилища данных, как правило, не допускает большого количества вариаций. Как правило, используется только один продукт или фреймворк. Еще одна причина статичности экосистемы заключается в том, что многие предприятия боятся вносить серьезные изменения в ETL: код часто бывает слишком сложным, поскольку он создавался в течение многих лет.
Виртуализация данных
Во вступлении к этой статье я упомянул о том, что тенденции к построению хранилищ данных изменились. Одной из новейших технологий является виртуализация данных: данные остаются на месте, а доступ к источникам и их просмотр осуществляется как к единой базе данных, без необходимости физического извлечения и дублирования данных, ориентированного на пакетную обработку. Эта технология поставляется с прикладным компонентом: движком виртуализации, который обрабатывает все входящие запросы, определяет оптимальную стратегию кэширования, знает, как обращаться к различным технологиям хранения данных, как их интегрировать и т.д. Я визуализировал эту технологию ниже.
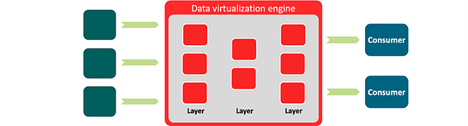
Хотя эта методика выглядит достаточно привлекательно, у нее есть ряд недостатков:
- Извлечение слишком большого объема данных может привести к сбою или нестабильной работе OLTP-систем. Виртуализация данных устраняет этот риск путем "кэширования" данных, то есть сохранения их копии в механизме виртуализации, но эта схема не устраняет риск полностью. При маршрутизации слишком большого количества запросов Вы все равно можете нанести вред OLTP-системам. В качестве альтернативы можно ускорить их работу, но это может быть слишком дорого, поскольку операционные системы дороже аналитических;
- Уровень виртуализации данных приводит к более тесному взаимодействию. Если меняются исходные системы, то сразу же требуются изменения и в слое виртуализации данных. Здесь могут помочь представления или дополнительные уровни, но любое изменение все равно требует перекрестной координации между владельцами исходных систем и инженерами, поддерживающими уровень виртуализации данных;
- Виртуализация данных не позволяет создавать новые данные, что потребовалось бы при необходимости внесения исправлений;
- Виртуализация данных опирается на сеть. В сильно распределенной среде с большим количеством сетей вполне возможен рост задержек;
- Виртуализация данных не может удалить неактуальные данные из базовых систем. Она требует, чтобы все исторические данные оставались в системах OLTP, что в долгосрочной перспективе делает виртуализацию данных достаточно дорогостоящим решением. В качестве альтернативы можно переместить данные во вторичное хранилище и снова объединить их на уровне виртуализации, но такой подход повышает сложность, поскольку необходимо разрабатывать и поддерживать сразу несколько уровней абстракции;
- Виртуализация данных ограничена базовой технологией поддержки, которая обычно представляет собой реляционную систему управления базами данных. Хотя виртуализация данных может читать многие системы баз данных, в общем случае она не позволяет создавать конечные точки баз данных типа "документ", "ключ-значение", "столбец" и "граф", если это необходимо;
- При интенсивных и повторяющихся запросах виртуализация данных потребляет больше вычислительной мощности, поскольку преобразования происходят в режиме реального времени. Методы кэширования позволяют снизить этот показатель, однако при использовании данных после их физического преобразования и хранения объем вычислительной мощности всегда будет сопоставимо больше.
Примечание: Некоторые производители баз данных предоставляют уровень запросов к базе данных, который также называют уровнем виртуализации данных. Этот уровень абстрагирует базу данных и оптимизирует данные для повышения производительности чтения. Еще одна причина абстрагирования - перехват запросов для повышения безопасности. В качестве примера можно привести Amazon Athena.
Несмотря на недостатки, виртуализация данных может помочь в случае миграции данных. Кроме того, она отлично работает в режиме реального времени, а значит, быстрее для относительно небольших объемов данных, по сравнению с инструментами ETL, которые должны обработать и сохранить все данные, прежде чем их можно будет использовать.
BI
Последняя возможность, о которой мы пока не говорили подробно, - это средства бизнес-анализа (BI), которые используются для получения информации и представления результатов для принятия правильных бизнес-решений. Они стали весьма популярны по мере появления хранилищ данных. С течением времени расширялись и их возможности. Если первые версии включали только лишь простые функции создания отчетов и дашбордов, то более поздние поколения предлагают широкие возможности визуализации, поддерживают возможность самообслуживания, методы кэширования данных и прогностическую аналитику. Таким образом, бизнес-аналитика не исключает расширенную аналитику: обе дисциплины дополняют и усиливают друг друга.
Современные средства бизнес-аналитики достаточно гибки в отношении количества источников, с которыми они могут работать. Традиционно BI-инструменты были более тесно связаны с хранилищами данных, но более поздние поколения способны извлекать и объединять данные из множества и более разнообразных источников.
В чем разница между OLAP, ROLAP, MOLAP и HOLAP? Кубы, также известные как OLAP-кубы, представляют собой предварительно обработанные и обобщенные коллекции данных, позволяющие значительно увеличить время выполнения запросов.
OLAP (Online Analytical Processing) относится к специализированным системам или инструментам, которые делают данные легкодоступными для принятия аналитических решений. Кубы OLAP представляют собой логические структуры, определяемые метаданными. Многомерные выражения, или MDX, - это популярный язык запросов на основе метаданных, который позволяет выполнять запросы к этим OLAP-кубам. Поставщики предлагают разнообразные OLAP-продукты, которые можно разделить на три категории:
ROLAP (Relational Online Analytical Processing): продукты ROLAP тесно взаимодействуют с реляционными базами данных для поддержки OLAP. Часто для расширения и адаптации базовой структуры реляционной базы данных для представления ее в качестве OLAP-сервера используется структура "звездной схемы".
MOLAP (Multidimensional Online Analytical Processing): продукты MOLAP обеспечивают многомерный анализ данных, помещая их в кубическую структуру. Данные в этой модели сильно оптимизированы для обеспечения максимальной производительности запросов.
HOLAP (Hybrid Online Analytical Processing): продукты HOLAP сочетают в себе MOLAP и ROLAP, используя реляционную БД для большей части данных и отдельную многомерную БД для наиболее плотных данных, которые, как правило, составляют лишь небольшую часть данных.
Вы узнали много нового о том, как работают хранилища данных, как устроены интеграционные слои, как происходит ввод и потребление данных. В следующем разделе мы обсудим озера данных, которые некоторые называли хранилищем данных второго поколения.
Озеро данных
По мере роста объемов данных инженеры начали работать над другими концепциями хранения данных. В качестве альтернативы доступа к необработанным и большим объемам данных стали появляться озера данных . Предоставляя данные "как есть", без предварительной структуризации, любой потребитель может сам решать, как их использовать, как преобразовывать и интегрировать.
Озера данных и хранилища данных считаются централизованными хранилищами данных, но они отличаются тем, что в озерах данных данные хранятся до их преобразования, очистки и структурирования. Кроме того, они поддерживают более широкий спектр форматов данных: структурированные, полуструктурированные и неструктурированные.
Более существенное различие между хранилищами данных и озерами данных заключается в используемых технологиях. Хранилища данных обычно проектируются на базе реляционных баз данных, а озера данных - на базе распределенных баз данных или NoSQL-систем. Популярностью пользуется система Hadoop, поскольку она работает на аппаратном обеспечении и может быть экономически эффективной. Кроме того, она обладает высокой масштабируемостью, открытым исходным кодом и модульной структурой, позволяющей использовать большое количество типов баз данных и аналитических фреймворков.
Использование публичных облачных сервисов также является популярным выбором для построения озер данных. Появившиеся в последнее время распределенные и полностью управляемые облачные базы данных на базе контейнерной инфраструктуры значительно упростили задачу управления централизованными хранилищами данных, добавив преимущества в эластичности и стоимости.
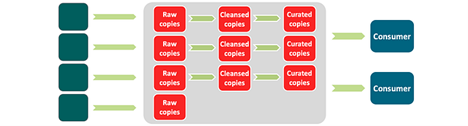
Многие озера данных, как показано на рисунке выше, собирают немодифицированные и необработанные данные из исходных систем. Загрузка необработанных данных осуществляется быстро и позволяет аналитикам получить быстрый доступ к данным. Однако сложность работы с необработанными данными заключается в том, что при их использовании всегда требуется переработка данных: необходимо устранить проблемы с качеством данных, произвести агрегирование и обогатить данные другими данными, чтобы придать им новый контекст. Это влечет за собой большое количество повторяющейся работы, и именно поэтому озера данных обычно объединяют с хранилищами данных.
Хранилища данных в таком сочетании выступают в качестве высококачественных хранилищ очищенных и согласованных данных, а озера данных - в качестве аналитических сред, содержащих большое количество необработанных данных для облегчения их анализа. При их объединении результаты анализа возвращаются в хранилище данных, в то время как озеро данных создается для необработанных данных и управляется вручную.
Зная, что такое озеро данных, мы можем перейти к следующему разделу, в котором я хочу обсудить применение хранилищ и озер данных в организациях.
Подводные камни корпоративных хранилищ данных и озер данных
По мере того как люди начинали понимать все преимущества хранилищ данных, масштабы их применения становились все больше и больше. Компании отправили своих работников в учебные центры, бизнес-пользователей просили передать все свои требования центральным командам разработчиков хранилищ данных, начались масштабные программы по созданию корпоративных хранилищ данных (EDW). EDW - это центральное хранилище данных, целью которого является создание единой версии истины и обслуживание всех потребностей организации в отчетности и анализе данных.
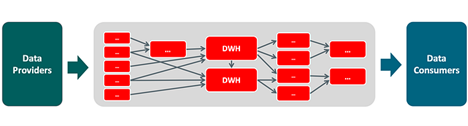
Прежде чем мы продолжим, я хотел бы попросить Вас сделать глубокий вдох и отбросить все свои предубеждения. Потребность в гармонизации данных всегда остается, но нужно учитывать масштаб, в котором мы хотим применять эту дисциплину. Действительно ли наилучшим способом является централизованная обработка всех данных до того, как они могут быть использованы любым пользователем или приложением?
Единые канонические модели и ненужные переводы схем
EDW требуют от поставщиков и потребителей данных согласования единой (корпоративной) канонической модели данных. Эта единая версия истины является самой большой проблемой, из-за которой компании не могут масштабироваться. В больших экосистемах существует множество различных контекстов. Построение интеграционного слоя, удовлетворяющего потребностям абсолютно всех, представляет собой серьезную проблему. Чем больше компания, тем больше конфликтов и, следовательно, тем больше времени требуется на согласование и гармонизацию корпоративных данных.
Вторая самая большая проблема, связанная с согласованием, заключается в том, что теряется ценность данных. При построении хранилищ данных инженерам приходится делать многочисленные интерпретации. Например, что такое дата начала контракта? Существует достаточно большое количество возможных ответов. Датой начала может быть юридическая дата подписания контракта или дата утверждения договора юридическим отделом. Это может быть и дата первого платежа. Вероятность того, что смысл этих определений различается в разных отделах, достаточно высока. В итоге мы либо создаем множество вариаций, либо миримся с различиями и несоответствиями. Чем больше данных мы добавляем, и чем больше конфликтов и несоответствий в определениях, тем сложнее нам будет провести гармонизацию.
Другая проблема заключается в том, что в процессе интеграции происходит «отбрасывание» данных, а значит, и определенного контекста. Для продвинутой аналитики, такой как машинное обучение, отсутствие деталей является большой проблемой.
Дополнительный этап преобразования
Второй проблемой при использовании хранилищ данных в больших масштабах является необходимость дополнительного этапа трансформации. Данные всегда должны быть сначала интегрированы в хранилище данных. Этот шаг означает большое количество времени ожидания, поскольку в хранилище данных практически все компоненты связаны между собой. Таблицы имеют ссылки на другие таблицы, а таблицы в свою очередь имеют зависимости от заданий ETL. Изменение в одной таблице обычно приводит к изменениям в других таблицах и заданиях ETL. Такая взаимосвязь требует больших трудозатрат и увеличивает время ожидания, из-за чего люди начинают заниматься «творчеством».
Что такое большой шар грязи? “Большой шар грязи” - это бессистемно структурированные, разросшиеся джунгли кода. Данный термин был когда-то введен Брайаном Футом и Джозефом Йодером. Большой шар грязи описывает архитектуру системы, которая является монолитной, сложной для понимания, трудной для сопровождения и тесно связанной из-за множества зависимостей.
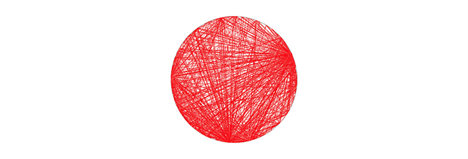
Хранилища данных с их интеграционным слоем, бесчисленными таблицами, связями, скриптами, заданиями ETL и потоками планирования часто оказываются в хаотичной паутине зависимостей. Через некоторое время в итоге получается то, что называют большим шаром грязи.
Один инженер может предложить для экономии времени обойти интеграционный слой, напрямую отобразив данные из исходной системы в витрине данных. Другой может предложить построить витрину данных поверх двух уже существующих витрин данных, поскольку изменение интеграционного слоя требует слишком много времени. Архитектура становится все более сложной, а люди теряют представление обо всех творческих решениях и недочетах, созданных для того, чтобы выполнить работу в срок.
Критическая точка
Хранилища данных характеризуются «экспоненциальной сложностью» с точки зрения количества источников данных и потребителей. Чем больше источников, тем сложнее вносить изменения. Этот же принцип применим и к количеству точек входа потребителей данных. Если на интеграционном слое расположено множество витрин данных данных, то внесение изменений в интеграционный слой может иметь серьезные последствия, поскольку его изменения влияют на витрины данных, которые должны быть тесно скоординированы со всеми потребителями данных.
Также я заметил, что существует так называемый "переломный момент": при достижении определенного количества источников и витрин данных гибкость системы падает практически до нуля. Интеграция огромного количества источников требует значительной координации и унификации. Релизные циклы в несколько месяцев не являются исключением для сложных систем хранения данных.
Бесконечные обсуждения с бизнес-лидерами
Из-за тесной связи и длительных циклов выпуска данных бизнес-лидеры вынуждены постоянно согласовывать приоритеты. Мне приходилось наблюдать длительные дискуссии между дата-инженерами и бизнес-лидерами по поводу приоритетов новых данных, поступающих в хранилища данных, или изменений, которые необходимо внести в интеграционный слой. Эти обсуждения не приносят абсолютно никакой пользы бизнесу.
Требовательные потребители
Проблемы маневренности монолитных платформ данных порождают нетерпение потребителей Добавление данных в EDW и озера данных может занимать много времени, поэтому пользователи начинают требовать, чтобы им были доступны сразу все данные. Наличие доступа ко всем данным устраняет риск ожидания. Я видел витрины данных, которые содержали практически все данные из интеграционного слоя что не делает архитектуру системы храения данных экономически эффективной.
Я также видел, как бизнес-пользователи и ИТ-пользователи одновременно обращаются и к витринам данных, и к интеграционному слою. Пользователи строили представления поверх витрин данных и интеграционных слоев для быстрого удовлетворения своих потребностей. Эти представления открывались и для других пользователей. В итоге возникал эффект бесконечного каскадного наслоения. Пользователи извлекают данные, не имея ни малейшего представления о том, откуда именно они берутся.
Давление на координацию действий
Еще одна проблема эксплуатации хранилищ и озер данных в больших масштабах заключается в том, что дата-инженерам и ИТ-пользователям приходится координировать доставку данных. Мне также приходилось сталкиваться с ситуациями, когда дата-инженеры сами занимались решением различных проблем. Например, исправляли данные в области стейджа для того, чтобы они правильно загружались в хранилище данных. Эти исправления происходили постоянно, и со временем приходилось применять сотни дополнительных скриптов, прежде чем можно было начать обработку данных. Эти сценарии не являются частью эффективного процесса ETL и не могут быть отслежены должным образом.
Качество данных и data governance
Data governance, как правило, также является проблемой, поскольку возникает ряд вопросов: кто является владельцем данных в хранилищах данных? Кто несет ответственность, если в исходных системах произойдет ошибка, и данные будут утрачены? Многие инженеры систем-источников указывают на инженеров хранилищ данных, когда что-то идет не так, поскольку именно они преобразуют данные. И наоборот, инженеры хранилищ данных обвиняют владельцев исходных систем в предоставлении некорректных данных.
Качество данных - отдельная тема для обсуждения. Поскольку после преобразования данных они становятся практически неузнаваемыми для владельцев исходных систем. Владельцы исходных систем обвиняют дата- инженеров в плохом качестве данных. Во многих реализациях я видел, что инженеры хранилищ данных заботятся о качестве данных. Данные исправляются до или после их загрузки в хранилище данных. Для обеспечения целостности особенно важно правильно настроить отношения между таблицами. Но какие данные являются истинными? Пользователи начинают сравнивать цифры из операционных систем с цифрами из хранилища данных. Никто не знает, что именно является истиной. Качество данных между операционными системами и хранилищами данных может настолько сильно отличаться между собой, что никто не будет доверять данным.
Исторические данные
Управление жизненным циклом исторических данных также является проблемой. Поскольку EDW рассматриваются как архив истины, операционные системы очищают неактуальные данные, зная, что они будут сохранены в хранилище. А если операционным системам потребуется составить аналитический отчет на основе собственных исторических данных, что тогда произойдет? Во многих случаях эту задачу решают СОД, но я также видел компании, использующие для этих целей EDW. При этом возникает интересная закономерность. Во-первых, оперативные данные переносятся и преобразуются в гармонизированную модель. Во-вторых, эти же данные переносятся и преобразуются обратно в исходный контекст (обратный инжиниринг).
Для оперативной расширенной аналитики часто требуются исторические данные. Предполагается, что они должны быть быстродоступными, поскольку "окна возможностей" скоротечны. Использование для этих целей хранилищ данных является проблемой, поскольку они должны обрабатывать данные, как правило, в течение многих часов.
Данные покидают централизованную платформу
Централизованное хранение и управление данными является проблемой, поскольку организационные потребности весьма разнообразны: различные типы решений, команды разного размера, различные требованияи так далее. Удержать все вместе - большая проблема.
EDW и озера данных тесно связаны с выбранным базовым решением или технологией, что означает, что потребители, требующие различных схем чтения, всегда вынуждены экспортировать данные в другие среды. По мере того как меняется ландшафт поставщиков, и появляются новые типы баз данных, эти монолитные платформы становятся все более разрозненными и вынуждены экспортировать данные. Эта тенденция подрывает концепцию эффективного использования "единого центрального хранилища". В результате создаются точечные решения, а аппаратные средства, лежащие в основе хранилища данных, используются только для ETL-обработки. Это представляет собой просто жуткую трату денег, поскольку в системах хранилищ данных используется, как правило, дорогостоящее оборудование, оптимизированное для интенсивного выполнения запросов.
После переноса и обогащения данных они, как правило, распределяются дальше. Это означает, что потребители данных начинают выступать в роли поставщиков данных. Для потребителей данных в крупномасштабных средах такая ситуация может быть весьма запутанной, ведь откуда взялись данные? Некоторые потребители начинают потреблять данные, не осознавая, что они также потребляются опосредованно. Это делает цепочку более длинной и, следовательно, более хрупкой.
Подобное распространение и разрастание данных создает еще одну проблему. Многие потребители данных не знают, где найти нужные данные, поскольку они распределены по всей организации. Пользователи используют самый быстрый путь к данным - тот, который имеет наименьшее расстояние и наименьшее сопротивление. EDW и озера данных превращаются в архитектуру "спагетти". Другие называют это большим шаром грязи. Несогласованные изменения, нерегулируемый рост и распределение данных вредят общей архитектуре данных предприятия. Теряется согласованность и, самое главное, гибкость.
Поставщики данных
В EDW и озерах данных часто отсутствует понимание специального потребления и дальнейшего распределения, особенно когда данные выносятся за пределы экосистемы. В условиях нового регулирования, такого как GDPR или CCPA, понимание потребления и распределения данных очень важно. По логике вещей, там, где начинается создание данных, должна начинаться и ответственность. Проблема с корпоративными хранилищами данных заключается в том, что поставщики данных не контролируют данные и имеют ограниченный кругозор. Нет возможности контролировать потребление данных, нет понимания их дальнейшего распространения или целей их использования.
Сервисная ориентация реализуется отдельно
Во многих организациях создание API осуществляется через каноническую модель предприятия отдельной командой. Это странно, поскольку и сервисная ориентация, и EDW используют и опираются на одни и те же операционные системы. Раздельная реализация создает две разные версии истины. Это может привести к появлению двух лагерей в организации и двух разных словарей с разными значениями данных. Однако исходные источники и их контекст остаются неизменными.
Навязчивые евангелисты и классические мыслители
Возможно, это покажется преувеличением, но у корпоративных хранилищ данных тоже есть "евангелисты". Большинство инициатив по созданию хранилищ данных стартовали с благими намерениями, но позже интеграция данных проводилась уже не ради их эффективного использования, а только ради собственной выгоды. Интеграция данных превратилась в хобби. Побочным эффектом стало то, что различные хранилища данных стали излишне сложными и трудными в обслуживании.
Другая проблема заключается в том, как формируются команды по созданию корпоративных хранилищ данных и озер данных из традиционных инженеров-программистов. Многие из них являются администраторами баз данных и привыкли проектировать монолиты. Они застряли в прошлом и не обладают такими современными навыками, как DataOps, проектирование с ориентацией на домен, распределенное и эволюционное мышление, версионирование данных, опыт CI/CD и автоматизированного тестирования и т.д. Соответственно, масштабирование и соответствие современным требованиям является сложной задачей.
Эталонные образцы
Многие EDW часто строятся на основе "готовых" моделей данных, ориентированных на конкретную отрасль. Например, IBM, Teradata, Oracle и Microsoft предоставляют такие модели данных для различных отраслей. Проблемазаключается в том, что они представляют собой версию правды поставщика, а не Вашу. Многие из этих моделей полны предположений и требуют заполнения множества пустых таблиц, содержащих только ключи. В результате интеграционный слой становится слишком большим и сложным.
Логические хранилища данных
Существует также подход, при котором EDW и "озера данных" сочетаются с виртуализацией данных. Они "дополняются" еще одним виртуальным слоем абстракции. При этом создаются новые интегрированные представления данных. Они могут распространяться как на операционные системы, так и на многие другие приложения. Генри Кук, директор по исследованиям компании Gartner, называет эту схему проектирования логическим хранилищем данных. Хотя отсутствие необходимости добавлять новые данные в корпоративное хранилище данных дает краткосрочные преимущества с точки зрения маневренности, в долгосрочной перспективе это неизбежно приведет к катастрофическим последствиям.
Во-первых, достаточно заманчиво заменить сложную интеграционную логику абстрагированием, но нельзя забывать о том, что базовая сложность при этом сохранится, включая все операционные и технологические накладные расходы. Во-вторых, это расширяет платформу данных за счет прямых обходов операционных систем и специальных источников данных при непосредственном повторном использовании частей платформы данных. Многие из этих операционных систем, как Вы уже поняли, не оптимизированы для интенсивного доступа на чтение и не могут хранить большие объемы исторических данных. В-третьих, существует тесная связь с обеими операционными системами, платформой данных и продуктом виртуализации. Изменения в базовых физических структурах платформ данных или операционных систем, которые не были тщательно скоординированы, немедленно приведут к разрушению логического слоя. И наконец, вся интеграция данных по-прежнему происходит "по воронке", поскольку виртуализация данных - это всего лишь еще один ETL-инструмент для поддержания модели данных предприятия.
Хотя технологии изменились, сама концепция сочетания виртуализации данных с озерами данных, корпоративными хранилищами данных и "воронкой" ETL является корнем проблемы. Данные переносятся в монолит, требующий точного согласования всех изменений и не позволяющий оптимизировать сценарии использования и выбрать технологию, наиболее полно отвечающую требованиям сценариев использования.
Внедрение сценариев использования на основе озера данных
Многие компании возлагают все свои надежды на экосистемы больших данных, объединяющие неструктурированные данные из различных систем-источников, к которым, возможно, добавляются и EDW. Предполагается, что аналитические сценарии будут выполняться в озере, а консолидированные представления - в EDW. Такой подход сопряжен с рядом проблем:
- Данные, которые попадают в озеро данных, часто являются необработанными и, скорее всего, представляют собой сложное представление всех различных приложений. Они могут включать в себя десятки тысяч таблиц, непонятные значения и логику приложений. Кроме того, существует тесная связь с исходными системами, поскольку унаследованная структура является их идентичной копией. Изменения чреваты немедленной поломкой среды озера данных;
- Аналитические модели в озере данных часто строятся как на сырых (неструктурированных), так и на согласованных данных. Не исключено, что ученые, занимающиеся исследованием данных, технически подготавливают, создают данные и эксплуатируют эти конвейеры данных и модели вручную или в рамках своего проекта по науке о данных. Поэтому озера данных несут в себе существенные риски;
- Результаты аналитической деятельности во многих случаях необходимо возвращать в EDW для формирования отчетности. Это требует работы с двумя разными моделями данных: сырыми данными и унифицированной, гармонизированной версией EDW. Поскольку эти структуры совершенно разные, для устранения всех несоответствий требуется дополнительный конвейер;
- Озера данных часто представляют собой единую платформу, которая используется многими различными сценариями применения. Из-за тесной связи с аппаратным обеспечением, проблем совместимости, общих библиотек и конфигураций такие платформы очень сложно поддерживать.
Перечисленные мною проблемы - это лишь несколько причин, по которым процент неудач проектов, связанных с большими данными, настоль высок. Сопротивление руководства, внутренняя политика, нехватка опыта, проблемы безопасности и управления - вот еще несколько причин неудач в сфере аналитики данных.
Изоляция знаний и централизованное проектирование
Одна из самых больших проблем при создании централизованных платформ данных, таких как EDW или "озера данных", заключается в том, как организованы команды: люди, обладающие навыками работы с данными, отделены от людей, обладающих знаниями в области бизнеса.
Все знания изолированы, что не позволяет командам эффективно использовать данные. Жизненные циклы и ритмы работы с данными приходится корректировать в соответствии с централизованным диктатом. Одна команда владеет всей инфраструктурой, которая доступна только ей. Именно такое положение дел мешает организациям расширяться и развиваться.
Заключение
Хранилища данных останутся, поскольку потребности в согласовании данных из различных источников в определенном контексте будут существовать всегда. Не исчезнут и шаблоны постановки данных на хранение. Так же как и этапы очистки, исправления и преобразования схем. Любой стиль, будь то Инман или Кимбалл, может быть применен макимально оптимальным способом, в зависимости от каждого конкретного случая. Однако, такие технологические тенденции, как ELT на основе метаданных, виртуализация данных, облако, распределенная обработка и машинное обучение неизбежно изменят ситуацию.
Необходимо учитывать и то, КАК именно мы хотим управлять нашими данными. Большие силосы, такие как корпоративные хранилища данных, исчезнут, поскольку они не смогут масштабироваться. Тесно связанные интеграционные слои, потеря контекста и интенсивное потребление данных заставят компании искать альтернативы. Архитектуры озер данных, в которых данные поступают в сыром виде, являются другой крайностью. Сырые данные сами по себе несут в себе много повторяющейся работы.
Также проблемой является силовое и монолитное мышление, которое не позволяет компаниям масштабироваться. Изоляция специалистов по работе с данными и отделение от людей, обладающих знаниями в области и бизнесе, приводит к проблемам с координацией в сфере данных.


