

Прошлое, настоящее и будущее Архитектуры данных
В данной статье речь пойдет об эволюции архитектуры данных. Что стоит за архитектурными изменениями, и как эти изменения отразятся на инициативах в области данных. Кроме того, я скажу несколько слов о data mesh.
Почему нам нужна архитектура данных?
Трансформация в организацию, управляемую данными, является одной из главных стратегических целей многих компаний. Ориентация на данные означает, что данные занимают центральное место во всех решениях, которые принимаются в организации.
Лидеры понимают, что управление данными - это единственный способ повысить качество обслуживания клиентов, снизить операционные затраты за счет автоматизации и машинного обучения, а также разобраться в тенденциях развития бизнеса, что важно для выработки стратегии и эффективного позиционирования на рынке. Платформа данных создает благоприятную среду для процветания данных.
Платформа данных - это хранилище и центр обработки всех данных организации. Она обеспечивает сбор, очистку, преобразование и применение данных для получения информации о бизнес-показателях. Иногда ее также называют “ современным стеком данных “, поскольку платформа данных зачастую состоит из нескольких интегрированных инструментов, поддерживаемых различными производителями (Dbt, Snowflake, Kafka и др.).
Одним из основных элементов платформы данных является архитектура данных. Архитектура данных - это процесс проектирования, создания и управления структурой информационных активов организации. Это своего рода каркас для интеграции данных из различных источников и приложений.
Основная цель эффективной архитектуры данных –заключается в том, чтобы сократить количество изолированных данных, минимизировать дублирование данных и повысить общую эффективность процесса управления данными.
По мере развития ландшафта данных в течение последних десятилетий архитектура данных также претерпевала различные изменения. Рассмотрим их более подробно.
Аналитические данные претерпели эволюционные изменения, обусловленные новыми моделями потребления: от традиционной аналитики для поддержки бизнес-решений до интеллектуальных продуктов, дополненных машинным обучением.
Первое поколение: Архитектура хранилища данных
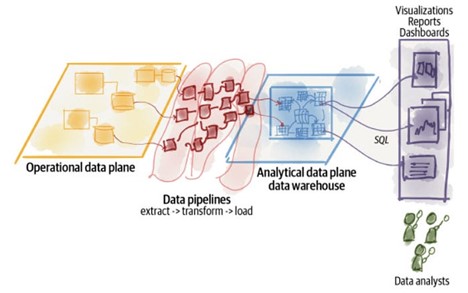
Архитектура хранилища данных определяется движением данных из операционных систем (SAP, Salesforce) и баз данных сторонних производителей (MySQL, SQL Server) в системы бизнес-анализа. Хранилище данных - это центральная точка, в которой определяется схема (схема "снежинка" или схема "звезда"), а также то, где именно будут храниться данные, что позволяет предприятиям отслеживать любые изменения в своей деятельности и взаимодействии с клиентами. Данные:
- Извлекаются из нескольких баз данных и источников;
- Преобразовываются в универсальную схему, представленную в многомерном и изменяющемся во времени табличном формате;
- Загружаются в таблицы хранилища с помощью процесса CDC (change data capture);
- Доступ к ним осуществляется с помощью SQL-подобных запросов;
- В основном используются аналитиками данных для создания отчетов и аналитической визуализации.
В этом архитектурном стиле в дело вступают и витрины данных. Они представляют собой дополнительный слой (состоящий из одной или нескольких таблиц) поверх хранилища данных, предназначенный для решения бизнес-задач конкретных подразделений. Без витрин данных этим отделам пришлось бы исследовать и создавать множество запросов в хранилище, чтобы получить данные нужного им содержания и формата.
Основные проблемы данного подхода:
- Со временем создаются тысячи ETL-заданий, таблиц и отчетов, понять и поддерживать которые сможет только специализированная группа;
- Современные практики, такие как CI/CD, в данном случае не применимы;
- Модель данных и схемы хранилищ данных слишком жесткие, чтобы справиться с огромным объемом структурированных и неструктурированных данных из различных источников.
Именно эти трудности обусловили появление второго поколения Архитектуры данных.
Второе поколение: Архитектура Data Lake
Архитектура data lakeбыла представлена в 2010 году как ответ на проблемы архитектуры хранилищ данных в удовлетворении новых потребностей в использовании данных, а именно доступа к данным в процессе обучения моделей машинного обучения.
Для обучения моделей машинного обучения специалистам по исследованию данных необходимы данные в их исходном виде. Кроме того, им необходимы огромные объемы данных, которые сложно хранить в хранилище данных.
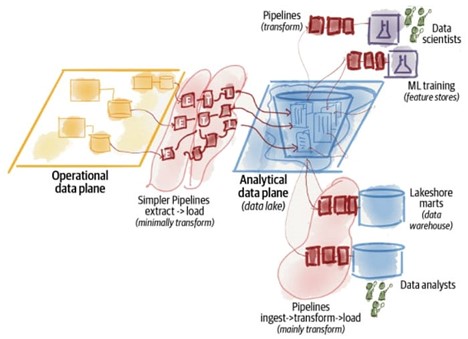
Первые "озера данных" предполагали хранение данных в распределенной файловой системе Hadoop (HDFS). Данные извлекались и обрабатывались с помощью MapReduce, Spark и других фреймворков обработки данных.
Архитектура data lake работает в рамках процесса ELT, а не ETL. Данные извлекаются (E) из операционных систем и загружаются (L) в центральное хранилище. Однако, в отличие от хранилищ данных, data lake предполагает незначительную трансформацию и моделирование данных или полное отсутствие таковых. Задача состоит в том, чтобы сохранить данные в их первоначальном виде. После того как данные попадают в озеро, архитектура расширяется за счет конвейеров преобразования данных (T) для моделирования исходных данных и их хранения в хранилище данных или функциональных хранилищах.
Команды дата-инженеров создают различные "зоны" для более оптимальной организации data lake. Цель состоит в том, чтобы хранить данные в зависимости от степени их очистки и трансформации - от самых "сырых" данных, которые необходимо подвергнуть этапу обогащения, до наиболее чистых и доступных.
Такая архитектура данных призвана устранить трудности, связанные с необходимостью проведения обширного предварительного моделирования, которое необходимо при создании хранилища данных. Предварительная трансформация данных весьма неудобна и приводит к замедлению процесса доступа к данным и обучения моделей.
Основные трудности данного подхода:
- Архитектура data lake слишком сложна, что приводит к низкому качеству и надежности данных;
- Сложные конвейеры пакетных или потоковых операций, управляемые центральной командой высокоспециализированных дата- инженеров;
- Создаются неуправляемые наборы данных, которые зачастую являются и недоступными, не представляя собой какой-либо ценности;
- Сложно отследить историю данных и их зависимости;
- Отсутствие масштабного предварительного моделирования данных затрудняет построение семантического отображения между различными источниками данных, что приводит к возникновению информационного болота.
Третье поколение: Архитектура облачного data lake
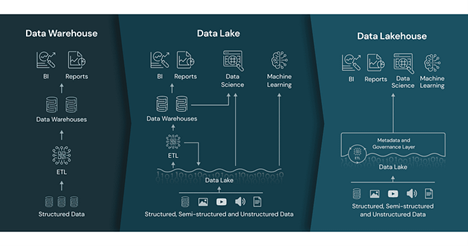
Самыми значительными изменениями в архитектуре данных второго поколения по сравнению с архитектурой третьего поколения стали переход к облачным технологиям, доступность данных в режиме реального времени и конвергенция между хранилищем данных и озером данных. Если более подробно, то:
- Поддержка потоковой обработки для обеспечения доступности данных практически в режиме реального времени с помощью таких архитектур, как Kappa;
- Попытка унифицировать пакетную и потоковую обработку для преобразования данных с помощью таких фреймворков, как Apache Beam;
- Внедрение полностью облачных сервисов и использование современных облачных реализаций с изолированными вычислениями и хранением. Хранение данных при этом становится значительно дешевле;
- Объединение хранилища и озера данных в единую технологию: либо расширение хранилища данных за счет встроенного ML-обучения, либо создание систем целостности, транзакционности и запросов в хранилище данных в рамках решений для озер данных. Databricks Lakehouse - пример традиционного решения для хранения данных в озере с поддержкой транзакций и запросов, подобных data warehouse.
Облачное озеро данных позволяет устранить некоторые недостатки предыдущих поколений. Тем не менее, некоторые проблемы все же остаются:
- Архитектура озер данных остается слишком сложной в управлении, что сказывается на качестве и надежности данных;
- Проектирование архитектуры остается централизованным, что подразумевает наличие команды высокоспециализированных дата-инженеров;
- Длительное ожидание результатов. Потребители данных вынуждены ждать несколько месяцев, чтобы получить набор данных, необходимый для аналитики или машинного обучения;
- Хранилища данных больше не являются репликацией реального мира через данные, что негативно сказывается на опыте потребителей данных при их изучении.
Все эти проблемы привели к созданию архитектуры данных четвертого поколения, которая на момент публикации этой статьи все еще находится в стадии зарождения.
Четвертое поколение: архитектура data mesh
Архитектура data mesh - это относительно новый подход к построению архитектуры данных, направленный на решение проблем, описанных выше.
Data mesh привносит в архитектуру данных то, что в свое время микросервисы привнесли в монолитные приложения.
В data mesh данные децентрализованы, а право собственности на них распределено между несколькими доменами. Каждый домен отвечает за данные в пределах своей области, включая моделирование, хранение и управление данными; архитектура должна обеспечивать набор практик, позволяющих каждому домену самостоятельно управлять своими данными.
Приведем список ключевых компонентов архитектуры data mesh:
- Домены —самостоятельные бизнес-единицы, которые владеют и управляют своими собственными данными. Каждый домен имеет четкую бизнес-цель и отвечает за определение модели данных, схем и политик управления данными. Эта концепция отличается от витрин данных, предназначенных для различных отделов, таких как маркетинг или продажи. В архитектуре data mesh отдел продаж может иметь сразу несколько доменов;
- Продукты данных — конечный результат того, что производится каким-либо доменом и становится доступным для потребления другими доменами или приложениями. Каждый продукт данных имеет четкую бизнес-цель. Один домен может работать сразу с несколькими продуктами данных. Продукты данных - это активы данных, которые играют ключевую роль в организации;
- Инфраструктура данных включает в себя инструменты и технологии, необходимые для управления данными в домене, подобно контейнерным микросервисам для программного приложения. Сюда входят средства хранения, обработки и анализа данных;
- Data Governance - набор процедур, регулирующих качество, конфиденциальность и безопасность данных. Осуществляется каждым доменом;
- Mesh API: подобно тому, как микросервис раскрывает все свои возможности через HTTP REST API, домен data mesh будет раскрывать все свои возможности через интерфейс, который может быть использован другими доменами и продуктами данных.
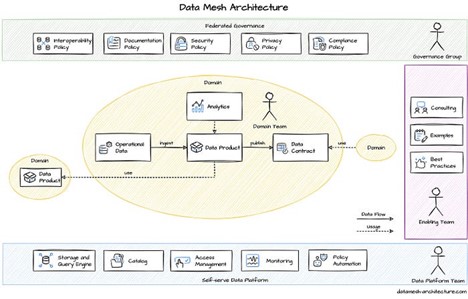
Data mesh можно рассматривать как смену парадигмы в том, как проектируется архитектура данных и как организованы команды по работе с данными в настоящее время:
- Команды по работе с данными становятся кросс-функциональными командами, специализирующимися на одном или нескольких бизнес-доменах (а не на технологиях), подобно тому как команды по работе с программными продуктами ориентированы на предоставление услуг;
- Каждый бизнес-домен, состоящий из одного или нескольких микросервисов, будет иметь свою собственную OLAP-базу данных и распределенную файловую систему хранения, точно так же, как любая часть микросервиса контейнеризируется для самостоятельной работы;
- Продукт данных A будет потребляться продуктом данных B, оба они будут взаимодействовать с другими продуктами данных через потоковые или REST API, точно так же, как микросервисы приложений взаимодействуют друг с другом;
- API-интерфейсы продуктов данных будут сопровождаться традиционной документацией по REST API, а продукты данных могут быть обнаружены через каталог data mesh.
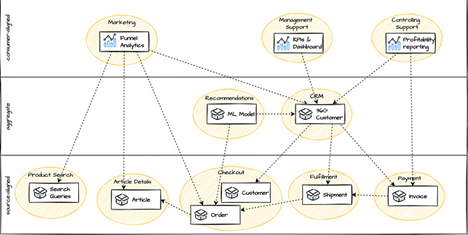
Что еще меняется с data mesh, кроме архитектуры данных?
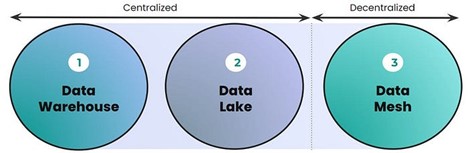
Наиболее значимым изменением в системе data mesh является архитектура. Но переход от централизованного озера данных к децентрализованной сетке данных - это социотехнический феномен, который предполагает ряд дополнительных изменений.
Если Вы помните, переход от монолитных приложений к микросервисным заставил команды разработчиков ПО изменить жизненный цикл разработки, организационную структуру, мотивацию, навыки и управление. Именно тогда появилась роль менеджера продукта, который должен гарантировать то, что приложения будут решать проблемы пользователей. То же самое должно происходить и при применении архитектуры data mesh.


