

Контекст применения каталога данных в корпоративной data-платформе
Каталог данных стал одним из ключевых элементов современной корпоративной data-платформы. Он выступает не просто реестром объектов, но центральной сущностью, обеспечивающей поиск, описание, управление и использование данных в масштабе организации. В условиях растущей сложности источников, регуляторных требований и потребности бизнеса в быстром принятии решений каталог данных становится связующим звеном между техническими командами, данными и бизнес-пользователями. В этой главе рассмотрим контекст применения каталога данных, его цели в рамках корпоративной data-платформы, архитектурные принципы и практику эксплуатации.
Цель каталога данных в корпоративной среде — превратить огромное множество разбросанных источников и их описаний в единый, управляемый и доверительный актив. Каталог обеспечивает единый язык терминологии, стандартизированные описания сущностей (датасеты, таблицы, представления, потоки данных, методы трансформации), поддержку поиска по бизнес-контексту и техническим параметрам, возможность отслеживать lineage, качество данных и соответствие политикам безопасности. В рамках цифровой трансформации каталог становится опорой для прозрачности процессов, ускорения аналитических циклов и повышения уровня соответствия требованиям регуляторов.
В контексте корпоративной data-платформы каталог играет несколько взаимодополняющих ролей. Во-первых, он служит каталогом активов данных для исследователей данных, аналитиков и дата-сайентистов, позволяя быстро находить релевантные источники и получать контекст через теги, аннотации, владельцев и политику доступа. Во-вторых, он поддерживает управление данными и их качество: фиксирует владельцев данных, ответственных за данные, определяет правила обработки и стандарты качества. В-третьих, он интегрируется с процессами соблюдения требований и аудитом: регистрирует lineage, версии объектов, изменения в метаданных и события доступа. В-четвёртых, он является активной частью операционной инфраструктуры: интегрируется с конвейерами данных, системами мониторинга и BI-инструментами, обеспечивая бесшовное взаимодействие и уменьшение затрат на объяснение данных бизнес-пользователям.
Стратегическая роль каталога данных в цифровой трансформации organisation проявляется через три ключевых аспекта: управляемость, прозрачность и скорость принятия решений. Управляемость достигается за счет четких ролей, политик доступа и процессов метаданных, которые задаются и контролируются через код и политики. Прозрачность достигается посредством детального описания источников, потоков и контекстов данных, что снижает риск неправильного использования информации. Скорость принятия решений обеспечивается быстрым обнаружением данных, автоматизированной проверкой соответствия требованиям и совместной работой между бизнесом и IT.
Однако практическая реализация требует ясной картины архитектуры, согласованных моделей метаданных и хорошо выстроенных процессов внедрения. В следующих разделах освещаются архитектурные принципы, подходы к моделированию метаданных, интеграционные паттерны, а также эксплуатационные сценарии, которые позволяют каталогу стать интегральной частью платформы данных.
Ключевые принципы, которых следует придерживаться при проектировании и внедрении каталога данных в корпоративной среде:
- Централизация описаний и гибкость в отношении источников: каталог должен принимать данные из разнообразных систем и форматов, сохраняя единый язык описания.
- Контроль качества и ответственности: каждый объект должен иметь владельца, согласованные метрики качества и политики обновления.
- Безопасность и соответствие: политика доступа и аудита должны быть встроены в архитектуру каталога с возможностью автоматизации действий.
- Масштабируемость и производительность: механизмы индексации, кеширования и оптимизации запросов должны поддерживать быстрый поиск в больших объемах метаданных.
- Эволюционность и сопереформируемость: каталог должен поддерживать версионирование метаданных, откат изменений и эволюцию схем без сбоев в эксплуатации.
Следующая часть главы углубляется в архитектурные слои каталога, типовые решения и практики развертывания, которые позволяют добиться устойчивого поведения в условиях динамичных бизнес-требований.
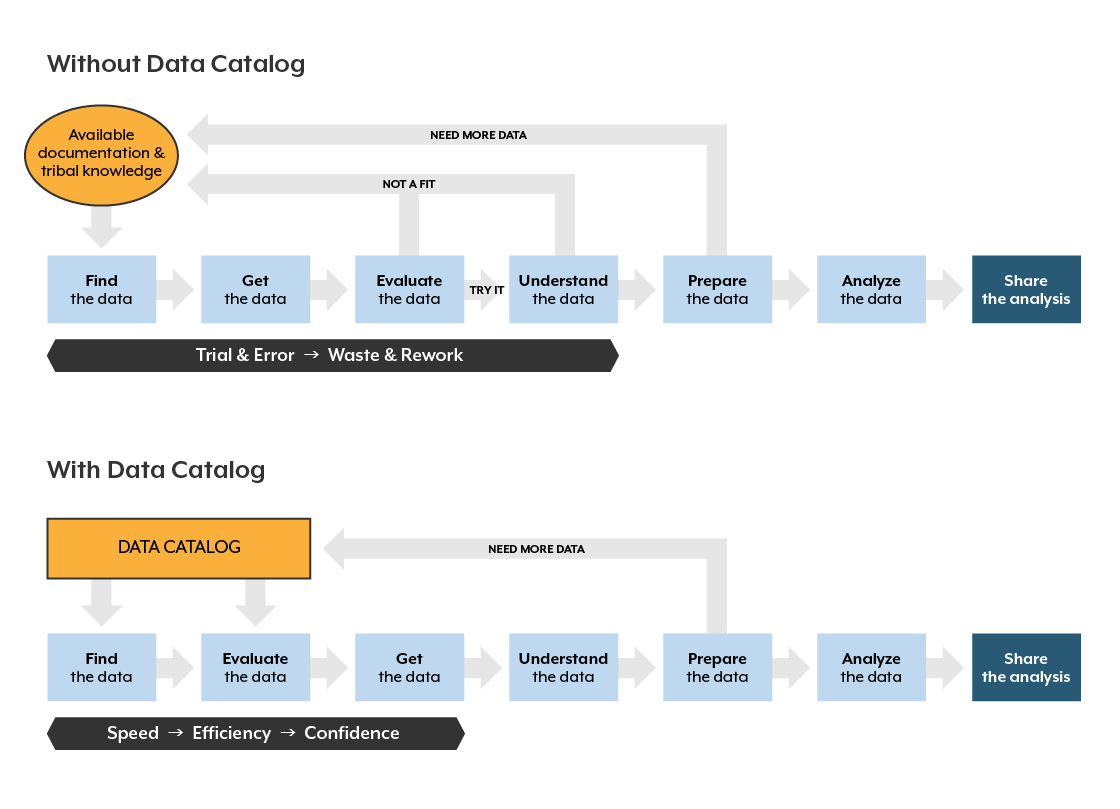
Архитектура каталога данных
Современная архитектура каталога данных обычно строится на нескольких взаимосвязанных слоях. Каждый слой выполняет специфическую функцию и обеспечивает независимое развитие отдельных подсистем без потери целостности всей платформы. В базовой конфигурации можно выделить следующие слои:
- Слой источников метаданных: включает подключаемые коннекторы к различным системам хранения и обработки данных — реляционные СУБД, data lake, хранилища облачных провайдеров, конвейеры потоков данных и бизнес-инструменты. В качестве примера технических реализаций можно привести открытые фреймворки и продукты: Apache Atlas и Amundsen как платформы для сбора и организации метаданных. Они выступают в роли движка каталога и репозитория метаданных.
- Слой хранения метаданных: центральное хранилище, где сохраняются описания объектов, версии метаданных, lineage, политики доступа и связанные атрибуты. В зависимости от требований к масштабируемости и доступности он может применяться как графовая база данных, так и document-oriented или relational-ориентированное решение с индексами полнотекстового поиска.
- Слой индексации и поиска: обеспечивает эффективный поиск по названию, тегам, бизнес-контексту, владельцам и другим атрибутам. Современные каталоги используют полнотекстовый поиск, графовые структуры для быстрого расчета lineage и слои кеширования.
- Слой политики и соответствия: механизм реализации политик доступа, контроля качества, согласования изменений и аудита. Он тесно связан с возможность автоматического применения политик к данным на основе их контекста и классификации.
- Слой интеграций и API: набор REST/gRPC API, событийные интерфейсы и SDK для потребителей (BI-инструменты, конвейеры данных, ноутбуки, сервисы данных). Возможны API для импорта экспорта метаданных, синхронизации и мониторинга.
- Слой UI и пользовательских рабочих процессов: веб-интерфейс, инструменты самообслуживания, панели мониторинга по качеству и lineage. UI должен быть интуитивно понятным и адаптированным под роли: дата-архитектор, дата-сайентист, бизнес-аналитик, data steward.
- Слой эксплуатации и мониторинга: сбор телеметрии, метрик производительности, журналов аудита, уведомления о нарушениях и инцидентах. Непрерывная интеграция и развёртывание (CI/CD) для изменений в конфигурациях каталога.
Технологический выбор в каждом слое зависит от контекста компании: объёма данных, скорости изменений, регуляторных требований и зрелости процессов. В рамках открытого кросс-рынкового контекста можно отметить две популярные концепции: амандзен-ориентированные подходы к поиску с графовой структурой lineage и Atlas-основанные механизмы политики и управления. Применение таких подходов вкупе обеспечивает не только поиск и описание, но и автоматическое отслеживание изменений, чего в рамках взрослой корпоративной среды требует регуляторная прозрачность и возможность аудита.
| Компонент | Назначение | Примеры технологий |
|---|---|---|
| Источник метаданных | сбор описаний объектов из источников | Apache Atlas, Amundsen |
| Хранилище метаданных | единое хранилище описаний, версионирование | Graph/SQL базы данных, индексируемые хранилища |
| Поиск и индексация | быстрый доступ к данным по различным признакам | Elasticsearch, Lucene, встроенные движки поиска |
| Политика и аудит | управление доступом, качество, соответствие | Policy-as-code, SIEM-интеграции |
| API и интеграции | взаимодействие потребителей и источников | REST/gRPC API, SDK, Event bus |
| UI и рабочие процессы | самообслуживание, совместная работа | Web UI, рабочих пространства, витрины |
Архитектура каталогов данных должна поддерживать модульность и возможность замены отдельных компонентов без нарушения всей системы. Это важно на практике, поскольку технологический ландшафт быстро меняется: новые источники данных появляются, требования к безопасности усложняются, аудит и документирование становятся более строгими. Важными аспектами являются:
- Интерфейс между каталогом и источниками метаданных: как синхронизируются описания, как обрабатываются конфликты версий и дубликаты.
- Модель метаданных: как описывать объекты, какие атрибуты считать стандартными, как расширяемость схемы поддерживает бизнес-термины.
- Управление линейностью (lineage): как фиксируются потоки данных и трансформации, как обновляются зависимости при изменениях источников.
- Политики безопасности: как они разворачиваются и применяются, как обеспечивается соответствие требованиям регуляторов.
- Управление качеством: какие метрики качества данных доступны, как автоматизируются проверки и уведомления.
В целях примера можно привести сценарий интеграции с данными корпуса: потоковая обработка производит данные в ленивом конвейере, после чего метаданные автоматически обновляются в каталоге, включая lineage от источника к целевым хранилищам, а политики доступа применяются в реальном времени при попытке запроса пользователем конкретного набора данных. Такой сценарий демонстрирует ценность каталога как активного элемента data governance, а не пассивного реестра.
Модели метаданных и их роль в эксплуатации
Модель метаданных в каталоге данных — это не просто набор полей; это концептуальная рамка для описания смыслов, контекста и качества данных. В рамках технической парадигмы выделяют несколько уровней моделей, которые должны работать вместе для обеспечения полноты описания и эффективности эксплуатации.
- Концептуальная модель: определяет бизнес-термины и их взаимосвязи. Она описывает сущности бизнес-данных (например, заказ, клиент, транзакция) и их атрибуты на уровне бизнес-слоя. Важная задача — установить единый словарь терминов и обеспечить его согласованность между бизнес-аналитиками и технической командой.
- Логическая (логико-онтологическая) модель: переводит бизнес-термины в технические объекты, такие как датасеты, представления, слои в схеме обработки. Здесь формализуются связи между объектами, включая зависимости и lineage, без привязки к конкретным физическим реализациям.
- Физическая модель: описывает конкретные физические объекты хранения и пути их трансформации. Это включает схемы баз данных, названия таблиц и полей, форматы файлов и шаги обработки. В этот уровень входит реализация в конкретной СУБД, файловой системе или облачном хранилище.
- Модель качества метаданных: определяет метрики и пороги качества для каждого объекта: полнота описания, актуальность, согласованность, точность и непротиворечивость. Метрики качества должны быть связаны с политиками данных и требованиями регуляторов.
- Модель lineage и зависимости: фиксирует цепочку происхождения данных, источники, трансформации и потребителей. Это критично для аудиторов, анализа влияния изменений и обеспечения прозрачности.
Стратегическая задача — обеспечить связность между этими моделями так, чтобы бизнес-потребители видели понятный смысл через бизнес-термины, а специалисты могли работать с точной технической реализацией. Эффективность эксплуатации зависит не только от полноты метаданных, но и от того, как легко поддерживать актуальность и согласование между моделями. Для этого применяются следующие подходы:
- Контракты данных: каждой сущности присваивается контракт описания, который задаёт минимально необходимый набор атрибутов, обновления и правила совместимости при изменениях.
- Версионирование метаданных: изменения в любой модели сопровождаются версией и историей изменений. Это позволяет откатываться к предыдущим состояниям и анализировать эволюцию.
- Аннотации и теги: для ускорения поиска и группировки объектов применяются бизнес-ориентированные теги и аннотации, которые поддерживают гиперсвязь между концептуальным и физическим уровнями.
- Метаданные о качестве и lineage: для каждого объекта должны быть доступны показатели качества и линейная зависимость от источников, чтобы пользователи видели не только что данные есть, но и насколько они надёжны и прослеживаемы.
- Управление владельцами: назначение ответственных за данные и их роли в процессе обработки, обновления и аудита.
Пример демонстрации модели можно представить как последовательность уровней: бизнес-термин "Заказ" связывается с датасетом заказов, который имеет атрибуты и схему. Сложность возрастает, когда заказ проходит обработку и складывается в аналитический слой; затем lineage фиксирует переход от исходной таблицы к агрегированным представлениям и BI-отчетам. В таких связках важна прозрачность и непрерывная синхронизация между всеми уровнями модели.
{
  "entity_type": "dataset",
  "name": "sales.transactions",
  "description": "Транзакции продаж за период",
  "owner": "data-ops@corp.local",
  "business_terms": ["Заказ", "Покупатель", "Товары"],
  "schema": {
    "fields": [
      {"name": "order_id", "type": "string"},
      {"name": "customer_id", "type": "string"},
      {"name": "amount", "type": "decimal"},
      {"name": "order_date", "type": "date"}
    ]
  },
  "lineage": ["raw.sales.orders", "warehouse.fact_sales"],
  "quality": {
    "row_count": 12000000,
    "null_ratio": 0.002
  }
}
Такой формат обеспечивает как понятность контекста для бизнес-пользователя, так и возможность автоматизации процессов проверки качества и соответствия требованиям. В реальных условиях набор требований может быть расширен за счёт описания политики безопасности, чувствительных данных (PII/PCI), происхождения данных и связок с регуляторными актами. Важно обеспечить четкую договорённость между командами по модели и поддерживать её через механизмы CI/CD для метаданных: автоматизированные тесты на полноту описания, согласованность между концептуальной и физической моделями, а также регламент обновления и утверждения изменений.
Интеграции и протоколы взаимодействия
Каталог данных выступает как центральная интеграционная точка между источниками данных, процессами обработки и потребителями метаданных. Эффективная интеграция требует согласованных паттернов взаимодействия, устойчивых к постоянным изменениям в источниках данных и бизнес-требованиях. Ниже приводятся ключевые аспекты интеграций и типовые паттерны взаимодействия.
- Коннекторы к источникам: каталог поддерживает коннекторы к различным типам источников данных — реляционные СУБД, облачные хранилища, потоковые системы и конвейеры обработки. В реальной практике существует необходимость гибко настраивать коннекторы под конкретные версии источников, обеспечивать устойчивость к сбоям и минимизировать задержки синхронизации.
- Стандартные API и интерфейсы: REST и/или gRPC API для чтения и записи метаданных, обмена событиями и интеграции с инструментами анализа. В целях совместимости рекомендуется опираться на OpenAPI спецификации и поддерживать горизонтальное масштабирование API-шлюза.
- Протоколы обмена данными и безопасность: при передаче метаданных применяются протоколы TLS, а для авторизации — OAuth2 или модули аутентификации на основе доверия между сервисами. В рамках политик доступа следует поддерживать атрибутно-ориентированное управление доступом (ABAC) или роль-ориентированное управление доступом (RBAC) с учётом потребностей бизнеса.
- Инструменты обмена событиями: каталоги эффективнее работают в связке с системами обмена сообщениями (Kafka/REST webhook) для уведомления об изменениях метаданных, новых версиях объектов и инцидентах качества.
- Интеграции с процессами обработки данных: связь с оркестраторами конвейеров, системами качества данных и BI-инструментами. В таких сценариях каталог выполняет роль источника правдолюбия: получатели метаданных — аналитики, инженеры и менеджеры — получают единый доступ к актуальным описаниям объектов и контексту.
В рамках технологических ограничений и бизнес-потребностей полезно помнить: интеграции должны быть не только технически корректными, но и управляемыми в организационном плане. Это значит наличие регламентов по объявлению форматов данных, единых политик обновления и процессов согласования изменений между владельцами данных и командой разработки каталога. В практике часто встречаются два типа реализаций: централизованный каталог с единым репозиторием метаданных и децентрализованный каталог с согласованными контрактами между командой данных и источниками. Выбор зависит от зрелости управления данными, скорости изменений и требований к автономии команд.
Эксплуатация и сценарии использования
Эксплуатация каталога данных — это не только поддержание работоспособности системы, но и активная повседневная деятельность, направленная на повышение ценности данных для бизнеса. Ниже приведены базовые сценарии использования и ключевые практики, которые позволяют максимально раскрыть потенциал каталога в корпоративной среде.
- Поиск и самообслуживание: пользователи без глубоких технических знаний должны быть способны находить нужные данные, изучать контекст и запрашивать доступ. Эффективная навигация по бизнес-терминам, тегам, атрибутам качества и lineage снижает зависимость от специалистов IT.
- Управление доступом и соответствие: каталог становится точкой контроля для аудита и соблюдения требований. Управление ролями, политики доступа к данным и отслеживание действий пользователей позволяют обеспечить соответствие регуляциям и внутренним политкам.
- Контроль качества и мониторинг данных: метрики качества и автоматические проверки должны быть встроены в жизненный цикл метаданных. Регулярные проверки на полноту описания, согласованность и актуальность помогают поддерживать доверие к данным.
- Линейность и прослеживаемость данных: lineage позволяет понять цепочку происхождения данных, влияние изменений и зависимостей. Это критично для регуляторных требований и анализа влияния.
- Инструмент самообслуживания и аналитика: каталог служит основой для подготовки аналитических запросов, разработки моделей и обучения. Благодаря унифицированному контексту снижается риск непонимания данных и ошибок в аналитике.
- Эволюция и устойчивость изменений: обновления в источниках, схемах и бизнес-терминах должны происходить предсказуемо и без сбоев. Важны процессы утверждения изменений, миграции версий и обратной совместимости.
- Метрики эффективности каталога: оценка эффективности внедрения и эксплуатации включает показатели времени обнаружения данных, доли объектов с полной аннотацией, качество lineage и скорость обработки изменений.
Практика эксплуатации требует сочетания процессов, технических решений и организационных изменений. В частности, внедрение каталога данных часто сопровождается:
- Определением ролей и ответственных за данные на уровне бизнеса и IT.
- Разработкой политики управления метаданными и регламентов по обновлению.
- Непрерывной интеграцией каталога в конвейеры данных, BI и аналитические рабочие пространства.
- Внедрением практик тестирования метаданных и аудита изменений.
- Обеспечением устойчивости к изменениям в источниках данных и инфраструктуре.
Эти практики позволяют каталогу стать не только реестром, но и активной средой поддержки качества, прозрачности и доверия к данным внутри всей организации. В результате бизнес-подразделения получают возможность принимать решения на основе контекстной информации и связанной модели данных, что сокращает разрыв между технической реализацией и бизнес-ценностью.
Примеры реализации и стратегии внедрения
Эффективная работа с каталогом требует продуманной стратегии внедрения, подходов к миграции существующих метаданных и плана по развитию с учётом потребностей бизнеса. Ниже приводятся практические рекомендации, которые применимы к крупной корпоративной среде.
- Этапы внедрения: начните с пилотного проекта вокруг ключевого бизнес-объекта (например, заказ или клиент) с участием представителей бизнеса и IT; затем постепенно расширяйте покрытие на данные области и источники.
- Архитектура на микроуровнях: используйте модульный подход с независимыми коннекторами, которые можно разворачивать и обновлять отдельно; внедрите единую схему описания и контрактов между сервисами.
- Уровень зрелости управления данными: на старте сосредоточьтесь на базовом наборе атрибутов и простой линейности; далее добавляйте более сложную модель качества и зависимости по мере роста зрелости организации.
- План миграции и синхронизации: определить приоритетные источники для миграции метаданных, организовать периодическую синхронизацию и обеспечить обратную совместимость версий.
- KPI и измерение эффекта: time-to-discover, доля описанных объектов, полнота и актуальность описаний, степень покрытия lineage, скорость обновления метаданных после изменений.
- Обеспечение устойчивости и безопасности: внедрите политики обнаружения чувствительных данных, правила шифрования и аудит доступа; продумайте управление инцидентами в случае ошибок или нарушений.
Применение таких подходов в реальных условиях повышает вероятность успешного внедрения и обеспечивает устойчивость каталога в условиях изменений в бизнесе и инфраструктуре. В результате каталог становится не просто инструментом управления данными, а стратегическим активом, который поддерживает прозрачность, соответствие требованиям и ускорение цифровой трансформации.
Key takeaways
- Каталог данных в корпоративной data-платформе становится центральной единицей для описания, поиска, контроля качества и прослеживаемости данных.
- Архитектура каталога должна включать слои источников метаданных, хранения, индексации, политики, API, UI и мониторинга, обеспечивая модульность и масштабируемость.
- Модели метаданных должны быть согласованы на концептуальном, логическом и физическом уровнях, поддерживая версионирование и линейность данных.
- Интеграции требуют устойчивых паттернов взаимодействия, стандартных API, безопасных протоколов и механизмов обмена событиями.
- Эксплуатация каталога должна обеспечивать самообслуживание, управление доступом и аудит, мониторинг качества и прослеживаемость данных.
- Внедрение требует поэтапности, согласования бизнес-терминов, политики изменений и определения KPI для измерения эффективности.
- Каталог данных должен быть адаптивным к изменениям инфраструктуры и бизнес-требований, оставаясь источником доверия и скорости принятия решений.
FAQ
1) Что такое каталог данных и зачем он нужен в корпоративной data-платформе?
- Каталог данных — это централизованный реестр, который хранит описания всех активов данных, их контекст, владельцев, lineage и политики доступа. Он нужен для ускорения поиска, повышения прозрачности, обеспечения соответствия требованиям и поддержки самоуверенного использования данных бизнес-пользователями и аналитиками.
2) Каковы базовые архитектурные слои каталога и зачем каждый из них нужен?
- Базовые слои включают: источник метаданных (коннекторы к источникам), хранилище метаданных (единое репозитори), индексацию и поиск (быстрый доступ к данным), политики и аудит (контроль и безопасность), API и интеграции (взаимодействие с потребителями и источниками) и UI/мониторинг (самообслуживание и наблюдаемость). Каждый слой отделяет ответственность и упрощает развитие без затрагивания остальных слоев.
3) Какие модели метаданных наиболее полезны для эксплуатации каталога?
- Три уровня: концептуальная модель (бизнес-термины), логическая модель (связи между объектами и их зависимостями), физическая модель (конкретная реализация хранения и обработки). Дополнительно важны модели качества данных и lineage, обеспечивающие контроль за качеством и прослеживаемость происхождения.
4) Какие паттерны интеграции наиболее эффективны в рамках каталога?
- Эффективны паттерны: коннекторы к источникам, стандартные REST/gRPC API для доступа к метаданным, обмен событиями через etablированные брокеры (Kafka), протоколы безопасности (TLS, OAuth2) и управление доступом на основе ролей или атрибутов. Важно обеспечить совместимость между источниками и единым контрактом метаданных.
5) Как обеспечить безопасность и соответствие в каталоге?
- Внедрять политики доступа на уровне объектов и контекстов данных, использовать аудит действий пользователей, обеспечить шифрование данных в состоянии покоя и в транзите, поддерживать регламент обновления и доказательства соответствия регуляторам (регистрация изменений, версия метаданных).
6) Какие признаки указывают на готовность каталога к масштабированию?
- Наличие модульной архитектуры и горячей замены компонентов, поддержка горизонтального масштабирования, эффективные индексы и кеширование, возможность добавлять новые источники и типы объектов без серьезной переработки архитектуры, а также устойчивые процессы управления изменениями и контроля качества.
7) Как измеряется ценность каталога для бизнеса?
- По метрикам времени обнаружения данных (time-to-discovery), доле объектов с полной аннотацией, качеству lineage, скорости обновления метаданных после изменений и количеству пользователей, активно использующих каталог в самообслуживании.
8) Какие примеры open-source решений можно рассмотреть для начала внедрения?
- Apache Atlas и Amundsen — два популярных примера, которые предоставляют базовые функциональности по сбору метаданных, управлению lineage и поддержке политики доступа. Выбор зависит от контекста организации, зрелости процессов управления данными и требований к интеграциям.
9) Как каталогу обеспечивать устойчивость к изменениям инфраструктуры?
- Необходимо внедрять контрактное описание объектов, версионирование метаданных и миграционные стратегии. Важно автоматизировать обновление метаданных при изменениях источников и обеспечить совместимость версий, чтобы бизнес-пользователи не сталкивались с неожиданными разрывами контекста.
10) Какие шаги стоит предпринять в начале пути внедрения каталога?
- Определить пилотную предметную область, собрать команду из бизнеса и IT, сформировать минимальный набор метаданных и обязательств по качеству, выбрать архитектуру и паттерны интеграции, запустить цикл внедрения с четкой дорогой карты и KPI, а затем последовательно расширять покрытие и функциональность.


