Конвертирование файлов Ethereum ETL в формат Parquet
В этой статье я буду конвертировать экспортированные CSV-файлы в формат Apache Parquet. Зачем это нужно:
- Поскольку Parquet использует сжатие на уровне столбцов и файлов, он значительно уменьшает размер файлов, поэтому за хранение в S3 Вы платите меньше. Для первых 5 миллионов блоков общий размер файла уменьшится с 70 ГБ до примерно 30 ГБ.
- Поскольку столбцовый формат файлов уменьшает объем данных, которые необходимо сканировать, время работы и стоимость SQL-запросов в Athena сокращаются в разы. Большинство запросов обойдутся Вам в 10 раз дешевле, а для некоторых запросов и в 300 раз.
Существует два способа преобразования CSV в Parquet:
- Использование AWS EMR( смотрите статью https://docs.aws.amazon.com/athena/latest/ug/convert-to-columnar.html)
- Использование AWS Glue, о котором мы поговорим в этой статье. Мне этот подход нравится больше, потому что AWS Glue позволяет планировать задания и поддерживает закладки заданий. Кроме того, Вы можете добавлять пользовательские преобразования в свой Spark-скрипт.

Запуск краулеров
- Войдите в консоль AWS Glue и создайте новый краулер https://ap-southeast-1.console.aws.amazon.com/glue
-
Выберите S3 для хранилища данных и укажите Include Path
s3://<your_bucket>/ethereumetl/export/blocks - Выберите или создайте роль IAM с правами на чтение вашего ведра S3.
- Выберите или создайте новую базу данных под названием ehtereumetl
- Запустите краулер
Результатом работы краулера является определение таблицы, созданное в Glue Data Catalog. Обратите внимание, что очень важно изменить типы столбцов, требующих высокой точности (transactions.tx_value, erc20_transfers.erc20_value, blocks.block_difficulty, blocks.block_total_difficulty), на строковые.
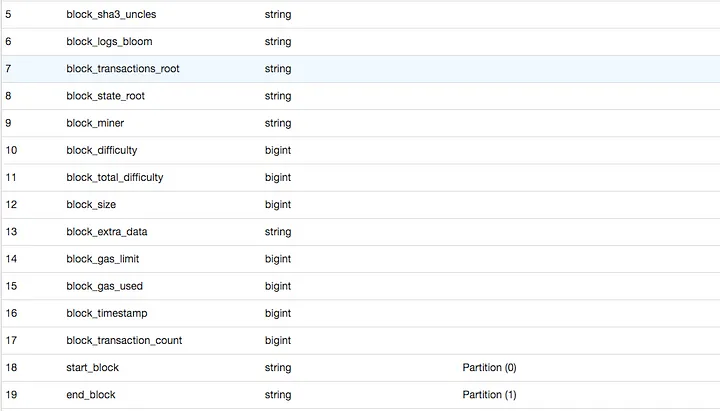
Glue также считывает все разделы, которые Вы можете увидеть, нажав на кнопку View Partitions.
Аналогичным образом следует запускать краулеры для транзакций и переводов ERC20.
Выполнение заданий ETL
Вы можете создать новое задание, следуя указаниям мастера Glue. Он предложит вам сгенерировать сценарий Spark на основе определения таблицы, или вы можете создать собственный сценарий. Автоматически сгенерированный сценарий не будет разбивать результирующие файлы Parquet, поэтому, если вам нужно, чтобы данные были разбиты, вы можете использовать сценарии из раздела https://github.com/medvedev1088/ethereum-export-pipeline/tree/master/ethereumetl/aws_glue_scripts. Пример транзакции:
import sys
from awsglue.transforms import *
from awsglue.utils import getResolvedOptions
from pyspark.context import SparkContext
from awsglue.context import GlueContext
from awsglue.job import Job
## @params: [JOB_NAME]
args = getResolvedOptions(sys.argv, ['JOB_NAME'])
sc = SparkContext()
glueContext = GlueContext(sc)
spark = glueContext.spark_session
job = Job(glueContext)
job.init(args['JOB_NAME'], args)
## @type: DataSource
## @args: [database = "ethereumetl", table_name = "transactions", transformation_ctx = "data_source"]
## @return: data_source
## @inputs: []
data_source = glueContext.create_dynamic_frame.from_catalog(database="ethereumetl", table_name="transactions",
                                                            transformation_ctx="data_source")
## @type: ApplyMapping
## @args: [mapping = [("start_block", "string", "start_block", "string"),("end_block", "string", "end_block", "string"),("tx_hash", "string", "tx_hash", "string"), ("tx_nonce", "long", "tx_nonce", "long"), ("tx_block_hash", "string", "tx_block_hash", "string"), ("tx_block_number", "long", "tx_block_number", "long"), ("tx_index", "long", "tx_index", "long"), ("tx_from", "string", "tx_from", "string"), ("tx_to", "string", "tx_to", "string"), ("tx_value", "long", "tx_value", "long"), ("tx_gas", "long", "tx_gas", "long"), ("tx_gas_price", "long", "tx_gas_price", "long"), ("tx_input", "string", "tx_input", "string")], transformation_ctx = "mapped_frame"]
## @return: mapped_frame
## @inputs: [frame = data_source]
mapped_frame = ApplyMapping.apply(frame=data_source, mappings=[
    ("start_block", "string", "start_block", "string"),
    ("end_block", "string", "end_block", "string"),
    ("tx_hash", "string", "tx_hash", "string"),
    ("tx_nonce", "long", "tx_nonce", "long"),
    ("tx_block_hash", "string", "tx_block_hash", "string"),
    ("tx_block_number", "long", "tx_block_number", "long"),
    ("tx_index", "long", "tx_index", "long"),
    ("tx_from", "string", "tx_from", "string"),
    ("tx_to", "string", "tx_to", "string"),
    ("tx_value", "string", "tx_value", "decimal(38,0)"),
    ("tx_gas", "long", "tx_gas", "long"),
    ("tx_gas_price", "long", "tx_gas_price", "long"),
    ("tx_input", "string", "tx_input", "string")],
                                   transformation_ctx="mapped_frame")
## @type: ResolveChoice
## @args: [choice = "make_struct", transformation_ctx = "resolve_choice_frame"]
## @return: resolve_choice_frame
## @inputs: [frame = mapped_frame]
resolve_choice_frame = ResolveChoice.apply(frame=mapped_frame, choice="make_struct", transformation_ctx="resolve_choice_frame")
## @type: DropNullFields
## @args: [transformation_ctx = "drop_null_fields_frame"]
## @return: drop_null_fields_frame
## @inputs: [frame = resolve_choice_frame]
drop_null_fields_frame = DropNullFields.apply(frame=resolve_choice_frame, transformation_ctx="drop_null_fields_frame")
## @type: DataSink
## @args: [connection_type = "s3", connection_options = {"path": "s3://<your_bucket>/ethereumetl/parquet/transactions"}, format = "parquet", transformation_ctx = "data_sink"]
## @return: data_sink
## @inputs: [frame = drop_null_fields_frame]
data_sink = glueContext.write_dynamic_frame.from_options(frame=drop_null_fields_frame, connection_type="s3",
                                                         connection_options={
                                                             "path": "s3://<your_bucket>/ethereumetl/parquet/transactions",
                                                             "partitionKeys": ["start_block", "end_block"]},
                                                         format="parquet", transformation_ctx="data_sink")
job.commit()
Убедитесь, что Вы подставили в переменную <your_bucket> правильное значение. Аналогичным образом Вы можете создать еще 2 задания для блоков и erc20_transfers.
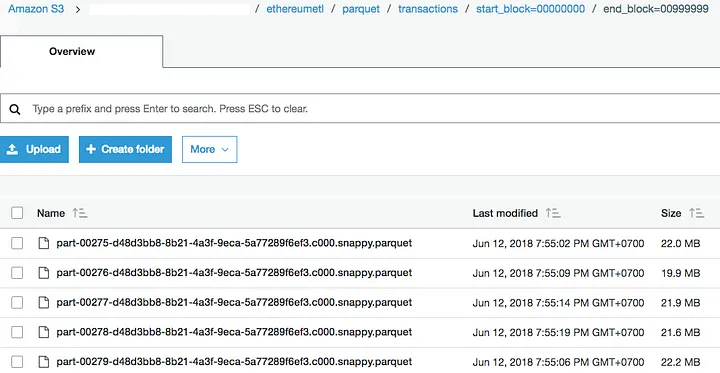
Результатом выполнения заданий будут файлы Parquet в S3, разделенные на start_block и end_block:
Вот один из примеров запроса, который для сканирования CSV-файлов потребовал 120 ГБ данных, а для сканирования Parquet - всего 425 МБ. Таким образом, за его выполнение Вы заплатите почти в 300 раз меньше:
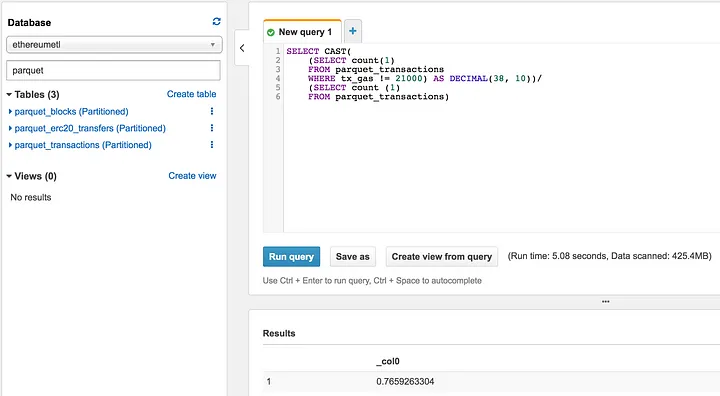
Кстати, этот запрос показывает долю всех транзакций, которые являются обращениями к контрактам.
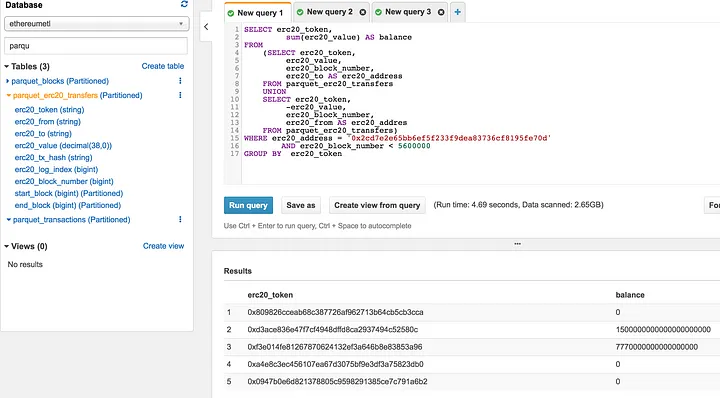
Вот еще один запрос, который показывает баланс токенов для определенного адреса: