Как генерировать файлы Parquet на Java
Parquet - это формат файлов с открытым исходным кодом, разработанный компанией Apache для инфраструктуры Hadoop. Изначально он создавался как формат файлов исключительно для Hadoop, но со временем стал очень популярным, и даже поставщики облачных услуг, такие как AWS, начали его поддерживать. В этом посте мы рассмотрим, что именно представляет собой формат файлов Parquet, а затем разберем простой пример создания или записи файлов Parquet на Java.
Введение в формат файлов Parquet
При традиционном подходе мы храним данные в виде строк. Но Parquet использует другой подход: он «сплющивает» данные в столбцы перед их сохранением. Это повышает производительность запросов в разы. Кроме того, благодаря такому подходу к хранению данных формат может работать с наборами данных с большим количеством столбцов.
Большинство проектов по работе с Big Data используют формат файлов Parquet именно из-за всех этих особенностей. Файлы Parquet также позволяют сократить объем требуемого пространства для хранения данных. В большинстве случаев мы используем запросы с определенными столбцами. Прелесть формата заключается в том, что данные для столбца расположены рядом, поэтому запросы выполняются быстрее.
Благодаря оптимизации и популярности формата файлов даже Amazon предоставляет встроенные функции для преобразования входящих потоков данных в файлы Parquet перед сохранением в S3 (который выступает в роли озера данных). Я использовал эту опцию в Athena и некоторых сервисах Apache. Для получения дополнительной информации о файловой системе Parquet рекомендую обратиться к официальной документации.
Зависимости
Прежде чем мы начнем писать код, нам нужно позаботиться о зависимостях. Поскольку это проект Spring Boot Maven, мы перечислим все наши зависимости в файле pom.xml:
<dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter</artifactId> </dependency> <dependency> <groupId>org.apache.parquet</groupId> <artifactId>parquet-hadoop</artifactId> <version>1.8.1</version> </dependency> <dependency> <groupId>org.apache.hadoop</groupId> <artifactId>hadoop-core</artifactId> <version>1.2.1</version> </dependency> </dependencies>
Как Вы видите, мы добавляем стартовый пакет Spring Boot и еще несколько зависимостей Apache. Для данного примера это все, что нам нужно.

Характеристики
У нас есть файл application.properties, в котором мы указываем все свойства. Для нашего примера нам нужно всего два свойства: одно указывает путь к файлу схемы, а другое - путь к каталогу. Подробнее о схеме мы поговорим чуть позже. Итак, файл свойств выглядит следующим образом:
schema.filePath=
output.directoryPath=
Поскольку это приложение Spring Boot, мы будем использовать аннотацию @Value для чтения этих значений в коде:
@Value("${schema.filePath}")
 private String schemaFilePath; @Value("${output.directoryPath}") private String outputDirectoryPath;
Схема файла Parquet
Нам необходимо указать схему данных, которые мы собираемся записать в файл Parquet. Это необходимо потому, что при создании двоичного файла Parquet тип данных каждого столбца также сохраняется. Основываясь на схеме, которую мы указываем в файле схемы, код будет соответствующим образом форматировать данные перед записью в файл Parquet.
Я придерживаюсь простой схемы:
message m {
      required INT64 id;
      required binary username;
      required boolean active;
}
Позвольте мне объяснить, что это такое. Первый параметр имеет тип INT64, то есть целое число, и называется id. Второе поле имеет тип binary, то есть является ничем иным, как строкой. Мы называем это поле именем пользователя. Третье поле - булево поле под названием active. Это довольно простой пример. Но, к сожалению, если ваши данные содержат сотню столбцов, Вам придется объявить их все здесь.
Ключевое слово required перед объявлением поля используется для проверки, чтобы убедиться в том, что для этого поля значение указано верно. Это необязательно, Вы можете убрать его для полей, которые не являются обязательными.
ParquetWriter
Время заявления об отказе от ответственности: я не писал эти два класса, о которых мы поговорим в этом разделе. Несколько месяцев назад, когда я изучал этот вопрос, я нашел их на StackOverFlow. Я не знаю, кто их написал. Но да, я переименовал их в соответствии с проектом.
Класс CustomParquetWriter расширяет класс ParquetWriter, который предоставляет Apache. Код для этого класса выглядит следующим образом:
public class CustomParquetWriter extends ParquetWriter<List<String>> { public CustomParquetWriter( Path file, MessageType schema, boolean enableDictionary, CompressionCodecName codecName ) throws IOException { super(file, new CustomWriteSupport(schema), codecName, DEFAULT_BLOCK_SIZE, DEFAULT_PAGE_SIZE, enableDictionary, false); } }Следующий класс - CustomWriteSupport, который Вы можете видеть в качестве второго параметра конструктора super() в приведенном выше фрагменте. Здесь происходит много всего интересного. Вы можете найти полный класс в репозитории и посмотреть, что он делает.
По сути, данный класс проверяет схему для того, чтобы определить тип данных каждого поля. После этогоданные записываются в файл, используя экземпляр класса RecordConsumer. Я не буду много говорить об этих двух классах, потому что а) я их не писал и б) код достаточно прост.
Подготовка данных для файла Parquet
Давайте подготовим данные для записи в файлы Parquet. Список строк представляет собой один набор данных для файла Parquet. Каждый элемент в этом списке будет значением корректирующего поля в файле схемы.
Глядя на файл схемы, мы можем сказать, что первое значение в массиве - это ID, второе - имя, а третье - булевский флаг для активного поля.
Итак, в нашем коде у нас будет список из списка String для представления нескольких строк. Да, Вы все правильно поняли, это список строк:
List<List<String>> columns = getDataForFile();
Давайте посмотрим на функцию, чтобы увидеть, как мы генерируем данные:\
private List<List<String>> getDataForFile() { List<List<String>> data = new ArrayList<>(); List<String> parquetFileItem1 = new ArrayList<>(); parquetFileItem1.add("1"); parquetFileItem1.add("Name1"); parquetFileItem1.add("true"); List<String> parquetFileItem2 = new ArrayList<>(); parquetFileItem2.add("2"); parquetFileItem2.add("Name2"); parquetFileItem2.add("false"); data.add(parquetFileItem1); data.add(parquetFileItem2); return data; }Просто, не так ли? Идем дальше.
Получение файла схемы
Как мы уже говорили ранее, у нас есть файл со схемой. Нам нужно перенести эту схему в код, в частности, в виде экземпляра класса MessageType. Давайте посмотрим, как это сделать:
MessageType schema = getSchemaForParquetFile(); ... private MessageType getSchemaForParquetFile() throws IOException { File resource = new File(schemaFilePath); String rawSchema = new String(Files.readAllBytes(resource.toPath())); return MessageTypeParser.parseMessageType(rawSchema); }Как видите, мы читаем файл как строку, а затем разбираем ее с помощью метода parseMessageType() в классе MessageTypeParser, предоставляемом библиотекой Apache.
Получение Parquet Writer
Это предпоследний шаг в процессе. Нам просто нужно получить экземпляр класса CustomParquetWriter, о котором мы говорили ранее. Здесь мы также указываем путь к выходному файлу, в который будет производиться запись. Код для этого также довольно прост:
CustomParquetWriter writer = getParquetWriter(schema);

...

private CustomParquetWriter getParquetWriter(MessageType schema) throws IOException {
    String outputFilePath = outputDirectoryPath+ "/" + System.currentTimeMillis() + ".parquet";
    File outputParquetFile = new File(outputFilePath);
    Path path = new Path(outputParquetFile.toURI().toString());
    return new CustomParquetWriter(
            path, schema, false, CompressionCodecName.SNAPPY
    );
}
Запись данных в файл ParquetПоследний шаг - нам осталось записать данные в файл. Мы создадим список и внесем его в файл с помощью Writer, который мы создали на предыдущем шаге:
for (List<String> column : columns) {
     writer.write(column); } logger.info("Finished writing Parquet file."); writer.close();
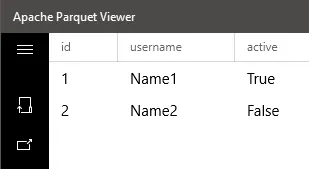
Вот, собственно, и все. Теперь Вы можете перейти в выходной каталог и проверить созданный файл. Вот что я получил после запуска этого проекта: