

Использование плагинов для загрузки файлов Parquet из S3 в Pinot
Одним из главных преимуществ использования Pinot является его архитектура плагинов . Плагины позволяют легко добавить поддержку любой сторонней системы, которая может быть фреймворком выполнения, файловой системой или форматом ввода.
В этом руководстве мы будем использовать три таких плагина, чтобы легко получать данные и отправлять их на наш кластер Pinot. Плагины, которые мы будем использовать:
- pinot-batch-ingestion-spark
- pinot-s3
- pinot-parquet
Информация обо всех плагинах доступна здесь: пакетная загрузка данных , файловые системы, и форматы ввода.
Настройка
В этом уроке мы будем использовать следующие инструменты и фреймворки:
- Apache Spark 2.2.3 (хотя любой spark 2.X должен работать)
- Apache Parquet 1.8.2
- Amazon S3
- Apache Pinot 0.4.0
Входные данные
Для начала нам нужно получить входные данные. Для начала давайте создадим несколько небольших файлов Parquet и загрузим их в бакет S3. Самый простой способ сделать это - создать CSV-файлы, а затем преобразовать их в Parquet. Назовем этот файл students.csv:
|
timestampInEpoch |
id |
name |
age |
score |
|---|---|---|---|---|
|
1597044264380 |
1 |
david |
15 |
98 |
|
1597044264381 |
2 |
henry |
16 |
97 |
|
1597044264382 |
3 |
katie |
14 |
99 |
|
1597044264383 |
4 |
catelyn |
15 |
96 |
|
1597044264384 |
5 |
emma |
13 |
93 |
|
1597044264390 |
6 |
john |
15 |
100 |
|
1597044264396 |
7 |
isabella |
13 |
89 |
|
1597044264399 |
8 |
linda |
17 |
91 |
|
1597044264502 |
9 |
mark |
16 |
67 |
|
1597044264670 |
10 |
tom |
14 |
78 |

Теперь создадим файлы Parquet из приведенного выше CSV-файла с помощью Spark. Поскольку это небольшая программа, мы будем использовать только оболочку Spark (писать полноценный код Spark не нужно).
val df = spark.read.format("csv").option("header", true).load("path/to/students.csv")
df.write.option("compression","none").mode("overwrite").parquet("/path/to/batch_input/")
Файлы .parquet теперь можно найти в каталоге /path/to/batch_input. Теперь Вы можете загрузить эту директорию в S3 либо с помощью пользовательского интерфейса, либо выполнив следующую команду.
aws s3 cp /path/to/batch_input s3://my-bucket/batch-input/ --recursive
Создание схемы и таблицы
Нам нужно создать таблицу для запроса данных, которые будут поступать в систему. Все таблицы в Pinot связаны со схемой. Более подробная информация доступна в Конфигурации таблиц и Конфигурации схем.
Для нашей демонстрации мы используем следующие конфигурации схем и таблиц:
{
    "schemaName": "students",
    "dimensionFieldSpecs": [
        {
            "name": "id",
            "dataType": "INT"
        },
        {
            "name": "name",
            "dataType": "STRING"
        },
        {
            "name": "age",
            "dataType": "INT"
        }
    ],
    "metricFieldSpecs": [
        {
            "name": "score",
            "dataType": "INT"
        }
    ],
    "dateTimeFieldSpecs": [
        {
            "name": "timestampInEpoch",
            "dataType": "LONG",
            "format": "1:MILLISECONDS:EPOCH",
            "granularity": "1:MILLISECONDS"
        }
    ]
}
{
    "tableName": "students",
    "segmentsConfig": {
        "timeColumnName": "timestampInEpoch",
        "timeType": "MILLISECONDS",
        "replication": "1",
        "schemaName": "students"
    },
    "tableIndexConfig": {
        "invertedIndexColumns": [],
        "loadMode": "MMAP"
    },
    "tenants": {
        "broker": "DefaultTenant",
        "server": "DefaultTenant"
    },
    "tableType": "OFFLINE",
    "metadata": {}
}
Теперь мы можем загрузить эти конфигурации в Pinot и создать пустую таблицу. Для этого мы будем использовать CLI pinot-admin.sh.
pinot-admin.sh AddTable -tableConfigFile /path/to/student_table.json -schemaFile /path/to/student_schema.json -controllerHost localhost -controllerPort 9000 -exec
обо всех командах предоставлена в интерфейсе командной строки (CLI).
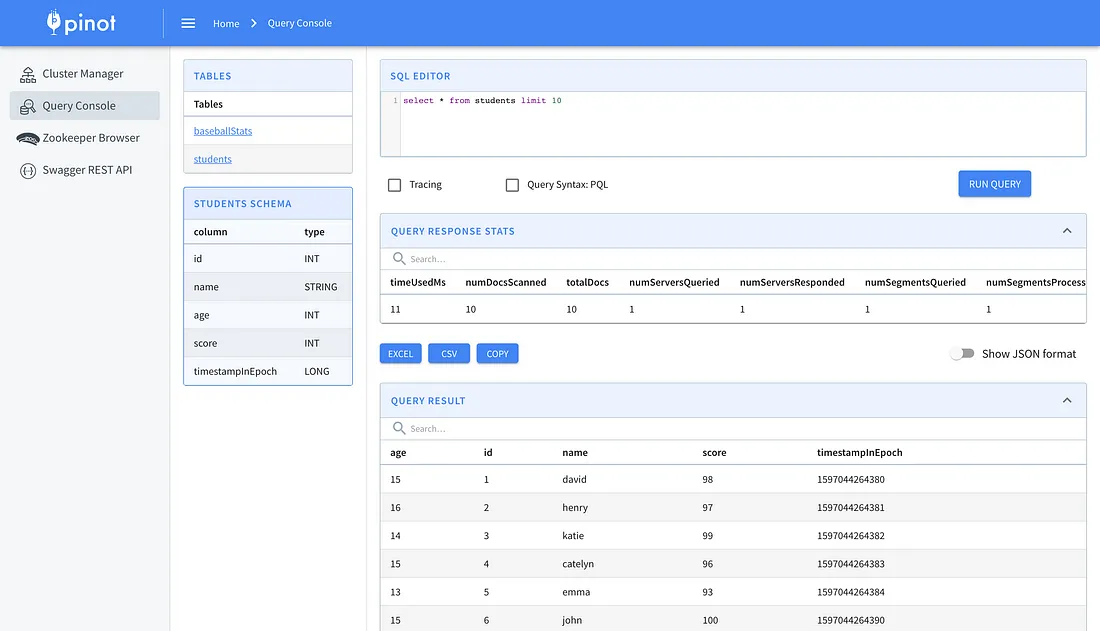
Теперь наша таблица будет доступна в Pinot data explorer.
Загрузка данных
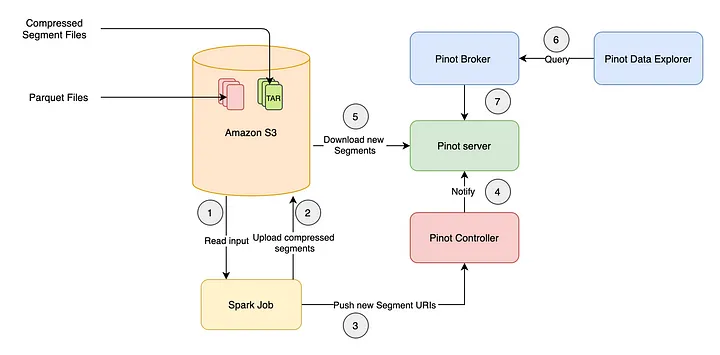
Теперь, когда наши данные доступны в S3, а также у нас есть таблицы в Pinot, мы можем приступить к процессу захвата данных. Ввод данных в Pinot включает в себя следующие шаги:
- Считывание данных и создание сжатых сегментных файлов на входе
- Загрузите сжатые файлы сегментов в выходное место
- Передайте расположение сегментных файлов контроллеру
Как только местоположение станет доступно контроллеру, он сможет уведомить серверы о необходимости загрузить файлы сегментов и заполнить таблицы.
Описанные выше шаги можно выполнить с помощью любого распределенного исполнителя, например Hadoop, Spark, Flink и т. д. В нашем случае мы будем использовать Apache Spark.
Pinot предоставляет команды для Spark из коробки. Поэтому Вам, как пользователю, не нужно писать ни строчки кода. Вы можете написать команду для любого другого исполнителя, используя предоставленные нами интерфейсы.
Сначала мы создадим файл конфигурации спецификации задания для нашего процесса ввода данных.
executionFrameworkSpec:
name: 'spark'
segmentGenerationJobRunnerClassName: 'org.apache.pinot.plugin.ingestion.batch.spark.SparkSegmentGenerationJobRunner'
segmentTarPushJobRunnerClassName: 'org.apache.pinot.plugin.ingestion.batch.spark.SparkSegmentTarPushJobRunner'
segmentUriPushJobRunnerClassName: 'org.apache.pinot.plugin.ingestion.batch.spark.SparkSegmentUriPushJobRunner'
extraConfigs:
stagingDir: s3://my-bucket/spark/staging/
jobType: SegmentCreationAndTarPush
inputDirURI: 's3://my-bucket/path/to/batch-input/'
outputDirURI: 's3:///my-bucket/path/to/batch-output/'
overwriteOutput: true
pinotFSSpecs:
- scheme: s3
className: org.apache.pinot.plugin.filesystem.S3PinotFS
recordReaderSpec:
dataFormat: 'parquet'
className: 'org.apache.pinot.plugin.inputformat.parquet.ParquetRecordReader'
tableSpec:
tableName: 'students'
pinotClusterSpecs:
- controllerURI: 'http://localhost:9000'
pushJobSpec:
pushParallelism: 2
pushAttempts: 2
pushRetryIntervalMillis: 1000
В спецификации задания мы указали фреймворк выполнения как spark и настроили соответствующие команды для каждого из наших шагов. Нам также нужен временный каталог stagingDir для нашего задания spark. Этот каталог будет очищен после выполнения задания.
Мы также предоставляем реализацию S3 Filesystem и Parquet reader в конфигурации для использования. Полный список конфигураций можно посмотреть в Ingestion Job Spec.
Теперь мы можем запустить наше задание Spark для выполнения всех шагов и заполнения данных в Pinot.
export PINOT_VERSION=0.4.0
export PINOT_DISTRIBUTION_DIR=/path/to/apache-pinot-incubating-${PINOT_VERSION}-bin

spark-submit //
--class org.apache.pinot.tools.admin.command.LaunchDataIngestionJobCommand //
--master local --deploy-mode client //
--conf "spark.driver.extraJavaOptions=-Dplugins.dir=${PINOT_DISTRIBUTION_DIR}/plugins -Dplugins.include=pinot-s3,pinot-parquet -Dlog4j2.configurationFile=${PINOT_DISTRIBUTION_DIR}/conf/pinot-ingestion-job-log4j2.xml" //
--conf "spark.driver.extraClassPath=${PINOT_DISTRIBUTION_DIR}/plugins/pinot-batch-ingestion/pinot-batch-ingestion-spark/pinot-batch-ingestion-spark-0.4.0-shaded.jar:${PINOT_DISTRIBUTION_DIR}/lib/pinot-all-${PINOT_VERSION}-jar-with-dependencies.jar:${PINOT_DISTRIBUTION_DIR}/plugins/pinot-file-system/pinot-s3/pinot-s3-0.4.0-shaded.jar:${PINOT_DISTRIBUTION_DIR}/plugins/pinot-input-format/pinot-parquet/pinot-parquet-0.4.0-shaded.jar" //

local://${PINOT_DISTRIBUTION_DIR}/lib/pinot-all-${PINOT_VERSION}-jar-with-dependencies.jar -jobSpecFile /path/to/spark_job_spec.yaml
В команде мы включили JAR-файлы всех необходимых плагинов в classpath драйвера Spark. На практике это нужно делать только в том случае, если Вы работаете с ClassNotFoundException.
Вуаля! Теперь наши данные успешно загружены. Давайте попробуем запросить их у брокера Pinot.
bin/pinot-admin.sh PostQuery -brokerHost localhost -brokerPort 8000 -queryType sql -query "SELECT * FROM students LIMIT 10"
Если все прошло правильно, вы должны получить следующий результат:
{
  "resultTable": {
    "dataSchema": {
      "columnNames": [
        "age",
        "id",
        "name",
        "score",
        "timestampInEpoch"
      ],
      "columnDataTypes": [
        "INT",
        "INT",
        "STRING",
        "INT",
        "LONG"
      ]
    },
    "rows": [
      [
        15,
        1,
        "david",
        98,
        1597044264380
      ],
      [
        16,
        2,
        "henry",
        97,
        1597044264381
      ],
      [
        14,
        3,
        "katie",
        99,
        1597044264382
      ],
      [
        15,
        4,
        "catelyn",
        96,
        1597044264383
      ],
      [
        13,
        5,
        "emma",
        93,
        1597044264384
      ],
      [
        15,
        6,
        "john",
        100,
        1597044264390
      ],
      [
        13,
        7,
        "isabella",
        89,
        1597044264396
      ],
      [
        17,
        8,
        "linda",
        91,
        1597044264399
      ],
      [
        16,
        9,
        "mark",
        67,
        1597044264502
      ],
      [
        14,
        10,
        "tom",
        78,
        1597044264670
      ]
    ]
  },
  "exceptions": [],
  "numServersQueried": 1,
  "numServersResponded": 1,
  "numSegmentsQueried": 1,
  "numSegmentsProcessed": 1,
  "numSegmentsMatched": 1,
  "numConsumingSegmentsQueried": 0,
  "numDocsScanned": 10,
  "numEntriesScannedInFilter": 0,
  "numEntriesScannedPostFilter": 50,
  "numGroupsLimitReached": false,
  "totalDocs": 10,
  "timeUsedMs": 6,
  "segmentStatistics": [],
  "traceInfo": {},
  "minConsumingFreshnessTimeMs": 0
}
Вы также можете просмотреть результаты в пользовательском интерфейсе Data explorer.
Мощная архитектура плагинов Pinot позволила нам успешно получить паркетные записи из S3 с помощью всего нескольких настроек. Процесс, описанный в этой статье, является высокомасштабируемым и может быть использован для захвата миллиардов записей с минимальной задержкой.


