

Терминология и базовые понятия песочниц в данных
Песочницы данных выступают фундаментом для безопасного и воспроизводимого экспериментирования на стыке DWH и ML-аналитики. Они позволяют разделять вычисление, данные и конфигурацию среды между различными командами и проектами, сохраняя при этом возможность строгой аудиции и контролируемой передачи результатов в продакшен. В условиях цифровой трансформации песочницы становятся не просто средами тестирования, а архитектурной концепцией, обеспечивающей изоляцию, управляемый доступ и совместное использование ресурсов без риска утечки чувствительных данных.
Разбирая терминологию и базовые концепции песочниц в данных, следует удерживать связь между архитектурой среды, политиками доступа и требованиями к соответствию. Разделение по средам, управление версиями наборов данных и моделей, а также связь песочниц с DWH и прикладной ML-аналитикой образуют базовый набор понятий, который позволяет перейти к проектированию конкретных сред и процессах их эксплуатации.
- Термины песочницы данных, изоляции и связанных паттернов влияют на архитектурные решения, выбор инструментов и регламенты внедрения.
- Понимание уровней изоляции и процессов репликации данных позволяет минимизировать риски утечки, задержек и несогласованности версий.
Краткое содержание главы
- Определение песочницы в контексте данных, цели и основные роли в DWH и ML-аналитике.
- Архитектурные принципы: уровни изоляции, сегментация сред, управление доступом и метаданные.
- Типы песочниц и сценарии использования: разработка, эксперименты, интеграция и соответствие требованиям.
- Интеграция песочниц с DWH и ML-аналитикой: источники данных, копирования, синтетика и маскирование, обзор инструментов.
- Типовые паттерны реализации и управление изменениями: паттерны мостов, shadow data, аудит и воспроизводимость.
- Этапы внедрения: формулирование требований, дизайн среды, выбор стеков и регламентов управления.
Основные понятия и термины
Песочница в данных представляет собой ограниченное по границам окружение, в котором можно безопасно выполнять анализ, экспериментировать с моделями и тестировать преобразования данных без воздействия на продакшен-системы. Главные характеристики:
- Изоляция. Границы между песочницей и остальной инфраструктурой должны быть чёткими. Это касается сети, доступа к данным, вычислительным ресурсам и конфигурации инструментов.
- Контроль доступа. Доступ должен строиться по принципу наименьших привилегий: кто может что видеть, что может изменять и какие операции разрешены.
- Управление версиями данных и окружения. Наличие версионирования наборов данных, конфигураций сред и моделей обеспечивает воспроизводимость экспериментов.
- Метаданные и трекинг. Непрерывный контроль за происхождением данных, их трансформациями и связями с моделями через каталог метаданных и трассируемость.
- Безопасность и соответствие. В песочнице применимы техники маскирования, синтетических данных и создание «теневых» копий данных, чтобы минимизировать риск утечки ПД и нарушения регуляторных требований.
Ключевые понятия, встречающиеся в архитектурной практике песочниц:
- Data sandbox (песочница данных). Область для локального или удалённого анализа, где данные и вычисления ограничены по контексту проекта.
- Ephemeral environment (эвмонтная среда). Временная среда, которая создаётся под конкретный цикл исследования и затем удаляется.
- Shadow data. Подмножество продакшен-данных, подвергнутое маскированию или синтетизации, которое используется в песочнице для безопасного анализа.
- Synthetic data. Сгенерированные данные, отражающие статистические свойства набора без раскрытия реальных записей.
- Data masking. Техника маскирования, при которой чувствительные детали скрываются или искажаются.
- Data lineage и catalog. Регистрация источников данных, траекторий их преобразований и зависимостей между данными и моделями.
- Sandboxing patterns (паттерны песочниц). Стратегии организации песочниц: изоляция на уровне среды, мосты между средами, контроль копирования данных и пр.
Гармоничное сочетание этих понятий позволяет выстроить базовую лексику для обсуждения архитектуры песочниц, определения и согласования требований между бизнесом, ИТ и командами аналитиков.
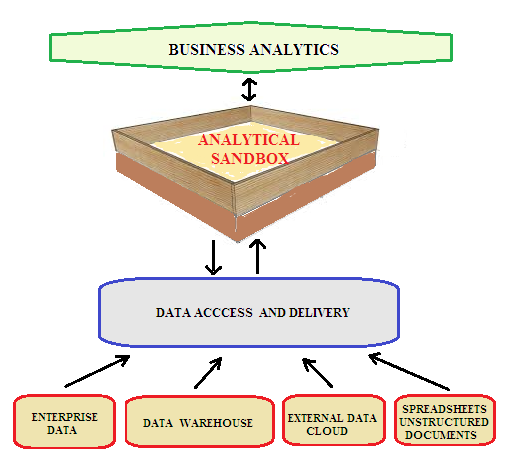
Архитектурные принципы песочниц
Глубокая архитектура песочницы следует за несколькими фундаментальными принципами, которые обеспечивают как безопасность, так и гибкость разработки и анализа.
- Многоуровневость и границы изоляции. Архитектура организуется по уровням: источники данных, staging, sandbox, продакшн. Каждый уровень имеет собственные политики доступа, вычислительные ресурсы и сетевые ограничения. Такой подход упрощает аудит и локализацию проблем.
- Контроль доступа и политика безопасности. Реализация RBAC/ABAC в сочетании с контекстно-зависимыми политиками позволяет обеспечить «need-to-know» режим работы. Важно иметь централизованный механизм управления ключами, секретами и сертификатами (Secret Management) и журналирования действий.
- Управление версиями и воспроизводимость. Все траектории данных и конфигураций сред должны быть версионированы. Это касается версий наборов данных, скриптов трансформаций и параметров моделей. В идеале внедряются процессы повторного воспроизведения экспериментов.
- Метаданные и каталогизация. Каталог метаданных связывает источники, данные, трансформации, окружения и результаты анализа. Это обеспечивает прозрачность, поиск и контроль качества.
- Механизмы маскирования и синтетических данных. Для снижения рисков конфиденциальности применяются техники маскирования, частичной деперсонализации и генерации синтетических наборов в песочнице.
- Эфемерность и управление жизненным циклом сред. Сборка и развёртывание песочницы должны быть автоматизированы. Эпизодические среды создаются для отдельных циклов анализа и удаляются после завершения.
- Архитектура подключения к DWH и ML-платформам. Песочницы должны обеспечивать безопасный доступ к данным DWH,, а также интеграцию с инструментами ML-цикла: notebooks, экспериментальные сервисы и оркестраторы.
Техническим следствием этих принципов является требование к инфраструктуре как коду (IaC): повторяемость окружения, автоматизация provisioning, версии конфигураций и контроль изменений. В качестве стандартного стека применяются контейнеризация и оркестрация (например, Kubernetes), а для определения и развертывания конфигураций - инструменты IaC (например, Terraform). Важной частью является пополнение песочницы шлюзами в сторону продакшна: каналами контрольно-гарантийной передачи данных, которые позволяют через строгие правила выборочно передавать результаты или снапшоты в тестовую или продакшен-среду.
При этом не следует забывать о сетевых границах: ingress/egress политики, сегментация VPC, шифрование в транзите и на диске. Архитектурное проектирование должно учитывать требования по GDPR, HIPAA и локальным регуляторным нормам, а также внутренние регламенты компании по обработке данных и безопасной разработке.
Если рассуждать на примере конфигураций, то можно представить две типовые составные части песочницы: «мостовую» инфраструктуру, связывающую песочницу с продакшеном через controlled data bridge, и саму среду вычислений с набором изолированных ресурсов (Compute, Storage, Network). В мостовой части обычно размещаются политики доступа, секреты и аудит, а вычислительная часть - контейнеризованные сервисы анализа и миграционные механизмы для копирования данных с необходимой маскиризацией.
Типы песочниц и сценарии использования
В рамках курса разумно выделить несколько стандартных типов песочниц и сопутствующих сценариев их применения.
- Разработка и исследование данных (Development Sandbox). Предназначена для аналитиков и инженеров данных, работающих над преобразованиями набора данных, формированием новых признаков и первоначальной валидацией гипотез. Эта песочница допускает гибкость, но ограничивает доступ к реальным данным, применяя маскирование и выборочные копии.
- ML-эксперименты (ML Sandbox). Среда, где исследователи и инженеры обучают модели, проводят гипотезные тесты, настраивают гиперпараметры и сравнивают версии моделей. Включает инструменты трекинга экспериментов, повторяемость и контроль версий.
- Интеграционная песочница (Data Integration Sandbox). Применяется командами интеграции данных, которые создают конвейеры извлечения, привязки и загрузки (ETL/ELT) и проверяют новые источники данных перед тем, как внедрять их в staging или production.
- Соответствие и безопасность (Compliance Sandbox). Среда, сфокусированная на тестировании политик маскирования, правил доступа, аудита, тестирования регуляторных требований и проверки влияния изменений на регламенты приватности.
- Препродакшен песочницы (Pre-prod Sandbox). Обеспечивает финальное испытание обновлений конвейеров данных и моделей под близкими к продакшен условиях, включая контроль версий, мониторинг качества данных и согласование метаданных перед релизом.
Типы песочниц, как правило, различаются по длительности жизни сред и уровню заявленных ограничений. Эпизодические или временные песочницы создаются под конкретные циклы анализа, затем удаляются; постоянные частично-изолированные песочницы используются для длительных проектов и команд. В архитектуре важно предусмотреть переходы между типами песочниц: копирование данных, маскирование, управление правами на передачу между средами и журналы аудита для соблюдения регуляторных требований.
Интеграция песочниц с DWH и ML-аналитикой
Интеграция песочниц с системой хранения данных и вычислительным пайплайном требует согласованности между источниками данных, правилами доступа и механизмами маскирования или синтетизации. Основные задачи интеграции:
- Безопасный доступ к источникам данных. Для каждого типа песочницы устанавливаются свои подключения к DWH и другим источникам. Доступ реализуется через централизованные политики и проверки прав.
- Маскирование и синтетика. В песочнице применяются методы маскирования или генерации синтетических данных, чтобы сохранить статистическую полезность наборов без раскрытия приватной информации.
- Копирование и трансформации. Подход «shadow data» обеспечивает наличие подмножеств продакшен-данных в песочнице с контролируемыми изменениями и линейной трассируемостью.
- Каталог метаданных и линейность. Важна связка песочницы с каталогами метаданных, чтобы отслеживать источники данных, шаги их трансформаций и зависимости между экспериментами, моделями и результатами.
- Инструменты и стеки. В рамках ограничений по объему примеров: DataHub как пример открытого каталога метаданных, и Apache Airflow как оркестрационная платформа.
В контексте архитектуры данные и вычисления из песочниц должны быть отделены от продакшена и объединяться через контролируемые каналы. Например, копирование набора данных может происходить через мостовую инфраструктуру, которая обеспечивает маскирование или синтетизацию, и только после успешного аудита передается в целевую песочницу или тестовую среду. Оркестрация конвейеров позволяет отслеживать состояние копирования, запуска трансформаций и результаты в репозитории артефактов.
Рассмотрим два примера открытых инструментов, которые часто применяются в связке с песочницами:
- DataHub. Открытый каталог метаданных, который помогает регистрировать источники данных, происхождение и трансформации. Это обеспечивает прозрачность и аудит, особенно в рамках соответствия.
- Apache Airflow. Инструмент оркестрации, который управляет зависимостями между задачами конвейеров, обеспечивает повторяемость процессов копирования данных, маскирования и трансформаций в песочнице.
Совместно эти решения позволяют реализовать безопасную передачу данных в песочницы, сохранение связей между источниками, поколениями и результатами анализа, а также автоматизировать повторяемые процессы воспроизводимости.
Типовые паттерны реализации и управления изменениями
Эти паттерны описывают чаще всего встречающиеся архитектурные решения и способы их реализации с целью повышения устойчивости и управляемости песочниц.
- Паттерн мостов (sandbox bridge). Создание управляемого канала между продакшеном и песочницей, который позволяет ограниченно копировать данные, фильтровать их и применять маскирование на уровне среды. Такой мост обеспечивает единый контроль доступа и аудит.
- Shadow data паттерн. Использование копий данных с полированием под песочницу, где чувствительная информация маскирована, а источник данных остается защищённым. Паттерн позволяет аналитикам работать с реалистичными данными без риска утечки.
- Паттерн синтетических данных. Генерация синтетических данных, сохраняющих распределения и корреляции, но без идентифицируемой информации. Эффективный способ уменьшить регуляторные препятствия при исследовании и разработке.
- Контроль версий среды и данных. Версионирование конфигураций среды, скриптов трансформаций и параметров моделей обеспечивает воспроизводимость экспериментов и упрощает возврат к предыдущим состояниям.
- Аудит и мониторинг. Включение журналирования действий пользователей, конфигураций и трансформаций. Наличие трейсбека и возврата к ранее зафиксированным точкам позволяет быстро выявлять источники ошибок и регуляторные отклонения.
- Практики безопасной передачи результатов. Передача результатов в продакшен должна проходить через процедуры валидации, согласования и тестирования на песочнице, чтобы исключить риск возврата нежелательных изменений в продакшен.
- Воспроизводимость и инфраструктура как код. Весь стек песочницы реализуется как код: описания окружений, конвейеры, правила доступа и политики безопасности хранятся в системах контроля версий и разворачиваются через IaC.
Каждый паттерн имеет контекст, в котором он наиболее эффективен. В зависимости от уровня зрелости организации и отраслевых требований выбор паттернов может варьироваться: от простых мостов и Shadow data до комплексной фабрики синтетических данных и формализованной политики аудита.
Этапы внедрения песочниц: путь от идеи к эксплуатации
Этапы внедрения следует рассматривать как последовательность, где каждая стадия усиливает контроль и воспроизводимость:
- Определение требований и профиля нагрузки. Уточнить бизнес-цели, какие данные необходимы в песочнице, какие задачи будут решаться и какие регуляторные ограничения применяются.
- Проектирование архитектуры сред. Выбрать типы песочниц, определить границы изоляции, политики доступа, связи с DWH и ML-платформами. Спроектировать мосты и процессы копирования данных.
- Выбор инструментов и технологического стека. Определить набор инструментов для оркестрации, каталогов метаданных, управления секретами и мониторинга. Минимизировать количество внешних зависимостей, чтобы снизить риски.
- Реализация и IaC. Внедрить инфраструктуру как код, обеспечить повторяемость развёртывания сред, параметризовать конфигурации и внедрить контейнеризацию и оркестрацию.
- Г governance и политика доступов. Определить роли, процедуры утверждений доступа, аудит и требования к соответствию. Установить правила жизненного цикла песочницы и регламенты мониторинга.
- Тестирование и валидация. Пройти через тестирование сценариев доступа, качества данных, маскирования и репродуцируемости экспериментов.
- Мониторинг, аудит и эволюция. Организовать мониторинг использования песочниц, устойчивость к сбоям, обновления политик и технологического стека. Обеспечить развитие среды в ответ на меняющиеся требования бизнеса.
Key takeaways
- Песочницы данных - изолированные среды для безопасного анализа и экспериментов, связывающие архитектуру DWH и ML-аналитики.
- Основной набор принципов: изоляция, контроль доступа, управление версиями, метаданные и безопасность.
- Типы песочниц включают разработку, ML-эксперименты, интеграцию и соответствие; каждый тип имеет характерные требования к жизненному циклу и доступу.
- Интеграция с DWH и ML требует безопасных мостов, маскирования и каталога метаданных; открытые инструменты DataHub и Apache Airflow часто используются как часть стека.
- Типовые паттерны - мосты, shadow data и синтетика; ключ к успеху - воспроизводимость, аудит и управление изменениями.
- Эффективное внедрение строится на четком прототипировании архитектуры, IaC, регламентах доступа и поэтапном расширении сред.
FAQ
- Что такое песочница в данных и зачем она нужна в DWH и ML?
Песочница в данных - это управляемая среда, отделенная от продакшена, где можно безопасно выполнять преобразования данных, эксперименты с моделями и тестировать конвейеры. Она нужна для снижения рисков утечки конфиденциальной информации, контроля изменений, воспроизводимости анализов и автономного обучения команд без воздействия на операции.
- Какие типичные уровни изоляции применяются в песочницах?
Обычно выделяют сетевую изоляцию и изоляцию данных, включая разделение по средам (источники данных, staging, sandbox, production), контроль доступа и строгие политики маскирования. Временная эмуляция и контроль версий позволяют держать среду под наблюдением и повторяемой.
- Какую роль играют метаданные в песочницах?
Метаданные обеспечивают линейность между источниками данных, их превращениями и результатами анализа. Каталоги метаданных позволяют аудитировать, воспроизводить эксперименты и быстро находить источники данных, что особенно важно для соответствия и доверия к результатам.
- Какие техники маскирования и синтетики данных применяются в песочницах?
Маскирование скрывает чувствительные элементы в реальных данных, а синтетика создает искусственные наборы, сохраняющие статистические свойства. Эти методы позволяют аналитикам работать с реалистичными данными без риска утечки персональных данных.
- Какие архитектурные паттерны применяются для связки песочниц и продакшена?
Популярные паттерны включают мосты (sandbox bridge) между средами для ограниченного копирования данных и паттерн shadow data, где в песочнице используется защищенная копия данных. В качестве дополнительной практики - контроль версий и аудит всего конвейера.
- Какие инструменты часто используются в связке с песочницами?
Нередко встречаются DataHub для каталога метаданных и Apache Airflow для оркестрации конвейеров. Эти инструменты поддерживают воспроизводимость, аудит и управляемые потоки данных и вычислений.
- Как начать внедрять песочницы в организации?
Необходимо начать с формулировки бизнес-целей и регламентов, затем спроектировать архитектуру сред и мостов, выбрать стек инструментов, внедрить IaC и регламенты управления доступом, а затем запустить пилотный цикл для одной или двух песочниц, расширяя их по мере зрелости процессов.
- Какие риски возникают при неправильной реализации песочниц?
Основные риски - утечки данных, неверная модель доступа, непреднамеренная передача данных в продакшен без тестов, нарушение регуляторных требований и слабая воспроизводимость экспериментов.
- Нужно ли использовать синтетику данных в песочнице с самого начала проекта?
Не обязательно. На начальном этапе можно применить маскирование и ограничение копирования. Синтетика полезна при более строгих требованиях к приватности или когда реальный набор не может быть безопасно использован даже в обезличенном виде.
- Как измерять успех песочницы?
Успех измеряется через степень воспроизводимости экспериментов, скорость развёртывания и обновления песочниц, качество аудита и соблюдение регуляторных требований, а также способность безопасно и эффективно передавать результаты в соответствующие среды для продакшена.


